
Utilisation de Markdown pour le blogage


Introduction
Markdown est un langage de marquage léger que vous pouvez utiliser pour ajouter des éléments de formattage aux documents de texte simple.. Créé par John Gruber dans 2004, Markdown fait maintenant partie des langues de marquation les plus populaires du monde.
Sur ce site, j’utilise une approche super simple pour bloger, ayant essayé et n’ayant pas réussi à maintenir un blog dans le passé je voulais faire en sorte qu’il soit aussi facile que possible d’écrire et de publier des articles. J’utilise Markdown pour écrire mes articles et ce site a un seul service utilisant Markdig pour convertir le marquage en HTML.
Pourquoi pas un générateur de site statique?
En un mot simplicité. Ce n’est pas'il ne sera pas un site de trafic super élevéM SK2 J’utiliserai ASP .NET OutPutCache pour cacher les pages et IMSC4je ne vais pas le mettre à jour que souventMNK5 Je voulais garder le site aussi simple que possible et ne dois pas m’inquiéter des frais générateurs d’un site statique tant en termes du processus de construction qu’en termes de complexité du site.
Pour clarifier les générateurs de sites statiques comme ; Hugo / Jekyll etc... peut être une bonne solution pour de nombreux sites, mais pour celui-ci j'ai voulu le garder aussi simple pour moi le plus possible. IM SK1m un 25 année ASP.NET anciens combattants donc comprenez-le à l’intérieur et à l'extérieurMSC4 Cette conception du site ajoute de la complexitéMST5 J’ai des vuesMst6 servicesM st7 contrôleurs et un LOT d’HTML manuel MSt8 CSS mais jeM St9me confortable avec celaMstr10
Pourquoi pas une base de données?
- Simplicité de la conception; Les bases de données sont des systèmes puissants pour l'entreposage des données ( et IM SK2 Je vais en ajouter un pour les commentaires prochainement) mais elles ajoutent aussi de la complexitéMSC4 À correctement utilisez les bases de données, surtout dans une application ASP.NET vous ajoutez un LOT de code , peu importe si vous EF Core, Dapper ou SQL brut avec ADO.NET. Je voulais garder le site aussi simple que possible à commencer par.
- Facilité de mise à jour et de déploiement. Ce site est destiné à démontrer la simplicité du Docker & Docker Compose peut être pour faire fonctionner un site . Je peux mettre à jour le site en vérifiant le nouveau code (y compris les contenusMSC4 vers GitHubM SK5 l'action se dérouleMST6 construit l'image puis la méthode Watchtower dans mon docker compose fichier actualise automatiquement l' image du siteM ST7 C'est une façon très simple d'actualiser un site et j'ai voulu le garder ainsiM st8
- Running duplicates; as I have ZERO data which is't within the docker image it means I can EASILY run exact duplicates locally MSC2on my little Ubuntu cluster here at homeM SK3 This is a great way to test changes with docker (eMST5gMst6 lorsque j'ai fait les changements ImageSharp ) avant de les déployer sur le site en direct
- Parce que je n’avais pas voulu', je voulais voir jusqu’à quel point j’aurais pu arriver avec un site simple et, à ce jour(s), je suis très satisfait(e) de cela(s).
Comment écrire vos articles?
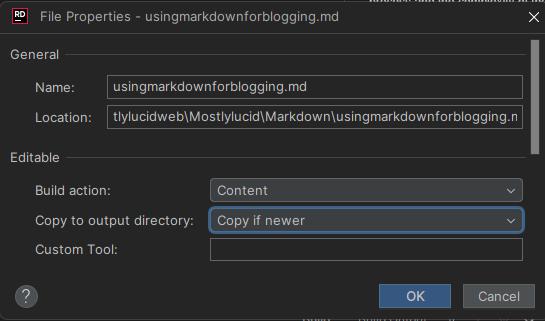
Je jette simplement un nouveau fichier .md dans le dossier de marquage et le site l'obtient et la rend (lors que je me souviens d'y ajouter du contenu , cela assure qu'il soit disponible dans les fichiers de sortie
Ensuite, lorsque je vérifie le site sur GitHub l'action se déroule et le site est mis à jour. Simple!
flowchart LR
    A[Write New Markdown File] -->|Checkin To Github| B(Github Action Triggers) -->  C(Builds Docker Image) --> D(Watchtower Pulls new Image) --> E(Site Updated)
Comment ajouter des images?
Puisque j’ai tout juste ajouté l’image ici, I'je vous montrerai comment je l’ai fait . J’ai simplement ajouté l'image au dossier wwwrootM SK3articleimages et la renvoyé dans le fichier de marquage comme celui-ciMSC4

J’ajoute ensuite une extension à mon pipeline Markdig qui les rédige à la URL correcte (tous au sujet de la simplicité). Voir ici pour le code source de l'extension.
using Markdig;
using Markdig.Renderers;
using Markdig.Syntax;
using Markdig.Syntax.Inlines;

namespace Mostlylucid.MarkDigExtensions;

public class ImgExtension : IMarkdownExtension
{
    public void Setup(MarkdownPipelineBuilder pipeline)
    {
        pipeline.DocumentProcessed += ChangeImgPath;
    }

    public void Setup(MarkdownPipeline pipeline, IMarkdownRenderer renderer)
    {
    }

    public void ChangeImgPath(MarkdownDocument document)
    {
        foreach (var link in document.Descendants<LinkInline>())
            if (link.IsImage)
                link.Url = "/articleimages/" + link.Url;
    }
}
Le service de blog.
Le BlogService est un service simple qui lit les fichiers de marquage à partir du dossier Markdown et les convertir en HTML avec Markdig.
La source complète de ce document est ci-dessous et ici.
Click to see the source code for the BlogService
using System.Globalization;
using System.Text.RegularExpressions;
using Markdig;
using Microsoft.Extensions.Caching.Memory;
using Mostlylucid.MarkDigExtensions;
using Mostlylucid.Models.Blog;

namespace Mostlylucid.Services;

public class BlogService
{
private const string Path = "Markdown";
private const string CacheKey = "Categories";

    private static readonly Regex DateRegex = new(
        @"<datetime class=""hidden"">(\d{4}-\d{2}-\d{2}T\d{2}:\d{2})</datetime>",
        RegexOptions.Compiled | RegexOptions.IgnoreCase | RegexOptions.NonBacktracking);

    private static readonly Regex WordCoountRegex = new(@"\b\w+\b",
        RegexOptions.Compiled | RegexOptions.Multiline | RegexOptions.IgnoreCase | RegexOptions.NonBacktracking);

    private static readonly Regex CategoryRegex = new(@"<!--\s*category\s*--\s*([^,]+?)\s*(?:,\s*([^,]+?)\s*)?-->",
        RegexOptions.Compiled | RegexOptions.Singleline);

    private readonly ILogger<BlogService> _logger;

    private readonly IMemoryCache _memoryCache;

    private readonly MarkdownPipeline pipeline;

    public BlogService(IMemoryCache memoryCache, ILogger<BlogService> logger)
    {
        _logger = logger;
        _memoryCache = memoryCache;
        pipeline = new MarkdownPipelineBuilder().UseAdvancedExtensions().Use<ImgExtension>().Build();
        ListCategories();
    }


    private Dictionary<string, List<string>> GetFromCache()
    {
        return _memoryCache.Get<Dictionary<string, List<string>>>(CacheKey) ?? new Dictionary<string, List<string>>();
    }

    private void SetCache(Dictionary<string, List<string>> categories)
    {
        _memoryCache.Set(CacheKey, categories, new MemoryCacheEntryOptions
        {
            AbsoluteExpirationRelativeToNow = TimeSpan.FromHours(12)
        });
    }

    private void ListCategories()
    {
        var cacheCats = GetFromCache();
        var pages = Directory.GetFiles("Markdown", "*.md");
        var count = 0;

        foreach (var page in pages)
        {
            var pageAlreadyAdded = cacheCats.Values.Any(x => x.Contains(page));

            if (pageAlreadyAdded) continue;


            var text = File.ReadAllText(page);
            var categories = GetCategories(text);
            if (!categories.Any()) continue;
            count++;
            foreach (var category in categories)
                if (cacheCats.TryGetValue(category, out var pagesList))
                {
                    pagesList.Add(page);
                    cacheCats[category] = pagesList;
                    _logger.LogInformation("Added category {Category} for {Page}", category, page);
                }
                else
                {
                    cacheCats.Add(category, new List<string> { page });
                    _logger.LogInformation("Created category {Category} for {Page}", category, page);
                }
        }

        if (count > 0) SetCache(cacheCats);
    }

    public List<string> GetCategories()
    {
        var cacheCats = GetFromCache();
        return cacheCats.Keys.ToList();
    }


    public List<PostListModel> GetPostsByCategory(string category)
    {
        var pages = GetFromCache()[category];
        return GetPosts(pages.ToArray());
    }

    public BlogPostViewModel? GetPost(string postName)
    {
        try
        {
            var path = System.IO.Path.Combine(Path, postName + ".md");
            var page = GetPage(path, true);
            return new BlogPostViewModel
            {
                Categories = page.categories, WordCount = WordCount(page.restOfTheLines), Content = page.processed,
                PublishedDate = page.publishDate, Slug = page.slug, Title = page.title
            };
        }
        catch (Exception e)
        {
            _logger.LogError(e, "Error getting post {PostName}", postName);
            return null;
        }
    }

    private int WordCount(string text)
    {
        return WordCoountRegex.Matches(text).Count;
    }


    private string GetSlug(string fileName)
    {
        var slug = System.IO.Path.GetFileNameWithoutExtension(fileName);
        return slug.ToLowerInvariant();
    }

    private static string[] GetCategories(string markdownText)
    {
        var matches = CategoryRegex.Matches(markdownText);
        var categories = matches
            .SelectMany(match => match.Groups.Cast<Group>()
                .Skip(1) // Skip the entire match group
                .Where(group => group.Success) // Ensure the group matched
                .Select(group => group.Value.Trim()))
            .ToArray();
        return categories;
    }

    public (string title, string slug, DateTime publishDate, string processed, string[] categories, string
        restOfTheLines) GetPage(string page, bool html)
    {
        var fileInfo = new FileInfo(page);

        // Ensure the file exists
        if (!fileInfo.Exists) throw new FileNotFoundException("The specified file does not exist.", page);

        // Read all lines from the file
        var lines = File.ReadAllLines(page);

        // Get the title from the first line
        var title = lines.Length > 0 ? Markdown.ToPlainText(lines[0].Trim()) : string.Empty;

        // Concatenate the rest of the lines with newline characters
        var restOfTheLines = string.Join(Environment.NewLine, lines.Skip(1));

        // Extract categories from the text
        var categories = GetCategories(restOfTheLines);

        var publishedDate = fileInfo.CreationTime;
        var publishDate = DateRegex.Match(restOfTheLines).Groups[1].Value;
        if (!string.IsNullOrWhiteSpace(publishDate))
            publishedDate = DateTime.ParseExact(publishDate, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);

        // Remove category tags from the text
        restOfTheLines = CategoryRegex.Replace(restOfTheLines, "");
        restOfTheLines = DateRegex.Replace(restOfTheLines, "");
        // Process the rest of the lines as either HTML or plain text
        var processed =
            html ? Markdown.ToHtml(restOfTheLines, pipeline) : Markdown.ToPlainText(restOfTheLines, pipeline);

        // Generate the slug from the page filename
        var slug = GetSlug(page);


        // Return the parsed and processed content
        return (title, slug, publishedDate, processed, categories, restOfTheLines);
    }

    public List<PostListModel> GetPosts(string[] pages)
    {
        List<PostListModel> pageModels = new();

        foreach (var page in pages)
        {
            var pageInfo = GetPage(page, false);

            var summary = Markdown.ToPlainText(pageInfo.restOfTheLines).Substring(0, 100) + "...";
            pageModels.Add(new PostListModel
            {
                Categories = pageInfo.categories, Title = pageInfo.title,
                Slug = pageInfo.slug, WordCount = WordCount(pageInfo.restOfTheLines),
                PublishedDate = pageInfo.publishDate, Summary = summary
            });
        }

        pageModels = pageModels.OrderByDescending(x => x.PublishedDate).ToList();
        return pageModels;
    }


    public List<PostListModel> GetPostsForFiles()
    {
        var pages = Directory.GetFiles("Markdown", "*.md");
        return GetPosts(pages);
    }
}
Traitement des fichiers
Le code pour traiter les fichiers de marquage en HTML est assez simple, J’utilise la bibliothèque Markdig pour convertir le marquaage en HTML et puis je utilise quelques expressions régulières pour extraire les catégories et la date publiée du fichier de marquation.
La méthode GetPage est utilisée pour extraire le contenu du fichier de marquage.
- Extraire le titre Par convention, j’utilise la première ligne du fichier de marquage comme titre du poste. Je peux donc simplement faire
        var lines = File.ReadAllLines(page);

        // Get the title from the first line
        var title = lines.Length > 0 ? Markdown.ToPlainText(lines[0].Trim()) : string.Empty;
Puisque le titre est précédé par "#", j'utilise la méthode Markdown.ToPlainText pour retirer "#" du titre
- Extraire les catégories Chaque post peut avoir jusqu’à deux catégories cette méthode extrait ces puis je retire ce tag du fichier de marquage.
// Concatenate the rest of the lines with newline characters
        var restOfTheLines = string.Join(Environment.NewLine, lines.Skip(1));

        // Extract categories from the text
        var categories = GetCategories(restOfTheLines);

   // Remove category tags from the text
        restOfTheLines = CategoryRegex.Replace(restOfTheLines, "");
La méthode GetCategories utilise une expression régulière pour extraire les catégories du fichier de marquage.
    private static readonly Regex CategoryRegex = new(@"<!--\s*category\s*--\s*([^,]+?)\s*(?:,\s*([^,]+?)\s*)?-->",
        RegexOptions.Compiled | RegexOptions.Singleline);

    private static string[] GetCategories(string markdownText)
    {
        var matches = CategoryRegex.Matches(markdownText);
        var categories = matches
            .SelectMany(match => match.Groups.Cast<Group>()
                .Skip(1) // Skip the entire match group
                .Where(group => group.Success) // Ensure the group matched
                .Select(group => group.Value.Trim()))
            .ToArray();
        return categories;


    }
- Extraire la date de publication J’extrais ensuite la date du post (J’avais utilisé la date créée, mais comment je déploie cela en utilisant une image de docker entière signifie que ce n’est pas plus vraiment utile 'N’utilisez plus d’expressions régulières. Il analyse un étiquette sous la forme qui figure dans chaque fichier .md.
     private static readonly Regex DateRegex = new(
        @"<datetime class=""hidden"">(\d{4}-\d{2}-\d{2}T\d{2}:\d{2})</datetime>",
        RegexOptions.Compiled | RegexOptions.IgnoreCase | RegexOptions.NonBacktracking);

           var publishedDate = fileInfo.CreationTime;
        var publishDate = DateRegex.Match(restOfTheLines).Groups[1].Value;
        if (!string.IsNullOrWhiteSpace(publishDate))
            publishedDate = DateTime.ParseExact(publishDate, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);


        restOfTheLines = DateRegex.Replace(restOfTheLines, "");
- Extraire le contenu En fait, getting the content is pretty simple this uses a pipeline (for the image tag replacement mentioned above ) then optionally gives me plain text for the list of posts or HTML for the actual post.
    pipeline = new MarkdownPipelineBuilder().UseAdvancedExtensions().Use<ImgExtension>().Build();

   var processed =
            html ? Markdown.ToHtml(restOfTheLines, pipeline) : Markdown.ToPlainText(restOfTheLines, pipeline);
Obtenir le 'slug' Il s'agit simplement du nom de fichier sans extension:
    private string GetSlug(string fileName)
    {
        var slug = System.IO.Path.GetFileNameWithoutExtension(fileName);
        return slug.ToLowerInvariant();
    }
Retourner le contenu Maintenant nous avons un contenu de page que nous pouvons afficher pour le blog!
The GetPage Method
public (string title, string slug, DateTime publishDate, string processed, string[] categories, string
        restOfTheLines) GetPage(string page, bool html)
    {
        var fileInfo = new FileInfo(page);

        // Ensure the file exists
        if (!fileInfo.Exists) throw new FileNotFoundException("The specified file does not exist.", page);

        // Read all lines from the file
        var lines = File.ReadAllLines(page);

        // Get the title from the first line
        var title = lines.Length > 0 ? Markdown.ToPlainText(lines[0].Trim()) : string.Empty;

        // Concatenate the rest of the lines with newline characters
        var restOfTheLines = string.Join(Environment.NewLine, lines.Skip(1));

        // Extract categories from the text
        var categories = GetCategories(restOfTheLines);

        var publishedDate = fileInfo.CreationTime;
        var publishDate = DateRegex.Match(restOfTheLines).Groups[1].Value;
        if (!string.IsNullOrWhiteSpace(publishDate))
            publishedDate = DateTime.ParseExact(publishDate, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);

        // Remove category tags from the text
        restOfTheLines = CategoryRegex.Replace(restOfTheLines, "");
        restOfTheLines = DateRegex.Replace(restOfTheLines, "");
        // Process the rest of the lines as either HTML or plain text
        var processed =
            html ? Markdown.ToHtml(restOfTheLines, pipeline) : Markdown.ToPlainText(restOfTheLines, pipeline);

        // Generate the slug from the page filename
        var slug = GetSlug(page);


        // Return the parsed and processed content
        return (title, slug, publishedDate, processed, categories, restOfTheLines);
    }
     public List<PostListModel> GetPosts(string[] pages)
    {
        List<PostListModel> pageModels = new();

        foreach (var page in pages)
        {
            var pageInfo = GetPage(page, false);

            var summary = Markdown.ToPlainText(pageInfo.restOfTheLines).Substring(0, 100) + "...";
            pageModels.Add(new PostListModel
            {
                Categories = pageInfo.categories, Title = pageInfo.title,
                Slug = pageInfo.slug, WordCount = WordCount(pageInfo.restOfTheLines),
                PublishedDate = pageInfo.publishDate, Summary = summary
            });
        }

        pageModels = pageModels.OrderByDescending(x => x.PublishedDate).ToList();
        return pageModels;
    }


    public List<PostListModel> GetPostsForFiles()
    {
        var pages = Directory.GetFiles("Markdown", "*.md");
        return GetPosts(pages);
    }