
استخدام العلامات المنخفضة للكتشاف


المقدمة
Markdown هو لغة إشارات خفيفة الوزن التي يمكنك استخدامها لإضافة عناصر الصيغة إلى दस्तावेज نصية ملموسة. تم إنشاءه من قبل جون غروبر في 2004, Markdown الآن واحد من أكثر اللغات الإشارات شعبية في العالمM SK2
في هذا الموقع أستخدم منهج بسيط جداً للكتابة على المدونات , لقد حاولت وفشلت في الحفاظ على مدونة في الماضي أردت أن أجعله سهلاً بقدر الإمكان لكتابة ونشر المدونة . أستخدم العلامة التجارية لكتشاف المدوناتي وهذا الموقع لديه خدمة واحدة تستخدم ماركديغ لتحويل المؤشر إلى HTML.
لماذا لا مولد موقع ثابت?
في كلمة البساطة. هذا ليس' لن يكون موقعاً عالياً في حركة المرورMSC2 أستخدم ASPM SK3NET OutPutCache لتخزين الصفحات و أناـ' لن أقوم بتحديثه عادةً ما . أردت أن أحافظ على الموقع ببساطة قدر الإمكان ولا أضطر إلى القلق بشأن تكاليف مولد المواقع الثابتة سواءً من ناحية عملية البناء و تعقيد الموقع
لتوضيح ; مولدات موقع ثابت مثل هوغو / جيكل etc... يمكن أن يكون حلاً جيداً للعديد من المواقع ولكن لهذا أريد أن أبقيه بسيطاً بالنسبة لي كما هو ممكن. I'm a M SK2 year ASP .NET veteran so understand it inside and outMST4 This site design does add complexityMst5 I have viewsM st6 servicesMstr7 controllers and a LOT of manual HTML M st8 CSS but I Mstr9m comfortable with thatM str10
لماذا لا يوجد قاعدة بيانات?
- البساطة في التصميم; قواعد البيانات هي أنظمة قوية لحفظ البيانات (and IM SK2ll add one for comments shortly) however they also add complexityMSC4 To بصورة صحيحة تستخدم قواعد البيانات خصوصاً في تطبيق ASP.NET تضيفون LOT من البرمجة مركز EF, مسدس أو SQL الخام مع ADO.NET. أردت الحفاظ على الموقع ببساطة قدر الإمكان في البداية.
- سهولة تحديثه ونشره. هذا الموقع يقصد أن يوضح كم هو بسيط الدوكر & برمجة الدوكر يمكن أن يكون لتشغيل الموقعM SK2 يمكنني تحديث الموقع عن طريق التحقق من الشيفرة الجديدة ( بما في ذلك المحتوىMSC4 إلى GitHubMska5 يعمل عملاًMske6 يبني الصورة ثم يقوم ببناء ميتود برج المراقب في ملف تركيب الدوكر ليقوم بتحديث صورة الموقع تلقائياً |. هذه طريقة بسيطة جداً لتحديث الموقع وأردت أن أحتفظ بها بهذه الطريقة
- تشغيل النسخات; بما أن لدي بيانات ZERO التي هي 't داخل صورة الدوكر هذا يعني أنه بإمكاني ببساطة تشغيل نسخ تقليدية دقيقة محليا ( على مجموعتي أوبونتو الصغيرة هنا في المنزلM SK3 هذه طريقة عظيمة لاختبار التغيرات مع الدوكر | | عندما قمت بتغيير ImageSharp ) قبل وضعها على الموقع المباشر.
- لأنني لم أكن أرغب بـ' أو ! أردت أن أرى إلى أي مدى يمكنني الوصول مع تصميم موقع بسيط وحتى الآن أنا ' أشعر بسعادة كبيرة
كيف تكتب رسائلك
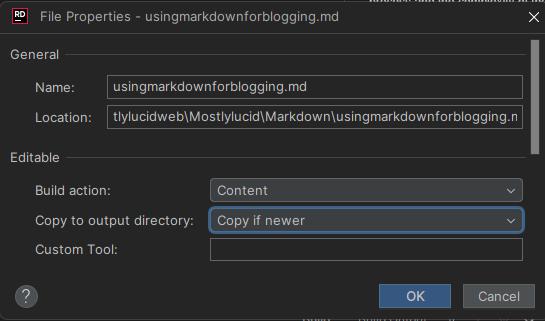
أسقط ببساطة ឯកសារ جديدة .md في مجلد العلامات و يلتقطها الموقع ويحولها ♫( ♫عندما أتذكر أن أضيفها كمحتوى ♫ , ♫ هذا يضمن أنها ♫
عندئذ عندما أقوم بالتحقق من الموقع على GitHub يشتغل العمل ويتم تحديث الموقع
flowchart LR
    A[Write New Markdown File] -->|Checkin To Github| B(Github Action Triggers) -->  C(Builds Docker Image) --> D(Watchtower Pulls new Image) --> E(Site Updated)
كيف يمكنك إضافة الصور?
بما أنني قمت بإضافة الصورة هنا، سأريكم كيف فعلتها.

ثم أضيف إضافة إلى خط أنابيب ماركديج الذي يعيد كتابة هذه إلى URL الصحيح (كل شيء عن البساطة). شاهدوا هنا المصدر للتوسع.
using Markdig;
using Markdig.Renderers;
using Markdig.Syntax;
using Markdig.Syntax.Inlines;

namespace Mostlylucid.MarkDigExtensions;

public class ImgExtension : IMarkdownExtension
{
    public void Setup(MarkdownPipelineBuilder pipeline)
    {
        pipeline.DocumentProcessed += ChangeImgPath;
    }

    public void Setup(MarkdownPipeline pipeline, IMarkdownRenderer renderer)
    {
    }

    public void ChangeImgPath(MarkdownDocument document)
    {
        foreach (var link in document.Descendants<LinkInline>())
            if (link.IsImage)
                link.Url = "/articleimages/" + link.Url;
    }
}
خدمة المدونة.
"الخدمات الإلكترونية" هي خدمة بسيطة تقوم بقراءة الملفات الملاحظة من مجلد الملاحظات وتقوم بتحويلها إلى HTML باستخدام "ماركدج"
المصدر الكامل لهذا هو في الأسفل هنا.
Click to see the source code for the BlogService
using System.Globalization;
using System.Text.RegularExpressions;
using Markdig;
using Microsoft.Extensions.Caching.Memory;
using Mostlylucid.MarkDigExtensions;
using Mostlylucid.Models.Blog;

namespace Mostlylucid.Services;

public class BlogService
{
private const string Path = "Markdown";
private const string CacheKey = "Categories";

    private static readonly Regex DateRegex = new(
        @"<datetime class=""hidden"">(\d{4}-\d{2}-\d{2}T\d{2}:\d{2})</datetime>",
        RegexOptions.Compiled | RegexOptions.IgnoreCase | RegexOptions.NonBacktracking);

    private static readonly Regex WordCoountRegex = new(@"\b\w+\b",
        RegexOptions.Compiled | RegexOptions.Multiline | RegexOptions.IgnoreCase | RegexOptions.NonBacktracking);

    private static readonly Regex CategoryRegex = new(@"<!--\s*category\s*--\s*([^,]+?)\s*(?:,\s*([^,]+?)\s*)?-->",
        RegexOptions.Compiled | RegexOptions.Singleline);

    private readonly ILogger<BlogService> _logger;

    private readonly IMemoryCache _memoryCache;

    private readonly MarkdownPipeline pipeline;

    public BlogService(IMemoryCache memoryCache, ILogger<BlogService> logger)
    {
        _logger = logger;
        _memoryCache = memoryCache;
        pipeline = new MarkdownPipelineBuilder().UseAdvancedExtensions().Use<ImgExtension>().Build();
        ListCategories();
    }


    private Dictionary<string, List<string>> GetFromCache()
    {
        return _memoryCache.Get<Dictionary<string, List<string>>>(CacheKey) ?? new Dictionary<string, List<string>>();
    }

    private void SetCache(Dictionary<string, List<string>> categories)
    {
        _memoryCache.Set(CacheKey, categories, new MemoryCacheEntryOptions
        {
            AbsoluteExpirationRelativeToNow = TimeSpan.FromHours(12)
        });
    }

    private void ListCategories()
    {
        var cacheCats = GetFromCache();
        var pages = Directory.GetFiles("Markdown", "*.md");
        var count = 0;

        foreach (var page in pages)
        {
            var pageAlreadyAdded = cacheCats.Values.Any(x => x.Contains(page));

            if (pageAlreadyAdded) continue;


            var text = File.ReadAllText(page);
            var categories = GetCategories(text);
            if (!categories.Any()) continue;
            count++;
            foreach (var category in categories)
                if (cacheCats.TryGetValue(category, out var pagesList))
                {
                    pagesList.Add(page);
                    cacheCats[category] = pagesList;
                    _logger.LogInformation("Added category {Category} for {Page}", category, page);
                }
                else
                {
                    cacheCats.Add(category, new List<string> { page });
                    _logger.LogInformation("Created category {Category} for {Page}", category, page);
                }
        }

        if (count > 0) SetCache(cacheCats);
    }

    public List<string> GetCategories()
    {
        var cacheCats = GetFromCache();
        return cacheCats.Keys.ToList();
    }


    public List<PostListModel> GetPostsByCategory(string category)
    {
        var pages = GetFromCache()[category];
        return GetPosts(pages.ToArray());
    }

    public BlogPostViewModel? GetPost(string postName)
    {
        try
        {
            var path = System.IO.Path.Combine(Path, postName + ".md");
            var page = GetPage(path, true);
            return new BlogPostViewModel
            {
                Categories = page.categories, WordCount = WordCount(page.restOfTheLines), Content = page.processed,
                PublishedDate = page.publishDate, Slug = page.slug, Title = page.title
            };
        }
        catch (Exception e)
        {
            _logger.LogError(e, "Error getting post {PostName}", postName);
            return null;
        }
    }

    private int WordCount(string text)
    {
        return WordCoountRegex.Matches(text).Count;
    }


    private string GetSlug(string fileName)
    {
        var slug = System.IO.Path.GetFileNameWithoutExtension(fileName);
        return slug.ToLowerInvariant();
    }

    private static string[] GetCategories(string markdownText)
    {
        var matches = CategoryRegex.Matches(markdownText);
        var categories = matches
            .SelectMany(match => match.Groups.Cast<Group>()
                .Skip(1) // Skip the entire match group
                .Where(group => group.Success) // Ensure the group matched
                .Select(group => group.Value.Trim()))
            .ToArray();
        return categories;
    }

    public (string title, string slug, DateTime publishDate, string processed, string[] categories, string
        restOfTheLines) GetPage(string page, bool html)
    {
        var fileInfo = new FileInfo(page);

        // Ensure the file exists
        if (!fileInfo.Exists) throw new FileNotFoundException("The specified file does not exist.", page);

        // Read all lines from the file
        var lines = File.ReadAllLines(page);

        // Get the title from the first line
        var title = lines.Length > 0 ? Markdown.ToPlainText(lines[0].Trim()) : string.Empty;

        // Concatenate the rest of the lines with newline characters
        var restOfTheLines = string.Join(Environment.NewLine, lines.Skip(1));

        // Extract categories from the text
        var categories = GetCategories(restOfTheLines);

        var publishedDate = fileInfo.CreationTime;
        var publishDate = DateRegex.Match(restOfTheLines).Groups[1].Value;
        if (!string.IsNullOrWhiteSpace(publishDate))
            publishedDate = DateTime.ParseExact(publishDate, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);

        // Remove category tags from the text
        restOfTheLines = CategoryRegex.Replace(restOfTheLines, "");
        restOfTheLines = DateRegex.Replace(restOfTheLines, "");
        // Process the rest of the lines as either HTML or plain text
        var processed =
            html ? Markdown.ToHtml(restOfTheLines, pipeline) : Markdown.ToPlainText(restOfTheLines, pipeline);

        // Generate the slug from the page filename
        var slug = GetSlug(page);


        // Return the parsed and processed content
        return (title, slug, publishedDate, processed, categories, restOfTheLines);
    }

    public List<PostListModel> GetPosts(string[] pages)
    {
        List<PostListModel> pageModels = new();

        foreach (var page in pages)
        {
            var pageInfo = GetPage(page, false);

            var summary = Markdown.ToPlainText(pageInfo.restOfTheLines).Substring(0, 100) + "...";
            pageModels.Add(new PostListModel
            {
                Categories = pageInfo.categories, Title = pageInfo.title,
                Slug = pageInfo.slug, WordCount = WordCount(pageInfo.restOfTheLines),
                PublishedDate = pageInfo.publishDate, Summary = summary
            });
        }

        pageModels = pageModels.OrderByDescending(x => x.PublishedDate).ToList();
        return pageModels;
    }


    public List<PostListModel> GetPostsForFiles()
    {
        var pages = Directory.GetFiles("Markdown", "*.md");
        return GetPosts(pages);
    }
}
معالجة الملفات
البرمجة لتحويل الملفات الملاحظة إلى HTML بسيطة جدا, أستخدم مكتبة ماركدغ لتحويل الملاحظات إلى HTML ومن ثم أستخدم بعض التعابير العادية لإستخلاص الفئات واليوم المنشور من ملف الملاحظ
طريقة GetPage تستخدم لإستخراج المحتوى من ملف الرسم البياني.
- استخرج عنوان بإعترافي أستخدم أول سطر في ملف التراجع كعنوان للرسالة
        var lines = File.ReadAllLines(page);

        // Get the title from the first line
        var title = lines.Length > 0 ? Markdown.ToPlainText(lines[0].Trim()) : string.Empty;
لأن العنوان مسبقاً بـ "#" أستخدم طريقة Markdown .ToPlainText لتقليل الـ | "#" من العنوان
- استخرج التصنيفات كل تعليق يمكن أن يحتوي على أكثر من اثنتين من التصنيفات هذه الطريقة تستخرج هذه ثم أزيل ذلك العلامة من ملف التقليل
// Concatenate the rest of the lines with newline characters
        var restOfTheLines = string.Join(Environment.NewLine, lines.Skip(1));

        // Extract categories from the text
        var categories = GetCategories(restOfTheLines);

   // Remove category tags from the text
        restOfTheLines = CategoryRegex.Replace(restOfTheLines, "");
طريقة GetCategories تستخدم تعبيراً عادياً لإستخلاص التصنيفات من ملف العلامة
    private static readonly Regex CategoryRegex = new(@"<!--\s*category\s*--\s*([^,]+?)\s*(?:,\s*([^,]+?)\s*)?-->",
        RegexOptions.Compiled | RegexOptions.Singleline);

    private static string[] GetCategories(string markdownText)
    {
        var matches = CategoryRegex.Matches(markdownText);
        var categories = matches
            .SelectMany(match => match.Groups.Cast<Group>()
                .Skip(1) // Skip the entire match group
                .Where(group => group.Success) // Ensure the group matched
                .Select(group => group.Value.Trim()))
            .ToArray();
        return categories;


    }
- استخرج التاريخ المنشور ثم أستخرج التاريخ من البريد ( كنت أستخدم التاريخ الذي تم إنشاءه لكن كيف أقوم بنشر هذا باستخدام صورة entire docker يعني أن هذا ليس ذا فائدة حقاً بعد الآن ) لذلك أنا هذا يفكّر بطاقة في الشكل الموجود في كل .md file.
     private static readonly Regex DateRegex = new(
        @"<datetime class=""hidden"">(\d{4}-\d{2}-\d{2}T\d{2}:\d{2})</datetime>",
        RegexOptions.Compiled | RegexOptions.IgnoreCase | RegexOptions.NonBacktracking);

           var publishedDate = fileInfo.CreationTime;
        var publishDate = DateRegex.Match(restOfTheLines).Groups[1].Value;
        if (!string.IsNullOrWhiteSpace(publishDate))
            publishedDate = DateTime.ParseExact(publishDate, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);


        restOfTheLines = DateRegex.Replace(restOfTheLines, "");
- استخرج المحتوى في الواقع الحصول على المحتوى بسيط جداً هذا يستخدم خط أنابيب (for the image tag replacement mentioned aboveM SK1 then optionally gives me plain text for the list of posts or HTML for the actual post.
    pipeline = new MarkdownPipelineBuilder().UseAdvancedExtensions().Use<ImgExtension>().Build();

   var processed =
            html ? Markdown.ToHtml(restOfTheLines, pipeline) : Markdown.ToPlainText(restOfTheLines, pipeline);
أحصل على 'slug' هذا ببساطة اسم файл بدون التوسع:
    private string GetSlug(string fileName)
    {
        var slug = System.IO.Path.GetFileNameWithoutExtension(fileName);
        return slug.ToLowerInvariant();
    }
أعيد المحتوى الآن لدينا محتويات صفحة يمكننا عرضها للدونة!
The GetPage Method
public (string title, string slug, DateTime publishDate, string processed, string[] categories, string
        restOfTheLines) GetPage(string page, bool html)
    {
        var fileInfo = new FileInfo(page);

        // Ensure the file exists
        if (!fileInfo.Exists) throw new FileNotFoundException("The specified file does not exist.", page);

        // Read all lines from the file
        var lines = File.ReadAllLines(page);

        // Get the title from the first line
        var title = lines.Length > 0 ? Markdown.ToPlainText(lines[0].Trim()) : string.Empty;

        // Concatenate the rest of the lines with newline characters
        var restOfTheLines = string.Join(Environment.NewLine, lines.Skip(1));

        // Extract categories from the text
        var categories = GetCategories(restOfTheLines);

        var publishedDate = fileInfo.CreationTime;
        var publishDate = DateRegex.Match(restOfTheLines).Groups[1].Value;
        if (!string.IsNullOrWhiteSpace(publishDate))
            publishedDate = DateTime.ParseExact(publishDate, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);

        // Remove category tags from the text
        restOfTheLines = CategoryRegex.Replace(restOfTheLines, "");
        restOfTheLines = DateRegex.Replace(restOfTheLines, "");
        // Process the rest of the lines as either HTML or plain text
        var processed =
            html ? Markdown.ToHtml(restOfTheLines, pipeline) : Markdown.ToPlainText(restOfTheLines, pipeline);

        // Generate the slug from the page filename
        var slug = GetSlug(page);


        // Return the parsed and processed content
        return (title, slug, publishedDate, processed, categories, restOfTheLines);
    }
     public List<PostListModel> GetPosts(string[] pages)
    {
        List<PostListModel> pageModels = new();

        foreach (var page in pages)
        {
            var pageInfo = GetPage(page, false);

            var summary = Markdown.ToPlainText(pageInfo.restOfTheLines).Substring(0, 100) + "...";
            pageModels.Add(new PostListModel
            {
                Categories = pageInfo.categories, Title = pageInfo.title,
                Slug = pageInfo.slug, WordCount = WordCount(pageInfo.restOfTheLines),
                PublishedDate = pageInfo.publishDate, Summary = summary
            });
        }

        pageModels = pageModels.OrderByDescending(x => x.PublishedDate).ToList();
        return pageModels;
    }


    public List<PostListModel> GetPostsForFiles()
    {
        var pages = Directory.GetFiles("Markdown", "*.md");
        return GetPosts(pages);
    }