
Volledige Tekszoeken (Pt 3 - OpenSearch met ASP.NET CoreM SK4


Inleiding
In de vorige delen van deze serie hebben we het concept 'full text search' geïntroduceerd en hoe het kan worden gebruikt om tekst te zoeken in een database.
Vorige onderdelen:
In dit deel behandelen we hoe je nieuwe glanzende OpenSearch-instances kan beginnen te gebruiken met ASP.NET Core.
Opstelling
Zodra we de OpenSearch-instance op en in werking hebben, kunnen we ermee interageren. OpenSearch Kliënt voor .NET. Eerst zetten we de client op in onze Opstellingsverlenging.
    var openSearchConfig = services.ConfigurePOCO<OpenSearchConfig>(configuration.GetSection(OpenSearchConfig.Section));
        var config = new ConnectionSettings(new Uri(openSearchConfig.Endpoint))
            .EnableHttpCompression()
            .EnableDebugMode()
            .ServerCertificateValidationCallback((sender, certificate, chain, errors) => true)
            .BasicAuthentication(openSearchConfig.Username, openSearchConfig.Password);
        services.AddSingleton<OpenSearchClient>(c => new OpenSearchClient(config));
Dit zet de client op met het eindpunt en credentials. We kunnen ook de ontfoutingsmodus activeren zodat we kunnen zien wat er aan de hand is.
Index-gegevens
Het kernconcept van OpenSearch is de Index.
Om dit te doen, gebruiken we de '. OpenSearch Kliënt Je kunt dit installeren via NuGet:
Je ziet er twee: - Opensearch.Net en OpenSearch.Client.De eerste zijn de laag niveau dingen zoals verbindingsmanagement,De tweede zijn de hoge niveau dingen als indexeren en zoeken.
Nu we het geïnstalleerd hebben, kunnen we beginnen te kijken naar indexerende data.
Het creëren van een index is semi-vorderwaarts. Je definieert gewoon hoe je index eruit moet zien en dan creëert het. In de code onder kan je zien dat we 'map' ons Indexmodel ( een vereenvoudigde versie van het blog Voor elk veld van dit model definiëren we dan welk type het is: (text, datumM SK2 sleutelwoord enz.
De Tipe is belangrijk omdat het definieert hoe de data worden opgeslagen en hoe ze kunnen worden gezocht.. Bijvoorbeeld, wordt een M SK2teks ' veld geanalyseerd en getokeniseerd.
Ook hier Categories is eigenlijk een string.[] maar de sleutelwoordtype begrijpt hoe ze goed te behandelen zijn.
   public async Task CreateIndex(string language)
    {
        var languageName = language.ConvertCodeToLanguageName();
        var indexName = GetBlogIndexName(language);

      var response =  await client.Indices.CreateAsync(indexName, c => c
            .Settings(s => s
                .NumberOfShards(1)
                .NumberOfReplicas(1)
            )
            .Map<BlogIndexModel>(m => m
                .Properties(p => p
                    .Text(t => t
                        .Name(n => n.Title)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Content)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Language)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Date(t => t
                        .Name(n => n.Published)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Keyword(t => t
                        .Name(n => n.Id)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Slug)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Hash)
                    )
                    .Keyword(t => t
                        .Name(n => n.Categories)
                    )
                )
            )
        );

        if (!response.IsValid)
        {
           logger.LogError("Failed to create index {IndexName}: {Error}", indexName, response.DebugInformation);
        }
    }
Itemen in de Index toevoegen
Zodra we onze index hebben opgezet om er items aan toe te voegen, moeten we er items bij toevoegen.
Je kunt zien dat we in het begin een methode namen dieGetExistingPosts die alle posten teruggeeft die al in de index zitten. We groeperen dan de posten per taal en filteren de 'ukM SK2 taal uit.
We gebruiken het hash en id om te bepalen of een bericht al in de index zit.
    public async Task AddPostsToIndex(IEnumerable<BlogIndexModel> posts)
    {
        var existingPosts = await GetExistingPosts();
        var langPosts = posts.GroupBy(p => p.Language);
        langPosts=langPosts.Where(p => p.Key!="uk");
        langPosts = langPosts.Where(p =>
            p.Any(post => !existingPosts.Any(existing => existing.Id == post.Id && existing.Hash == post.Hash)));

        foreach (var blogIndexModels in langPosts)
        {

            var language = blogIndexModels.Key;
            var indexName = GetBlogIndexName(language);
            if(!await IndexExists(language))
            {
                await CreateIndex(language);
            }

            var bulkRequest = new BulkRequest(indexName)
            {
                Operations = new BulkOperationsCollection<IBulkOperation>(blogIndexModels.ToList()
                    .Select(p => new BulkIndexOperation<BlogIndexModel>(p))
                    .ToList()),
                Refresh = Refresh.True,
                ErrorTrace = true,
                RequestConfiguration = new RequestConfiguration
                {
                    MaxRetries = 3
                }
            };

            var bulkResponse = await client.BulkAsync(bulkRequest);
            if (!bulkResponse.IsValid)
            {
                logger.LogError("Failed to add posts to index {IndexName}: {Error}", indexName, bulkResponse.DebugInformation);
            }

        }
    }
Nadat we de bestaande posten en onze ontbrekende analyzer hebben gefilterd, creëren we een nieuwe Index (gebaseerd op de naam, in mijn geval.
Je”'” zal dat in de BulkRequest We stelden de Refresh eigendom aan true. Dit betekent dat na het klaarmaken van de bulk-invoeging de index verfrisd wordt.
De Index zoeken
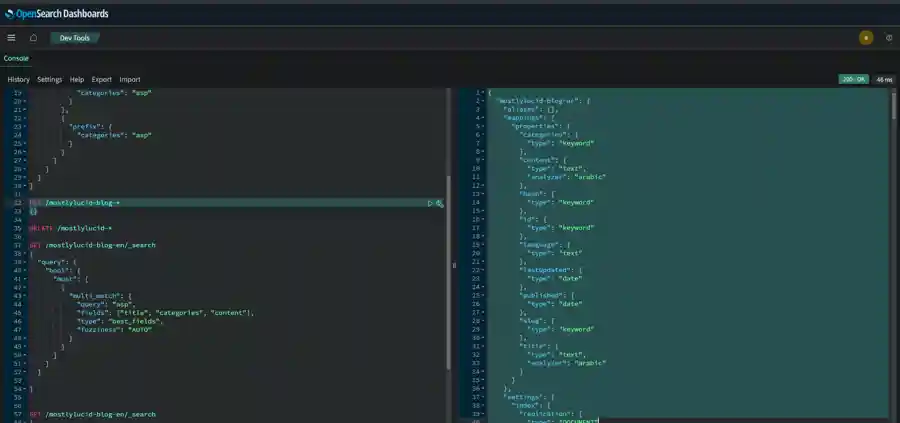
Een goede manier om te testen wat hier gemaakt is, is in de Dev-Tools op OpenSearch Dashboards te gaan en een zoekvraag uit te voeren.
GET /mostlylucid-blog-*
{}
Deze vraag zal ons alle indexen teruggeven die met het patroon overeenkomen. mostlylucid-blog-*. (zo al onze indexen tot nu toe
{
  "mostlylucid-blog-ar": {
    "aliases": {},
    "mappings": {
      "properties": {
        "categories": {
          "type": "keyword"
        },
        "content": {
          "type": "text",
          "analyzer": "arabic"
        },
        "hash": {
          "type": "keyword"
        },
        "id": {
          "type": "keyword"
        },
        "language": {
          "type": "text"
        },
        "lastUpdated": {
          "type": "date"
        },
        "published": {
          "type": "date"
        },
        "slug": {
          "type": "keyword"
        },
        "title": {
          "type": "text",
          "analyzer": "arabic"
        }
      }
    },
    "settings": {
      "index": {
        "replication": {
          "type": "DOCUMENT"
..MANY MORE
Dev Tools in OpenSearch Dashboards is een geweldige manier om je vragen te testen voordat je ze in je code zet.
De Index zoeken
Nu kunnen we beginnen te zoeken naar de index. Search methode op de client om dit te doen.
Hier komt de echte kracht van OpenSearch in. Het heeft letterlijk Duizenden verschillende vragentypes. Je kan je data gebruiken om te zoeken. Alles van een simpele sleutelwoordzoek naar een complex 'neuralM SK2 zoek
    public async Task<List<BlogIndexModel>> GetSearchResults(string language, string query, int page = 1, int pageSize = 10)
    {
        var indexName = GetBlogIndexName(language);
        var searchResponse = await client.SearchAsync<BlogIndexModel>(s => s
                .Index(indexName)  // Match index pattern
                .Query(q => q
                    .Bool(b => b
                        .Must(m => m
                            .MultiMatch(mm => mm
                                .Query(query)
                                .Fields(f => f
                                    .Field(p => p.Title, boost: 2.0)
                                    .Field(p => p.Categories, boost: 1.5)
                                    .Field(p => p.Content)
                                )
                                .Type(TextQueryType.BestFields)
                                .Fuzziness(Fuzziness.Auto)
                            )
                        )
                    )
                )
                .Skip((page -1) * pageSize)  // Skip the first n results (adjust as needed)
                .Size(pageSize)  // Limit the number of results (adjust as needed)
        );

        if(!searchResponse.IsValid)
        {
            logger.LogError("Failed to search index {IndexName}: {Error}", indexName, searchResponse.DebugInformation);
            return new List<BlogIndexModel>();
        }
        return searchResponse.Documents.ToList();
    }
Navraagbeschrijving
Deze methode, GetSearchResults, is ontworpen om een specifiek OpenSearch-index te vragen om blogposts terug te halen. language, query, en paginatieparameters page en pageSize. Hier'is wat het doet :
Keuse:
- Het haalt de indexnaam terug met behulp van de
GetBlogIndexNamemethode gebaseerd op de voorgestelde taal. De index wordt dynamisch gekies volgens de taal .
- Het haalt de indexnaam terug met behulp van de
De zoekvraag:
- De zoekopdracht gebruikt een
BoolEen vraag met eenMustClause om te zorgen dat de resultaten met bepaalde criteria overeenkomen. - Binnen de
Mustclause,aMultiMatchquery wordt gebruikt om te zoeken over meerdere velden (Title,Categories, enContent).- Stemverhoging: De
TitleHet veld krijgt een impuls.2.0, waardoor het belangrijker is in de zoekopdrachtCategoriesHij heeft een toename van1.5. Dit betekent dat documenten waar de zoekvraag in de titel of categorieën verschijnt hoger rangen. - Navraag-type: Het gebruikt
BestFields, die probeert het beste passende veld te vinden voor de vraag - Onduidelijkheid: De
Fuzziness.Autoparameter laat toe om ongeveer te overeenstemmen (e.gM SK2 manipulatie van kleine typo's ).
- Stemverhoging: De
- De zoekopdracht gebruikt een
paginatie:
- De gemeenschappelijke wetgeving van het land.
SkipDe methode overslaat de eerste.nResultaten afhankelijk van de paginanummer, berekend als(page - 1) * pageSize. Dit helpt bij het navigeren door paginade resultaten. - De gemeenschappelijke wetgeving van het land.
SizeDe methode beperkt het aantal teruggestuurde documenten tot de specifiek.pageSize.
- De gemeenschappelijke wetgeving van het land.
Fout Handling:
- Als de zoekopdracht mislukt, wordt een fout gelogd en een leeg lijst teruggestuurd.
Resultaat:
- De methode gee terug een lijst van:
BlogIndexModelDokumenten die overeenkomen met de zoek criteria.
- De methode gee terug een lijst van:
Je ziet dat we heel flexibel kunnen zijn in hoe we onze gegevens zoeken.
Eén grote voordeel is de gemakkelijke qith waarmee we meerdere talen kunnen ondersteunen. We hebben een ander index voor elke taal en kunnen zoeken binnen dat index. Dit betekent dat we het juiste analyzer kunnen gebruiken voor iedere taal en de beste resultaten krijgenM SK2
De nieuwe zoek-API
In tegenstelling tot de Search API die we in de vorige delen van deze serie zagen, kunnen we het zoekproces enorm vereenvoudigen door OpenSearch te gebruiken.
   [HttpGet]
    [Route("osearch/{query}")]
   [ValidateAntiForgeryToken]
    public async Task<JsonHttpResult<List<SearchResults>>> OpenSearch(string query, string language = MarkdownBaseService.EnglishLanguage)
    {
        var results = await indexService.GetSearchResults(language, query);

        var host = Request.Host.Value;
        var output = results.Select(x => new SearchResults(x.Title.Trim(), x.Slug, @Url.ActionLink("Show", "Blog", new{ x.Slug}, protocol:"https", host:host) )).ToList();
        return TypedResults.Json(output);
    }
Zoals je ziet hebben we alle gegevens die we nodig hebben in de index om de resultaten terug te geven. We kunnen dit dan gebruiken om een URL te genereren naar het blogpostje. Dit neemt de lading van onze database af en maakt de zoekprocessen veel sneller.
In slotting:
In deze post zagen we hoe je een C# client moet schrijven om te interageren met onze OpenSearch voorbeeld.