
Cercare il testo intero (Pt 3 - OpenSearch con ASPM SK3NET Core)


Introduzione
Nelle parti precedenti di questa serie abbiamo introdotto il concetto della ricerca completa del testo e come può essere usata per cercare il testo in una base di dati. In questa parte introduceremo come usare OpenSearch con ASP.NET CoreM SK2
Parti precedenti:
- La ricerca del testo completo con Postgres
- Scatola di ricerca con Postgres
- Introduzione a OpenSearch
In questa parte vi spiegheremo come cominciare a usare la nuova e brillante Instance OpenSearch con ASP.NET Core.
Setup
Una volta che abbiamo l'instance OpenSearch in funzione possiamo iniziare a interagire con essa. Noi' utilizzeremo il Il cliente OpenSearch per .NET. Prima abbiamo creato il cliente nella nostra estensione di Setup.
    var openSearchConfig = services.ConfigurePOCO<OpenSearchConfig>(configuration.GetSection(OpenSearchConfig.Section));
        var config = new ConnectionSettings(new Uri(openSearchConfig.Endpoint))
            .EnableHttpCompression()
            .EnableDebugMode()
            .ServerCertificateValidationCallback((sender, certificate, chain, errors) => true)
            .BasicAuthentication(openSearchConfig.Username, openSearchConfig.Password);
        services.AddSingleton<OpenSearchClient>(c => new OpenSearchClient(config));
Questo configura il cliente con l'ultimo punto e i credenziali. Noi attiviamo anche il modo di debuggere così possiamo vedere cosa sta succedendo.
Indice dei dati
Il concetto centrale di OpenSearch è l'Indice.
Per farlo noi' utilizzeremo il Il cliente OpenSearch per .NETM SK1 Potete installarlo tramite NuGet:
Lo noterete qui, la prima è quella di basso livello come la gestione delle connessioni, la seconda è quella a alto livello come l'indexazione e la ricerca.
Ora che l'abbiamo installato possiamo iniziare a guardare i dati indexati.
Creare un indice è semi-in avanti . Basta definire come dovrebbe apparire il vostro indice e poi crearloM SK2 Nel codice sotto potete vedere noi 'mapM SK1 il nostro modello di indice ( una versione semplificata del blog'il modello di base di datiMSC4 Per ogni campo di questo modello definiamo poi quale tipo sia ( testo , dataM SK2 parola chiave, ecc.
Il Tipo è importante perché definisce come i dati sono conservati e come possono essere cercati. Per esempio, un campo M SK2 testo ' viene analizzato ed etichettatoMSC4 un ' parola chiaveMNK6 il campo non èMRK7 Quindi voiMسک8d vi aspettate di cercare un campo chiave esattamente come è stato conservato, ma un campo di testo che potete cercare per parti del testo.
Anche qui le categorie sono in realtà una stringa.[] ma il tipo di parola chiave capisce come trattarli correttamente.
   public async Task CreateIndex(string language)
    {
        var languageName = language.ConvertCodeToLanguageName();
        var indexName = GetBlogIndexName(language);

      var response =  await client.Indices.CreateAsync(indexName, c => c
            .Settings(s => s
                .NumberOfShards(1)
                .NumberOfReplicas(1)
            )
            .Map<BlogIndexModel>(m => m
                .Properties(p => p
                    .Text(t => t
                        .Name(n => n.Title)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Content)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Language)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Date(t => t
                        .Name(n => n.Published)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Keyword(t => t
                        .Name(n => n.Id)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Slug)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Hash)
                    )
                    .Keyword(t => t
                        .Name(n => n.Categories)
                    )
                )
            )
        );

        if (!response.IsValid)
        {
           logger.LogError("Failed to create index {IndexName}: {Error}", indexName, response.DebugInformation);
        }
    }
Adding Items to the Index
Una volta che abbiamo creato il nostro indice per aggiungere elementi, dobbiamo aggiungere elementi a questo indice. Qui mentre aggiungiamo una BUNCH usiamo un metodo di inserzione in larga quantità.
Potete vedere che inizialmente chiamiamo un metodo chiamatoGetExistingPosts che restituisce tutti i post che sono già nell'indice. Poi raggruppiamo i posti secondo la lingua e filtramo fuori il 'ukM SK2 lingua (perche' non vogliamo l'indexare, dato che ha bisogno di un plugin extra non abbiamo ancoraMSC5non ne abbiamo ancora.
Usiamo il hash e l'id per identificare se un post è già nell'indice.
    public async Task AddPostsToIndex(IEnumerable<BlogIndexModel> posts)
    {
        var existingPosts = await GetExistingPosts();
        var langPosts = posts.GroupBy(p => p.Language);
        langPosts=langPosts.Where(p => p.Key!="uk");
        langPosts = langPosts.Where(p =>
            p.Any(post => !existingPosts.Any(existing => existing.Id == post.Id && existing.Hash == post.Hash)));

        foreach (var blogIndexModels in langPosts)
        {

            var language = blogIndexModels.Key;
            var indexName = GetBlogIndexName(language);
            if(!await IndexExists(language))
            {
                await CreateIndex(language);
            }

            var bulkRequest = new BulkRequest(indexName)
            {
                Operations = new BulkOperationsCollection<IBulkOperation>(blogIndexModels.ToList()
                    .Select(p => new BulkIndexOperation<BlogIndexModel>(p))
                    .ToList()),
                Refresh = Refresh.True,
                ErrorTrace = true,
                RequestConfiguration = new RequestConfiguration
                {
                    MaxRetries = 3
                }
            };

            var bulkResponse = await client.BulkAsync(bulkRequest);
            if (!bulkResponse.IsValid)
            {
                logger.LogError("Failed to add posts to index {IndexName}: {Error}", indexName, bulkResponse.DebugInformation);
            }

        }
    }
Una volta ' filtrati i post esistenti e il nostro analizzatore mancante, creiamo un nuovo Indice ( basato sul nome ,, nel mio caso " più chiaro "M SK4"
Voi' lo vedrete nel BulkRequest Abbiamo stabilito il Refresh proprietà a true. Significa che dopo la completazione dell'inserzione di massa l'indice viene aggiornato. Questo non èM SK2 veramente necessario ma è ' utile per la debuggingMSC4
Cercare l'indice
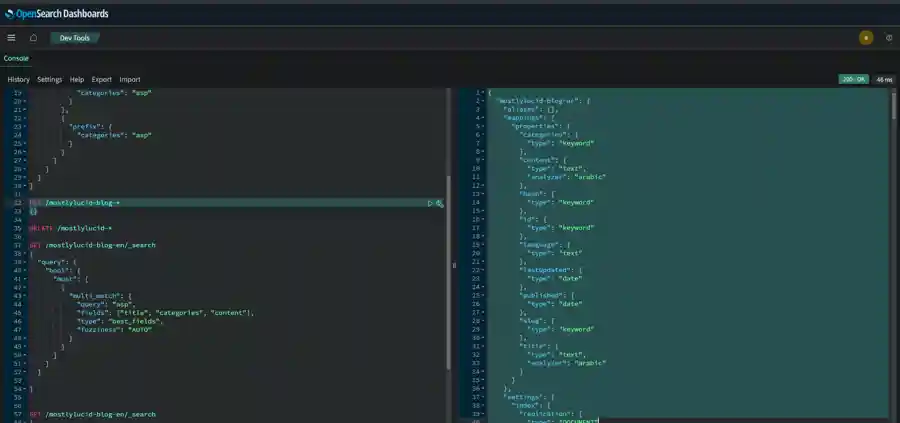
Un buon modo per testare quello che è stato creato qui è andare negli strumenti di Dev su OpenSearch Dashboards e fare una domanda di ricerca.
GET /mostlylucid-blog-*
{}
Questa domanda ci restituirà tutti gli index che corrispondono al modello. mostlylucid-blog-*. (pertanto tutti i nostri indice finoraM SK2
{
  "mostlylucid-blog-ar": {
    "aliases": {},
    "mappings": {
      "properties": {
        "categories": {
          "type": "keyword"
        },
        "content": {
          "type": "text",
          "analyzer": "arabic"
        },
        "hash": {
          "type": "keyword"
        },
        "id": {
          "type": "keyword"
        },
        "language": {
          "type": "text"
        },
        "lastUpdated": {
          "type": "date"
        },
        "published": {
          "type": "date"
        },
        "slug": {
          "type": "keyword"
        },
        "title": {
          "type": "text",
          "analyzer": "arabic"
        }
      }
    },
    "settings": {
      "index": {
        "replication": {
          "type": "DOCUMENT"
..MANY MORE
Dev Tools in OpenSearch Dashboards è un ottimo modo per testare le vostre domande prima di metterle nel vostro codice.
Cercare l'indice
Ora possiamo iniziare a cercare l'indice. Possiamo usare Search il metodo del cliente per farlo.
Ecco dove arriva il vero potere di OpenSearch. Ha letteralmente Dozzine di tipi diversi di query. Potete usare per cercare i vostri dati. Tutto da una semplice ricerca con un termine chiave a una complessa M SK1neural' search .
    public async Task<List<BlogIndexModel>> GetSearchResults(string language, string query, int page = 1, int pageSize = 10)
    {
        var indexName = GetBlogIndexName(language);
        var searchResponse = await client.SearchAsync<BlogIndexModel>(s => s
                .Index(indexName)  // Match index pattern
                .Query(q => q
                    .Bool(b => b
                        .Must(m => m
                            .MultiMatch(mm => mm
                                .Query(query)
                                .Fields(f => f
                                    .Field(p => p.Title, boost: 2.0)
                                    .Field(p => p.Categories, boost: 1.5)
                                    .Field(p => p.Content)
                                )
                                .Type(TextQueryType.BestFields)
                                .Fuzziness(Fuzziness.Auto)
                            )
                        )
                    )
                )
                .Skip((page -1) * pageSize)  // Skip the first n results (adjust as needed)
                .Size(pageSize)  // Limit the number of results (adjust as needed)
        );

        if(!searchResponse.IsValid)
        {
            logger.LogError("Failed to search index {IndexName}: {Error}", indexName, searchResponse.DebugInformation);
            return new List<BlogIndexModel>();
        }
        return searchResponse.Documents.ToList();
    }
Descrizione della domanda
Questo metodo, GetSearchResults, è progettato per fare una ricerca su un particolare indice OpenSearch per recuperare post di blog. Ci vogliono tre parametriM SK2 language, query, e parametri di paginazione page e pageSize. Qui ' è quello che fa:
Selezione dell'indice:
- Trova il nome dell'indice usando la
GetBlogIndexNamemetodo basato sulla lingua prodotta. L'indice è selezionato dinamicamente secondo la lingua.
- Trova il nome dell'indice usando la
Cercare una domanda:
- La domanda usa un
Boolla domanda con unMustuna cláusula per assicurare che i risultati corrispondano a certi criteri. - All'interno del
Mustclause, aMultiMatchla domanda è usata per cercare attraverso diversi campi (Title,Categories, eContent).- Innalzamento: Il
TitleIl campo viene stimolato.2.0, rendendolo più importante nella ricerca, eCategoriesha una spinta di1.5. Significa che i documenti dove la domanda di ricerca appare nel titolo o nelle categorie si classificano più in alto. - Tipo di domanda: Usa
BestFields, che cerca di trovare il campo migliore per la domanda - Fuzziness: Il
Fuzziness.Autoil parametro permette di approssimare i corrispondenti (e.gM SK2 manipolare i tipi minori ).
- Innalzamento: Il
- La domanda usa un
La paginazione:
- L'informazione figura nella parte dispositiva.
Skipil metodo skips the firstni risultati a seconda del numero di pagina, calcolato come(page - 1) * pageSize. Questo aiuta a navigare attraverso i risultati paginati. - L'informazione figura nella parte dispositiva.
Sizeil metodo limita il numero di documenti riportati alla specificazione.pageSize.
- L'informazione figura nella parte dispositiva.
Error Handling:
- Se la domanda fallisce, un errore è registrato e una lista vuota viene restituita.
Risultato:
- Il metodo restituisce una lista di
BlogIndexModelDocumenti che corrispondono ai criteri di ricerca.
- Il metodo restituisce una lista di
Quindi vedete che possiamo essere super flessibili nel modo in cui cerchiamo i nostri dati. Possiamo cercare campi specifici, possiamo stimolare certi campiM SK2 possiamo persino cercare attraverso diversi indiceMSC3
Uno dei vantaggi BIG è la facilità del qith che ci permette di supportare diverse lingue. Abbiamo un indice diverso per ogni lingua e possiamo fare ricerca all'interno di quell'indice. Questo significa che possiamo usare l'analisi corretta per ciascuna lingua e ottenere i migliori risultatiM SK2
La nuova API di ricerca
In contrasto con la Search API che abbiamo visto nelle parti precedenti di questa serie, possiamo semplificare enormemente il processo di ricerca usando OpenSearch. Possiamo semplicemente inserire un testo in questa domanda e ottenere grandi risultati di ritornoM SK2
   [HttpGet]
    [Route("osearch/{query}")]
   [ValidateAntiForgeryToken]
    public async Task<JsonHttpResult<List<SearchResults>>> OpenSearch(string query, string language = MarkdownBaseService.EnglishLanguage)
    {
        var results = await indexService.GetSearchResults(language, query);

        var host = Request.Host.Value;
        var output = results.Select(x => new SearchResults(x.Title.Trim(), x.Slug, @Url.ActionLink("Show", "Blog", new{ x.Slug}, protocol:"https", host:host) )).ToList();
        return TypedResults.Json(output);
    }
Come potete vedere abbiamo tutti i dati necessari nell'indice per restituire i risultati. Possiamo poi usare questo per generare un URL al post del blog. Questo toglie la carica dalla nostra base di dati e rende il processo di ricerca molto più veloceM SK2
Conclusione
In questo post abbiamo visto come scrivere un cliente C# per interagire con l'instance OpenSearch.