This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Sunday, 16 November 2025
När dina verktyg spårar sig själva, utvecklas sig själva och väljer sig själva
Anmärkning: Detta är del 8 i Semantic Intelligence-serien. Del 7 täckte den övergripande DSE-arkitekturen. Denna artikel dyker djupt in i något jag slätade över: hur verktygen själva fungerar, spåra användning, utvecklas och bli smartare med tiden.
Anmärkning: Om du trodde att arbetsflödets utveckling i del 7 var vild, vänta tills du ser vad som händer när vartenda verktyg har samma kapacitet.
I del 7 visade jag dig Riktad Synthetic Evolution: arbetsflöden som planerar, genererar, utför, utvärderar och förbättrar. Jag nämnde "verktyg" ett gäng gånger.
Här är vad jag inte förklarade:
De är inte statiska, de är inte konfigurationsfiler som sitter där oförändrade.
De är levande artefakter som:
Med andra ord: Verktyg är noder, noder är verktyg, allt utvecklas.
Och det blir konstigare.
Låt mig visa dig vad systemet faktiskt har:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
För detta ändamål ska följande gälla: index.json? 5 464 rader av verktygsdefinitioner, användningsstatistik, versionshistorik, träningsresultat och linjespårning.
Varje verktyg där inne:
OBS: Systemet kommer faktiskt att köras utan några verktyg. Bara mindre effektivt; och dummare. Utan dem skulle verktyg genereras som en normal del av arbetsflödets nedbrytning. Det skulle fortfarande långsamt anpassa sig, men det skulle ta väg fler polletter.
Låt oss titta på vad ett verktyg faktiskt är.
Här är en riktig verktygsdefinition från systemet:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Lägg märke till vad som finns där:
Men så här är det: inte I YAML:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Systemet förstärkningar statiska definitioner med inlärning i körtid.
Så här går det när du använder ett verktyg:
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Vad som spåras:
Låt oss titta på cachemekanismen.
Den smartaste biten: Systemcacheverktyget anropar på flera nivåer.
Nivå 1: Exakt matchningscachelagring
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Därför är detta viktigt:
Om du ber systemet att "skriva en haiku om kod" två gånger, är andra gången ögonblick. LLM kör inte. RAG-minnet returnerar det cachade resultatet.
Men här är den smarta biten: den returnerar BEST-versionen Om flera finns.
Exempel:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Systemet väljer automatiskt det cacheerade resultatet av högsta kvalitet.
En av de subtilare egenskaperna: systemet lär sig hur lång tid varje modell tar för att svara.
Problemet:
Olika modeller har helt olika svarstider:
tinyllama (2B): ~3 sekunderllama3 (8B): 10 sekunderqwen2.5-coder (14B): ~25 sekunderdeepseek-coder-v2 (16B): ~60 sekunderOm du ställer in en global timeout (säg, 30s), slösar du 27 sekunder väntar på tinyllama, och du dödar deepseek Innan den är klar.
Lösningen: Adaptive Learning
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Hur det fungerar:
Resultat:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Systemet lär sig rätt timeout för varje modell istället för att använda ett globalt värde.
När du ber systemet att göra något, det inte bara välja den första matchande verktyg. konditionsfunktion över flera dimensioner.
Beräkning av ändamålsenlighet:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Verkligt exempel:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Markerade: email_validator_workflow (lämplighet: 190)
Systemet väljer snabb, fri, hög kvalitet, bevisad Inte den mest semantiska, inte den mäktigaste.
Den som optimalt uppfyller flera begränsningar.
Verktygen är inte statiska, de utvecklas.
Versionssökning och förändringsdetektion:
Varje verktyg har en Definition av "hash" beräknad utifrån dess YAML:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
När du redigerar ett verktygs YAML:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Vid nästa laddning:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Semantisk version:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Brytning av ändringar:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Vid belastning:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Systemet varnar dig för att bryta förändringar och upprätthåller versionshistorik.
Varje verktyg indexeras i RAG minne för semantisk sökning:
Vid laddningstid:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Nu när du söker:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Systemet använder RAG-inbäddningar för att hitta relevanta verktyg och sedan ranka dem efter Flerdimensionell träning.
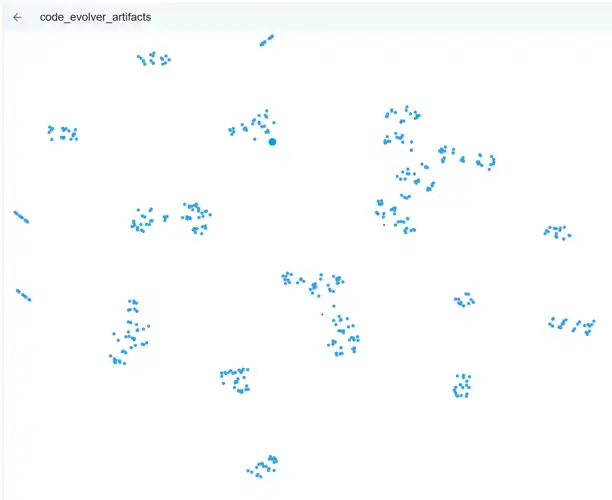
I vårt system sparar vi vektorerna till inbäddningarna i Qdrant Ordförande en vektordatabas och det ger oss ett snyggt sätt att se hur vår verktygsutrymme. Detta är minnet systemet för vårt arbetsflöde byggsystem.
Delas upp i de ursprungliga mallarna (yaml-filer i verktygskatalogen) och varje element av kod som genereras för att lösa en uppgift (och konfiguration för llms etc). Dessa form till verktygslåda för att montera arbetsfängor. Förbyggda bitar från;
På så sätt är hela workdlow kompatibel och testbar eftersom varje Python-element har en serie tester, BDD spec, statiska verktyg för att verifiera korrekthet och flera LLM-utvärderare för att säkerställa att det fungerar.
sidoeffekten är VARJE kod som kommer att köras i ett arbetsflöde är precis där, redo att inspektera som varje "verktyg" skapande leder till inspekteras Python scripes.
Du kan se för klumpar tillsammans med varje blob är en semantant länkade uppsättning av verktyg som:
Alla grupperade tillsammans. Naturligtvis specialiserat på systemets natur.
I framtiden skulle vi sannolikt vilja optimera dessa kluster för att minska kodbasen till ett mindre, stramare och mer optimerat system.
Eftersom vi kan spåra versioner, användningar, förändringar och lögn kan vi selektivt optimera och "kluster defrag" tnhe mest använda och mest prestandakritiska comopnents som en del av hur systemet är i sig struktur.
Låt oss titta på vad som faktiskt finns i systemet nu.
LLM Tools (27 specialister):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Verktyg som kan köras:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
OpenAPI- verktyg:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Totala verktyg: 50+
Totala rader för metadata: 5 464 linjer i index.json
Låt mig visa dig det mest sofistikerade verktyget i systemet: kod_optimeringsmedel.
I denna förordning gäller följande definitioner: tools/llm/code_optimizer.yaml (317 rader!)
Vad den gör:
Hierarkioptimering:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Kostnadshantering:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Integrering av test:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Versionshantering:
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Detta Ett enda verktyg Andra, med en bredd av mer än 30 cm
Och det är bara ett verktyg i ett system med 50+ verktyg.
Ett av de mest metaverktyg: Modell_väljare.
Naturligt språkval:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Hur det fungerar:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Systemet tolkar naturligt språk för att välja modeller. Du kan säga:
Och det går intelligent till höger backend.
Systemet behandlar externa API:er på samma sätt som interna verktyg.
Exempel: NMT Översättare
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Vid körning:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Vad som spåras:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Externa API:er får samma behandling:
Ett av de vildaste verktygen: workflow_ documenter.
Vad den gör:
Kräver ett arbetsflöde (a) main.py fil) och automatiskt genererar omfattande dokumentation av:
README.txtAlla automatiskt.
I denna förordning gäller följande definitioner: tools/llm/workflow_documenter.yaml (11.803 tecken!)
Inmatning:
{
    "workflow_path": "nodes/email_validator/main.py"
}
Utmatning:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
F: Kan detta verifiera om ett e-postmeddelande finns? S: Nej, det här validerar bara format. Använd DNS/SMTP-kontroll för existens.
F: Stödjer den internationella domäner? S: Ja, men konvertering av yneycode kan behövas.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Användaren: "Jag behöver ett verktyg som omvandlar temperaturer"
System:
Nytt verktyg skapat: temperatur_converter.yaml
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Systemet känner till följande:
Och det använder dessa data till:
Låt oss gå tillbaka och tänka på vad vi faktiskt har byggt:
Ett system där
Vi har skapat en självoptimerande verktygslåda som:
Det här är inte konfigurationshantering.
Detta är en framväxande verktygsekologi.
Verktyg är inte statiska resurser. levande artefakter i ett evolutionärt system.
Scenario 1: Självförbättrande kritisk väg
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Systemet optimerade sin egen kritiska väg utan mänsklig inblandning.
Scenario 2: Anpassningsbar specialisering
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Systemet identifierade ett mönster och skapade ett specialiserat verktyg.
Scenario 3: Kostnadsmedveten Escalation
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Systemet använde pengar på ett intelligent sätt för att uppnå bättre resultat.
Låt mig katalogisera vad som faktiskt existerar just nu.
Kodspecialist
code_explainer - Förklarar kod i naturligt språkcode_optimizer - Hierarkioptimering (lokal/moln/djup)code_reviewer - Kvalitets- och säkerhetsöversynfast_code_generator - Snabb generation med små modellersecurity_auditor - Sårbarhetsskanningperformance_profiler - Kodprofilering och analysInnehåll Specialister:
long_form_writer - Romaner, böcker (128K sammanhang)content_generator - Allmänt innehållarticle_analyzer - Artikelstruktur/kvalitetsummarizer - Sammanfattar långt innehållproofreader - Grammatik och stilseo_optimizer - SEO optimeringoutline_generator - InnehållsbeskrivningarÖversättning:
quick_translator - Snabb översättning (liten modell)translation_quality_checker - Validerar översättningarDokumentation:
doc_generator - Koddokumentationtechnical_writer - Teknisk dokumentationworkflow_documenter - Skapar arbetsflöden automatisktSystemverktyg:
general - Reträtt för allmänna ändamålmodel_selector - Väljer bästa gränssnitt/modelltask_to_workflow_router - Vägar uppgifter till arbetsflödenquick_feedback - Snabb triagesignalr_connection_parser - Parses SignalR-anslutningarsignalr_llmapi_management - Hanterar SignalR LLM API:erValidering:
call_tool_validator - Validerar användning av call_tool()python_syntax_validator - Syntaxkontrollmypy_type_checker - Statisk typkontrolljson_output_validator - Validering av JSON-formatstdin_usage_validator - Validerar användning av stdinmain_function_checker - Kontroller för funktionen main()node_runtime_import_validator - Validerar importAnalys:
run_static_analysis - Kör statiska analysverktygperformance_profiler - Prestanda för profilkoderVerktyg:
save_to_disk - Diskpersistensunit_converter - Enhetsomvandlingarrandom_data_generator - Produktion av testdatabuffer - Bufferthanteringworkflow_datastore - Lagring av arbetsflödesdatastream_processor - Strömbehandlingsse_stream - Server-skickade händelserIntegrering:
connect_signalr - SignalR-anslutningsignalr_hub_connector - Hub-anslutningsignalr_websocket_stream - WebSocket streamingDokumentation:
document_workflow - Arbetsflöde dokumentationsgeneratornmt_translator - Neural maskin översättning APITotalt: 53 verktyg (och växande)
Här blir det riktigt intressant: Verktyg som består av andra verktyg.
Och när ett sammansatt verktyg utvecklas, varje arbetsflöde som använder det förbättrar automatiskt.
Låt oss titta på en faktisk sammansatt verktyg från systemet:
Uppgift: "Överför denna artikel till spanska och validera kvalitet"
Traditionellt tillvägagångssätt:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
Tillvägagångssätt för DSE:
Systemet upptäcker detta mönster används ofta och automatiskt skapar ett kompositverktyg:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Vad är galet med det här:
När nmt_translator utvecklas till v2.0.0 (kanske 20% snabbare), det sammansatta verktyget använder automatiskt den nya versionen. Inga kodändringar behövs.
Resultat: Varje arbetsflöde som använder validated_translator får 20% snabbare utan någon ändring.
Här är ett ännu coolare exempel: Parallell verktygssammansättning.
Uppgift: "Överväg denna kod noggrant"
Naive tillvägagångssätt:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE parallell sammansättning:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Genomförande:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Resultat: 35 sekunder → 20 sekunder (43% snabbare!)
Och när security_auditor utvecklas till v3.0.0 (säg, 30% snabbare), hela kommittén blir snabbare automatiskt.
Här är delen som verkligen är vild: verktyg fungerar som gener.
Anmärkningar: När ett verktyg visar sig användbart, sprids genom systemet.
Verkligt exempel: Mönstret för kvalitetskontroller
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Detta är bokstavlig genetisk spridning:
Kodsökvägen är alltid optimal eftersom:
Här är den riktigt smarta biten: du kan förbättra alla verktyg på en gång.
Scenario: Du har 20 arbetsflöden, var och en med 5-10 verktyg. Totalt: ~100 verktyg anropar.
Traditionellt system:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
DSE-system:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Resultat:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Du tränade ONE tool och förbättrade EIGHTEEN arbetsflöden samtidigt.
Den riktigt vilda delen: Utvecklingskaskader genom beroendekurvan.
Exempel:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
En evolutionshändelse förbättrade ELEVEN-arbetsflödena utan någon manuell åtgärd.
Eftersom verktyg spår fitness, cache resultat, och auto-evolve, systemet alltid kör bästa tillgängliga genomförande.
Exempel på utförande:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Systemet:
Kodsökvägen är optimerad vid varje steg:
Låt oss vara exakt om varför detta är Riktad syntetisk utveckling och inte bara "caching med version":
Verktyg som gener:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Riktad utveckling:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
"Gene Pool":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Genetisk spridningsvisualisering:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
Genetisk arvsmassa:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Neat, eller hur?
Ja, det är helt galet.
Vi byggde ett system där:
Det är ingen metafor.
Det är faktiskt regisserad syntetisk evolution.
Efter att ha kört detta system i veckor:
Om verktyg kan:
Vad händer nu?
Här är vad del 7 inte helt förklarade:
De är gjorda av verktyg. Verktygen som består av arbetsflöden utvecklas också. Systemet som hanterar evolutionen? - Mätvärdena som spårar konditionen?
Det är verktyg hela vägen ner.
Och varenda en:
Vi byggde ingen kodgenerator.
Vi byggde en självutvidgande, självoptimerande, självdokumenterande verktygslåda som råkar generera kod.
Skillnaden är viktig.
För när verktyg blir evolutionära enheter, när de följer sin egen kondition, när de reproducerar och mutera och tävlar...
Du har ingen verktygslåda.
Du har en ekologi.
Och ekologier utvecklas.
Men vad händer när evolutionen bryter ner saker och ting? När en verktygsmutation introducerar en kritisk bugg? När optimering gör ett verktyg sämre istället för bättre?
Det är där del 9 kommer in. Självläkning genom ättling-aware beskärning—Ett system där verktyg inte bara utvecklas, de minns varje misslyckande, beskära misslyckade grenar, och sprida denna kunskap för att förhindra liknande misstag i hela ekosystemet.
När dina verktyg kan bryta sig själva, ditt system bör komma ihåg varför och aldrig upprepa misstaget.
Arkivering: mestadelslucid.dse
Nyckelfiler:
src/tools_manager.py (2 293 rader) – Hantering av kärnverktygsrc/rag_integrated_tools.py (562 rader) – Integrering av regionala aktionsgruppersrc/openapi_tool.py (313 rader) - Stöd för OpenAPIsrc/model_selector_tool.py (460 rader) - Val av modelltools/index.json (5 464 rader) - Verktygsregistertools/llm/*.yaml (27 verktyg) - Definitioner av LLM-specialistertools/executable/*.yaml (19 verktyg) - Körbara verktygtools/openapi/*.yaml (3 verktyg) - API-integrationerDokumentation:
LLMS_AS_TOOLS.md - System för urval av lLMWORKFLOW_DOCUMENTATION_TOOL.md - Automatisk dokumentationCHAT_TOOLS_GUIDE.md - Guide för verktygsanvändningTOOL_PACKAGING.md - Guide för verktygsutvecklingSerienavigering:
Detta är del 8 i Semantic Intelligence-serien. Del 7 visade den övergripande DSE-arkitekturen. Den här artikeln visar den dolda komplexiteten: varje verktyg i systemet spårar användning, utvecklar implementationer, cacheresultat och deltar i fitness-baserat urval. Verktygslådan är inte bara en resurs – det är en evolutionär ekologi som expanderar, optimerar och dokumenterar sig själv. Verktyg genererar verktyg. Verktyg förbättrar verktyg. Och hela systemet blir smartare med tiden.
Koden är verklig, kör lokalt på Ollama, verkligen spåra mätvärden, och faktiskt utvecklas. Det är experimentell, ibland instabil, och definitivt "vibe-kodas." Men verktygen fungerar, spårning fungerar, och evolutionen fungerar. Verktygslådan växer sig själv.
Dessa utforskningar ansluter till sci-fi-romanen "Michael" om framväxande AI och implikationerna av system som optimerar sig själva. De verktyg som beskrivs här är verkliga implementationer som visar hur evolutionärt tryck skapar specialisering, hur fitnessfunktioner vägleder urval, och hur självförbättrande system naturligt utvecklar ekologiliknande egenskaper. Oavsett om detta leder till planetskalan verktygsnätverk i del 6, eller något helt oväntat, återstår att se. Det är det som gör det till ett experiment.
Taggar: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
