
Semantisk intelligens


När dina verktyg följer sig själva
Nota: Det här är en del 8 i den semantiska intelligensen- -.. En del | 7. Omfattade den generella DSE-Architekturen. .. Den här artikeln dyker djupt in i något jag pratade om. hur verktygen själva fungerar
Nota: Om du tyckte att utvecklingen av arbetsflödet i del 7 var vild, vänta tills du ser vad som händer när varje enda verktyg har samma egenskaper.
Sakdelen 7 Sa inte ' till dig
I delen 7, visade jag er riktade syntetiska evolutioner : arbetsflöden som planerar , genererar M SK3 utför, , utvärderar, , och förbättrar,. Jag nämnde ♫ " ♫ verktygen ♫ МSK8 ♫ en massa gånger ♫
Här är vad jag inte förklarade.
De verktygen, ?, de ', är inte statiska. ., dem ', är inga konfigurationsfiler som finns där utan att ändras.
De är levande artefakter som
- spåra varje invocation
- Lär dig från användarbeteenden
- Att utveckla sina egna implementeringar
- Cache lyckade svar
- Förbereda hälsohandel
- Versionen själv automatiskt
- få återanvända genom hela systemet
Med andra ord: verktyg är noder . Noder är verktyg. Allting utvecklas
Och det blir konstigare
Toolsregistern: En själv
Låt mig visa er vad systemet faktiskt har
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
Det index.json? 5,464 linjer av verktygsdefinitioner, användarstatistikar, versionshistorien , konditionstillståndsresultatM SK3 och stamspårning
Alla verktyg däri
- Har användningsmätare
- Träger ut kvalitetvärden från utvärderingar
- Håller versionshistorien
- länkar till RAGs minnesartefakter
- Speicherar prestationsmått
- Rekordar framgångsrika invocationer
NOTET: Systemet kommer faktiskt att fungera utan några verktyg . Bara mindre effektivt ; och dumma, . Utan dem skulle verktyg skapas som en normal del av arbetsflödets nedbrytning.
Låt oss titta på vad ett verktyg faktiskt är
verktygsanalys: Mer än konfiguration
Här är en riktig verktygsdefinition från systemet.
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Titta på vad
- Förvaltningsnivåer - kostnaderna , hastighet M SK2 kvalitet
- Specialisering - Vad är detta verktyg? bra på:
- Kapasiteten - Max utgångslängd
- Templates - Hur man invokerar det
- Tags - Semantisk kategorisering
Men här är vad inte i YAML:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Systemet förstärker statiska definitioner med starttidslärning
Usage Tracking: Varje invocation spelar roll
Här är vad som händer när du använder ett verktyg
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Vad blir spårat:
- Invocationsmetadata - verktygsidentifisering , modell
- Förmågor - Lansighet, minneM SK2 responstid
- Jakt - Evaluator-värde , användarfeedback
- Caching - Exakt promptmatch för återanvändning
- Passform - Multidimensionell scoring
Låt oss titta på kaskande mekanismen.
Hierarkisk Caching: Computera aldrig två gånger
Den smartaste biten: systeminvocationer av verktyg i flera nivåer.
Pozition 1: Exakt match Caching
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Varför är detta viktigt:
Om du frågar systemet att " skriva en haiku om koden " två gånger ögonblicklig. LLM inte sätter igång
Men här är det smarta: den återvänder den bästa versionen om flera existerar.
exempel:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Systemet urvisar automatiskt den högsta kufferresultatet av kvalitet.
Adaptivt Timeout-lärning: Sluta gissa
En av de subtilare egenskaperna, :, är att systemet lär sig hur lång tid varje modell tar för att svara.
Problemet:
Skillnade modeller har helt olika responsstid:
tinyllama(2BM SK1 ~3 sekunderllama3(8BM SK1 ~10 sekunderqwen2.5-coder(14BM SK1 ~25 sekunderdeepseek-coder-v2(16BM SK1 ~60 sekunder
Om du sätter upp ett globalt avbrott, så slösar du bort några sekunder till att vänta tinyllama, och du dödar deepseek innan den slutar.
Lösningen: Anpassningslärning
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Hur det fungerar:
- spåra reaktionstid för varje modell
- Beräkna 95ste percentil (de flesta reaktioner slutar vid den här tidpunkten
- Lägg till 20% buffer för säkerhet
- Använd det som den nya utgången
Resultat:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Systemet lär sig rätt tidpunkt för varje modell istället för att använda ett globalt värde.
Multi-Dimensional Fitness: När man väljer rätt verktyg
När du frågar systemet att göra något, så gör det inte. konditionsfunktion över flera dimensioner.
Fitnessberäkningar:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Ett riktigt exempel:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Utvalda: email_validator_workflow (
Systemet väljer snabb, gratis , hög- kvalitetM SK3 bevisat lösning. Inte den mest semantiskt liknande . Inte det mest kraftfulla.
Den som optimalt tillfredsställer flera begränsningar.
Tool Evolution: Self-Improverande implementeringar
verktyg inte är statiska de utvecklas
Versionering & Detektor av förändringar:
Varje verktyg har en definition hash beräknat från dess YAML:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
När du redigerar ett verktyg
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Vid nästa belastning:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Semantisk versionering:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Breaking Changes:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
På belastning:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Systemet varnar dig om att bryta förändringar och underhåller versionshistorien.
RAG integration : verktyg som semantiska artefakter
Alla verktyg blir indexerade i RAG minnet för semantisk sök
Vid laddade tid:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Nu när du söker
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Systemet använder RAG-inbäddar att hitta relevanta verktyg, sedan rangerar de efter multi-dimensionell tillpassning.
Nutsruta
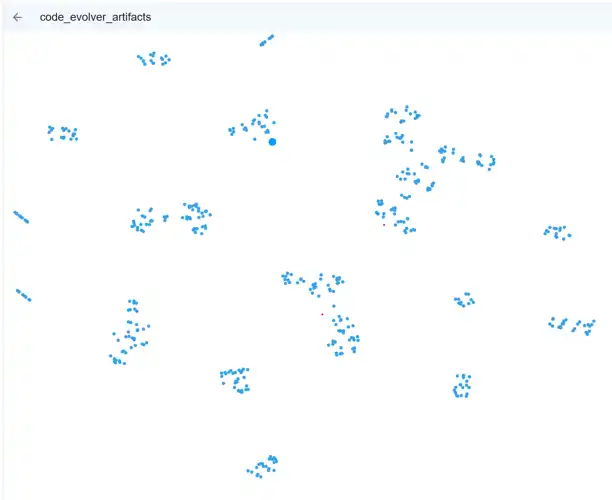
I vårt system sparar vi vektorerna för inbäddarna i Qdrant en vektordatabas och det ger oss ett prydligt sätt att se hur vår verktygslåda
Delade in i de ursprungliga mallerna (yaml-filerna i verktygskatalogen ) och varje element av kod som skapats för att lösa en uppgift ♫ ( ♫ och konfiguration för llms etc ♫ De formeras till verktygslåda för att montera arbetsbänkar
- Den ursprungliga prompten - kunde vi bygga från ny !
- Hela arbetsflödet - som med allt annat ett verkligt python skript
- Varje verktyg använder - som kallade ett verktyg , när
- Varje Python-funktion (data från arbetsflödet
På det här sättet är allt arbetenskomposerat och testbart eftersom varje Python-element har en uppsättning tester, BDD-specifikationen , statiska verktyg för att kontrollera korrektheten & flera LLM-värdare för att se till att det fungerarM SK3
biverkningar är: Varenda bit kod som körs i ett arbetsflöde är precis där.
Ni kan se att toosen kvävlar tillsammans med varje flod som är en semantiskt länkad uppsättning verktyg som
- Lägg till 1 plus 2
- Lägg till 1 plice 3
- Lägg till numbe x plus y
- och den optimerade x+y-kodexmetoden
Alla sammanslagna. Naturligt specialiserad på systemet
I framtiden vill vi förmodligen optimera dessa kluster för att reducera kobasen till ett mindre system.
Eftersom vi kan följa versioner, tillämpningar , ändringar och utbredning kan vi selektivt optimera och ' klusterfraggaM SK3 de mest använda och mest effektiva kritiska komponenterna som en del av hur systemet är inhärdligt strukturerat
Det rika ekosystemet som uppstod
Låt oss titta på vad som faktiskt finns i systemet nu.
LLM Tools (27 experter):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Rakbara verktyg:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
OpenAPI verktyg:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Total verktyg: 50+
Totala rader av metadata: 5,464 linjer i index.json
Ett verkligt exempel: En kodoptimeringsverktyg
Låt mig visa er det mest sofistikerade verktyget i systemet: kod_optimisator.
Definitionen: tools/llm/code_optimizer.yaml (317 linjer
Vad gör den:
- Profil basnivå performance
- analyserar bottlenecks (CPU, IM SK2OMSC3 minnet )
- Väljer optimeringsnivå:
- LOCALA ( fria, 10-20% förbättringM SK3
- KLUDER (betaledd, 20-40% förbättringM SK3
- DEEP ( billigt , system
- Optimerar kod på den markerade nivån
- Aktualiserar tester automatiskt
- Profil optimerad version
- jämför före/efter
- Bestämdar accepte/reflektera
- Versioner om accepterat
- Migrationer användande om inget brytande ändras
Hierarkisk optimering:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Kusthantering:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Integrationstest:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Versionsmanagement:
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Det här ett enda verktyg orkestrer:
- 3 profilering körs
- Multi-nivå LLM optimering
- Automatisk testuppdatering
- Förmågorsvergleich
- kostnaden
- Versionsmanagement
- Auto-migration
Och det” ' ” bara ett verktyg i ett system med 50+ verktyg.
Modellselektor: LLMs Välja LLM
En av de mest meta-verktygna: modell_selektor.
Naturligt språk urval:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Hur det fungerar:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Systemet analyserar naturlig språk att välja modeller. Du kan säga
- "använd gpt
- " plocka den snabbaste modellenM SK1
- "Jag behöver en lång kontext för den här boken "
- "använd den kraftfullaste koden llm
Och den riktar sig intelligent till den högra baksidan.
OpenAPI-integration: Externa verktyg som första sorts medborgare
Systemet behandlar externa APIs på samma sätt som inre verktyg.
exempel: NMT översättare
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Vid starttid:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Vad blir spårat:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Externa API får samma behandling:
- Användarspårning
- Tillverkningsmått
- Jakt scoring
- Fitnessberäkningar
- RAG-indexering
Workflow-Dokumentatorn: Meta-Tool
En av de vildaste verktygen: arbetsflödet_documenter.
Vad gör den:
Ta ett arbetsflöde (a main.py file) och genererar automatiskt en komplett dokumentation av:
- Att läsa koden
- Att extrahera ingångar/utgångar
- Att upptäcka verktygssändningar
- Analisering av komplexitet
- Generera simmarediagram
- Att skapa användandeexempler
- Att skriva FAQs
- Att spara till
README.txt
Allt automatiskt.
Definitionen: tools/llm/workflow_documenter.yaml Character: (11,803
Input:
{
    "workflow_path": "nodes/email_validator/main.py"
}
utgång:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
Till exempel:
API-sändning
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
Python
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
Vanligt användande fall
- FormularsValidering vid ingång
- E-post-domainbevakning för företagspost
- En stor mailingslista städning
- API-inputsvalidation
Förmågor
- Rymden: Väldigt snabbt (< 50ms)
- kostnaderna: Gratis (pure Python)
- Precision: 99%+ för vanliga e-postformat
Begränsningar
- Verifierar inte att e-mail faktiskt existerar
- Ser inte på DNS-registrer
- Complexa RFC-kollektiva randfall kan misslyckas
FAQ
Q: Kan man kontrollera om en e-mail existerar? A: Nej
Q: Ondersteuner den internationella domains? A: Ja , men skriftikod omvandling kan behövas
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Användare: "Jag behöver ett verktyg som konverterar temperaturer "
System:
- Söker på RAG för liknande verktyg
- finner "enhetM SK1konverter" (generisk konvertörMSC4
- Koder kod_generator för att skapa specialiserad "temperatur_konverterM SK3
- kör tester
- Bedömer kvalitet
- Storer i RAG
- Registrerar som ett nytt verktyg
- Genererar dokumentation automatiskt
- Lägger till verktygsregister
Nu skapades ett nytt verktyg: temperatur
- Version: 1.0.0
- Jakt : 0.88
- Rymden: mycket - snabbt
- kostnad: gratis
- Insererad i index.json
- Indiserad i RAG
- Dokumentation skapad
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Systemet vet:
- Hur många verktyg finns det?
- Vilka typer är mest vanliga
- Vilka tag är populära
- Vilka verktyg används mest
Och det använder denna data till:
- Suosita liknande verktyg
- Identifiera luckor (missing tool types)
- Prioritera optimering. (optimera hög nivån.
- Suggest consolidation (kolla ihop liknande låga apparaterM SK1användbar apparat, )
Det obehagliga förverkligande
Låt oss ta ett steg tillbaka och tänka på vad vi faktiskt har byggt.
Ett system där
- verktygen följer deras egen användning
- Ger sig själva verktyg för versionen
- verktyg utvecklar sina implementeringar
- verktyg skapa andra verktyg
- Ger sig själva verktyg för att dokumentera
- verktyg väljer sig själva baserat på passform
- verktyg kastar sina egna invocationer
- verktyg för att lära sig optimala avbrott
- verktyg för att hantera handel
Vi har skapat en självoptimerande verktygslåda som
- Expanderar sig själv (skaper nya verktyg)
- Försämrar sig själv ( optimerar existerande verktyg)
- Dokumenten gör sig själv (automatiskt -genererar dokument
- Väljer sig själv (pasthet-baserad routeringM SK2
- Caches själva (hierarchisk Memoisering)
- Versioner själva (automatisk semver)
- Lärar sig från sig själv (adaptiv prestationstunning
Det här är Konfigurationsmanagement
Det här är emergent tool ecology
verktyg är inte statiska resurser levande artefakter i ett evolutionärt system.
Vad detta gör möjligt? ( Och varför det är så?
Scenario 1: Själva- Förhöjning av kritiska väg
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Systemet optimerade sin egen kritiska väg utan mänsklig ingripande.
Scenario 2: Adaptiv specialisering
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Systemet identifierade en mönster och skapade ett specialiserat verktyg.
Scenario 3: kostnad - medveten utbredning
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Systemet spenderade pengar på ett smart sätt för att få bättre resultat.
Tools-manifestet: Den nuvarande uppsättningen
Låt mig katalogisera vad som faktiskt finns just nu
LLM verktyg (27)
Kodspezialist
code_explainer- förklarar koden på ett naturligt språkcode_optimizer- Hierarchisk optimering lokalt/molnetM SK3djupcode_reviewer- Kvalite och säkerhetskontrollfast_code_generator- Vinnig skapande med små modellersecurity_auditor- Vulnerability scanningperformance_profiler- Kodprofilering och analys
innehållsspecialister:
long_form_writer- Romanercontent_generator- allmän innehållarticle_analyzer- Artikelstrukturen /kvalitésummarizer- sammanfattar lång innehållproofreader- Grammar och stilseo_optimizer- SEO optimeringoutline_generator- innehållsgränserna
översättning:
quick_translator- snabb översättning klein modelltranslation_quality_checker- Validaterar översättningar
Dokumentation:
doc_generator- Koddokumentationtechnical_writer- Teknikdokumentationworkflow_documenter- Automatiskt -genererar arbetsflödetdocs
Systemverktyg:
general- Generalmodel_selector- Väljar den bästa baksidan /modelltask_to_workflow_router- Routerar uppgifter till arbetsflödenquick_feedback- snabb triagesignalr_connection_parser- Belyser SignalR kopplingarsignalr_llmapi_management- hanterar SignalR LLM APIs
Rakbara verktyg (19)
Validering:
call_tool_validator- Validaterar sändning_tool () användandepython_syntax_validator- Syntakskontrollmypy_type_checker- Statisk typkontrolljson_output_validator- JSON-formatets valideringstdin_usage_validator- Validerar stdins användandemain_function_checker- Kontroller för huvudfunktionen ()node_runtime_import_validator- Validaterar importer
Analytik:
run_static_analysis- kör statiska analysverktygperformance_profiler- Profilkodpresterande
Nutsprogram:
save_to_disk- Disketthållighetunit_converter- Konverteringar av enheterrandom_data_generator- Testdatagenereringbuffer- Bufferstyrningworkflow_datastore- Storage av data från arbetsflödetstream_processor- Strombehandlingsse_stream- Server
Integration:
connect_signalr- SignalR kopplingsignalr_hub_connector- Hubuppkopplingsignalr_websocket_stream- WebSocket-strömningar
Dokumentation:
document_workflow- Dokumentationsgenerator för arbetsflödet
OpenAPI verktyg (3)
nmt_translator- Neurola maskinöversättning API- (2 andra för framtida yttre tjänster )
Totalt: 53 verktyg ( och växandeM SK3
verktygskomposition: När verktyg ropar på verktyg
Här är det där det blir riktigt intressant verktyg komponerar andra verktyg.
Och när ett komponerat verktyg utvecklas varje arbetsflöde som använder den förbättras automatiskt.
Ett verkligt exempel : Den översättningskedjan
Låt oss titta på ett riktigt kompositverktyg från systemet
Uppgift: " översätta artikeln till spanish och validera kvalitet
Traditionell tillvägagångssätt
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
DSE-metoden:
Systemet upptäcker att detta mönster används ofta och skapar automatiskt ett komposit:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Vad är det galet med den här?
När nmt_translator utvecklas till v använder den nya versionen automatiskt. Ingen kodförändring behöver göras.
Resultat: Varje arbetsflöde som använder validated_translator får 20% snabbare utan några ändringar.
Parallella implementering av verktygen: Kodövervakningskommitan
Här är ett ännu häftigare exempel parallella verktygskomposition.
Uppgift: "Revisera den här koden noggrant
Naiv tillvägagångssätt:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE parallella sammansättning:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Execution:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Resultat: 35 sekunder → 20 sekunder
Och när security_auditor utvecklas till v
Genetisk spridning: verktyg som replikerande enheter
Här är den del som verkligen är vild verktyg fungerar som gener.
Bevakning: När ett verktyg visar sig användbart, så gör det sprider sig genom systemet.
Ett verkligt exempel : Kvalitekontroll Pattern
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Detta är bokstavlig genetisk spridning
- Replicering - verktyg kopieras till nya arbetsflöden
- Mutation - verktyg utvecklas
- Tillvägagång - högre kondition = mer tillämpning
- Specialisering - Framgångsrika mönster ger ut varianter
- Erfarenhet - Barnverktyg härrar metadata från föräldrar
Kodvägen är ALWAYS optimal eftersom:
- Höga-passningsverktyg blir mer ofta väljade
- Utvecklade verktyg auto- sätter upp äldre versioner
- Specialiserade varianter dyker upp för vanliga mönster
- Low-Fitness verktyg blir prunerade
Att träna hela arbetsflödet samtidigt
Här är det riktigt smarta: du kan förbättra alla verktyg på en gång.
Scenario: Du har 20 arbetsflöden , var och en med hjälp av ♫ 5-10 ♫ verktygen ♫
Traditionellt system:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
DSE system:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Resultat:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Du tränade ONE verktyg och förbättrade 18 arbetsflöden samtidigt.
Cascading Evolution: När förbättringar kommer fram
Den riktigt vilda delen: evolutionen kaskader genom beroende grafen.
exempel:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
En evolutionär händelse förbättrade ELEVENs arbetsflöden utan manuell ingripande.
Always-Optimerad kodpfad
Eftersom verktygen följer passformen, ,, Cacheresultat och ,, och automatiserat, M SK2, utvecklas, ,, så utvecklas systemet driver alltid den bästa tillgängliga implementeringen.
Exemplationsöverdrag:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Systemet:
- Använder alltid den högsta utrustningen
- Använder alltid den senaste versionen
- Cachear alltid framgångsrika resultat
- Jag följer alltid prestationen
- Allting förbättras över tid
Kodbanan optimeras vid varje steg
- Tillvägagångssätt (vikt-baseradeM SK2
- Selektion av version ( bäst )
- Execution (cached om möjligt)
- Att lära sig ( mätdata uppdaterad)
- Evolution ( trigerade om nedbrytning upptäckts)
Direkterad syntetisk evolution: Genetiskt perspektiv
Låt oss vara exakta på varför det är så. riktad syntetisk evolution och inte bara "caching med versionering
verktyg som Genes:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Direkterad Evolution:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
"Gene Pool":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Genetisk spridningsvisualisering:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 stroke:#ef4444,stroke-width:3px
    style T2 stroke:#10b981,stroke-width:3px
    style T3 stroke:#6366f1,stroke-width:3px
    style W1 stroke:#eab308,stroke-width:3px
    style W2 stroke:#eab308,stroke-width:3px
    style W3 stroke:#eab308,stroke-width:3px
    style U1 stroke:#f59e0b,stroke-width:3px
    style U2 stroke:#f59e0b,stroke-width:3px
Genetiskt arv:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Ned, höger ?
Ja. Det ' är verkligen vild
Vi byggde ett system där
- verktyg som replikerar som gener
- Passform bestämmer överlevnad
- Evolutionen styrs av data
- förbättringar kaskader genom beroenden
- Hela kodexbasen optimerar sig själv
Det är inte en metafor.
Den verkliga riktade syntetiska evolutionen
Vad fungerar egentligen?
Efter att ha kört systemet i veckor:
Vad fungerar ✓
- Användarspårning - exakta mätare , prestationsmått
- Fitness-baserad val - Verkligen väljer bättre verktyg
- Hierarkiska kassering - Massiv hastighet för upprepade begäran
- Anpassningsmässiga avbrott - Modeller får lämpliga väntatid
- verktygsversionering - Samver fungerar , brytande förändringar upptäckta
- RAG-indexering - Syntetiska sökningar hittar relevanta verktyg
- OpenAPI-integration - Externa APIs fungerar ömtlöst
- Auto-dokumentation - arbetsflödet _documenter är förvånansvärt bra
- Kodoptimering - Hierarkiska nivåer spara pengar och förbättra kvalitet
Vad är det som är svårt?
- verktygsexplosion - 53 verktyg innebär valförsämring
- Överlappande möjligheter - Flera verktyg gör liknande saker
- Inkonsistent kvalitet - Några verktyg utmärkta , andra medelmåttiga
- Cache-invalidering - Det är svårt att veta när kasserade resultat är förlegade
- Versionsmigrationen - Automatiskt -Migration ibland bryter saker
- Kustspårning - Makligt att smälta budget på molnoptimering
- Dokumentationsdrift - Automatiskt -docs don' inte alltid uppdateras när koden ändras
Vad är det som är helt konstigt?
- verktyg för optimering av verktyg - Kodoptimisator optimerar kogeneratör
- Kaskaderande evolution - verktyget A utvecklas , utlöser utvecklingen av verktyg som använder A
- Emergent specialisering - System skapar hyper- -specifika verktyg
- Fitnessspel - verktyg ibland
- Versionsproliferation - Några verktyg har versioner 15+
- Self-referensiella kretsar - verktygsdokumentator som dokumenterar sig själv
Framtiden : Vart det här leder framåt
Om verktyg kan:
- Benutzung av spår
- Att utveckla sig själva
- Generera nya verktyg
- Välj sig själva
- Cacheinvocationer
- Lära upp prestationer
Vad är det som händer?
Kort sikt (Snädliga få månaderM SK1
- verktygskonsolidering - Merge similar tools , prune low
- Passform - bättre multidimensionell scoring
- kostnadskontroller - Smartare budgetstyre
- Versionsprångning - Automatiskt -archivera gamla versioner
- Dokumentation synkronisering - Håll dokument aktuella med kod
Medeltid (2025)
- verktygsmarknader - dela verktyg över instanser
- Kollaborativ evolution - Flera DSE-instantioner som utvecklar delade verktygen
- A/B-tester - Automatisk jämförelse av verktygsversioner
- verktygskomposition - Automatiskt kombinera verktyg till arbetsflöden
- Performance förutsägning - förutsäga verktygsvikt innan utföring
Wilda idéer (Den verkligt roliga saken )
- Att odla verktyg - Kombinera framgångsrika verktyg för att skapa hybrider
- Motsägelsefull evolution - verktyg som tävlar om att lösa problem
- verktygsekosystem - Symbiotiska relationer mellan verktyg
- Ekonomiska modeller - verktyg
- Meta-verktyg - verktyg som sköter andra verktyg
- Migration av verktyg - Flytta vanliga verktyg till bättre backends automatiskt
- Self-Healning genom gener - verktyg som minns misslyckanden och aldrig återhämtar den
slutsats:, 's verktyg hela vägen ner
Här är vad som inte förklarades
De arbetsflöden som utvecklas De verktyg som komponerar arbetsflöden? De utvecklas också. Systemet som sköter evolutionen Statistiken som mäter kondition
Det är 's verktyg hela vägen ner
Och varenda en
- Spurar dess användande
- mäter dess prestation
- förbättringar över tid
- Vet om sin egen kondition
- Caches körs framgångsrikt
- Versioner själva
- Dokumenten själv
Vi byggde inte en kodgenerator
Vi byggde en egen dokumentationslåda som genererar kod.
Skillnaden spelar roll
För när verktyg blir evolutionära enheter, när de följer sin egen kondition, när dom förökar sig, muterar och tävlar,
Du har ingen verktygslåda
Du har en ekologi.
Och ekologier utvecklas
Men vad händer när evolutionen bryter saker När en mutation i ett verktyg introducerar en viktig bug? När optimering gör ett verktyg värre än bättre
Att "'" är där delen "9" kommer in i ".". Vi utforskar självt- läkande genom könsstrukturen - medvetande skövling—, ett system där verktygen inte bara utvecklas, ', de minns varje misslyckande, ,, skövlar misslyckade grannar, M SK4 och sprider kunskapen för att förhindra liknande misstag över hela ekosystemet.
När dina verktyg kan bryta sig själva
Teknikresurser
Repository: mest tydliga.dse
Nyckeldates:
src/tools_manager.py(2,293 linjersrc/rag_integrated_tools.py(562 linjersrc/openapi_tool.py(313 linjersrc/model_selector_tool.py(460 linjertools/index.json(5,464 linjertools/llm/*.yaml(27 verktygtools/executable/*.yaml(19 verktygtools/openapi/*.yaml(3 verktyg
Dokumentation:
LLMS_AS_TOOLS.md- LLM urvalssystemWORKFLOW_DOCUMENTATION_TOOL.md- Automatiskt -dokumentationCHAT_TOOLS_GUIDE.md- verktygshandbokenTOOL_PACKAGING.md- verktygsutvecklingshandboken
Navigationsserien:
- Del 1: enkla regler , komplext beteende - grunden
- Del 2: Kollektiv intelligens - Kommunikation omvandlar allting
- Del 3: Själva -Optimering - System som förbättrar sig själva
- Del 4: Kriget - När optimering blir intelligens
- Del 5: Evolution - Från optimering till guilds och kultur
- Del 6: Global konsensus - Inriktad evolution och planeterkänning
- Del 7: Den verkliga saken! - Att faktiskt bygga den och se hur den utvecklas
- Del 8: verktyg hela vägen ner ← Du är här
- Del 9: själv -Healing Tools - Linjer
- Del 10: The DiSE Cooker - När teorin möter stökiga verkligheter
Detta är en del 8 i den semantiska intelligensen serien | . | En del ♫ 7 | visade den generella DSE-Architekturen | МSK3 | Denna artikel visar den dolda komplexiteten |: | varje verktyget i systemet följer användandet |, | utvecklar implementeringar | , | lagar upp resultat | , | och deltar i formalitet | - | baserad val |. | verktygskit är inte bara en resurs |— | det | Sk11 | är en evolutionär ekologi som expanderar | skämtar , | optimerar , | documentserar sig själv |
Koden är verklig, som drivs lokalt på Ollama , som verkligen följer mätvärdena , och faktiskt utvecklar sig M SK3 Den är experimentell MSC5 ibland instabil, , och definitivt | " | livsvikt, - | kodat,." | Men verktygen fungerar, , | spårning fungerar, M SK11 | och utvecklingen fungerar.
Dessa utforskningar är kopplade till den sci-fi-romanen """, Michael, " "" om framväxande AI och konsekvenserna av system som optimerar sig själva. . "" De här verktygen är verkliga implementeringar som visar hur evolutionärt tryck skapar specialisering.
Tags: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology