
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
पूर्ण पाठ ढूंढने (Pt | 3 |- | OpenSearch के साथ ASP
Saturday, 24 August 2024
परिचय
इस श्रृंखला के पिछले भागों में हमने पूर्ण पाठ खोज की संकल्पना और यह कैसे एक डाटाबेस के भीतर पाठ के लिए ढूंढने के लिए उपयोग किया जा सकता है का परिचय दिया।
पिछले हिस्से:
इस भाग में हम आप के नए चमकदार ओपन सर्च इंस्टैंसेस का उपयोग आरंभ करने के लिए कैसे कवर करेंगे ASP
सेटअप
एक बार जब हम OpenSearch इंस्टैंस अप और चल रहा है तो हम इसके साथ संवाद शुरू कर सकते हैं ओपन सर्च क्लाइंट के लिए पहले हम अपने सेटअप एक्सटेंशन में क्लाइंट सेटअप करें
    var openSearchConfig = services.ConfigurePOCO<OpenSearchConfig>(configuration.GetSection(OpenSearchConfig.Section));
        var config = new ConnectionSettings(new Uri(openSearchConfig.Endpoint))
            .EnableHttpCompression()
            .EnableDebugMode()
            .ServerCertificateValidationCallback((sender, certificate, chain, errors) => true)
            .BasicAuthentication(openSearchConfig.Username, openSearchConfig.Password);
        services.AddSingleton<OpenSearchClient>(c => new OpenSearchClient(config));
यह अंतिम बिन्दु और प्रमाणपत्र के साथ क्लाइंट को सेटअप करता है।
सूचकांकन डाटा
ओपन सर्च में मुख्य संकल्पना अनुक्रमणिका है
यह करने के लिए हम' उपयोग करेंगे ओपन सर्च क्लाइंट के लिए You can install this via NuGet
आप वहाँ पर ध्यान देंगे।
अब जब हम इसे स्थापित किया है तो हम सूचकांकन डेटा को देखना शुरू कर सकते हैं
एक अनुक्रमणिका बनाने का आधा है नीचे के कोड में आप देख सकते हैं कि हम 'मैप'अपनी अनुक्रमणिका मॉडल को दिखा सकते है। इस मॉडल के प्रत्येक क्षेत्र के लिए हम उस प्रकार को परिभाषित करते हैं जो यह है (पाठ, दिनांकM SK2 शब्दकुञ्जी आदि
प्रकार महत्वपूर्ण है क्योंकि यह परिभाषित करता है कि डेटा कैसे भंडारित किया जाता है और कैसे खोजा जा सकता है।
यहाँ भी वर्ग वास्तव में एक स्ट्रिंग है[लेकिन शब्दकुञ्जी प्रकार उन्हें सही तरीके से संभालने के लिए समझता है
   public async Task CreateIndex(string language)
    {
        var languageName = language.ConvertCodeToLanguageName();
        var indexName = GetBlogIndexName(language);

      var response =  await client.Indices.CreateAsync(indexName, c => c
            .Settings(s => s
                .NumberOfShards(1)
                .NumberOfReplicas(1)
            )
            .Map<BlogIndexModel>(m => m
                .Properties(p => p
                    .Text(t => t
                        .Name(n => n.Title)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Content)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Language)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Date(t => t
                        .Name(n => n.Published)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Keyword(t => t
                        .Name(n => n.Id)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Slug)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Hash)
                    )
                    .Keyword(t => t
                        .Name(n => n.Categories)
                    )
                )
            )
        );

        if (!response.IsValid)
        {
           logger.LogError("Failed to create index {IndexName}: {Error}", indexName, response.DebugInformation);
        }
    }
अनुक्रमणिका में आइटम जोड़ें
एक बार जब हम अपने अनुक्रमणिका सेटअप करने के लिए आइटमों को इसमें जोड़ने की जरूरत है, तो हमें इस अनुक्रमा में आइटम्स जोड़ना होगा।
आप देख सकते हैं कि हम शुरू में एक विधि called में बुलाते हैGetExistingPosts जो पहले से ही अनुक्रमणिका में मौजूद सभी पोस्टों को लौटाता है
हम Hash और आईडी का उपयोग करते हैं पता लगाने के लिए अगर एक पोस्ट पहले से ही अनुक्रमणिका में है
    public async Task AddPostsToIndex(IEnumerable<BlogIndexModel> posts)
    {
        var existingPosts = await GetExistingPosts();
        var langPosts = posts.GroupBy(p => p.Language);
        langPosts=langPosts.Where(p => p.Key!="uk");
        langPosts = langPosts.Where(p =>
            p.Any(post => !existingPosts.Any(existing => existing.Id == post.Id && existing.Hash == post.Hash)));

        foreach (var blogIndexModels in langPosts)
        {

            var language = blogIndexModels.Key;
            var indexName = GetBlogIndexName(language);
            if(!await IndexExists(language))
            {
                await CreateIndex(language);
            }

            var bulkRequest = new BulkRequest(indexName)
            {
                Operations = new BulkOperationsCollection<IBulkOperation>(blogIndexModels.ToList()
                    .Select(p => new BulkIndexOperation<BlogIndexModel>(p))
                    .ToList()),
                Refresh = Refresh.True,
                ErrorTrace = true,
                RequestConfiguration = new RequestConfiguration
                {
                    MaxRetries = 3
                }
            };

            var bulkResponse = await client.BulkAsync(bulkRequest);
            if (!bulkResponse.IsValid)
            {
                logger.LogError("Failed to add posts to index {IndexName}: {Error}", indexName, bulkResponse.DebugInformation);
            }

        }
    }
एक बार जब हम मौजूदा पोस्टों और हमारे अनुपस्थित विश्लेषक को फिल्टर किया है, हम एक नया अनुक्रमणिका बनाते हैं।
आप' यह देखेंगे कि में BulkRequest हम सेट Refresh संपत्ति को true. इसका अर्थ है कि बल्क इंस्टीट्यूट पूरा होने के बाद सूचकांक ताज़ा किया जाता है।
अनुक्रमणिका खोज रहा है
यह देखने के लिए एक अच्छा तरीका है कि पता लगाएं क्या वास्तव में यहाँ बनाया गया है OpenSearch Dashboards पर Dev उपकरणों में जाएँ और एक खोज क्वेरी चलाएँ
GET /mostlylucid-blog-*
{}
यह क्वेरी हमें सभी अनुक्रमणिका पैटर्न मिलते हैं लौटाएगा mostlylucid-blog-*. (अभी आज तक हमारे सभी सूचकांक
{
  "mostlylucid-blog-ar": {
    "aliases": {},
    "mappings": {
      "properties": {
        "categories": {
          "type": "keyword"
        },
        "content": {
          "type": "text",
          "analyzer": "arabic"
        },
        "hash": {
          "type": "keyword"
        },
        "id": {
          "type": "keyword"
        },
        "language": {
          "type": "text"
        },
        "lastUpdated": {
          "type": "date"
        },
        "published": {
          "type": "date"
        },
        "slug": {
          "type": "keyword"
        },
        "title": {
          "type": "text",
          "analyzer": "arabic"
        }
      }
    },
    "settings": {
      "index": {
        "replication": {
          "type": "DOCUMENT"
..MANY MORE
ओपन सर्च डैशबोर्ड में डेव उपकरण आपके क्वेरी को अपने कोड में डालने से पहले परीक्षण करने का एक अच्छा तरीका है
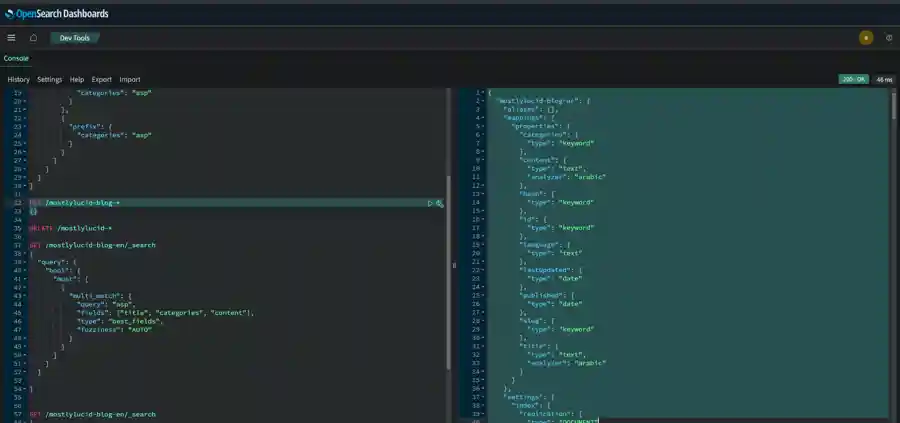
अनुक्रमणिका खोज रहा है
अब हम अनुक्रमणिका खोज शुरू कर सकते हैं Search यह करने के लिए क्लाइंट पर विधि
यह है जहां OpenSearch की वास्तविक शक्ति में आता है . यह अक्षरशः विभिन्न प्रकार के प्रश्नों की दर्जनों आप अपने डेटा ढूंढने के लिए उपयोग कर सकते हैं. एक साधारण शब्दकुञ्जी खोज से लेकर एक जटिल खोज तक
    public async Task<List<BlogIndexModel>> GetSearchResults(string language, string query, int page = 1, int pageSize = 10)
    {
        var indexName = GetBlogIndexName(language);
        var searchResponse = await client.SearchAsync<BlogIndexModel>(s => s
                .Index(indexName)  // Match index pattern
                .Query(q => q
                    .Bool(b => b
                        .Must(m => m
                            .MultiMatch(mm => mm
                                .Query(query)
                                .Fields(f => f
                                    .Field(p => p.Title, boost: 2.0)
                                    .Field(p => p.Categories, boost: 1.5)
                                    .Field(p => p.Content)
                                )
                                .Type(TextQueryType.BestFields)
                                .Fuzziness(Fuzziness.Auto)
                            )
                        )
                    )
                )
                .Skip((page -1) * pageSize)  // Skip the first n results (adjust as needed)
                .Size(pageSize)  // Limit the number of results (adjust as needed)
        );

        if(!searchResponse.IsValid)
        {
            logger.LogError("Failed to search index {IndexName}: {Error}", indexName, searchResponse.DebugInformation);
            return new List<BlogIndexModel>();
        }
        return searchResponse.Documents.ToList();
    }
क्वेरी वर्णन
यह विधि GetSearchResultsएक विशेष ओपन सर्च अनुक्रमणिका को खोजने के लिए डिजाइन किया गया है जो ब्लॉग पोस्टों को प्राप्त करता है language, query, और पृष्ठांकन पैरामीटर page और pageSizeयहाँ यह क्या करता है
अनुक्रमणिका चयन:
- यह अनुक्रमणिका नाम का उपयोग कर प्राप्त करता है
GetBlogIndexNameदिए गए भाषा पर आधारित विधि. अनुक्रमणिका भाषा के अनुसार गतिशील रूप से चयनित की जाती है
- यह अनुक्रमणिका नाम का उपयोग कर प्राप्त करता है
खोज क्वेरी:
- क्वेरी एक का उपयोग करता है
Boolएक के साथ प्रश्नMustयह सुनिश्चित करने के लिए खंड कि परिणाम कुछ मानदंडों से मिलते हैं - अंदर
Mustखंड, aMultiMatchक्वेरी का उपयोग बहुविध क्षेत्रों में खोज के लिए किया जाता है (Title,Categories, औरContent).- बूस्टिंग:
Titleक्षेत्र को एक प्रोत्साहन दिया जाता है2.0, यह खोज में अधिक महत्वपूर्ण बनाता हैCategoriesकी वृद्धि करता है1.5. इसका अर्थ है, दस्तावेज़ जहां खोज क्वेरी शीर्षक या श्रेणियों में दिखाई देता है उच्च दर्जा प्राप्त करेंगे - क्वेरी प्रकार: यह उपयोग करता है
BestFields, जो क्वेरी के लिए सर्वोत्तम मिलान क्षेत्र ढूंढने का प्रयास करता है - अस्पष्टता:
Fuzziness.Autoपैरामीटर approximate matches के लिए अनुमति देता है
- बूस्टिंग:
- क्वेरी एक का उपयोग करता है
पृष्ठांकन:
Skipविधि पहले छोड़ती हैnपरिणाम पर निर्भर करता है पृष्ठ संख्या, के रूप में गणना(page - 1) * pageSizeपृष्ठित परिणामों के माध्यम से नेविगेट करने में मदद करता हैSizeविधि निर्दिष्ट किए गए दस्तावेजों को लौटाए जाने की संख्या को सीमित करती हैpageSize.
त्रुटि प्रबंधन:
- यदि क्वेरी असफल है, एक त्रुटि लॉग की जाती है और एक खाली सूची लौटाया जाता है
परिणाम:
- विधि का एक सूची लौटाता है
BlogIndexModelढूंढें criteria के अनुरूप दस्तावेज़
- विधि का एक सूची लौटाता है
तो आप देख सकते हैं कि हम अपने डेटा की खोज के बारे में बहुत लचीला हो सकता है
एक बड़ी सुविधा यह है कि हम कई भाषाओं को समर्थन कर सकते हैं।
नया खोज API
इस श्रृंखला के पिछले भागों में देखा गया खोज API के विपरीत, हम OpenSearch का उपयोग करके खोज प्रक्रिया को व्यापक रूप से सरल कर सकते हैं
   [HttpGet]
    [Route("osearch/{query}")]
   [ValidateAntiForgeryToken]
    public async Task<JsonHttpResult<List<SearchResults>>> OpenSearch(string query, string language = MarkdownBaseService.EnglishLanguage)
    {
        var results = await indexService.GetSearchResults(language, query);

        var host = Request.Host.Value;
        var output = results.Select(x => new SearchResults(x.Title.Trim(), x.Slug, @Url.ActionLink("Show", "Blog", new{ x.Slug}, protocol:"https", host:host) )).ToList();
        return TypedResults.Json(output);
    }
जैसा कि आप देख सकते हैं, हम परिणाम लौटाने के लिए अनुक्रमणिका में सभी डाटा की जरूरत है।
अंत में
इस पोस्ट में हमने देखा कि हम अपने ओपन सर्च इंस्टैंस के साथ बातचीत करने के लिए एक C# क्लाइंट लिखने का तरीका है