This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Sunday, 16 November 2025
Lorsque vos outils se suivent, évoluent et choisissent eux-mêmes
Remarque: Ceci est la partie 8 de la série Semantic Intelligence. La partie 7 a couvert l'architecture DSE globale. Cet article plonge profondément dans quelque chose que j'ai glissé sur: comment les outils eux-mêmes fonctionnent, suivent l'utilisation, évoluent et deviennent plus intelligents au fil du temps.
Remarque: Si vous pensiez que l'évolution du flux de travail dans la partie 7 était sauvage, attendez de voir ce qui se passe quand chaque outil a les mêmes capacités.
Dans la partie 7, je vous ai montré l'évolution synthétique dirigée: workflows qui planifient, génèrent, exécutent, évaluent et améliorent. J'ai mentionné "outils" un tas de fois.
Voici ce que je n'ai pas expliqué :
Ces outils ne sont pas statiques, ce ne sont pas des fichiers de configuration qui restent inchangés.
Ce sont des artefacts vivants qui :
En d'autres termes : Les outils sont des nœuds. Les nœuds sont des outils. Tout évolue.
Et ça devient plus bizarre.
Laissez-moi vous montrer ce que le système a en fait:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
C'est index.json? 5 464 lignes des définitions des outils, des statistiques d'utilisation, de l'historique des versions, des scores de remise en forme et du suivi des lignées.
Chaque outil à l'intérieur:
REMARQUE: Le système fonctionnera effectivement SANS aucun outil. Juste moins efficace; et plus stupide. Sans eux, les outils seraient générés comme une partie normale de la décomposition du flux de travail. Il s'adapterait encore lentement, mais il faudrait WAY plus de jetons.
Voyons ce qu'est un outil.
Voici une définition d'outil réelle du système:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Remarquez ce qu'il y a :
Mais voici ce qu'il y a pas dans le YAML:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Le système augmente définitions statiques avec apprentissage de l'exécution.
Voici ce qui se passe lorsque vous utilisez un outil :
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Ce qui est suivi:
Voyons le mécanisme de mise en cache.
Le plus malin : l'outil cache système invocations à plusieurs niveaux.
Niveau 1: Cachement de correspondance exacte
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Pourquoi cela importe-t-il :
Si vous demandez au système de "écrire un haïku sur le code" deux fois, la deuxième fois est instant. Le LLM ne s'exécute pas. La mémoire RAG renvoie le résultat mis en cache.
Mais voici le plus malin : il retourne la version BEST s'il existe plusieurs.
Exemple :
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Le système sélectionne automatiquement le résultat mis en cache de la plus haute qualité.
Une des caractéristiques les plus subtiles : le système apprend combien de temps chaque modèle prend pour répondre.
Le problème :
Différents modèles ont des temps de réponse extrêmement différents:
tinyllama (2B): ~3 secondesllama3 (8B): ~10 secondesqwen2.5-coder (14B): ~25 secondesdeepseek-coder-v2 (16B): ~60 secondesSi vous définissez un timeout global (disons, 30s), vous gaspillez 27 secondes en attendant tinyllama, et vous tuez deepseek avant qu'il ne finisse.
La solution : l'apprentissage adaptatif
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Comment ça marche :
Résultats:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Le système apprend le bon timeout pour chaque modèle au lieu d'utiliser une valeur globale.
Lorsque vous demandez au système de faire quelque chose, il ne se contente pas de choisir le premier outil correspondant. fonction de remise en forme sur plusieurs dimensions.
Calcul de la condition physique :
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Exemple réel :
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Sélectionné : email_validator_workflow (Compatibilité : 190)
Le système choisit le rapide, gratuit, de haute qualité, prouvé Ce n'est pas la solution la plus sémantique, pas la plus puissante.
Celui qui satisfait de manière optimale de multiples contraintes.
Les outils ne restent pas statiques, ils évoluent.
Détection de la version et du changement :
Chaque outil a un définition hash calculé à partir de son YAML:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
Lorsque vous modifiez un outil YAML:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Au chargement suivant:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Version sémantique :
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Briser les changements :
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Au chargement:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Le système vous avertit au sujet de la rupture des changements et maintient l'historique des versions.
Chaque outil est indexé dans la mémoire RAG pour la recherche sémantique:
Au temps de chargement:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Maintenant, quand vous recherchez:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Le système utilise Intégrations RAG pour trouver des outils pertinents, puis les classer par conditionnement multi-dimensionnel.
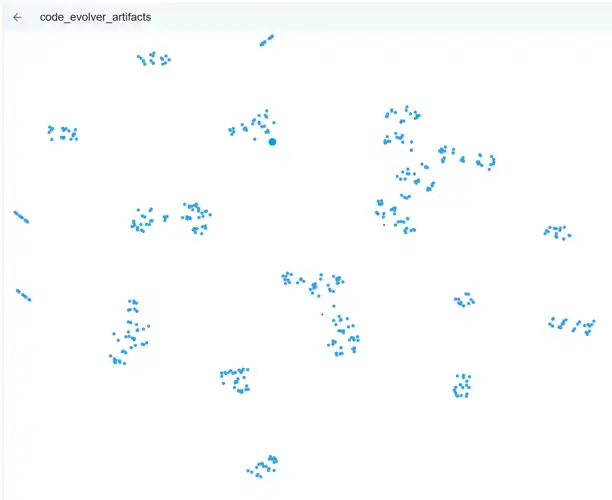
Dans notre système, nous enregistrons les vecteurs pour les Qdurant une base de données vectorielle et elle nous donne une façon soignée de voir comment notre espace d'outils. C'est le système de mémoire de notre système de construction de workflow.
Divisé dans les modèles d'origine (fichiers yaml dans le répertoire des outils) et chaque élément de code généré pour résoudre une tâche (et configurer pour llms etc). Cette forme à la boîte à outils pour assembler les zones de travail.
De cette façon, tout le workdlow est Composable et testable car chaque élément Python dispose d'une suite de tests, de spécifications BDD, d'outils statiques pour vérifier l'exactitude et plusieurs évaluateurs LLM pour s'assurer qu'il fonctionne.
l'effet secondaire est TOUTE pièce de code qui s'exécutera dans un workflow est juste là, prêt à inspecter comme chaque création 'outil' conduit à des certificats Python inspectables.
Vous pouvez voir les tropes clumoing ensemble avec chaque blob étant un ensemble d'outils liés sémantiquement comme:
Tous regroupés, se spécialisant naturellement par la nature du système.
À l'avenir, nous souhaiterions probablement optimiser ces clusters pour réduire la base de code à un système plus petit, plus serré, plus optimisé.
Comme nous pouvons suivre les versions, les utilisations, les changements et le mensonge, nous pouvons optimiser sélectivement et 'cluster defrag' tnhe les plus utilisés et la plupart des comopnents critiques de performance dans le cadre de la structure intrinsèque du système.
Examinons ce qui existe réellement dans le système maintenant.
LLM Tools (27 spécialistes):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Outils exécutables :
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
Outils OpenAPI :
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Total des outils : 50+
Total des lignes de métadonnées : 5 464 lignes en index.json
Laissez-moi vous montrer l'outil le plus sophistiqué du système: code_optimizer.
Définition: tools/llm/code_optimizer.yaml (317 lignes!)
Ce qu'il fait:
Optimisation hiérarchique :
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Gestion des coûts :
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Intégration des essais:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Gestion des versions :
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
C'est outil unique orchestres:
Et c'est Un seul outil dans un système avec 50+ outils.
L'un des outils les plus méta : modèle_sélécteur.
Sélection du langage naturel :
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Comment ça marche :
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Le système analyse le langage naturel Pour sélectionner des modèles. Vous pouvez dire:
Et il se dirige intelligemment vers le bon moteur.
Le système traite les API externes de la même façon que les outils internes.
Exemple : Traducteur NMT
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Au moment de l'exécution:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Ce qui est suivi:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Les API externes reçoivent le même traitement :
Un des outils les plus fous : _documenter de flux de travail.
Ce qu'il fait:
Prend un flux de travail (a main.py fichier) et génère automatiquement une documentation complète par:
README.txtTout automatiquement.
Définition: tools/llm/workflow_documenter.yaml (11,803 caractères!)
Entrée & #160;:
{
    "workflow_path": "nodes/email_validator/main.py"
}
Produit :
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
Q: Est-ce que cela peut vérifier l'existence d'un courriel? R: Non, cela ne valide que le format. Utilisez la vérification DNS/SMTP pour vérifier l'existence.
Q: Est-ce qu'il soutient des domaines internationaux? R: Oui, mais la conversion du code puny peut être nécessaire.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Utilisateur: "J'ai besoin d'un outil qui convertit les températures"
Système:
Nouvel outil créé : temperature_converter.yaml
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Le système sait :
Et c'est utilise ces données à:
Reculons et réfléchissons à ce que nous avons construit :
Un système dans lequel:
Nous avons créé une boîte à outils auto-optimisante qui :
Ce n'est pas la gestion de configuration.
C'est l'écologie d'outils émergente.
Les outils ne sont pas des ressources statiques. artefacts vivants dans un système évolutif.
Scénario 1 : Auto-amélioration de la voie critique
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Le système a optimisé sa propre voie critique sans intervention humaine.
Scénario 2 : Spécialisation adaptative
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Le système a identifié un modèle et créé un outil spécialisé.
Scénario 3 : Escalation des coûts en connaissance de cause
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Le système a dépensé de l'argent intelligemment pour obtenir de meilleurs résultats.
Laissez-moi cataloguer ce qui existe réellement en ce moment.
Spécialiste du code
code_explainer - Explique le code en langage naturelcode_optimizer - Optimisation hiérarchique (local/cloud/deep)code_reviewer - Examen de la qualité et de la sécuritéfast_code_generator - Génération rapide avec de petits modèlessecurity_auditor - Numérisation de la vulnérabilitéperformance_profiler - Profilage et analyse du codeSpécialistes du contenu :
long_form_writer - Romans, livres (128 000 contexte)content_generator - Contenu généralarticle_analyzer - Structure/qualité des articlessummarizer - Résume le long contenuproofreader - Grammaire et styleseo_optimizer - Optimisation du référencementoutline_generator - Aperçus du contenuTraduction:
quick_translator - Traduction rapide (petit modèle)translation_quality_checker - Valide les traductionsDocumentation:
doc_generator - Documentation du codetechnical_writer - Documentation techniqueworkflow_documenter - Génére automatiquement les documents de flux de travailOutils système :
general - Renversement à des fins généralesmodel_selector - Sélectionne le meilleur moteur/modèletask_to_workflow_router - Route les tâches vers les workflowsquick_feedback - Tri rapidesignalr_connection_parser - Parses connections SignalRsignalr_llmapi_management - Gère les API LLM SignalRValidation:
call_tool_validator - Valide l'utilisation de call_tool()python_syntax_validator - Contrôle de la syntaxemypy_type_checker - Contrôle statique de typejson_output_validator - Validation du format JSONstdin_usage_validator - Valide l'utilisation de stdinmain_function_checker - Vérification de la fonction main()node_runtime_import_validator - Valide les importationsAnalyse :
run_static_analysis - Exécute des outils d'analyse statiqueperformance_profiler - Exécution du code de profilsServices publics :
save_to_disk - Résistance du disqueunit_converter - Conversions d'unitésrandom_data_generator - Production de données d ' essaibuffer - Gestion des tamponsworkflow_datastore - Stockage des données de flux de travailstream_processor - Traitement des fluxsse_stream - Événements en présence d'un serveurIntégration:
connect_signalr - Connexion SignalRsignalr_hub_connector - Connexion au moyeusignalr_websocket_stream - WebSocket streamingDocumentation:
document_workflow - Générateur de documentation de flux de travailnmt_translator - API de traduction automatique neuronaleTotal: 53 outils (et en croissance)
C'est là que ça devient vraiment intéressant : outils composent d'autres outils.
Et quand un outil composé évolue, chaque workflow l'utilisant s'améliore automatiquement.
Examinons un véritable outil composite du système :
Tâche : "Traduisez cet article en espagnol et validez la qualité"
Approche traditionnelle:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
Approche DSE:
Le système découvre ce modèle est utilisé fréquemment et crée automatiquement un outil composite:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Qu'est-ce qui est fou à ce sujet :
Quand nmt_translator évolue vers v2.0.0 (peut-être 20% plus vite), l'outil composite utilise automatiquement la nouvelle version. Aucun changement de code n'est nécessaire.
Résultat : Chaque flux de travail utilisant validated_translator obtient 20% plus vite sans aucune modification.
Voici un exemple encore plus cool: composition de l'outil parallèle.
Tâche : "Revoir ce code à fond"
Approche naïve:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE composition parallèle:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Exécution :
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Résultat : 35 secondes → 20 secondes (43% plus vite!)
Et quand security_auditor évolue vers v3.0.0 (par exemple, 30 % plus vite), l'ensemble du comité s'accélère automatiquement.
Voici la partie qui est vraiment sauvage: les outils agissent comme des gènes.
Observation: Lorsqu'un outil s'avère utile, il s'étend à travers le système.
Exemple réel: Le modèle de vérificateur de la qualité
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Il s'agit d'une propagation génétique littérale:
Le chemin de code est toujours optimal car:
Voici le plus malin : vous pouvez améliorer tous les outils à la fois.
Scénario : Vous avez 20 workflows, chacun utilisant 5-10 outils. Total: ~100 invocations d'outils.
Système traditionnel:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
Système DSE:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Résultat :
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Vous avez formé ONE tool et amélioré simultanément les workflows d'EIGHTEN.
La partie vraiment sauvage: évolution cascades à travers le graphique de dépendance.
Exemple :
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
Un événement d'évolution a amélioré les workflows d'ELEVEN sans intervention manuelle.
Parce que les outils suivent la forme physique, les résultats cache, et auto-évoluer, le système exécute toujours la meilleure mise en œuvre disponible.
Exemple d'exécution :
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Le système:
Le chemin de code est optimisé à chaque étape :
Soyons précis sur la raison pour laquelle c'est évolution synthétique dirigée et pas seulement "encastrement avec version":
Outils en tant que gènes :
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Évolution dirigée :
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
La "pool des genres" :
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Visualisation de la propagation génétique :
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
Héritage génétique :
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Neat, c'est ça ?
Oui, c'est vraiment sauvage.
Nous avons construit un système où:
Ce n'est pas une métaphore.
C'est une évolution synthétique dirigée.
Après avoir exécuté ce système pendant des semaines:
Si les outils peuvent :
Et ensuite ?
Voici ce que la partie 7 n'a pas entièrement expliqué :
Les flux de travail qui évoluent ? Ils sont faits d'outils. Les outils qui composent les workflows ? Ils évoluent aussi. Le système qui gère l'évolution? Aussi des outils. Les mesures qui suivent la forme physique ?
Ce sont des outils qui descendent.
Et chacun d'eux :
Nous n'avons pas construit de générateur de code.
Nous avons construit une boîte à outils auto-élargissante, auto-optimisante, auto-documentante qui se produit pour générer du code.
La distinction est importante.
Parce que quand les outils deviennent des unités évolutives, quand ils suivent leur propre forme physique, quand ils se reproduisent, mutent et rivalisent...
Vous n'avez pas de boîte à outils.
Vous avez une écologie.
Et les ecologies évoluent.
Mais que se passe - t - il quand l'évolution rompt les choses? Quand une mutation d'outil introduit un bug critique ? Quand l'optimisation rend un outil pire que mieux ?
C'est là que la Partie 9 entre en jeu. auto-guérison à travers l'élagage de lignage-connaissance—un système où les outils ne se contentent pas d'évoluer, ils se souviennent de chaque échec, prunent des branches défaillantes, et propagent ces connaissances pour éviter des erreurs similaires dans l'ensemble de l'écosystème.
Lorsque vos outils peuvent se briser, votre système doit se rappeler pourquoi et ne jamais répéter l'erreur.
Dépôt : principalementlucide.dse
Fichiers clés & #160;:
src/tools_manager.py (2 293 lignes) - Gestion des outils de basesrc/rag_integrated_tools.py (562 lignes) - Intégration RAGsrc/openapi_tool.py (313 lignes) - Support OpenAPIsrc/model_selector_tool.py (460 lignes) - Sélection de modèlestools/index.json (5464 lignes) - Registre d'outilstools/llm/*.yaml (27 outils) - Définitions de spécialistes LLMtools/executable/*.yaml (19 outils) - Outils exécutablestools/openapi/*.yaml (3 outils) - Intégrations APIDocumentation:
LLMS_AS_TOOLS.md - Système de sélection LLMWORKFLOW_DOCUMENTATION_TOOL.md - Auto-documentationCHAT_TOOLS_GUIDE.md - Guide d'utilisation de l'outilTOOL_PACKAGING.md - Guide de développement d'outilsNavigation des séries:
C'est la partie 8 de la série Semantic Intelligence. La partie 7 montre l'architecture globale DSE. Cet article révèle la complexité cachée : chaque outil du système suit l'utilisation, évolue les implémentations, cache les résultats et participe à la sélection basée sur la condition physique. La boîte à outils n'est pas seulement une ressource, c'est une écologie évolutive qui s'étend, optimise et documente elle-même.
Le code est réel, fonctionnant localement sur Ollama, vraiment suivi des mesures, et en fait en évolution. Il est expérimental, parfois instable, et certainement "vibe-coded." Mais les outils fonctionnent, le suivi fonctionne, et l'évolution fonctionne. La boîte à outils se développe elle-même.
Ces explorations se connectent au roman de science-fiction "Michael" sur l'IA émergente et les implications des systèmes qui s'optimiser. Les outils décrits ici sont de véritables implémentations démontrant comment la pression évolutive crée la spécialisation, comment les fonctions de fitness guident la sélection, et comment les systèmes auto-améliorants développent naturellement des propriétés écologie-comme. Que cela mène aux réseaux d'outils à l'échelle planétaire de la Partie 6, ou quelque chose complètement inattendu, reste à voir. C'est ce qui en fait une expérience.
Étiquettes : #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
