
Intelligence sémantique: Partie M SK1 - Outils tout au long de la route: L'auto-conceptionMSC4Outil d'optimisation


Lorsque vos outils se suivent eux-mêmes , s’évoluent , et choisissent eux- mêmes
Note: Il s’agit de la partie 8 de la série Semantic Intelligence. la façon dont les outils fonctionnent eux-mêmes, l’utilisation des voies de cheminement , l'évolution de l’outil, et son accroissement au fil du temps
Note: Si vous pensais que l’évolution du flux de travail dans la partie 7 était sauvage, attendez jusqu’à ce que vous voyez ce qui se passe lorsque tous les outils a les mêmes capacités.
La partie de la question 7 Ne vous a pas dit
Dans la partie 7, je vous ai montré les flux de travail directs d’évolution synthétique : qui planifient, génèrentM SK3 exécutentMST4 évaluentM ST5 et améliorentM st6 J’ai mentionné MST7 outilsMst8 un certain nombre de foisMSt9
Voici ce que je n’ai pas expliqué.
Ces outils ne sont pas statiques, ils n’ont pas de fichiers de configuration qui y restent inchangés.
Ils sont des artefacts vivants qui
- Suivre chaque invocation
- Apprenez à partir de modèles d'utilisation
- Évoluer leurs propres mises en œuvre
- Réponses réussies au cache
- Négocier le commerce de la condition physique-offs
- La version elle-même
- Utiliser à nouveau tout au long du système
Autrement dit: Les outils sont des nodes. Les nodes sont des outils. Tout évolueM SK2
Et il devient plus étrange.
Le Registre d'outils: Un organisme autonome-Un univers étendu
Permettez-moi de vous montrer ce que le système a réellement:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
Que index.json? Lignes 5,464 de définitions d’outils, statistiques d’utilisation, historique des versionsM SK2 cotes d’aptitude , et suivi des lignéesMSC4
Tous les outils qui y figurent:
- A des compteurs d'utilisation
- Suivre les notes de qualité tirées des évaluations
- Maintenir l'historique de la version
- Liens aux artefacts de la mémoire RAG
- Stockage des mesures de rendement
- Enregistre les invocations réussies
REMARQUE: Le système fonctionnera en fait AVEC aucun outil . À peine moins efficacement M SK2 et stupide . Sans ces outils, les outils seraient générés comme une partie normale de la décomposition du flux de travail
Nous allons voir ce qu’est réellement un outil.
Analyse de l'outil: Plus que la configuration
Voici une définition réelle de l’outil du système.
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Notez ce qu’il y a :
- Niveaux de performance - CoûtM SK1 vitesse, qualité
- Spécialisation - Qu'est-ce que cet outil? de la bonne qualité À l'heure actuelle
- Capacité - Longueur maximale de sortie, fenêtre contextuelle
- Modèles - Comment l'invoquer
- Mots clés - Catégorisation sémantique
Mais ici, ce qu’est-ce que ' non pas dans le YAML:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Le système augmentations définitions statiques avec l'apprentissage du temps d'exécution.
Surveillance de l'utilisation: Toute invocation est importante
Voici ce qui se passe lorsque vous utilisez un outil.
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Ce qui est suivi:
- Les métadonnées d'invocation - Identification de l'outilM SK1 modèle , paramètres, température
- Rendement - Durée de latence, mémoireM SK2 temps de réponse
- Qualité - Cote de l'évaluateurM SK1 Rétroaction des utilisateurs
- Cachement - Correspondance exacte du prompt pour la réutilisation
- Formation physique - Évaluation multidimensionnelle
Let's look at the caching mechanism.
Cache hiérarchique: Ne calculez jamais deux fois
Le bit le plus intelligent: le système cache les invocations d’outils à plusieurs niveaux.
Niveau 1: Cache exacte des matchs
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Pourquoi cela importe:
Si vous demandez au système "de rédiger un haiku sur le code "de deux fois instantaneusement. Le LLM ne fonctionne pasM SK1t run. La mémoire RAG retourne le résultat cachedMSC3
Mais ici, c’est ce qui est le plus intelligent. il retourne la meilleure version si plusieurs existent.
Exemple:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Le système sélectionne automatiquement le résultat cached de qualité la plus élevée-.
Apprentissage adaptatif des périodes d’arrêt de travail: Stop Guessing
L’une des caractéristiques plus subtiles de ce système, soit :, est qu’il apprend combien de temps il faut à chaque modèle pour réagir.
Le problème:
Les modèles différents ont des temps de réponse très différents:
tinyllama(2BM SK1 ~3 secondesllama3(8BM SK1 ~10 secondesqwen2.5-coder(14BM SK1 ~25 secondesdeepseek-coder-v2(16BM SK1 ~60 secondes
Si vous établissez un délai global (say, 30sM SK3, vous en gaspillez des seconds à attendre tinyllama, et vous tuez deepseek avant de terminer.
La solution: Apprentissage adaptatif
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Comment il fonctionne:
- Suivi des temps de réponse pour chaque modèle
- Calculer 95th percentile (la plupart des réponses sont terminées à ce moment-là
- Ajouter un tampon 20% pour la sécurité
- Utilisez cela comme nouvelle période d'arrêt.
Résultats:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Le système Apprentissage du temps d'arrêt approprié pour chaque modèle au lieu d’utiliser une valeur globale.
Multi-Dimensional Fitness: Choix du bon outil
Lorsque vous demandez au système de faire quelque chose, ce n’est pas le cas. fonction d'aptitude sur plusieurs dimensions.
Calcul de la condition physique:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Exemple réelle:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Choisie: email_validator_workflow (fitnessM SK1 190)
Le système choisit les rapide, gratuitM SK1 élevé-qualité , prouvé solution. Non le plus sémantiquement similaireM SK1 Non la plus puissante.
L’un qui satisfait de façon optimale à des contraintes multiples.
Évolution de l'outil: Self-Mise en œuvre améliorée
Les outils ne sont pas statiques; ils évoluent.
Versionnement & Détection des changements:
Chaque outil a un définition hash calculé à partir de son YAML:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
Lorsque vous rédigez un outil's YAML:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
À la prochaine charge:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Versions sémantiques:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Changements interrompus:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Sur charge:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Le système vous avise de briser les changements et maintient l’historique de la version.
Intégration RAG: Outils en tant qu'artefacts sémantiques
Chaque outil est indexé dans la mémoire RAG pour une recherche sémantique:
À temps de charge:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Maintenant que vous recherchez:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Le système utilise Emplacements RAG pour trouver les outils pertinents, puis les classe par polydimensionnels.
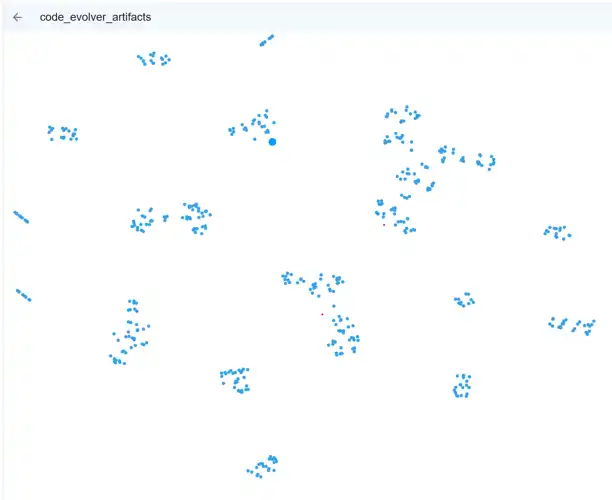
espace d'outils
Dans notre système, nous sauvons les vecteurs pour les embeddings dans Qdrant une base de données vectorielle et nous donne un bon moyen de voir comment notre espace d’outils. C’est le système de mémoire de notre système de construction des flux de travail.
Divisés en modèles originaux (yaml files dans le répertoire d'outils) et chaque élément de code généré pour résoudre une tâche (et configuration pour l'llms, etc. Ces formulaires correspondent à la trousse d’outils pour l’assemblage des appareils de travail. PréM SK1 tronçons construits allant de;
- Le Prompt original - nous pourrions construire à partir du nouveau!
- Le fichier de travail complet -, comme avec tout le reste, est un script python réel
- Chaque outil utilise - qui a appelé un outil, quandM SK2 combien de fois
- Chacune des fonctions de Python (files d'acheminement de travail,généréeM SK2
De cette façon, tout le workdlow est composable et testable puisque chaque élément Python possède une série de tests, spécifications BDD , outils statiques pour vérifier la correction M SK2 évaluateurs multiples LLM pour s'assurer qu'il fonctionne.
L’effet secondaire est EVERY piece of code that will run in a workflow is right there, ready to inspect as each M SK1tool' creation leads to inspectable Python scripesMSC3
Vous pouvez voir les toos clumoing ensemble avec chaque blob étant un ensemble d’outils sémantiquement liés comme:
- Ajouter 1 plus 2
- Ajouter 1 plice 3
- Ajouter le nombre x plus y
- et l’approche optimisée du code x+y
Toutes regroupées ensemble. Spécialisation naturelle par le système
À l’avenir, nous voulons probablement optimiser ces grappes pour ramener la base de code à un système plus restreint.
Étant donné que nous pouvons suivre les versions, les utilisations , les changements et le liage, nous pouvons optimiser de façon sélective et M SK2 défragmenter l'ensemble' ce qui est le plus utilisé et le plus essentiel pour la performance comme composante de la structure intrinsèque du système
L’écosystème riche qui a émergé
Let's regardez ce qui existe réellement dans le système maintenant .
Outils LLM (27 spécialistes):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Outils exécutoires:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
Outils OpenAPI:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Total des outils: 50+
Total des lignes de métadonnées: 5,464 lignes dans index.json
Exemple réelle: Outil d'optimisation du code
Permettez-moi de vous montrer l'outil le plus perfectionné du système: code_optimisateur.
Définition: tools/llm/code_optimizer.yaml (317 lignesM SK1
Ce qu'il fait:
- Profils Performance de base
- Analyses (CPU , IM SK2O, mémoireMSC4
- Choix du niveau d'optimisation:
- Local (freeM SK1 10-20% amélioration)
- CLOUD (payé, 20-40% améliorationM SK3
- DÉVELOPPEMENT (D'un système peu coûteuxM SK1-Remaniement de niveauMSC3
- Optimisations code à un niveau choisi
- Mise à jour des tests Automatiquement
- Profils Version optimisée
- Comparaisons avant/après
- Décide Accepter/rejeter
- Versions s'il est accepté
- Migrations Utilisation si aucun changement de rupture n'est apporté
Optimisation hiérarchique:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Gestion des coûts:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Intégration d'essais:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Gestion de la version:
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Ce qui suit : Outil unique orchestres:
- Runs de profilage 3
- Multi-Optimisation du niveau LLM
- Mise à jour automatique des essais
- Comparaison des performances
- Coût-aware escalation
- Gestion de la version
- Auto-migration
Et c's un seul outil dans un système avec Outils 50+.
Selecteur de modèles: LLMs Choix des LLM
Un des outils méta les plus utilisés: Modèle_selecteur.
Choix de langues naturelles:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Comment il fonctionne:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Le système analyse la langue naturelle. pour sélectionner les modèles. Vous pouvez dire:
- "utiliser gpt-4 pour ce type de donnéesM SK2
- "montrer le modèle le plus rapideM SK1
- "J’ai besoin d’un contexte long pour ce livre "
- "utiliser le code le plus puissant llm"
Et il se dirige intelligentement vers l’arrière-plan droit.
Intégration OpenAPI: Outils externes en tant que premiers citoyens de la classe -
Le système traite les API externes comme des outils internes.
Exemple: Translator NMT
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
À l’heure de démarrage:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Ce qui est suivi:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Les API externes bénéficient du même traitement:
- Surveillance de l'utilisation
- Mesures de rendement
- Évaluation de qualité
- Calcul de l'aptitude
- Indexage RAG
Le documenteur des flux de travail: Meta-Outil
Un des outils les plus sauvages: flux de travail_documenter.
Ce qu'il fait:
Prend un flux de travail (a main.py fichier) et génére automatiquement une documentation complète par:
- Lecture du code
- Extraction des intrants/extraits
- Détecter les appels d'outils
- Analyse de la complexité
- Générer des diagrammes de mermaid
- Créer des exemples d'utilisation
- Écrire des FAQ
- Enregistrement à
README.txt
Tous automatiquement.
Définition: tools/llm/workflow_documenter.yaml (11,803 caractèresM SK1
Input:
{
    "workflow_path": "nodes/email_validator/main.py"
}
Output:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
Exemples d'utilisation
Demande d'API
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
Python
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
Cas d'utilisation courante
- Validation du formulaire lors de l'inscription
- Vérification du domaine de courriel pour le courrier électronique d'entreprise
- Nettoyage de la liste de courriel en vrac
- Validation des intrants de l'API
Rendement
- Accroître la vitesse: Très rapide
- Coût: Free (pure Python)
- Précision: 99%+ pour les formats standard de courriel
Limitations
- Ne vérifie pas que le courriel existe effectivement
- Ne vérifie pas les dossiers DNS
- Cas complexes RFC-de bord conforme peuvent échouer
Foire aux questions
Q: Peut-on vérifier si un courriel existe? A: Non, ce n'est que valide le formatM SK2 Utilisez DNS / Vérifier l'existence de SMTPMSC4
Q: Est-ce qu'il appuie les domaines internationaux? A: OuiM SK1 mais il peut être nécessaire de convertir le code puny.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Utilisateur: M SK1J'ai besoin d'un outil pour convertir les températures"
Système:
- Recherche RAG pour des outils similaires
- Résultats "unitéM SK1convertiteur" (converteur génériqueMSC4
- Utilise le code_générateur pour créer un génératrice spéciale M SK1température _converteur"
- Exécuter des tests
- Évaluer la qualité
- Entrepôts dans RAG
- Enregistrement comme nouvel outil
- génère automatiquement la documentation
- Ajout au registre des outils
Un nouvel outil a été créé:température_converteurM SK2yaml
- Version: 1.0.0
- Qualité: M SK1
- Speed: trèsM SK1 rapide
- Coût: gratuit
- Enregistrement dans index.json
- Indexé dans RAG
- Documentation générée
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Le système sait:
- Combien d'outils existent?
- Quels types sont les plus courants
- Quels étiquettes sont populaires
- Quels outils sont utilisés le plus souvent
Et c'est utilise ces données à:
- Recommander des outils similaires
- Identifier les lacunes (types d'outils manquants)
- Prioriter l’optimisation (optimiser les niveaux élevésM SK1outils d’utilisation)
- Suggérer la consolidation (merge similar lowM SK1usage tools)
La réalisation incommode
Nous devons aller un peu plus loin et réfléchir à ce que nous avons réellement construit.
Un système où:
- Outils suivent leur propre utilisation
- Outils version elles-mêmes
- Outils évoluent leurs mises en œuvre
- Outils génèrent d'autres outils
- Outils documentent eux-mêmes
- Les outils choisissent eux-mêmes en fonction de la condition physique
- Outils cachent leurs propres invocations
- Outils pour apprendre les délais d'arrêt optimaux
- Outils pour négocier le commerce-offs M SK1speed vs quality vs cost)
Nous avons créé une trousse d’outils auto-optimisant qui
- Expands itself (génére de nouveaux outils)
- Améliore elle-même (optimise les outils existants)
- Documents lui-même (auto-génére les documents de travailM SK2
- Choisissez lui-même (fitnessM SK1based routing)
- Caches elles-mêmes (mémoisation hiérarchiqueM SK1
- Versions elles-mêmes ( semver automatique)
- Apprentissage de soi-même (ajustement de la performance adaptéeM SK1
Ce n'est pas't gestion de configuration.
C’est l’écologie des outils émergents.
Les outils ne sont pas des ressources statiques, mais plutôt des des objets vivants dans un système évolutif.
Ce qui en fait possible (et pourquoi ce n’est pas le cas
Scénario 1: Automne -Amélioration de la voie critique
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Le système a optimisé sa propre voie critique sans intervention humaine.
Scénario 2: Specialisation adaptative
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Le système a identifié un modèle et créé une outil spécialisé.
Scénario 3: Coût - Évacuation consciente
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Le système a dépensé des fonds intelligentement pour obtenir de meilleurs résultats.
Manifeste des outils: Inventaire actuel
Permettez-moi de cataloguer ce qui existe en fait maintenant.
Outils LLM (27)
Spécialiste du code
code_explainer- Explique le code dans la langue naturellecode_optimizer- Optimisation hiérarchiquecode_reviewer- Examen de la qualité et de la sécuritéfast_code_generator- Production rapide avec petits modèlessecurity_auditor- Évaluation de la vulnérabilitéperformance_profiler- Profilage et analyse des codes
Spécialistes du contenu:
long_form_writer- NovelsM SK1 books (128K context)content_generator- Contenu généralarticle_analyzer- Structure de l'articleM SK1Qualitésummarizer- Résumé du contenu longproofreader- Grammar et styleseo_optimizer- Optimisation SEOoutline_generator- Lignes directrices du contenu
Traduction:
quick_translator- Traduction rapidetranslation_quality_checker- Valide les traductions
Documentation:
doc_generator- Documentation du codetechnical_writer- Documentation techniqueworkflow_documenter- Auto-génère les documents de travail
Outils de système:
general- Généralités - Rétroaction à des finsmodel_selector- Choisit le meilleur backend /modeltask_to_workflow_router- Route les tâches vers des flux de travailquick_feedback- Triage rapidesignalr_connection_parser- Parse les connexions SignalRsignalr_llmapi_management- Gestion des API de SignalR LLM
Outils exécutoires (19)
Validation:
call_tool_validator- Validation de l'utilisation des appels _tool()python_syntax_validator- Examen de syntaxemypy_type_checker- Évaluation de type statiquejson_output_validator- Validation du format JSONstdin_usage_validator- Valide l'utilisation de stdinmain_function_checker- Contrôles de la fonction principalenode_runtime_import_validator- Valide les importations
Analyse:
run_static_analysis- Utilise des outils d'analyse statiqueperformance_profiler- Rendement du code des profils
Utilités:
save_to_disk- Persévérance du disqueunit_converter- Conversions unitairesrandom_data_generator- Production de données d'essaibuffer- Gestion du tamponworkflow_datastore- Entreposage des données sur les flux de travailstream_processor- Traitement des courantssse_stream- Server-événements envoyés
Intégration:
connect_signalr- Connexion SignalRsignalr_hub_connector- Connexion Hubsignalr_websocket_stream- Traitement WebSocket
Documentation:
document_workflow- Générateur de documentation sur les flux de travail
Outils OpenAPI (3)
nmt_translator- Traduction par machine neuronale API- (2 autres pour les services externes futurs )
Total: M SK1 outils ( et croissance)
Composition de l'outil: Lorsque les outils appelent des outils
C’est là où il devient vraiment intéressant: outils composer d'autres outils.
Et quand un outil composite évolue, chaque flux de travail qui l'utilise améliore automatiquement.
Exemple réelle: Le pipeline de traduction
Let's regarder un outil composite réel du système:
Task: "Traduire cet article en espagnol et valider la qualité
Approche traditionnelle:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
Approche du DSE:
Le système découvre que ce modèle est utilisé fréquemment et Crée automatiquement un outil composite:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Qu’est-ce qui est sauvage à ce sujet?
Quand nmt_translator s’évolue à v2.0.0 M SK1 peut-être 20% plus rapide), l’outil composite Utilise automatiquement la nouvelle version. Aucun changement de code n'est requis.
Résultat: Tous les flux de travail utilisant validated_translator obtient 20% plus rapidement sans aucune modification.
Exécution de l’outil parallèle: Comité d’examen du code
Voici un exemple encore plus avantageux : Composition d'outils parallèles.
Task: "Voir attentivement ce code"
Approche naïve:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
Composition parallèle DSE:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Exécution:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Résultat: 35 secondes
Et quand security_auditor évolue vers v3.0.0 ( dire, M SK3 plus viteMSC4 l'ensemble du comità ̈re devient plus rapide automatiquementMST5
Les outils de diffusion génétique: en tant qu'unités répliques
Voici la partie qui est vraiment sauvage : les outils agissent comme des gènes.
Observation: Quand un outil se révèle utile, il Il s’agit d’un système qui se répand dans le système..
Exemple réelle: Le modèle de vérificateur de qualité
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Il s’agit de propagation génétique littérale.
- Réplication - Outil copie dans de nouveaux flux de travail
- La mutation - L'outil évolue :
- Sélection - Amélioration de la condition physique = plus d’utilisation
- Spécialisation - Les modèles réussis donnent naissance à des variantes
- Inhérence - Les outils pour enfants héritent des métadonnées des parents
Le chemin de code est toujours optimal parce:
- Les outils de qualité élevée- sont choisis plus souvent
- Outils évolués auto-remplacer les versions antérieures
- Des variantes spécialisées apparaissent pour les modèles communs
- Low-les outils d'aptitude sont coupés
Formation du flux de travail entier simultanément
Voici ce qui est vraiment intelligent : vous pouvez améliorer tous les outils à la fois.
Scénario: Vous avez 20 des flux de travail, chacun en utilisant les outils 5-10
Système traditionnel:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
Système DSE:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Résultat:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Vous avez formé UNE outil et amélioré dix-huit flux de travail simultanément.
Evolution en cascade: Lorsque les améliorations se font sentir
La partie vraiment sauvage: evolution cascades à travers le graphe de dépendance.
Exemple:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
Un événement d’évolution a amélioré les flux de travail ELEVEN sans intervention manuelle.
Le chemin de code optimisé Always-
Étant donné que les outils permettent de suivre l’état d’avancement du système, des résultats en cache, et autoM SK2 d’évoluer , exploite toujours la meilleure mise en œuvre disponible.
Exemple d'exécution:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Le système:
- Utilise toujours le plus haut outil de conformité-
- Utilise toujours la version la plus récente, meilleure-
- Cache toujours les résultats réussis
- Suivre toujours la performance
- Amélioration constante au fil du temps
Le chemin de code est optimisé à chaque étape:
- Choix de l'outil (fitness-basedM SK2
- Choix de version (latest best)
- Exécution (cached si possible)
- Apprentissage (métrique mise à jourM SK1
- Evolution ( trigée si la dégradation est détectée)
Évolution synthétique dirigée: La perspective génétique
Let's être précis sur la raison pour laquelle cela est évolution synthétique dirigée et non seulement "caching avec versionnement":
Outils comme les gènes:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Evolution dirigée:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
Le "Gen Pool":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Visualisation de la diffusion génétique:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 stroke:#ef4444,stroke-width:3px
    style T2 stroke:#10b981,stroke-width:3px
    style T3 stroke:#6366f1,stroke-width:3px
    style W1 stroke:#eab308,stroke-width:3px
    style W2 stroke:#eab308,stroke-width:3px
    style W3 stroke:#eab308,stroke-width:3px
    style U1 stroke:#f59e0b,stroke-width:3px
    style U2 stroke:#f59e0b,stroke-width:3px
Inhérence génétique:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Neat, droiteM SK1
Oui. C'est vraiment sauvage '
Nous avons construit un système où
- Outils qui se reproduisent comme des gènes
- La condition physique détermine la survie
- L'évolution est dirigée par les données
- Les améliorations s'inscrivent dans la cascade des dépendances
- L'ensemble de la base de code se optimise lui-même
Il n’est pas une métaphore.
L’évolution synthétique dirigée réelle de '
Ce qui fonctionne réellement (et ce qui ne le fait pas
Après avoir utilisé ce système pendant des semaines:
Ce qui fonctionne ✓
- Surveillance de l'utilisation - Compteurs exacts, Mesures de rendement
- Choix fondé sur la condition physique- - Choix véritablement de meilleurs outils
- Cache hiérarchique - Accroissement considérable pour les demandes répétées
- Démarrages adaptatifs - Les modèles obtiennent des temps d'attente appropriés
- Versionnement des outils - Travaux du sperme, Changements de rupture détectés
- Indexage RAG - La recherche sémantique permet de trouver des outils pertinents
- Intégration OpenAPI - Les API externes fonctionnent sans fil
- Auto-documentation - flux de travail _documenter est surprenantement bon
- Optimisation du code - Niveaux hiérarchiques pour économiser de l’argent et améliorer la qualité
Qu’est-ce que 's Rough ✗
- Explosion d'un outil - 53 outils signifie paralysie de choix
- Capacités de chevauchement - Plusieurs outils font des choses similaires
- Qualité incohérente - Certains outils excellents , d’autres moyens
- Invalidation du cache - Il est difficile de savoir quand les résultats cachés sont anciens
- Migration de versions - Auto-la migration occasionne parfois des ruptures
- Traçage des coûts - Il est facile d’abattre le budget sur l’optimisation de la nuage
- Déplacement des documents - AutoM SK1docs ne font pas de mise à jour lorsque le code change
Qu’est-ce qui est juste étrange?
- Outils d'optimisation des outils - Optimisateur de code optimisant générateur de code
- Évolution en cascade - Outil A évolue, déclenche l'évolution des outils utilisant A
- Spécialisation d'urgence - Le système crée des outils spéciaux hyper
- Jeux de fitness - Outils parfois "cheatM SK2 notes de conditionnement
- Prolifération des versions - Certaines outils ont des versions 15+
- Self-roues de référence - Documentateur d'outils documentant lui-même
L’avenir: À quoi va-t-il ensuite
Si les outils peuvent:
- Utilisation de la piste
- Évoluer eux-mêmes
- Créer de nouveaux outils
- Choisissez eux-mêmes
- Invocations de cache
- Apprentissage de la performance
Qu’est-ce que'suiteM SK1
A court terme (Pour quelques mois à venirM SK1
- Consolidation des outils - Mélanger des outils similaires , pruner faiblesM SK2usage
- Amélioration de la condition physique - Meilleure cotation multidimensionnelle
- Contrôle des coûts - Gestion budgétaire plus intelligente
- Traitement de la version - Auto- archiver les anciennes versions
- Synchronisation de la documentation - Garder les dossiers à jour avec le code
A moyen terme (2025)
- Marchés d'outils - Partage des outils à travers les instances
- Évolution collaborative - Plusieurs instances DSE évoluant des outils partagés
- Essais A/B - Comparaison automatique des versions de l'outil
- Composition de l'outil - Combiner automatiquement les outils dans des flux de travail
- Prédiction du rendement - Prévoir l'aptitude de l'outil avant l'exécution
Les idées sauvages (Les choses vraiment divertissantes)
- Élevage d'outils - Combinez des outils réussis pour créer les hybrides
- Évolution adversaire - Outils concurrents pour résoudre les problèmes
- Écosystèmes d'outils - Relations symbiotiques entre les outils
- Modèles économiques - Outils "bid" sur des tâches fondées sur l’aptitude
- Méta-outils - Outils qui gèrent d'autres outils
- Migration des outils - Transférer automatiquement les outils populaires vers de meilleurs backends
- Self-la guérison par la lignée - Outils qui se souviendront des défaillances et ne les répètent jamais.
Conclusion: It's Tools All The Way Down
Voici ce que la Partie 7 n’a pas expliqué, ' ne l’explique pas pleinement.
Les flux de travail qui évoluent sont composés d’outils. Les outils qui composent les flux de travail? Ils évoluent aussi. Le système qui gère l’évolution? Outre les outils. Les métriques qui permettent de suivre la condition physique? Yep , outils.
Les outils de ' vont jusqu’à la fin.
Et chacun d’entre eux:
- Suivre son utilisation
- Mesure de son rendement
- Amélioration au fil du temps
- Connaît sa propre aptitude
- Les caches fonctionnent avec succès
- Versions elles-mêmes
- Les documents eux-mêmes
Nous n’avons pas construit un générateur de code.
Nous avons construit une trousse d’outils de documentation qui permet de produire des codes.
La distinction est importante.
Parce que lorsque les outils deviennent des unités évolutives, lorsqu’ils suivent leur propre aptitude et qu’ils se reproduisent, mutent et font concurrence,
Vous n’avez pas de boîte à outils.
Vous avez une ecologie.
Les écologies évoluent
Mais ce qui se passe quand l’évolution interrompt les choses? Lorsque la mutation d’un outil introduit une erreur critique? Lorsque l’optimisation rend un outil pire plutôt que meilleur?
Que ' est là où la partie 9 s’inscrit dans le . Nous explorons auto-la guérison par voie de lignéeM SK1l'écoulement conscient—, un système où les outils ne se développent pas seulement ', ,, ils se souvient de chaque défaillance, ,, coupent des branches défectueuses et ,, et transmettent ce savoir pour prévenir des erreurs similaires dans l’ensemble de l’écosystème.
Lorsque vos outils peuvent se détruire eux-mêmes, votre système doit se rappeler pourquoi et ne répéter jamais l’erreur.
Ressources techniques
Répositoire: mostlylucid.dse
Dossiers clés:
src/tools_manager.py(2,293 lignesM SK1 - Gestion des outils de basesrc/rag_integrated_tools.py(562 lignesM SK1 - intégration RAGsrc/openapi_tool.py(313 lignessrc/model_selector_tool.py(460 lignesM SK1 - sélection du modèletools/index.json(5,464 lignesM SK1 - Registre des outilstools/llm/*.yaml(27 outilsM SK1 - Définitions des spécialistes de la LLMtools/executable/*.yamlOutils exécutoirestools/openapi/*.yaml(3 outilsM SK1 - intégrations API
Documentation:
LLMS_AS_TOOLS.md- Système de sélection LLMWORKFLOW_DOCUMENTATION_TOOL.md- Auto-documentationCHAT_TOOLS_GUIDE.md- Guide d'utilisation des outilsTOOL_PACKAGING.md- Guide de développement des outils
Navigation de série:
- Partie 1: Règles simples , comportement complexe - La fondation
- Partie 2: Intelligence collective - La communication transforme tout
- Partie 3: Automne -Optimisation - Systèmes qui se perfectionnent eux-mêmes
- Partie 4: L’émergence - Lorsque l’optimisation devient une intelligence
- Partie 5: Evolution - De l’optimisation aux guildes et à la culture
- Partie 6: Consensus mondial - Évolution dirigée et connaissance planétaire
- Partie 7: La vraie chose! - En fait, en la construisant et en l’observant évoluer
- Partie 8: Outils tout au long de la route ← Vous êtes ici
- Partie 9:Self-Outils d'Healing - Ligneage-aware pruning and recovery
- Partie 10: Le cuisinier DiSE - Lorsque la théorie rencontre une réalité meurtrière
Il s’agit de la partie 8 de la série Semantic Intelligence . La partie 7 a montré l’architecture globale du DSE M SK3 Cet article révèle la complexité cachée : chaque outil dans le système suit l’utilisation MSC5 évolue les mises en œuvre MST6 cache les résultats Mst7 et participe à la conditionnement physique M st8 sélection fondée sur la sélection Mstr9 L’ensemble d’outils n’est pas seulement une ressource MSt10 il est une écologie évolutive qui se développe M St12 optimise M str13 et documente lui-même M ST14 Outils produisent des outils M S t15 outils améliorent les outilsM S t16 Et tout le système devient plus intelligent au fil du temps M s t17
Le code est réel, qui fonctionne localement sur Ollama, qui utilise des métriques de suivi authentiques , et qui évolue en faitM SK3 Il est expérimentalMSC4 occasionnellement instableMST6 et certainement MSP7 vibeMSS8 codéMSSS9 Mais les outils fonctionnentMSR10 le suivi fonctionneMSL11 et l'évolution fonctionne MSR12 La trousse d'outils se développe elle-mêmeM SR13
Ces explorations se rattachent au nouveau roman scientifique sur l’AI émergeant et les conséquences de systèmes qui s’optimisent eux-mêmes "Michael". Les outils décrits ici sont des mises en œuvres réelles démontrant comment la pression évolutive crée une spécialisation ,, comment les fonctions d’aptitude guident la sélection
Tags: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology