
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Bygga mestadels lucid-nmt: En Production-Ready (EasyNMT kompatibel) Översättningstjänst
Saturday, 08 November 2025
Inledning
En FastAPI-implementation kopierar EXAKT API för EasyNMT (https://github.com/UKPLab/EasyNMT) ett utmärkt men övergivet neural-machine-translation-projekt.
Men jag har lagt till så många fina funktioner för att öka tillförlitligheten och göra den redo att användas i ett produktionssystem.Tänk snabbt översättning själv värd...).
Sedan starten av denna blogg har en stor passion varit auto-translating bloggartiklar.
JA jag vet att "google gör detta" i webbläsare etc ... etc ... etc ... men det är inte poängen.mostlylucid-nmtJag ville veta hur man gör!
Plus att det är trevligt att vara välkomnande till människor som inte läser engelska (även om de läser engelska som ett andra språk, är det FAR svårare att tolka).Så jag arbetade ut hur man gör det; samt dela hur man bygger denna typ av system.Åh och det gav mig idéer om hur man använder det i ASP.NET för automatisk lokalisering av text (inklusive dynamisk text) med hjälp av SignalR & ett slick realtidsuppdateringssystem. (
Håll ögonen öppnaI huvudsak; människor skriver skräp text som är SUPER bullriga för maskiner att hantera effektivt.
Så mycket var att räkna ut hur man ska arbeta kring problem med EasyNMT (det var verkligen någonsin ett forskningsprojekt).


vilket gör att både jag och du kan ha en pjäs.
Iskrev ett helt systemhttp://<server>:<port>/demoatt få det att hända med ett fantastiskt projekt som heter EasyNMT.
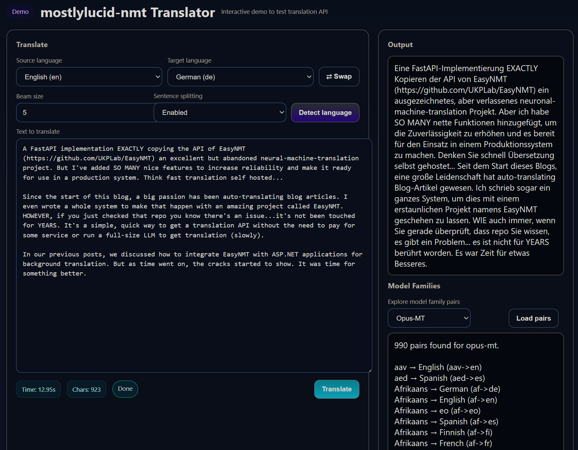
Men om du bara kollade det där report så vet du att det finns ett problem... det har inte rörts på flera år.
Det är ett enkelt, snabbt sätt att få en översättning API utan att behöva betala för någon tjänst eller köra en full storlek LLM för att få översättning (slowly).
I våra tidigare inlägg diskuterade vi hur man integrerar EasyNMT med ASP.NET-applikationer för bakgrundsöversättning.
**Men med tiden började sprickorna visa sig.**Det var dags för något bättre.
**Som vanligt är allt på GitHub och alla gratis för användning etc...**Dockerdrag
- ✓ (ingår i CPMP):
Reusing loaded model for en->de (3/10 models in cache) - ✗ Cpu-min Ordförande:
Need to load model for en->fr (3/10 models in cache) - gpu OrdförandeGpu-min Ordförande
- **Demo ... se senare för demo sida!**En komplett (oftast) interaktiv demosida
- (videller bara roten)
- **Vad är nytt?**Innan vi dyker in i snabbstart, här är vad som gör denna version spel-förändra:
Större uppdateringar (v3.1) - Intelligens och synbarhetNytt i v3.1:
- **Den senaste versionen ger enorma förbättringar i tillförlitlighet, prestandasynlighet och intelligent modellval!**1. Vad är det som händer?
- Smart modell Caching med sikt- Se vad som händer.
- Cache HIT- loggningCache MISS- loggning
- Spårning av cachestatus: Visar utnyttjandeprocent och laddade modeller
- Varning för vräkning: Tydliga varningar när cache är full och modeller vräks
- Ökad kapacitet:
====================================================================================================
  🚀 DOWNLOADING MODEL
  Model: facebook/mbart-large-50-many-to-many-mmt
  Family: mbart50
  Direction: en → bn
  Device: GPU (cuda:0)
  Total Size: 2.46 GB
  Files: 6 main files
====================================================================================================
[Progress bars for each file...]
====================================================================================================
  ✅ MODEL READY
  Model: facebook/mbart-large-50-many-to-many-mmt
  Translation: en → bn is now available
====================================================================================================
**: Förvald cachestorlek guppad till 10 modeller (från 6)**Enhetsloggning per modell
- : Se exakt vilken GPU/CPU varje modell använderTvå.
- Förbättrad nedladdningsförlopp- Jag undrar inte om den är fast.
- Storlek före nedladdning:
[Pivot] Languages reachable from en: 85 languages [Pivot] Languages that can reach bn: 42 languages [Pivot] Found 38 possible pivot languages [Pivot] Selected pivot: en → hi → bn (both legs verified) - **: Visar total nedladdningsstorlek (t.ex., "Total storlek: 2,46 GB")**Filräkning
- : Visar antal filer att ladda nerEnhetsdisplay
: Visar målenhet (GPU/CPU) i bannerFörloppsrader
- **: Vackra tqdm framsteg för varje fil (när på TTY)**Färdigställande banner
- : Tydligt framgångsmeddelande när modellen är klarExempel på utmatning
- 3. Vad är det som händer?:
Request: en→bn with opus-mt
Trying families: ['opus-mt', 'mbart50', 'm2m100']  ✓ All three!
opus-mt: Failed (model doesn't exist)
mbart50: Success! (auto-fallback worked)
Datadriven intelligent pivotval- Inga fler blinda försök:
- Smart skärningslogik
Loading mbart50 model on GPU (cuda:0) - : Hittar språk där BOTH pivot ben finns
Model loaded on device: cuda:0 - Undviker misslyckade försök
Successfully loaded... on GPU (cuda:0)
: Kommer inte att försöka en→es→bn om es→bn inte finnsExempel på en→bn
- Undsättningsprioritet
en->hi,hi->bn - : engelska → spanska → franska → tyska → kinesiska → ryska
- Genomskinlig loggning
[Pivot] Both legs loaded and cached. Ready to translate.
: Se exakt varför varje pivot valdes eller hoppade överFyra.
- Fast automatisk reserv
-
- Inga fler dubbel-tries:
model_familyFörsöker alltid med bakslag.
- Inga fler dubbel-tries:
- : Även om föredra familjen "bör" stödja paret
Engångsförsök per familj
: Inga fler försök med samma modell två gångerExempelflöde
- För att uppnå detta mål har kommissionen beslutat att inleda ett förfarande enligt artikel 108.2 i fördraget om Europeiska unionens funktionssätt (nedan kallat EUF-fördraget).
- GPU-tydlighet
-
- Vet alltid var dina modeller är:
- Varje modellbelastning visar:
- Efter belastningen bekräftas:
**Framgångsmeddelandet omfattar följande:**6. Vad är det som händer?
- Pivot förlaga för cachelagring- Effektiv återanvändning av pivot:
- **Båda benen av pivot cachad separat:**Nästa gång en→hi eller h→bn behövs, omedelbar cache hit!
- **Rensa loggning:**7. Vad är det som händer?
- Urval av förlagor per begäran
**- Fungerar redan i demo:**Demo dropdown gör det möjligt att välja opus-mt, mbart50 eller m2m100
- Gränssnittet respekterar
- parameter per begäran
- Modeller cached separat efter familj för omedelbar omkoppling
- Större uppdateringar (v3.0)
-
- Vad är det som händer?
requirements-prod.txtFörstärkt demosida
- Vad är det som händer?
**- Produktionsklart interaktivt gränssnitt:**Fullständig visningslayout (100vw/100vh) för uppslukande översättningsupplevelse
- **Rätt tema välj rullgardiner (ingen mer klumpig inmatning/datalista)**Familjebyte i realtid (Opus-MT, mBART50, M2M100)
- Dynamisk språkbelastning baserad på vald modellRullbara utdataområden för stora översättningar
- **Två.**Prestandaoptimerade standardvärden
-
- "Snabbt som möjligt" ur lådan:
- GPU
**: FP16 aktiverad, TILLVERKNINGSSATS_SIZE=64, MAX_INFLIGHT=1 (optimalt för enkel GPU)**Maskiner och apparater för tillverkning av massa, papper eller papp, i.a.n.
- : WEB_CONCURRENCY=4, MAX_INFLIGHT=4, TILLVERKNINGSSATS_SIZE=16 (använd alla kärnor)
- Snabb avstängning
- : 5-sekunders graciös timeout (inga fler 20-sekunder hänger)
- Behållare stannar rent utan skrämmande SIGKILL meddelanden
-
- Vad är det som händer?
- Optimering av produktionsbyggande
**- Mindre, snabbare bilder:**Borttagna testberoenden (pytest, pytest-cov) från produktionsbyggen
- Sparar ~200MB per bildCPU-avbildningar: ~8-10GB (fullständig), ~3-4GB (min)
- **GPU-avbildningar: ~12-15GB (fullständig), ~6-8GB (min)**Alla användningsområden
- för minimalt fotavtryckFyra.
Omfattande testning och belastningsprovning- Validera allt:
- Live API testsvit
- (30+ tester) för hälsa, översättning, upptäckt, upptäckt
- k6 belastningsprovning
med realistiska trafikmönsterValideringsskript mellan plattformar
/discover/opus-mt(PowerShell + Bash)/discover/mbart50Tester för modell nedladdningar och pivot översättning fallback/discover/m2m100Automatiserade röktester för snabb validering
**För att uppnå detta mål har kommissionen beslutat att inleda ett förfarande enligt artikel 108.2 i fördraget om Europeiska unionens funktionssätt (nedan kallat EUF-fördraget).**Dokumentation för installation
-
- Produktionsklar från första dagen:
- 4 inställningsscenarier: Max genomströmning, låg latens, hög konkurrent, minne-Konstruerad
- Docker Komponera exempel med GPU/CPU-konfigurationer
Kubernetes manifesterar sig med PVC, resursbegränsningar, hälsokontrollerExempel på Azure Container Prospects
scottgal/mostlylucid-nmt:cpuProvningsvägledning och rekommendationer för övervakning:latestKoncurrency vs throughput kompromisser förklarasscottgal/mostlylucid-nmt:cpu-min6. Vad är det som händer?scottgal/mostlylucid-nmt:gpuTre modeller för familjerscottgal/mostlylucid-nmt:gpu-min- Välj det bästa för dina behov:
Opus-MT: 1200+ par, bästa kvalitet (separata modeller)
- MBART50 Ordförande
latest,min,gpu,gpu-min: 50 språk, enkel 2,4 GB modell, 2 450 par - M2M100 Ordförande
20250108.143022: 100 språk, en 2.2GB modell, 99900 par -
- Vad är det som händer?
Auto-Fallback- Väljer intelligent bästa tillgängliga modell:
- **Ställ in primär familj (t.ex., Opus-MT för kvalitet)**Försöker automatiskt mBART50/M2M100 om par inte finns tillgängliga
- Maximal täckning utan att offra kvalitet8. Vad är det som händer?
- Modell Upptäckt- Dynamiskt fråga tillgängliga modeller:
-
- Alla 1200+ par från Hugging Face
- Alla mBART50 par- Alla M2M100 par
-
- Utövande av delegeringen av befogenhet
- Minimala bilder
- Mindre och flexibel användning:
Inga förladdade modeller (nedladdning on-demand)
Volymmappad ihållande cache
Byt modellfamiljer utan ombyggnad**- Tio. - Vad är det?**Ett enda dockningsarkiv
- Alla varianter på ett ställe:
|-----|-----------------|------|-------------|----------|
|
cpu(ellerlatest) |scottgal/mostlylucid-nmt:cpu) - CPU |cpu-min|scottgal/mostlylucid-nmt:cpu-min- CPU minimal |gpu|scottgal/mostlylucid-nmt:gpu- GPU med CUDA 12.6 |gpu-min|scottgal/mostlylucid-nmt:gpu-min- GPU minimal
**11. Vad är det som händer?**Korrekt översättning
-
- Alla bilder inkluderar datumversioner:
- Namngivna etiketter (
- ) alltid peka på den senaste bygget
- Utbytbara versionstaggar (t.ex.
) för spikning av särskilda byggnader
Fullständiga OCI-etiketter för spårningsversioner, byggdatum och git begår
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  scottgal/mostlylucid-nmt
Det finns inga bevis för att det finns en risk för att det finns en risk för att det finns en risk för att det finns en risk för att det uppstår en allvarlig störning.
curl -X POST "http://localhost:8000/translate" \
  -H "Content-Type: application/json" \
  -d '{
    "text": ["Hello, how are you?"],
    "target_lang": "de"
  }'
Senaste basbilder
{
  "translated": ["Hallo, wie geht es Ihnen?"],
  "target_lang": "de",
  "source_lang": "en",
  "translation_time": 0.34
}
- Säkerhets- och prestandaförbättringar:
Python 3.12-slim
docker run -d \
  --name mostlylucid-nmt \
  --gpus all \
  -p 8000:8000 \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu
för CPU-avbildningar (adresser Python 3.11 sårbarheter)
CUDA 12.6
med Ubuntu 24.04 för GPU-avbildningar (senaste NVIDIA stacken)
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  -v $HOME/model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  scottgal/mostlylucid-nmt:cpu-min
PyTorch med CUDA 12.4
docker run -d `
  --name mostlylucid-nmt `
  -p 8000:8000 `
  -v ${HOME}/model-cache:/models `
  -e MODEL_CACHE_DIR=/models `
  scottgal/mostlylucid-nmt:cpu-min
(kompatibel med CUDA 12.6 körtid)
docker run -d ^
  --name mostlylucid-nmt ^
  -p 8000:8000 ^
  -v %USERPROFILE%/model-cache:/models ^
  -e MODEL_CACHE_DIR=/models ^
  scottgal/mostlylucid-nmt:cpu-min
Alla beroenden uppdaterade till de senaste säkra versionerna
- 13. - Vad är det?
curl http://localhost:8000/healthz
Varningar för fast avskrivning
- Framtidssäkrad:
Borttagen avkorrigerad TRANSFORMERS_CACHE (numera med hjälp av HF_HOME)Kompatibel med transformatorer v5Snabbstart (5 minuter)
http://localhost:8000/demo/
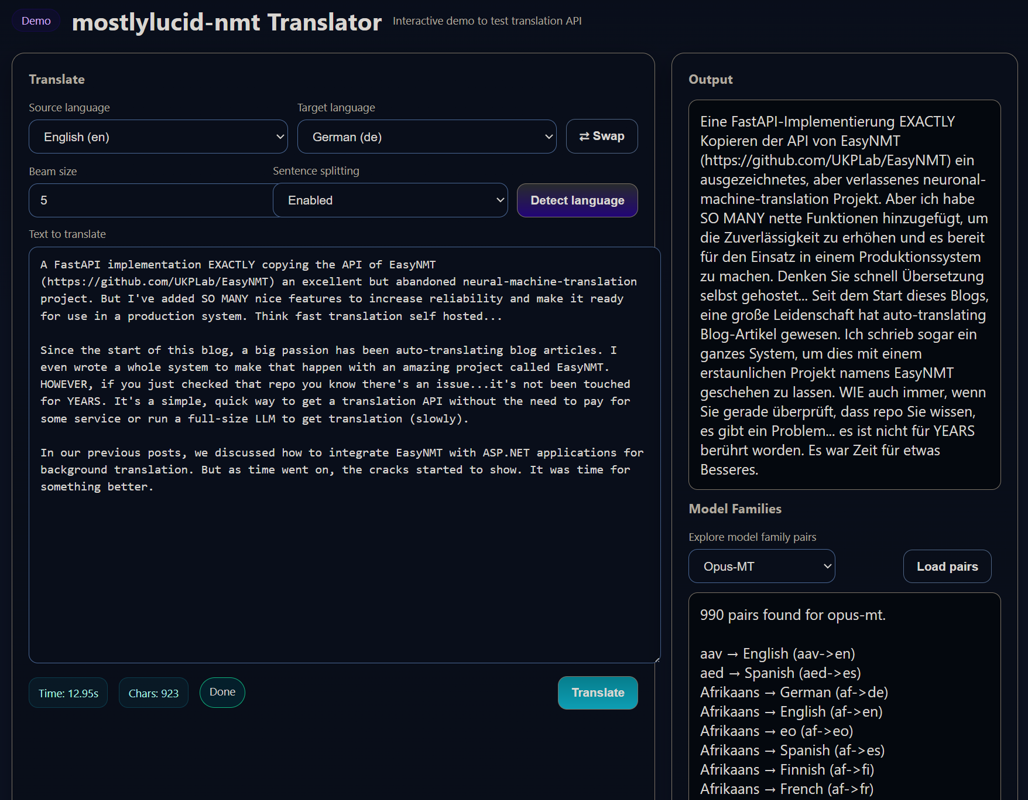
Här är det absolut enklaste sättet att köra mestadels lucid-nmt:
Tillgängliga dockningsbilder
- Alla varianter finns tillgängliga från
- ett arkiv
- med olika etiketter:
på Tagg på full bild Namn på storlek på Beskrivning på användningsfall på plats
- (eller
- på ~2.5GB på CPU med källkod på Produktion CPU-utbyggnad
- på ~1.5GB på CPU minimal, inga förladdade modeller på volym-mappad cache, flexibel
- GPU med CUDA 12.6 + källa på produktions GPU-utplaceringar
- GPU minimal, inga förladdade modeller på GPU med volymmappade cache
Minimala bilder
- rekommenderas för:
- Produktionsinstallationer med volymomfattad cache
- Användning av mBART50 eller M2M100 (enstaka stora modeller)
Hålla behållaren liten
- Flexibilitet för att byta modellfamiljer utan återuppbyggnadEnkel start (Opus-MT-processor)
-
- Vad är det som händer?
- Dra och spring:
-
- **Två.**Översätt någon text:
- Svar:
- GPU accelererad (10x snabbare)
Kräver NVIDIA Docker körtid:
- Med ihållande modell CacheLadda ner modeller en gång och hålla dem över behållare omstarter:
- **Linux/Mac:**Fönster (PowerShell):
- **Fönster (CMD):**Modeller laddas ner automatiskt vid första användning och finns kvar i din lokala katalog!
Hälsokontroll:
- Det är 5 minuters snabbstart!
- **För produktion installation, konfiguration och avancerade funktioner, hålla läsning.**Interaktiv demosida
- Tjänsten inkluderar en fullfjädradinteraktiv demosida
- **som gör det enkelt att testa översättningar utan att skriva någon kod.**Få tillgång till den på:
- Demografiska egenskaper
Demosidan ger en komplett översättningstestningsmiljö med:
- Vad är det som händer?
// Example: Translating a 5000-word article
Input: Long article with multiple paragraphs

Step 1: Split by paragraphs (preserves structure)
  → Paragraph 1 (800 chars)
  → Paragraph 2 (1200 chars)
  → Paragraph 3 (600 chars)
  ...

Step 2: Group into ~1000 character chunks
  → Chunk 1: Paragraphs 1-2
  → Chunk 2: Paragraph 3-4
  → Chunk 3: Paragraphs 5-6

Step 3: Translate each chunk sequentially
  → Shows progress: "Translating chunk 1/3..."
  → Shows progress: "Translating chunk 2/3..."
  → Shows progress: "Translating chunk 3/3..."

Step 4: Reassemble with paragraph breaks
  → Final output: Complete translated article with preserved formatting
Språkval
Automatiskt befolkade språkdroppar från live-tjänsten
- Byt källkod/målspråk med ett klick
- Stöder alla 100+ språk konfigurerade i tjänsten
- Två.
- Smart textknäppning
Hanterar automatiskt stora textingångar oavsett storlek
- Intelligent uppdelning efter punkter, bevara dokumentstruktur
- Faller tillbaka till straffdelning för mycket långa punkter
- Visar förlopp för multi-chunk översättningar ("Översättning bit 2/5...")
- Sömlös återmonterar bitar med rätt avstånd
3. Vad är det som händer?
- Påvisande av språk
- Upptäck källspråket med ett klick
- Fyller automatiskt i dropdown för källspråk
- Fungerar med text upp till 5000 tecken
Fyra.
Avancerade alternativ:
- Strålstorlek
- : Kontroll översättning kvalitet (1-10)
- Högre värden = bättre kvalitet men långsammare
- Lägre värden = snabbare genomströmning
Skadefördelning:
- : Växla automatisk meningsdelning
- Aktiverad (standard): Delar långa texter i meningar för bättre kvalitet
- Inaktiverad: Översätter hela texten som ett block (snabbare för korta texter)
- För att uppnå detta mål har kommissionen beslutat att inleda ett förfarande enligt artikel 108.2 i fördraget om Europeiska unionens funktionssätt (nedan kallat EUF-fördraget).
Statistik i realtid:
- Översättningstid
- : Visar faktisk tid för översättning på serversidan
- Teckenräkning
- : Live räkna som du skriver
Statusindikator
: Idle → Translating → Klar/Error
- **6. Vad är det som händer?**Förlaga till familjeupptäckt
- **Utforska tillgängliga översättningspar för varje modellfamilj:**Opus-MT
- : 1200+ språkparMBART50 Ordförande
- : 50 språk, 2 450 parM2M100 Ordförande
: 100 språk, 9 900 par/demo/Se exakt vilka språkpar som finns tillgängliga innan du översätter
Hur textknäppning fungerar
Demo implementerar intelligent text bitning på klientsidan:Varför använda demo?SnabbtestTestöversättningar utan skrivningskodValidera språkparets tillgänglighet
Jämför översättningskvalitet med olika balkstorlekar
- **Provkantsfall (emoji, symboler, specialtecken)**Utvecklingsstöd
- Se exakt API-förfrågan/responsformatKontrollera hälso- och sjukvården innan du integrerar
- Provningsprestanda med olika textstorlekarUpptäck tillgängliga modellfamiljer
- KundreferensVisar korrekta API- användningsmönster
- **Visar felhantering (429, språkdetektering)**Exempel på genomförande av styckning
- Real-world retry logikExempel på användningEnkel översättning.
- **Klistra in texten: "Hej, hur mår du idag?"**Välj mål: Tyska
- **Klicka på "Översätt"**Resultat: "Hallo, wie geht es Ihnen heute?"
Översättning av långa dokument
Klistra in hela blogginlägget (5000 + ord)Demo skär den automatiskt i hanterbara bitarVisar förlopp när varje bit översätter
Returnerar fullständigt översatta dokument
Påvisande av språkKlistra in text på okänt språkKlicka på "Detektera språk"
Demo identifierar språk och uppdateringar dropdown
- Redo att översätta omedelbartTekniska detaljer
- **Demosidan är:**Delar och tillbehör till maskiner enligt nr 8456 eller till hjälpapparater för sådana maskiner eller apparater, inte nämnda eller inbegripna någon annanstans i detta kapitel, inte nämnda eller inbegripna någon annanstans i detta kapitel
- : Enkel HTML-fil med inbäddat JavaScriptNollberoenden
- : Inga externa bibliotek krävsMobilvänlig
- : Responsiv design fungerar på alla enheterProduktion färdig
- : Samma bitningslogik kan användas i dina apparFå tillgång till live demo på
På din löpande instans!
- Problemen med EasyNMTDet här är inte att dumpa på
- LättNMTDet gjorde så att inget annat kunde och jag har byggt
- Ett stort antal projekt som använder den
- **Det börjar bara bli långt i tanden så... vilka problem har vi?**Herregud, det är många.
- **EasyNMT byggdes för nästan tio år sedan.**Tekniken har gått vidare... plus att det aldrig var tänkt att vara ett system på produktionsnivå.
- **Här är några av frågorna:**Det kraschar... en LOT.
Den är inte utformad för att återhämta sig från problem så ofta faller bara över.
- **Det är SUPER PICKY om dess input.**Smilisar, symboler, även siffror kan förvirra det.
- **Den är inte avsedd för någon last.**Se ovan.
- **Det var aldrig konstruerat för att vara.**Den är inte utformad för att uppdatera sina modeller
- **eller vara (lätt) byggd med inbyggda modeller.**Dess GPU CUDA grejer är uråldriga
- **Så långsammare än vad det behöver vara.**Du kan inte fixa nåt.
- **Python-koden är på repo men igen.**Inte så bra.
**Inget mottryck eller köande.**Skicka för många förfrågningar och det bara kölar över.MODEL_FAMILYIngen observationsförmåga.
# Opus-MT (default, best quality)
MODEL_FAMILY=opus-mt

# mBART50 (50 languages, single model)
MODEL_FAMILY=mbart50

# M2M100 (100 languages, broadest coverage)
MODEL_FAMILY=m2m100
När saker går fel, du flyger blind.
Lösningen: MestadelsLucid-NMTSå...Jag bestämde mig för att bygga en ny och förbättrad EasyNMT, nuMest lucid-nmt
- Detta är inte bara ett lapp jobb; det är en komplett omskrivning med produktionsanvändning i åtanke.
MODEL_FAMILYHär är vad som gör det bättre:opus-mtStöd för familjer i flera modeller - MestadelsLucid-NMT stöder nu
- Tre översättningsmodellfamiljer
- , ger dig flexibilitet baserat på dina behov:
Opus-MT (Helsinki-NLP) - Förval
# Set primary to Opus-MT (best quality)
MODEL_FAMILY=opus-mt
AUTO_MODEL_FALLBACK=1
MODEL_FALLBACK_ORDER=opus-mt,mbart50,m2m100

# Request Ukrainian → French
# 1. Try Opus-MT first (not available)
# 2. Automatically fall back to mBART50 (available!)
# 3. Translation succeeds with mBART50
Täckning:
- 1200+ översättningspar för 150+ språkArkitektur:
- Separat modell per översättningsriktningKvalitet:
- Bästa övergripande översättningskvalitetAnvändningsfall:
- Produktionsöversättningar där kvalitetsfrågorFörlagans storlek:
300–500 MB per riktning
# Enable auto-fallback (default: enabled)
AUTO_MODEL_FALLBACK=1

# Set fallback priority (default: opus-mt → mbart50 → m2m100)
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"

# Disable for strict single-family mode
AUTO_MODEL_FALLBACK=0
Exempel:
Engelska→Tyska är en annan modell än tyska→engelska
- **mBART50 (Facebook)**Täckning:
- 50 språk, all-to-all översättningArkitektur:
- En enda flerspråkig modellKvalitet:
- God kvalitet, särskilt för stora språkAnvändningsfall:
- Utrymmesbegränsade utplaceringar eller många språkparFörlagans storlek:
- **~2.4GB (en enda modell för alla 50 språk)**Fördel:
- En modell hanterar 2 450 översättningsparM2M100 (Facebook)
- **Täckning:**100 språk, all-to-all översättning
- **Arkitektur:**En enda flerspråkig modell
- **Kvalitet:**God kvalitet med bredast språktäckning
- **Användningsfall:**Maximal språktäckning
-minFörlagans storlek:
~2.2GB (en enda modell för alla 100 språk)
Fördel:
En modell hanterar 9,900 översättningspar
Växling är lätt
-
- Bara ställa in
- miljövariabel:
- Automatisk modell Family Fallback - NY!
En av de mest kraftfulla nya funktionerna är
- automatisk reserv mellan modellfamiljer
- Detta garanterar maximal språkpar täckning samtidigt prioritera översättning kvalitet.
**Hur det fungerar:**Du ställer in en primär
- **(t.ex.**för bästa kvalitet)
- När du begär ett översättningspar som inte är tillgängligt i den primära familjenSystemet testar automatiskt nästa familj i reservordning
- Detta fortsätter tills en lämplig modell hittasExempel på scenario:
Fördelar:
Maximal täckning:
Stöd 100+ språk utan att hantera flera utplaceringar
- Kvalitetsprioritering:
- Använd alltid den bästa tillgängliga modellen för varje par
- Nollinställning:
- Fungerar automatiskt, ingen manuell åtgärd behövs
Transparent loggning:
- Se vilken modellfamilj som användes för varje översättning
- Inställning:
- Denna funktion är perfekt för produktionsmiljöer där du vill ha maximal täckning utan att offra kvalitet!
- Viktiga förbättringar
Flera modeller för familjestöd
# NMT: Fits on a USB stick
du -sh model-cache/
2.5G    model-cache/

# LLM: Needs serious storage
du -sh llama-models/
140G    llama-models/
- Välj mellan Opus-MT (1200+ par), mBART50 (50 språk), eller M2M100 (100 språk).
Förlaga till resultatmått för upptäckt
-
- Dynamiskt fråga tillgängliga modeller från Hugging Face för varje familj.
- Robust hantering av indata
-
- Är det Emoji?
- Siffror?
Symboler?
- Sätt igång.
- Tjänsten innehåller nu omfattande input sanitisering och symbol maskering.
- Begär köning och mottryck
-
- Inbyggd semaforbaserad kö med intelligenta försök efter beräkningar.
LRU-modell cachelagring
- Hanterar automatiskt VRAM genom att vräka gamla modeller när cachen är full. |--------|------|------| Modernt stöd för CUDA
- Använder PyTorch med CUDA 12.6, stöder FP16/BF16 för 2x hastighetsförbättringar. Produktionsklar observerbarhet
- Hälsokontroller, beredskaps sonder, cachestatus, strukturerad loggning. Förtjusande avstängning
Inga fler övergivna förfrågningar eller korrupta stater.
EasyNMT-kompatibelt API
-
- Drop-in ersätter befintliga integrationer.
- Reträtt för översättning av pivot
-
- Om ett direkt språkpar inte är tillgängligt, leder du automatiskt genom engelska (eller din valda pivot).
- Minimala Docker-bilder
-
- Ny
varianter med volymmappad cache för mindre installationer.
- ⚠️ Sometimes adds interpretations not in original
- ⚠️ Quality varies with prompt phrasing
- ⚠️ Can be "creative" with technical terms
- ⚠️ Needs careful prompt engineering
- ⚠️ Unpredictable with edge cases
Varför NMT över LLMs för översättning?
Input: "The API returns a 429 status code when rate limited."

NMT (Opus-MT): "Die API gibt einen 429-Statuscode zurück, wenn sie ratenbegrenzt ist."
(Accurate, preserves technical terms)

LLM (might do): "Die API sendet den Fehlercode 429, wenn zu viele Anfragen gestellt werden."
(Interprets rather than translates, adds context not in original)
Du kanske undrar: "Varför använda en dedikerad NMT-tjänst när LLMs som GPT-4, Claude, eller Llama kan översätta?" Bra fråga.
Här är verklighetskontrollen baserad på produktionsanvändning:
- Hastighet: 10-100x Snabbare
- NMT (mestadelslylucid-nmt):
- CPU: ~0,3-1,0 sekunder per mening
- GPU (FP16): ~0.05-0,2 sekunder per mening
- Partibearbetning: 50+ meningar/sekund på GPU
- LLM:
GPT-4: 3-10 sekunder per begäran (API latens + generation)
- Llama 3 70B: 5-15 sekunder per mening (lokal)
- Claude 3: 2-8 sekunder per begäran (API latens)
- Verkligt exempel:
- Översättning av ett 1000-ords blogginlägg:
- Mest lucid-nmt (GPU)
: 5-10 sekunder
GPT-4 API**: 30-60 sekunder**Lokala Llama 70B
- : 2-5 minuter
- När du automatiskt översätter hundratals blogginlägg till 12+ språk är den hastighetsskillnaden MASSIV.
- Modellstorlek: 500MB vs 140GB
- NMT-modeller:
Opus-MT (per riktning): 300-500MB
mBART50 (alla 50 språk): 2.4GBM2M100 (alla 100 språk): 2.2GB
Totalt för 100+ språk: ~2.2GB
flowchart LR
    A[HTTP Client] --> B[API Gateway]
    B --> C[Translation Endpoint]
    C --> D{Has Capacity?}
    D -->|Yes| E[Translation Service]
    D -->|No| F[Queue with 429]
    F --> E
    E --> G[Process Pipeline]
    G --> H[Get Model from Cache]
    H --> I[Translate]
    I --> J[Return Response]
    J --> A
LLM:
- Llama 3 8B: ~16GBLlama 3 70B: ~140GB
- Mixtral 8x7B: ~90GBGPT-4: Ej tillgängligt för självvärdande
- **Inverkan vid lagring:**Resurskrav: Laptop vs Server Farm
- **Utplacering av NMT-processor:**Körs bra på: 2 processorkärnor, 4 GB RAM
- Docker bild: 1.5-2.5GBSlutsatser: Endast CPU, ingen GPU behövs
Retry-AfterKostnad: $10-20/månad VPS
- **LLM-krav:**Llama 3 70B: Behov 80GB+ VRAM (A100 GPU)
- Mindre 7B-13B modeller: Fortfarande 16-32GB RAM minimum
- API-kostnader: $0.03-0.30 per 1000 polletter (kompletterar snabbt!)
- Självvärdighet: $1000+/månad för seriös GPU
- Real kostnad jämförelse för 10 000 blogginlägg översättningar:
- på metod på bekostnad av tidtill största delen lucid-nmt (CPU) på $20/månad VPS på 2-3 timmar
- De flesta lucid-nmt (GPU) på 50 dollar/månad GPU VPS 15-30 minuter
- på GPT-4 API på $ 150-300 8-15 timmar
- på Claude API på $200-400 på 6-12 timmar
- Lokal Llama 70B $ 1000+/månad hårdvara på 20-40 timmarKvalitet: Syfte-Built vs General-Purpose
**NMT styrkor:**Utbildad särskilt för översättningRetry-AfterKonsekvent kvalitet (samma indata = samma utdata)
Inga "hallucinationer" - ren översättning
Hanterar tekniskt innehåll, kod, formatering väl
Ingen snabb konstruktion behövs
sequenceDiagram
    participant Client
    participant API
    participant Queue
    participant Translator
    participant Cache
    participant Model

    Client->>API: POST /translate
    API->>Queue: Acquire slot

    alt Queue has space
        Queue-->>API: Slot acquired
        API->>Translator: Process translation
        Translator->>Translator: Sanitize input
        Translator->>Translator: Split sentences
        Translator->>Translator: Chunk text
        Translator->>Translator: Mask symbols
        Translator->>Cache: Get model (en→de)

        alt Cache hit
            Cache-->>Translator: Return cached model
        else Cache miss
            Cache->>Model: Load from Hugging Face
            Model-->>Cache: Pipeline loaded
            Cache->>Cache: Evict old if at capacity
            Cache-->>Translator: Return model
        end

        Translator->>Model: Translate batches
        Model-->>Translator: Translations
        Translator->>Translator: Unmask symbols
        Translator->>Translator: Post-process
        Translator-->>API: Translations
        API->>Queue: Release slot
        API-->>Client: 200 OK + translations
    else Queue full
        Queue-->>API: Overflow error
        API-->>Client: 429 Too Many Requests\nRetry-After: X seconds
    end
Utmaningar för LLM:
Exempel på scenario:
graph LR
    A[Raw Input] --> B{Sanitize?}
    B -->|Yes| C[Check Noise]
    B -->|No| D[Split Sentences]
    C -->|Is Noise| Z[Return Placeholder]
    C -->|Valid| D

    D --> E[Enforce Max Length]
    E --> F[Chunk for Batching]
    F --> G{Symbol Masking?}

    G -->|Yes| H[Mask Digits/Punct/Emoji]
    G -->|No| I[Translate]
    H --> I

    I --> J{Direct Model?}
    J -->|Available| K[Direct Translation]
    J -->|Not Available| L{Pivot Fallback?}

    L -->|Yes| M[src→en→tgt]
    L -->|No| Z
    K --> N[Unmask Syis robust input handling. Here's what happens:

**Noise Detection:**
- Strips control characters (except \t, \n, \r)
- Checks minimum character count (default: 1)
- Calculates alphanumeric ratio (default: must be ≥20%)
- Rejects pure emoji, pure punctuation, or pure whitespace

**Symbol Masking:**
Why mask symbols? Translation models are trained on text, not emoji or special symbols. These can confuse them or get mangled. So we:

1. Extract all digits, punctuation, and emoji as contiguous runs
2. Replace them with sentinel tokens: `⟪MSK0⟫`, `⟪MSK1⟫`, etc.
3. Translate the masked text
4. Restore the original symbols in their positions

Example:
Input: "Hello 👋 world! Price: $99.99" När var och en ska användas (👋) (!) (:) ($99.99)
**Post-Processing:**
After translation, we remove "symbol loops" - repeated symbols that weren't in the source:
Använd NMT (mestadelslylucid-nmt) när: Du behöver konsekvent, snabb översättning i skala Budgetfrågor (självvärdighet eller hög volym)
### Sentence Splitting & Chunking

Long texts get split intelligently:

```mermaid
graph TD
    A[Long Text] --> B[Split on . ! ? …]
    B --> C{Sentence > 500 chars?}
    C -->|Yes| D[Split on word boundaries]
    C -->|No| E[Keep sentence]
    D --> E

    E --> F[Group into chunks ≤900 chars]
    F --> G[Translate each chunk]
    G --> H[Join with space]
Du översätter tekniskt innehåll, kod, strukturerad data
- Du behöver deterministisk utmatning (samma indata = samma utdata)
- Du vill köra på CPU eller blygsam hårdvara
- Du bygger automatiska översättningsrörledningar.
Använd LLMs när:
Du behöver kreativ anpassning, inte bokstavlig översättning
stateDiagram-v2
    [*] --> CheckCache
    CheckCache --> CacheHit: Model exists
    CheckCache --> CacheMiss: Model not loaded

    CacheHit --> MoveToEnd: Update LRU order
    MoveToEnd --> ReturnModel

    CacheMiss --> CheckCapacity
    CheckCapacity --> LoadModel: Space available
    CheckCapacity --> EvictOldest: Cache full

    EvictOldest --> MoveToCPU: Free VRAM
    MoveToCPU --> ClearCUDA: torch.cuda.empty_cache()
    ClearCUDA --> LoadModel

    LoadModel --> AddToCache
    AddToCache --> ReturnModel
    ReturnModel --> [*]
Sammanhang och kulturell nyansering betyder mer än snabbhet
- Du gör översättningar med låg volym.
- Du måste översätta + sammanfattning + skriva om i ett steg
- Du är okej med rörliga kostnader och långsammare bearbetning
- Bottenlinjen
- För
automatiserad översättning av bloggar
(mitt användningsfall) NMT är den tydliga vinnaren:
# Semaphore limits concurrent translations
MAX_INFLIGHT = 1  # On GPU, 1 at a time for efficiency
MAX_QUEUE_SIZE = 1000  # Up to 1000 waiting

# When full:
# - Returns 429 Too Many Requests
# - Includes Retry-After header
# - Estimates wait time based on average duration
Översätter 100+ blogginlägg till 12 språk på ~30 minuter (GPU)
avg_duration = 2.5 seconds (tracked with EMA)
waiters = 100
slots = 1
estimated_wait = (100 / 1) * 2.5 = 250 seconds
clamped = min(250, 120) = 120 seconds
Retry-After: 120
Körs på en $ 50 / månad VPS
Konsekvent kvalitet på alla tjänster
graph LR
    A[Ukrainian Text] --> B{Direct uk→fr?}
    B -->|Exists| C[Translate Directly]
    B -->|Missing| D[Pivot via English]

    D --> E[uk→en]
    E --> F[en→fr]
    F --> G[French Result]
    C --> G
Total installation: En Docker-behållare
Prova detta med LLMs skulle kosta hundratals dollar per månad i API-avgifter eller kräva en $ 2000 + GPU-server att självvärd.
Enbart hastighetsskillnaden gör NMT till det enda praktiska valet för produktionsöversättningar.
TL;DR:
NMT är avsedd för översättning, körs på blygsam hårdvara, och är 10-100x snabbare än LLMs. Om du behöver snabb, konsekvent, kostnadseffektiv översättning i skala, NMT vinner hands down.
# src/core/cache.py
from collections import OrderedDict
import torch

class LRUPipelineCache:
    """LRU cache that automatically cleans up GPU memory when evicting models."""

    def __init__(self, capacity: int):
        self.cache = OrderedDict()  # Maintains insertion order
        self.capacity = capacity

    def get(self, key: str):
        """Get model from cache, moves it to end (most recently used)."""
        if key not in self.cache:
            return None
        self.cache.move_to_end(key)  # Mark as recently used
        return self.cache[key]

    def put(self, key: str, value):
        """Add model to cache, evicting oldest if at capacity."""
        if key in self.cache:
            self.cache.move_to_end(key)
        else:
            self.cache[key] = value

        # If cache is full, evict the oldest model
        if len(self.cache) > self.capacity:
            oldest_key, oldest_pipeline = self.cache.popitem(last=False)

            # MAGIC: Move evicted model to CPU to free GPU memory
            try:
                oldest_pipeline.model.to("cpu")
                if torch.cuda.is_available():
                    torch.cuda.empty_cache()  # Tell GPU to release memory
                logger.info(f"Evicted {oldest_key}, freed GPU memory")
            except Exception as e:
                logger.warning(f"Failed to clean GPU memory: {e}")
Översikt över arkitekturen
OrderedDictBegärans flöde är enkelt:- Kundskickar översättningsbegäran till API Gateway (Gunicorn + Uvicorn-arbetare)
- API- gatewayNamerutter till Translation Endpoint
- Kapacitetskontroll: Systemkontroller om den har kapacitet att hantera begäran
Ja, det är jag.
→ Begäran går till översättningstjänsten omedelbart
# src/services/model_manager.py
def get_pipeline(self, src: str, tgt: str):
    """Try to get translation model, with automatic fallback to other providers."""

    # Determine which model families support this language pair
    families_to_try = []

    if config.AUTO_MODEL_FALLBACK:
        # Try families in priority order: opus-mt → mbart50 → m2m100
        for family in config.MODEL_FALLBACK_ORDER.split(","):
            if self._is_pair_supported(src, tgt, family.strip()):
                families_to_try.append(family.strip())

    # Try each family until one succeeds
    last_error = None
    for family in families_to_try:
        try:
            model_name, src_lang, tgt_lang, _ = self._get_model_name_and_langs(src, tgt, family)

            if family != config.MODEL_FAMILY:
                logger.info(f"Using fallback '{family}' for {src}->{tgt}")

            # Load the model from HuggingFace
            pipeline = transformers.pipeline(
                "translation",
                model=model_name,
                device=device_manager.device_index,
                src_lang=src_lang,
                tgt_lang=tgt_lang
            )

            self.cache.put(f"{src}->{tgt}", pipeline)
            return pipeline

        except Exception as e:
            last_error = e
            logger.warning(f"Family '{family}' failed for {src}->{tgt}: {e}")
            continue  # Try next family

    # All families failed
    raise ModelLoadError(f"{src}->{tgt}", last_error)
Ej tillämpligt
- → Begär köad, klienten får HTTP 429 medHuvud
- Översättningstjänstbehandlar begäran genom rörledningen
- Insatssanering och meningsdelningSymbolmaskering (emojis, specialtecken)
- Översättning med cachade modellerSymbolisk avmaskning och efterbehandling
Förlaga Cache
(LRU) tillhandahåller översättningsmodeller:
# src/services/queue_manager.py
import asyncio
from contextlib import asynccontextmanager

class QueueManager:
    """Manages request queuing and backpressure."""

    def __init__(self, max_inflight: int, max_queue: int):
        self.semaphore = asyncio.Semaphore(max_inflight)  # Limit concurrent translations
        self.max_queue_size = max_queue
        self.waiting_count = 0
        self.inflight_count = 0
        self.avg_duration_sec = 5.0  # Exponential moving average

    @asynccontextmanager
    async def acquire_slot(self):
        """Try to get a translation slot, track metrics, handle queueing."""

        # Check if queue is too full
        if self.waiting_count >= self.max_queue_size:
            # Calculate how long client should wait before retrying
            retry_after = self._estimate_retry_after()
            raise QueueOverflowError(self.waiting_count, retry_after)

        self.waiting_count += 1
        try:
            # Wait for available slot (this is the queue!)
            await self.semaphore.acquire()
            self.waiting_count -= 1
            self.inflight_count += 1

            start_time = time.time()
            yield  # Let the translation happen

            # Update average duration for retry-after estimates
            duration = time.time() - start_time
            alpha = config.RETRY_AFTER_ALPHA  # Smoothing factor (0.2)
            self.avg_duration_sec = alpha * duration + (1 - alpha) * self.avg_duration_sec

        finally:
            self.inflight_count -= 1
            self.semaphore.release()

    def _estimate_retry_after(self) -> int:
        """Smart calculation: how many waiting / how many slots * avg time per request."""
        if self.inflight_count == 0:
            return config.RETRY_AFTER_MIN_SEC

        # If 10 people waiting and 2 slots available, and each takes 5 seconds:
        # retry_after = (10 / 2) * 5 = 25 seconds
        retry_sec = (self.waiting_count / self.semaphore._value) * self.avg_duration_sec

        # Clamp between min and max
        return max(
            config.RETRY_AFTER_MIN_SEC,
            min(int(retry_sec), config.RETRY_AFTER_MAX_SEC)
        )
Cache hit → Snabb respons
- Cache miss → Ladda från HuggingFace HubCache full → Auto-evict gamla modeller, rensa CUDA minne
max_inflight) - Svar (
@asynccontextmanageråtervänder till klienten - **Nyckeldesign:**Mottrycksmekanismen (queue + HTTP 429) förhindrar sammanbrott under belastning.
- När överväldigad, tjänsten köer förfrågningar i stället för att dö, ger kunderna intelligent försök timing viaHuvuden.
- Hur det fungerar: DjupdykningBegär flöde
När en översättning begäran kommer in, här är vad som händer:
Inmatningsbearbetningsrör
# src/utils/symbol_masking.py
import re

def mask_symbols(text: str) -> tuple[str, dict[str, str]]:
    """Replace special symbols with placeholders before translation."""

    originals = {}
    masked_text = text
    placeholder_counter = 0

    # Pattern: Match emojis, symbols, special punctuation
    # \U0001F300-\U0001F9FF = emoji range
    # [\u2600-\u26FF\u2700-\u27BF] = misc symbols
    symbol_pattern = re.compile(
        r'[\U0001F300-\U0001F9FF\u2600-\u26FF\u2700-\u27BF'
        r'\u00A9\u00AE\u2122\u2139\u3030\u303D\u3297\u3299]+'
    )

    for match in symbol_pattern.finditer(text):
        symbol = match.group()
        placeholder = f"__SYMBOL_{placeholder_counter}__"
        originals[placeholder] = symbol
        masked_text = masked_text.replace(symbol, placeholder, 1)
        placeholder_counter += 1

    return masked_text, originals

def unmask_symbols(text: str, originals: dict[str, str]) -> str:
    """Restore original symbols after translation."""
    for placeholder, original in originals.items():
        text = text.replace(placeholder, original)
    return text
Tjänsten använder en sofistikerad flerstegsrörledning för att hantera rörig riktig text:
# Before translation:
text = "Hello! 👋 Check out this cool feature 🚀"

# Mask symbols:
masked, originals = mask_symbols(text)
# masked = "Hello! __SYMBOL_0__ Check out this cool feature __SYMBOL_1__"
# originals = {"__SYMBOL_0__": "👋", "__SYMBOL_1__": "🚀"}

# Translate the masked text:
translated = translate(masked, "de")  # → "Hallo! __SYMBOL_0__ Schau dir diese coole Funktion an __SYMBOL_1__"

# Unmask symbols:
final = unmask_symbols(translated, originals)
# final = "Hallo! 👋 Schau dir diese coole Funktion an 🚀"
Maskerad: "Hej, det här är världen"
- **Källa: "Hej världen"**Dålig översättning: "Hola mundo!!!!!!"
- Rengörs: "Hola mundo" # Tar bort !!!! loopDetta säkerställer följande:
👋Modeller kvävs inte av enorma ingångar__SYMBOL_0__Vi kan batch effektivt - Sammanhanget bevaras inom rimliga gränserModell Caching och minneshantering
LRU-cachen är smart om GPU-minnet:
Därför är detta viktigt:
# src/utils/text_processing.py
def chunk_sentences(sentences: list[str], max_chars: int = 900) -> list[list[str]]:
    """Group sentences into chunks that fit within model's max input length."""

    chunks = []
    current_chunk = []
    current_length = 0

    for sentence in sentences:
        sentence_len = len(sentence)

        # If this sentence alone is too long, it goes in its own chunk
        if sentence_len > max_chars:
            if current_chunk:
                chunks.append(current_chunk)
                current_chunk = []
                current_length = 0
            chunks.append([sentence])
            continue

        # If adding this sentence exceeds limit, start new chunk
        if current_length + sentence_len + 1 > max_chars:
            chunks.append(current_chunk)
            current_chunk = [sentence]
            current_length = sentence_len
        else:
            current_chunk.append(sentence)
            current_length += sentence_len + 1  # +1 for space

    # Don't forget the last chunk!
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def split_sentences(text: str, max_sentence_chars: int = 500) -> list[str]:
    """Split text into sentences, enforcing max length."""

    # Split on common sentence terminators
    sentences = re.split(r'([.!?…]+\s+)', text)

    result = []
    for sentence in sentences:
        if not sentence or sentence.isspace():
            continue

        # If sentence is too long, split on word boundaries
        if len(sentence) > max_sentence_chars:
            words = sentence.split()
            current = []
            current_len = 0

            for word in words:
                if current_len + len(word) + 1 > max_sentence_chars:
                    result.append(' '.join(current))
                    current = [word]
                    current_len = len(word)
                else:
                    current.append(word)
                    current_len += len(word) + 1

            if current:
                result.append(' '.join(current))
        else:
            result.append(sentence.strip())

    return result
GPU-minnet är värdefullt
- Översättningsmodellerna är 300-500MB varderaLastmodellerna är långsamma (1-3 sekunder)
.!?…Vi håller de 6 senaste modellerna heta - Gamla modeller vräks automatisktKöa och mottryck
- **Istället för att krascha under belastning, tjänsten köer begäran:**Uppskattningen är smart:
- Översättning av Pivot FallbackAlla språkpar har inte direkt modeller på Hugging Face.
Lösning?
Pivot genom engelska:
# src/services/model_discovery.py
import httpx
from datetime import datetime, timedelta

class ModelDiscoveryService:
    """Discovers available translation models with 1-hour cache."""

    def __init__(self):
        self._cache = {}  # Cache results to avoid hammering HuggingFace API
        self._cache_ttl = timedelta(hours=1)
        self._hf_api_base = "https://huggingface.co/api/models"

    async def discover_opus_mt_pairs(self, force_refresh: bool = False):
        """Query HuggingFace for all Helsinki-NLP Opus-MT models."""

        cache_key = "opus-mt"

        # Check cache first
        if not force_refresh and cache_key in self._cache:
            cached_data, cached_time = self._cache[cache_key]
            if datetime.now() - cached_time < self._cache_ttl:
                return cached_data  # Cache hit!

        # Cache miss - query HuggingFace API
        async with httpx.AsyncClient() as client:
            response = await client.get(
                self._hf_api_base,
                params={
                    "author": "Helsinki-NLP",
                    "search": "opus-mt",
                    "limit": 1000
                },
                timeout=30.0
            )
            models = response.json()

        # Extract language pairs from model names
        # Example: "Helsinki-NLP/opus-mt-en-de" → ("en", "de")
        pairs = []
        for model in models:
            model_id = model.get("modelId", "")
            if model_id.startswith("Helsinki-NLP/opus-mt-"):
                # Extract the language codes after "opus-mt-"
                lang_part = model_id.replace("Helsinki-NLP/opus-mt-", "")
                if "-" in lang_part:
                    src, tgt = lang_part.split("-", 1)
                    pairs.append({"source": src, "target": tgt})

        # Cache the results
        self._cache[cache_key] = (pairs, datetime.now())

        return pairs
Detta dubblar latens men säkerställer täckning för alla språkpar som stöds.
- Kod djupdykning: Coola funktioner förklaras (
httpxLåt oss utforska några av de mest intressanta delarna av kodbasen! - **Detta är verkliga produktionsmönster som gör tjänsten robust och effektiv.**Varje snippet innehåller förklaringar lämpliga för icke-Python utvecklare.
- **1. Vad är det som händer?**Smart LRU-cache med GPU-minneshantering
enEn av de coolaste funktionerna är den intelligenta modellen cache som vet hur man hanterar GPU minne:deVad händer här?Helsinki-NLP/opus-mt-en-de - : Som ett vanligt lexikon, men minns att beställningsobjekten har lagts tillLRU (minst nyligen använd)
: När cachen är full, sparka ut modellen som inte har använts på längst tid
Upprensning av GPU
# src/core/device.py
import torch

class DeviceManager:
    """Smart device selection with GPU auto-detection."""

    def __init__(self):
        self.use_gpu = self._should_use_gpu()
        self.device_index = self._resolve_device()
        self.device_str = "cpu" if self.device_index < 0 else f"cuda:{self.device_index}"

        # Auto-configure parallel translation slots based on device
        if self.device_index >= 0:
            # GPU: Run translations serially to avoid VRAM fragmentation
            self.max_inflight = 1
        else:
            # CPU: Can handle multiple translations in parallel
            self.max_inflight = config.MAX_WORKERS_BACKEND

        self._log_device_info()

    def _should_use_gpu(self) -> bool:
        """Check if GPU should be used."""
        if config.USE_GPU.lower() == "false":
            return False
        if config.USE_GPU.lower() == "true":
            return torch.cuda.is_available()
        # "auto" mode: use GPU if available
        return torch.cuda.is_available()

    def _resolve_device(self) -> int:
        """Returns device index: -1 for CPU, 0+ for CUDA."""
        if not self.use_gpu:
            return -1

        # Check if specific CUDA device requested
        if config.DEVICE and config.DEVICE.startswith("cuda:"):
            device_num = int(config.DEVICE.split(":")[1])
            return device_num

        return 0  # Use first GPU

    def _log_device_info(self):
        """Log device information at startup."""
        if self.device_index >= 0:
            gpu_name = torch.cuda.get_device_name(self.device_index)
            vram_gb = torch.cuda.get_device_properties(self.device_index).total_memory / 1e9
            logger.info(f"Using GPU: {gpu_name} ({vram_gb:.1f}GB VRAM)")
            logger.info(f"Max inflight translations: {self.max_inflight} (GPU mode)")
        else:
            cpu_count = os.cpu_count()
            logger.info(f"Using CPU ({cpu_count} cores)")
            logger.info(f"Max inflight translations: {self.max_inflight} (CPU mode)")

# Global singleton instance
device_manager = DeviceManager()
: När vi vräker en modell flyttar vi den uttryckligen till CPU-minnet och säger till GPU att släppa sina resurser
- Varför det är viktigt: Utan detta skulle GPU-minnet fyllas upp och krascha efter att ha laddat 2-3 modeller!
- **Två.**Automatisk modell familj fall tillbaka
max_inflight=1Denna smarta funktion försöker flera AI-modellleverantörer automatiskt om den första inte har det språkpar du behöver:max_inflight=4Vad händer här? - Ryggkedja: Om Opus-MT inte har ukrainska→Franska, prova automatiskt mBART50, sedan M2M100
DEVICE=cuda:1 - Ingen manuell åtgärd: Användare bara begära en översättning och få den bästa tillgängliga modellen
- Felhantering: Om alla familjer misslyckas, vi kasta ett tydligt fel med den senaste misslyckande skäl
Smart cachelagring
: Framgångsrika modeller är cachad med språkpar nyckel
# Snippet from QueueManager showing EMA calculation
def update_avg_duration(self, new_duration: float):
    """Update average duration using exponential moving average."""

    # EMA formula: new_avg = α × new_value + (1 - α) × old_avg
    # α = smoothing factor (0.0 to 1.0)
    #   - Higher α = more weight to recent values (faster adaptation)
    #   - Lower α = more weight to historical values (more stable)

    alpha = 0.2  # 20% weight to new value, 80% to historical

    self.avg_duration_sec = (
        alpha * new_duration +
        (1 - alpha) * self.avg_duration_sec
    )
3. Vad är det som händer?
# Initial average: 5.0 seconds
# New request takes: 10.0 seconds

# EMA calculation:
new_avg = 0.2 * 10.0 + 0.8 * 5.0
        = 2.0 + 4.0
        = 6.0 seconds

# Next request takes: 3.0 seconds
new_avg = 0.2 * 3.0 + 0.8 * 6.0
        = 0.6 + 4.8
        = 5.4 seconds
Begär kö med mottryck (HTTP 429)
- **Produktionsgrad kö som förhindrar server kraschar under tung belastning:**Vad händer här?
- Symptom på semaforer: Som en dörrvakt på en klubb - bara släpper in N människor på en gång (N =
- Sammanhangshanterare): Spårar automatiskt mätvärden och städar upp
- Smarta försök efter: Säger till kunderna "kom tillbaka om 25 sekunder" baserat på ködjup och genomsnittlig begäran tid
Retry-AfterExponentiellt glidande medelvärde
: Jämnar ut spikar i begäran varaktighet
- Varför det är viktigt: Under tung belastning, returnerar HTTP 429 istället för att krascha eller köa oändligt
- **Fyra.**Symbolmaskering magi
- **Bevarar specialtecken (emojis, symboler) som översättningsmodeller kan förstöra:**Exempel på användning:
- **Vad händer här?**Regex- mönster
- : Matchar emoji och specialsymbol Unicode intervallSystem för platshållare
- : Bytedär
tillfälligt
Varför det är viktigt
: Översättningsmodeller ibland korrupta eller ta bort emojis - detta bevarar dem perfekt!
För att uppnå detta mål har kommissionen beslutat att inleda ett förfarande enligt artikel 108.2 i fördraget om Europeiska unionens funktionssätt (nedan kallat EUF-fördraget).
# Prefer GPU if available (default)
USE_GPU=auto

# Force GPU
USE_GPU=true

# Force CPU
USE_GPU=false

# Explicit device override
DEVICE=cuda:0
DEVICE=cpu
Intelligent textknäppning
# Model family selection (NEW in v2.0!)
MODEL_FAMILY=opus-mt   # Best quality (default)
MODEL_FAMILY=mbart50   # 50 languages, single model
MODEL_FAMILY=m2m100    # 100 languages, maximum coverage

# Auto-fallback between model families (NEW in v2.0!)
AUTO_MODEL_FALLBACK=1  # Enabled by default
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"  # Priority order

# Volume-mapped model cache (NEW in v2.0!)
MODEL_CACHE_DIR=/models  # Persistent cache directory

# Model arguments passed to transformers.pipeline
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
EASYNMT_MODEL_ARGS='{"torch_dtype":"bf16","cache_dir":"/models"}'

# Preload models at startup (reduces first-request latency)
PRELOAD_MODELS="en->de,de->en,fr->en"

# LRU cache capacity
MAX_CACHED_MODELS=6
Bryter långa texter i bitar som passar modellgränser samtidigt som meningsgränser bevaras:
**Vad händer här?**Skadeståndsskillnad
opus-mt: Använder regex för att dela påmbart50med bibehållen interpunktionm2m100Glädjande bitning
: Packar så många meningar som möjligt i varje bit utan att överskrida gränsenSpridning av ordgräns
1: Om en enda mening är för lång, delas på mellanslag istället för att klippa mittord0Varför det är viktigt
**: Översättningsmodeller har inmatningsgränser (vanligtvis 512-1024 polletter).**Detta säkerställer att vi aldrig överskrider dem samtidigt som sammanhanget förblir intakt.
-
- Vad är det som händer?
"opus-mt,mbart50,m2m100"Async modell Upptäckt med Caching
- Vad är det som händer?
- Dynamiskt upptäcker tillgängliga översättningsmodeller från HuggingFace:
"m2m100,mbart50,opus-mt"Vad händer här?
-
Async HTTP- klientName): Gör icke-blockerande HTTP-förfrågningar till HuggingFace
- Tidsbaserad cachelagring
/models: Lagrar resultat för 1 timme för att undvika hastighetsbegränsning-v ./model-cache:/models - Förlaga till tolkning
- : Extrakt
- Tidsbaserad cachelagring
och
fp16frånbf16Varför det är viktigtfp32: HuggingFace har 1200+ Opus-MT modeller.
Att fråga dem alla tar 10 sekunder.
# Batch size for translation (higher = faster but more VRAM)
EASYNMT_BATCH_SIZE=16  # CPU: 8-16, GPU: 32-64

# Maximum text length per item
EASYNMT_MAX_TEXT_LEN=1000

# Maximum beam size (higher = better quality but slower)
EASYNMT_MAX_BEAM_SIZE=5

# Worker thread pools
MAX_WORKERS_BACKEND=1    # Translation workers
MAX_WORKERS_FRONTEND=2   # Language detection workers
Caching gör det omedelbart!
# Enable request queueing (highly recommended)
ENABLE_QUEUE=1

# Max concurrent translations
# Auto: 1 on GPU, MAX_WORKERS_BACKEND on CPU
MAX_INFLIGHT_TRANSLATIONS=1

# Max queued requests before 429
MAX_QUEUE_SIZE=1000

# Per-request timeout (0 = disabled)
TRANSLATE_TIMEOUT_SEC=180

# Retry-After estimation
RETRY_AFTER_MIN_SEC=1      # Floor
RETRY_AFTER_MAX_SEC=120    # Ceiling
RETRY_AFTER_ALPHA=0.2      # EMA smoothing factor
7. Vad är det som händer?
# Enable input filtering
INPUT_SANITIZE=1

# Minimum alphanumeric ratio (0.2 = 20%)
INPUT_MIN_ALNUM_RATIO=0.2

# Minimum character count
INPUT_MIN_CHARS=1

# Language code for undetermined/noise
UNDETERMINED_LANG_CODE=und
Automatisk upptäckt av enheten
# Default sentence splitting behavior
PERFORM_SENTENCE_SPLITTING_DEFAULT=1

# Max chars per sentence before word-boundary split
MAX_SENTENCE_CHARS=500

# Max chars per chunk for batching
MAX_CHUNK_CHARS=900

# Sentence joiner
JOIN_SENTENCES_WITH=" "
Avkänner och använder automatiskt GPU om tillgängligt:
# Enable symbol masking
SYMBOL_MASKING=1

# What to mask
MASK_DIGITS=1    # Mask 0-9
MASK_PUNCT=1     # Mask .,!? etc.
MASK_EMOJI=1     # Mask 😀🎉 etc.
Vad händer här?
# Align response array length to input
ALIGN_RESPONSES=1

# Placeholder for failed items (when aligned)
SANITIZE_PLACEHOLDER=""

# Response format
EASYNMT_RESPONSE_MODE=strings    # ["translation1", "translation2"]
EASYNMT_RESPONSE_MODE=objects    # [{"text":"translation1"}, ...]
GPU-detektion
# Enable two-hop translation via pivot
PIVOT_FALLBACK=1

# Pivot language (usually English)
PIVOT_LANG=en
: Använder PyTorch för att kontrollera om CUDA är tillgängligt
# Log level
LOG_LEVEL=INFO

# Per-request logging (verbose)
REQUEST_LOG=1

# Format
LOG_FORMAT=plain    # Human-readable
LOG_FORMAT=json     # Structured JSON

# File logging with rotation
LOG_TO_FILE=1
LOG_FILE_PATH=/var/log/marian-translator/app.log
LOG_FILE_MAX_BYTES=10485760    # 10MB
LOG_FILE_BACKUP_COUNT=5

# Include raw text in logs (privacy risk!)
LOG_INCLUDE_TEXT=0
Automatisk inställning
# Periodically clear CUDA cache (seconds, 0=disabled)
CUDA_CACHE_CLEAR_INTERVAL_SEC=0
: Ställningar
# Worker count (use 1 for single GPU)
WEB_CONCURRENCY=1

# Request timeout
TIMEOUT=60

# Graceful shutdown timeout
GRACEFUL_TIMEOUT=20

# Keep-alive timeout
KEEP_ALIVE=5
om GPU (undvik VRAM-fragmentering)
På processorn (maximera parallellism)
# GET request
curl "http://localhost:8000/translate?target_lang=de&text=Hello%20world&source_lang=en"

# Response
{
  "translations": ["Hallo Welt"]
}
Enhetsval
# POST request
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": [
      "Hello world",
      "This is a test",
      "Machine translation is amazing"
    ],
    "target_lang": "de",
    "source_lang": "en",
    "beam_size": 1,
    "perform_sentence_splitting": true
  }'

# Response
{
  "target_lang": "de",
  "source_lang": "en",
  "translated": [
    "Hallo Welt",
    "Das ist ein Test",
    "Maschinenübersetzung ist erstaunlich"
  ],
  "translation_time": 0.342
}
: Kan rikta specifika GPU med
# Omit source_lang for auto-detection
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": ["Bonjour le monde"],
    "target_lang": "en"
  }'

# Response
{
  "target_lang": "en",
  "source_lang": "fr",  # Detected
  "translated": ["Hello world"],
  "translation_time": 0.156
}
Loggning
# GET
curl "http://localhost:8000/language_detection?text=Hola%20mundo"
# {"language": "es"}

# POST with batch
curl -X POST http://localhost:8000/language_detection \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello", "Bonjour", "Hola"]}'
# {"languages": ["en", "fr", "es"]}
: Visar GPU-namn och VRAM vid start för felsökning
# Health check
curl http://localhost:8000/healthz
# {"status": "ok"}

# Readiness
curl http://localhost:8000/readyz
# {
#   "status": "ready",
#   "device": "cuda:0",
#   "queue_enabled": true,
#   "max_inflight": 1
# }

# Cache status
curl http://localhost:8000/cache
# {
#   "capacity": 6,
#   "size": 3,
#   "keys": ["en->de", "de->en", "fr->en"],
#   "device": "cuda:0",
#   "inflight": 1,
#   "queue_enabled": true
# }

# Model info
curl http://localhost:8000/model_name | jq
Mönster för enkelton
# When queue is full, you get 429
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["test"], "target_lang": "de"}'

# Response: 429 Too Many Requests
# Headers: Retry-After: 45
# Body:
{
  "message": "Too many requests; queue full",
  "retry_after_sec": 45
}

# Proper client behavior:
# 1. Read Retry-After header
# 2. Wait that long + jitter
# 3. Retry request
: En instans som delas över hela ansökan
- Vad är det som händer?
Exponentiell glidande medelvärde för försök-efter
Jämna försök efter uppskattning som anpassar sig till den faktiska begärans varaktighet:
Exempel:
.\build-all.ps1
Vad händer här?
chmod +x build-all.sh
./build-all.sh
EMA (Exponentiellt glidande medelvärde)
: Som ett vägt genomsnitt som ger större vikt åt de senaste värdenaUtjämningsfaktor (α):
- : Kontrollerar hur snabbt vi anpassar oss till förändringar (
latest,min,gpu,gpu-minVarför inte ett simpelt genomsnitt? - : EMA anpassar sig snabbare till förändringar och filtrerar ut spikarVarför det är viktigt
20250108.143022: Ger kunderna realistiska
tider som anpassar sig till nuvarande systembelastning
# Always get the latest version
docker pull scottgal/mostlylucid-nmt:cpu
# Or use the :latest alias
docker pull scottgal/mostlylucid-nmt:latest

# Pin to a specific version for reproducibility
docker pull scottgal/mostlylucid-nmt:cpu-20250108.143022
docker pull scottgal/mostlylucid-nmt:cpu-min-20250108.143022
Dessa kodmönster visar på pythonmetoder av produktionskvalitet:
Resursförvaltning
- : Explicit GPU minne rensningNådfull förnedring
- : Automatisk reserv mellan modellleverantörerMottryckshantering
- : Kö + HTTP 429 istället för krascherDataintegritet
- : Symbol maskering bevarar specialteckenPrestandaoptimering
: Smart cachelagring, kapning och parallell bearbetning
docker inspect scottgal/mostlylucid-nmt:cpu | jq '.[0].Config.Labels'
Observationsförmåga: Detaljerad loggning och mätning spårning.
Var och en av dessa funktioner löser ett verkligt produktionsproblem som skulle orsaka krascher, fel, eller dålig användarupplevelse utan dem!
Inställningsguide
# Using pre-built image from Docker Hub (recommended)
docker run -d \
  --name translator \
  -p 8000:8000 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=500 \
  -e EASYNMT_BATCH_SIZE=16 \
  -e TIMEOUT=180 \
  -e LOG_LEVEL=INFO \
  -e REQUEST_LOG=0 \
  scottgal/mostlylucid-nmt

# Or build locally
docker build -t mostlylucid-nmt .
docker run -d --name translator -p 8000:8000 mostlylucid-nmt

# Check logs
docker logs -f translator
Tjänsten är mycket konfigurerbar via miljövariabler.
# Using pre-built GPU image from Docker Hub (recommended)
docker run -d \
  --name translator-gpu \
  --gpus all \
  -p 8000:8000 \
  -e USE_GPU=true \
  -e DEVICE=cuda:0 \
  -e PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en" \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  -e EASYNMT_BATCH_SIZE=64 \
  -e MAX_CACHED_MODELS=8 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=2000 \
  -e WEB_CONCURRENCY=1 \
  -e TIMEOUT=180 \
  -e GRACEFUL_TIMEOUT=30 \
  -e LOG_FORMAT=json \
  -e LOG_TO_FILE=1 \
  -v /var/log/translator:/var/log/marian-translator \
  scottgal/mostlylucid-nmt:gpu

# Or build locally
docker build -f Dockerfile.gpu -t mostlylucid-nmt:gpu .
docker run -d --name translator-gpu --gpus all -p 8000:8000 mostlylucid-nmt:gpu

# Monitor cache and performance
watch -n 5 "curl -s http://localhost:8000/cache | jq"
Här är hela guiden:
version: '3.8'

services:
  translator:
    image: scottgal/mostlylucid-nmt:gpu  # Use pre-built image
    container_name: translator
    restart: unless-stopped

    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]

    ports:
      - "8000:8000"

    environment:
      USE_GPU: "true"
      DEVICE: "cuda:0"
      PRELOAD_MODELS: "en->de,de->en,en->fr,fr->en"
      EASYNMT_MODEL_ARGS: '{"torch_dtype":"fp16"}'
      EASYNMT_BATCH_SIZE: "64"
      MAX_CACHED_MODELS: "8"
      ENABLE_QUEUE: "1"
      MAX_QUEUE_SIZE: "2000"
      WEB_CONCURRENCY: "1"
      TIMEOUT: "180"
      LOG_FORMAT: "json"
      LOG_TO_FILE: "1"

    volumes:
      - translator-logs:/var/log/marian-translator
      - translator-cache:/root/.cache/huggingface

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/healthz"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s

volumes:
  translator-logs:
  translator-cache:
Enhetsval
apiVersion: apps/v1
kind: Deployment
metadata:
  name: translator
spec:
  replicas: 2  # Scale horizontally for CPU, use 1 per GPU
  selector:
    matchLabels:
      app: translator
  template:
    metadata:
      labels:
        app: translator
    spec:
      containers:
      - name: translator
        image: scottgal/mostlylucid-nmt:gpu
        ports:
        - containerPort: 8000
        env:
        - name: USE_GPU
          value: "true"
        - name: EASYNMT_MODEL_ARGS
          value: '{"torch_dtype":"fp16"}'
        - name: PRELOAD_MODELS
          value: "en->de,de->en"
        - name: ENABLE_QUEUE
          value: "1"
        - name: MAX_QUEUE_SIZE
          value: "2000"

        resources:
          requests:
            memory: "4Gi"
            cpu: "2"
            nvidia.com/gpu: 1
          limits:
            memory: "8Gi"
            cpu: "4"
            nvidia.com/gpu: 1

        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10

        readinessProbe:
          httpGet:
            path: /readyz
            port: 8000
          initialDelaySeconds: 20
          periodSeconds: 5

---
apiVersion: v1
kind: Service
metadata:
  name: translator
spec:
  selector:
    app: translator
  ports:
  - port: 80
    targetPort: 8000
  type: LoadBalancer
Modellinställning
Ny inställning förklarade:
FÖRLAGA_FAMILJ
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'- : Välj vilken modellfamilj som ska användas som primär
- : Bästa kvalitet, 1200+ par, separata modeller
- : Bra kvalitet, 50 språk, enkel 2,4 GB modell
: Bra kvalitet, 100 språk, enkel 2.2GB modell
# Start high, reduce if you get OOM
EASYNMT_BATCH_SIZE=64  # Try 128 on large GPUs
AUTO_MODEL_FALLBACK
PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en": Prova automatiskt andra familjer om par inte finns tillgängliga
WEB_CONCURRENCY=1
MAX_INFLIGHT_TRANSLATIONS=1
(förval): Aktiverad - maximal täckning
MAX_CACHED_MODELS=10 # Keep more models in VRAM: Handikappad - strikt enfamiljsläge
# beam_size=1 is 3-5x faster than beam_size=5
# Quality difference is often minimal
curl -X POST ... -d '{"beam_size": 1, ...}'
FÖRLAGA_FALLBACK_ORDER
: Prioriterad ordning för reserv
EASYNMT_BATCH_SIZE=8Förval:
MAX_WORKERS_BACKEND=4
MAX_INFLIGHT_TRANSLATIONS=4
WEB_CONCURRENCY=2
(första kvalitet)
PERFORM_SENTENCE_SPLITTING_DEFAULT=0
Alternativt:
(omslag först)
// Bad: 100 separate requests
for (const text of texts) {
  await translate(text);
}

// Good: 1 batch request
await translate(texts);
FÖRLAGA_CACHE_DIR
async function translateWithRetry(texts) {
  try {
    return await translate(texts);
  } catch (err) {
    if (err.status === 429) {
      const retryAfter = err.headers['retry-after'];
      const jitter = Math.random() * 5;
      await sleep((retryAfter + jitter) * 1000);
      return translateWithRetry(texts);
    }
    throw err;
  }
}
: Ihållande modelllagring via Docker-volymer
// Reuse HTTP connections
const agent = new https.Agent({ keepAlive: true });
Ställ in till
// Bad: mixed language pairs in one request
translate([
  { text: "Hello", sourceLang: "en", targetLang: "de" },
  { text: "Bonjour", sourceLang: "fr", targetLang: "de" }
]);

// Good: group by language pair
translateBatch(enToDe, "en", "de");
translateBatch(frToDe, "fr", "de");
och kartvolym:
Modeller finns kvar över hela behållarens omstarter
- Delad cache mellan flera behållareAlternativ för torch_dtyp:
- (flytande16): 2x snabbare på GPU, halva minnet, försumbar kvalitetsförlust(float16): Bättre numerisk stabilitet än fp16, kräver moderna GPU:er
- (flytande32): Full precision, långsammast men mest exaktÖversättningsinställningar
- Köa & prestandaInsatssanering
- DomsprövningSymbolmaskering
- SvarsbeteendeBivotnedslag
- LoggningSkötsel
Gunhörn (Docker)
Exempel på användning
translation_requests_total{lang_pair="en->de",status="success"} 1523
translation_requests_total{lang_pair="en->de",status="error"} 7
translation_duration_seconds{lang_pair="en->de",quantile="0.5"} 0.342
translation_duration_seconds{lang_pair="en->de",quantile="0.95"} 1.234
translation_queue_depth 23
translation_cache_size 6
translation_cache_hits_total 8234
translation_cache_misses_total 142
Grundläggande översättning
# Enable JSON logging
LOG_FORMAT=json REQUEST_LOG=1

# Output example
{
  "ts": "2025-01-08T15:30:45+0000",
  "level": "INFO",
  "name": "app",
  "message": "translate_post done items=5 dt=0.342s",
  "req_id": "a3d2f5b1-c4e6-4f7a-9d8c-1e2f3a4b5c6d",
  "endpoint": "/translate",
  "src": "en",
  "tgt": "de",
  "items": 5,
  "duration_ms": 342
}
Batchöversättning (rekommenderas)
Påvisande av automatiskt språk
Endast påvisande av språk |---------|---------|-----------------| | Slutpunkter för observerbarhetHantering av mottryck | Byggande och versionshanteringAlla Docker bilder inkluderar nu korrekt version och metadata för spårning. | Snabbt byggaBygg alla 4 varianter med automatisk datumversion: | **Fönster:**Linux/Mac: | VersionsstrategiVarje bygge skapar | två taggarNamngiven etikett | ) - alltid pekar på den senasteVersionsetikett | (t.ex.) - oföränderlig ögonblicksbild | **Exempel:**OCI- etiketter | **Varje bild innehåller metadata:**Ansökan ska innehålla följande uppgifter: | **: Bygg tidsstämpel (ÅÅÅÅMMDD.HHMMSS)**Byggdatum | : ISO 8601 tidsstämpelGit- åtagande
: Kort SHA
Variant Ordförande
: cpu-full, cpu-min, gpu-full eller gpu-minInspektera etiketterna:
För detaljerade bygginstruktioner och CI/CD-integration, se
- BUILD.M.D.
MAX_QUEUE_SIZE - Utplacering
- Utplacering av processorn
MAX_INFLIGHT_TRANSLATIONSGPU-utplacering - Docker komposera
Utplacering av Kubernetes
Optimering av prestandaChecklista för GPU-optimering
Använd FP16 precision
- 2x snabbare slutsats
ENABLE_QUEUE=1 - Hälften av VRAM-användningen
Försumbar kvalitetsförlust för översättning
Ton tillverkningssats storlekFörladda heta modeller
Ensamstående arbetstagare per GPU
- Öka cachestorleken
EASYNMT_BATCH_SIZE - Lägre strålstorlek för genomströmning
MAX_CACHED_MODELS - Checklista för processoroptimering
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' - Lägre satsstorlek
WEB_CONCURRENCY=1Öka parallellismenMAX_INFLIGHT_TRANSLATIONS=1
Inaktivera meningsdelning för korta texter
Kundens bästa metoderBegäran om tillverkningssats
Respektera försök efter
PRELOAD_MODELS="en->de,de->en"
Använd anslutningspoolning
Gruppera efter språkpar Helsinki-NLP/opus-mt-{src}-{tgt}Övervakning och observerbarhet
Nyckelmått att spåra
- Översättningsgenomgång
PIVOT_FALLBACK=1(begäran/sekund) - Genomsnittlig latens
curl http://localhost:8000/lang_pairs
(p50, p95, p99)
Ködjup(nuvarande vänteräkning)
Cache träfffrekvens
- (% av förfrågningar som träffar cache)
MASK_EMOJI=0FelfrekvensMASK_PUNCT=0 - (5xx svar)
SYMBOL_MASKING=0
Användning av GPU
(om tillämpligt)
public class MostlyLucidNmtClient
{
    private readonly HttpClient _httpClient;
    private readonly string _baseUrl;

    public MostlyLucidNmtClient(HttpClient httpClient, string baseUrl)
    {
        _httpClient = httpClient;
        _baseUrl = baseUrl;
    }

    public async Task<TranslationResponse> TranslateAsync(
        List<string> texts,
        string targetLang,
        string sourceLang = "",
        int beamSize = 1,
        bool performSentenceSplitting = true,
        CancellationToken cancellationToken = default)
    {
        var request = new TranslationRequest
        {
            Text = texts,
            TargetLang = targetLang,
            SourceLang = sourceLang,
            BeamSize = beamSize,
            PerformSentenceSplitting = performSentenceSplitting
        };

        var response = await _httpClient.PostAsJsonAsync(
            $"{_baseUrl}/translate",
            request,
            cancellationToken);

        if (response.StatusCode == System.Net.HttpStatusCode.TooManyRequests)
        {
            // Read Retry-After header
            var retryAfter = response.Headers.RetryAfter?.Delta?.TotalSeconds ?? 30;
            var jitter = Random.Shared.Next(0, 5);
            await Task.Delay(TimeSpan.FromSeconds(retryAfter + jitter), cancellationToken);

            // Retry
            return await TranslateAsync(texts, targetLang, sourceLang, beamSize,
                performSentenceSplitting, cancellationToken);
        }

        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<TranslationResponse>(cancellationToken);
    }
}

public class TranslationRequest
{
    [JsonPropertyName("text")]
    public List<string> Text { get; set; }

    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("beam_size")]
    public int BeamSize { get; set; }

    [JsonPropertyName("perform_sentence_splitting")]
    public bool PerformSentenceSplitting { get; set; }
}

public class TranslationResponse
{
    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("translated")]
    public List<string> Translated { get; set; }

    [JsonPropertyName("translation_time")]
    public double TranslationTime { get; set; }
}
Minnesanvändning
services.AddHttpClient<MostlyLucidNmtClient>(client =>
{
    client.BaseAddress = new Uri("http://translator:8000");
    client.Timeout = TimeSpan.FromMinutes(3);
});
(VRAM för GPU, RAM för CPU)
Exempel Prometheus Metrics**Om du integrerar Prometheus (inte inbyggd, men enkel att lägga till):**Exempel på strukturerad loggning
Du kan skicka detta till Elasticsearch, CloudWatch, eller någon loggsamlare.
Jämförelse: EasyNMT vs MostlyLucid-NMT
- på funktionen på EasyNMT på MestadelsLucid-NMT
- Stabilitet
- på Crashes ofta med produktion-ready, graciös felhantering
Hantering av inmatning
- Misslyckades med emoji/symbols med Robust sanitisering + symbolmaskering
- Mottryck
- Ingen, OMS under belastning på Semaphore + kö med försök efter
Observationsförmåga
- med minimala resultatmått för hälsa/ready/cache, strukturerade loggar
- Stöd för GPU
- Stöd inom ramen för FP16/BF16
- Förlaga till förlaga
Manuell, ingen cachning, LRU-cache med auto-eviction
- Rättsskipning
- på grund av att man delar upp en smart buckling + batching
- Pivotöversättning
- Automatisk reserv via engelska
- Förtjusande avstängning
Med timeout, ja, med timeout
InställningFör finjustering: 40 + env vars för finjusteringAPI-kompatibilitet
på EasyNMT endpoints på 100% kompatibel + förlängningar
- Kod KvalitetObibehållen, monolitisk, modulär, typad, testad
- Felsökning429 För många förfrågningar
- **Orsak:**Kö är full.
- **Lösning:**Ökning
- **Lägg till fler kopior (horisontell skalning)**Ökning
- **(om du har huvudutrymme)**Minska batchstorlekar från kunder
- 503 Otillgänglig tjänstOrsak:
- **Köa inaktiverade och alla slots upptagna.**Lösning:
Aktivera köning:
# Maximum coverage with auto-fallback (recommended!)
docker run -d -p 8000:8000 \
  -v ./model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  -e AUTO_MODEL_FALLBACK=1 \
  -e MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100" \
  scottgal/mostlylucid-nmt:cpu-min

# GPU with best quality
docker run -d --gpus all -p 8000:8000 \
  -e USE_GPU=true \
  -e MODEL_FAMILY=opus-mt \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu

# Test it
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello world"], "target_lang": "de"}'
Höj gränsen för inflygning om du har resurser
OOM (ut ur minnet) på GPU
Orsak:
Batch storlek för hög eller för många modeller cachad.
Lösning:
och
Långsam första begäran[Orsak:
Modellen är inte förladdad.
Translation NMT Neural Machine Translation Python FastAPI Docker CUDA PyTorch Transformers Helsinki-NLP Production Microservices API