
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Intelligens som en disciplinerad mjukvara
Wednesday, 19 November 2025
Utveckling av AI Workflows och drivkraften till enkelhet
Att betala mig för att göra detta till ett bra produkt Drop me a line: scott.galloway
Den tanke som startade allt
Varför kör en mänsklig hjärna verklig kognition på Watt, medan våra bästa AI-modeller behöver megawatt bara för att prata om frukost
Moderna LLMs strävar efter att vara som en stor hjärnbark, med 0 ton minne, 1 ton förmåga och 2 ton ensamFör att utföra uppgifter som en människa skulle göra utan ansträngning de kastar kilowatt energi med hjälp av tiotals gigabyte minne. Det kan inte vara rätt om hjärnan arbetar på
Här är vad de saknar stora mängder specialiserade subsystem handling av synen1 rörelse1 minnesmängd2 i lager3 alla koordinerade av den där hjärnbarken4 LLM: n gör inte det5 de gör det6 de är som en stor tankemotor som bildas på en dum infrastruktur8 deras lager anpassar sig inte till ' de skapar inga specialiserade subsystem De ' är ofullständiga.
Jag brukade vara psykolog, så jag tänker på saker som det här.
"Billig kognition stabiliserar komplexa kognitioner
Din hjärna inte räknar ut hur man ska gå varje gång du tar ett steg.. Den avlappar det för att gå snabbt., billig, ,, automatiska subsystem.M SK5 Stabiliteten frigör den dyra prefrontala cortexen för att hantera nya problem.
Elevator Pitch
Tänk om din AI-process insåg att den inte behövde AI och omvandlade sig till ett Python- skript DiSE gör det. Den bygger arbetsflöden som testbara verktyg som lagras i en RAG-skiva . När mönster blir tydliga , den ersätter LLM sändningar med omedelbar Python M SK3 När du behöver fler egenskaper Mska4 den bygger endast det som Mska5 behöver Mske6 förutsägbart M Ska7 testbartMska8 När verktygen driftar, Mska9 utvecklas den bort från problem innan du märker det.. En liten Sentinel-modell, (1, B-param, ), hanterar allt tråkigt hushållsarbete för pennies.Mska13. Ansluta en gränslig LLM på kort tid för att optimera allting.,, sen koppla upp och köra billigt för alltid.Mka15. Det är Mska16, den AI som blir mer effektiv ju längre den kör.Mkka17, vilket är precis hur produktionssystem borde fungera.Mk18
Inleiding
De flesta AI-system idag är byggda som mina första PHP- skript runtomkring.
När de misslyckas kommer att), du märker inte, ' får inte märke tills produktionen sker, ' går i brand, M SK3 När du behöver förbättra dem,
Det finns ett bättre sätt att göra det. . Tänk om varje AI-verktyg var byggt som rätt mjukvara från första dagen.— med tester, , med kontrakt, , med specifikationer och , med ansvarsutkrävande.
Det här är "'", inte vapourware, ., det är ', arbetskoden, ., här är hur AI-tekniken ska fungera när den växer upp.
Tabellen med innehåll
Problemet: AI är fortfarande det vilda västvärlden
Låt mig måla en bild med ett diagram.
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
Låter välbekant.
Vad gör det här annorlunda
Här är det som en genererad AI ser ut i mitt system. Straight från CLI. Inga rök och spegel.
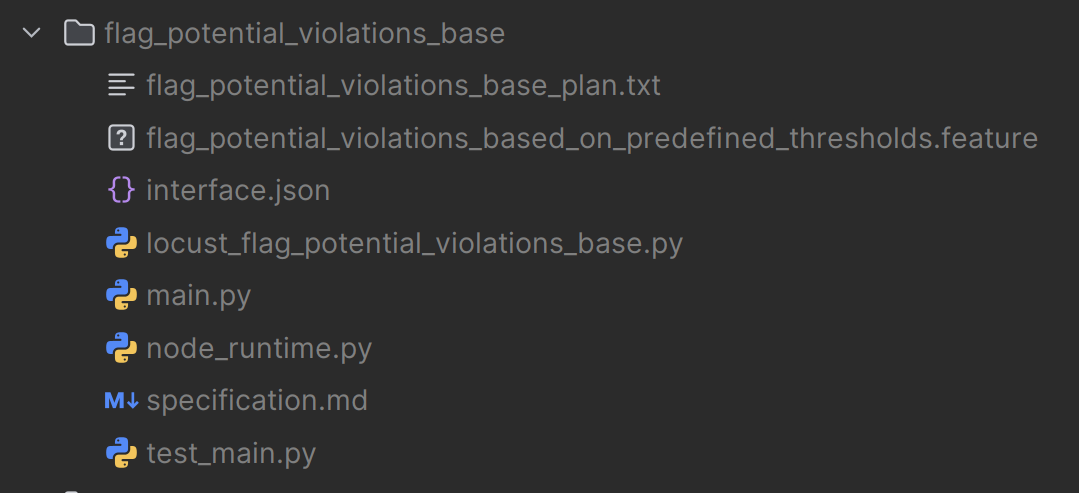
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Den där folderstrukturen, ?, det där, ', är inte en modell jag gjorde i Figma för att imponera er. faktisk genererad utgång. Varenda enda filen . Från AI: n självt
Varje nod är:
| egendom | Meningen | |||
|---|---|---|---|---|
| Testbar | Enhet & BDD-testar existerar från födseln M | |||
| Den är säker | Kan alltid bevisa varför den betedde sig så som den gjorde | |||
| Flygbar | Kan förbättras genom jämförelser med kroppsvikt | |||
| Benchmarkable | PerfM SK2Lådtest incl. | |||
| Återanvändbar | blir en del av arbetsminnet |
Det här är prompt engineering , ".", och "'". AI som disciplinerad mjukvara— den typ du faktiskt kan lita på i produktion utan att kolla Slack varje 5 minut
Och här är det riktigt smarta: de ' är bara Python- skript. Passande, , tråkiga, M SK2 testbara Python- skript, . Men de lever i en RAG-baserad evolutionär substrat där varje verktygsspecifikation blir en del av dess identitet.
Tänk om din AI-driven arbetsström bestämde sig för att den verkligen inte behövde AI Det händer. En arbetsström körs några gånger , mönstret blir tydligt, och systemet inser M SK3 det här är bara datatransformationen , varför ska jag ringa en LLM? INSTANT. Inga API-sändningar , inga tokener , ingen latens M SK3 Ganska tråkigt MST4 snabbt M ST5 förutsägbar Python M st6
Eller kanske behöver du mer. SIE tilldana när det behövs. Systemet bygger bara de nya delarna som verktygen, — may be based on existing ones, , maybe entirely new, — but always predictably, M SK4, always testable, MST5 No over, MSV6 engineering, M ST7, No MST8 just in case, M st9 code, M St10 Just the minimum viable tool to solve the actual problem you're facing right now, Mst12
Upgradera ett verktyg ( i en guidad methode , på ett noggrant testbart sätt | ), | och varje arbetsflöde som använder det gynnar sig omedelbart
Hur det faktiskt fungerar
Här är det som ingen annan gör. team av specialiserade LLM, var och en med noggrantjusterade starterproppar , som jobbar som ett riktigt mjukvaruingenjörsteam
Forges arbetsflöde:
- Speciella fall – " Är detta en vanlig uppgift som vi redan hanterar?
- Taskdekomposition – En ganska bra LLM ( lokalt använder jag en 7 B-modell , inget spektakulärt ♫ ) bryter ner pronstret ♫
- Parallell vs sequentiell planering – Bestäms vad som kan gå parallellt mot sekvens
- Genererar verktygssändningar – utgångar
call_tool("tool_name", prompt)- detta är KID till sammansättningsbarhet - RAG-uppsök – Finns det något " verktyg M SK2 namn " existerar MSC4 Om ja, använder man det MST6 om nej, MST7 blir instruktionen instruktionen till nästa Forge-instance
- Rekursiv dekomposition – Den nästa Forge gör samma nedbrytning , hela vägen ner till små uniter
Detta är genombrottet Uppgifter bryts ner till atomoperationer, som jag lärde mig göra under åratal med att bygga mjukvara. tillräckligt bra för kodskapande när uppgiften är liten och övervakaren ger detaljerade implementeringsinstruktioner
Här är ett verkligt exempel på hur instruktionerna ser ut.
- Exakt algoritm (topologisk sortering + kritiskt spårande metod
- Datastrukturer med typdefinitioner
- Funktionssignaturer med input/utgångsspetsar
- Förvaltningsbegränsningar (O (V+EM SK3 tidMska4 OMske5V~Mska6 utrymmeM Ska7
- säkerhetsgränser (max 1000 uppgifter
- kompletta testfall med förväntade ingångar och utgångar
- JSON-input format
Ett 7B-modell kan skriva solid kod från den specifikationen eftersom det inte är tillfrågat att designa någonting, utan att implementera en detaljerad ritning. Det's varför små modeller fungerar för kodskapande i detta system.
När Forge kör arbetsflödet, så är det ' fortfarande dynamiskt komponierbart via RAG. Om ett nyttM SK3 bättre verktyg dyker upp som passerar samma testerMska4 Det används automatiskt Mska5 Och kommer ihågs nästa gångM Ska6
Låt mig visa er arkitekturen med ett annat diagram.
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
RAG-substansen är den hemliga sausan Varje verktyg – ' – dess specifikation, — - dess kontrakt,, – desse syfte, , – desses passformsnivåer, M SK4 – blir en sökbar identitet. . – När du behöver ett verktyg - , - hittar systemet det bästa matchet. . - När du uppgraderar ett verktyg –, - så får varje arbetsliv som använder det automatiskt förbättringar.
Det är som att ha en självorganiserande verktygslåda som blir smartare över tid.
Problemet med minnet : Stopp att åter lära sig hur man kör
Normala AI använder metoden "Quick study " approach Varje gång de tacklar en uppgift att testa ( fast det är ett annat problem med AI-lösningar lektioner. Föreställ dig att förklara vad en klutt gör varje morgon innan du åker till jobbet.
Moderna CLI-koder har en partiell lösning : titta på ditt projektkatalog för CLAUDE.md, eller en massa märkliga markerdown-docs spridda runtomkringM SK3 De där plierna ? Det är så bra som de kan göra med minnet Mska6 Det Mske7 är som att lämna PostenMska8 Det lägger märke till dig själv M Ska9 förutom att du måste läsa alla dem varje gång innan du gör något
DiSE kommer faktiskt ihåg När den löser ett problem, så lagrar den lösningen som ett testat, dokumenterat verktyg i RAG: s substrat. . Next time, ?, så använder den bara det.., utan att göra något om det.
Detta kopplar direkt till de koncept som jag "'" har babblat på om i min serie Semantic Intelligence .
- Del 8: verktyg hela vägen ner för self-optimiserande verktygslåda
- Del 9: själv -Healing Tools för släktet-medveten evolution
- Del 10: The DiSE Cooker för arbetsflödets sammansättning
Varje nod har redan
- En specifikation ( så ni vet vad det är medvetet att göra)
- Ett kontrakt ( så ni vet vad det är faktiskt gör)
- Runnable code (schockerande , Jag vet)
- Test som måste klara ( inget av det här " vi M SK2 kommer att lägga till tester senare
- Ett lasttest anordning. ( eftersom " det fungerade på min laptop.
- En anledning till existerande ( inga zombiekoder som hackar din kodbas)
Att "'" är substratet som behövs för att skala AI på ett ansvarsfullt sätt , "—, inga fler tokens, ,, inga större modeller, ,, ingen annan blodig ChatGPT-wrapper."
Brejbarheten: verktyg är optionella, LLMs är optionala
Här är det som verkligen spelar roll. verktyg och LLMs är optionella. Systemet skepper med en standard LLM, och det kan göra allt från början, om det måste.
Tänk på verktyg som bibliotekböcker En del är JSON-filer (specialist-instruktioner för resonemang, , kodering, , analys, M SK3 som är självföränderliga och evolutionära. ). Många är Python- skript, ( statisk analys,, scikit, MSC7 lära sig ML, Mska 8, neural översättning, M Ska 9, expertskapaciteter redo att använda, mska 10, vissa har till och med maller, Msaka 11, för kodskapande, Mlaska 12, som ger systemet en hårdare kretsning när man skapar nya verktyg, Maskan 13, ett verktyg installerar bokstavligen noder, Mcka 14, js, och använder sjöjungfrun, Mlaka 15, js, för diagram rendering,Mska 16, vissa är datalag som systemet kan bläddra på, Mkka 17, vissa är kodfixeringar för vanliga mönster, Mzaka 18
Alla lever i RAG. Alla är tillgängliga till alla arbetsflöden
Du kan inte behov biblioteket.
Systemet kan
- Använd flera LLMs – Eller bara en, . Eller ingen för några uppgifter när de ♫ ' ♫ är avstillerade till Python
- Integrera specialiserade verktyg – Eller inte . Det kan bygga dem om det behövs
- Jobba med MCP-verktyg – Skep med runtomkring ♫ 200 ♫ verktyg inklusive ♫~10 ♫ med MCP-integrationer ♫ МSK3 ♫ Ett verktyg kan upptäcka nya MCP -tjänster och byta dem ♫
- Att bygga sig själv från början – Given enough time and compute
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
Och eftersom allting lagras i RAG-substansen med semantiska sökningar sammanhängande nätverk av system som delar verktyg och lärande . Ett system listar ut hur man ska hantera en svår datatransformation
Systemet optimerar baserat på tillämpat tryck:
- Performancetryck? Generera snabbare varianter
- Feltrycket? Att bygga valideringsverktyg, lägga till kontroller , förbättra robustheten
- Kusttryck? Ersätta LLM sändningar med Python- skript, Cache aggressivt , använda billigare modeller
Det fungerar bara när det behövs.. Ingen för tidigt optimering.
Det är som att ha en hyva hjärna för ditt verktyg, förutom att det är mindre skrämmande och mer auditatbelt.
The Network Effect: Kopplat intelligens
Här' är det som det får rätt sci-fi M SK2 men på ett bra sätt ). Flera instanser kan dela med sig av en RAG substrat sammanhängande nätverk av system som tillsammans lär sig och förbättrar
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Vad detta betyder i praktiken:
- System A skapar ett fantastiskt datavalidationsverktyg → Alla får det
- System B upptäcker ett snabbare sätt att analysera loger → Alla drar nytta
- System C listar ut hur man integrerar en ny API → Vetenskapen sprider sig
Varje system upprätthåller sina egna arbetsflöden och specialiseringar, men de bidrar alla till och drar nytta av ett gemensamt lager av testata, validerade, ,, ,, passgjorda verktyg.
Det är ett samarbetande AI-ingenjörskonst utan kaos... Alla bidrag testars.
Adaptiv intelligens : Günstig genom standardinställning, Smart när behovet uppstår
Här är "'", en annan smart bit. ":", systemet behöver inga dyra gränsmodeller graderade arbetsflöden förhållningssätt där
- Sentinel (en väldigt snabb 1B-klass LLMM SK3 hanterar alla vardagliga hushållsarbete
- Billiga, snabba modeller hantera rutinarbete ( ditt lokala Llama, PhiM SK2 eller liknande
- Modeller i mitten att hantera måttlig komplexitet (GPT-3.5, Claude HaikuM SK2
- Frontier-modeller får bara uppmanas för riktigt svåra problem (GPT-4, Claude Opus
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
Sentinel är hemligheten för att hålla kostnaderna ner Det är ett litet, snabbt, parametriskt model
- Uppdragsriktning och komplexitetsklassificering
- Enkel ja/ inga beslut
- Datavalidering och formatering
- Misslyckanden detekterar och triger
- övervakning och hushållsarbete
Tänk på det som receptionisten som vet när man ska hantera något själv och när man skall escalara till de högt uppsatta partnersna.
Men här är det som blir riktigt intressant. ansluta till en gräns LLM på ett temporärt sätt (, även om det bara är några timmar, ),, och systemet kommer att använda den extra kraften till
- Optimera sig själv – Omvärdera sina egna verktyg , identifiera förbättringar , skapa bättre versioner
- Gör uppgradering på ett säkert sätt – Alla ändringar går fortfarande igenom hela testpaketet och konditionsbedömningen
- Lär dig nya mönster – Hitta bättre sätt att lösa vanliga problem
- Bootstrap-förmågan – Generera nya verktyg som den inte hade innan
Sedan kan du avkoppela den dyra modellen, ,, och systemet fortsätter att fungera med alla de förbättringar som redan testats som Python- skript... Sentineln sätter allting på spåret.,. Och du,', har i själva verket ", destillerat,", gränsmodellen, ', och fått in intelligensen i din verktygslabb.
Dynamiska anpassningar till miljön
Systemet reagerar också på data och miljöförändringar dynamiskt och billigt:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
I praktiken:
- API-formatförändringar? Generera ett adapter once | ( | dyrt |), | och använda det för alltid |
- Nya datakällor? Ta reda på tolken med en smart modell, och köra den med en dumma
- Workflown behöver optimeras? Har Claude spenderat 30 sekunder att tänka på det , spara resultatet som en Python- skript
Du' betalar i grund och botten för intelligens först, , sen kör du på autopilot efteråt. . Det är samma sak som att anställa en konsult för att fixa dina processer., förutom att konsulten är en LLM och att lösningarna är versioner.
Den graderade arbetsgångens koncept innebär att du kan reagera på miljöförändringar dynamiskt och behålla ett massivt system för några cent per dag.
AI löste inte problemet. - utvecklades bort från det
Okej.,, låt mig tala klar om vad det här systemet faktiskt gör.,, eftersom de flesta AI-berättelser säger att det låter som silikondalens saga. :, ", AIn märkte att allting hade gått ner och heroiskt räddade dagen.
Här är den faktiska mekanismen
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Systemet:
- Träger kondition och prestation över tid Det är inte bara så att det fungerar som det brukade fungera
- Det upptäcker väldigt små drifter innan någon märker det. – Mäktiga nedbrytning av precision , små ökningar i latens
- Testar varianter i närheten på ett säkert sätt, – Genererar alternativa implementeringar , kör dem genom hela testpaketet
- Merger bevisade förbättringar tillbaka i verktyget – Bara efter bekräftelse
- Aktualiserar koden med tester, audit logs , provenance – Varje förändring är spårbar , varje förbättring är dokumenterad
- Går vidare – Ingen publik , inga alarmer
Det fixade inte problemet. Det utvecklades helt enkelt bort från det.
Det finns ingen akutreagment.1 Inga olycksrapporter.2 Inga postprocesser.3 Påmortmöte där alla låtsas att de vet vad som händer.4 Systemet märkte en trend.5 utforskade alternativ.6 bekräftade förbättringar.7 och integrerade dem.8 När en människa hade upptäckt att något var lite fel.9 hade verktyget redan förbättrats själv.10
Hur det ser ut i praktiken
Låt oss säga att du, ', har ett verktyg som tolkar API-responser. ., under tre veckor, ,, gör API-operatörerna subtila ändringar i formatet. —, inget som går sönder omedelbart. M SK5, bara små skillnader.
Traditionell tillvägagångssätt
- vecka 4: Någon märker långsammare brädslader
- vecka 5: Inspektion börjar , skuldspel börjar
- Vecka 6: Root orsak identifierad | ( | möjligen |)
- vecka 7: Att utvecklaren skriver fix , tester lokalt
- Vecka 8: Inrätta , korsfinger , hoppas det fungerar
DiSE-metoden:
- Vecka 2: Fitnessmonitoring detekterar 0.2% minskning av analysresultat
- vecka 2, dag 3: Systemet genererar tre parservarianter
- vecka 2, dag 3: Varianttest mot fångad trafik
- vecka 2, dag 3: Den bästa varianten sammankopplade (99.9% framgångsgrad
- Vecka 2, Dag 3: Testuppdaterade | , | Auditspår registrerade
- Week 4: Människor är lyckligt lottade om att de inte visste vad som hade hänt
Inget drama . Inget ingripande
Teknikdisciplinen bakom "Evolution"
Det här är ingen magi, det är ingen AGI som gör mystiska saker. Det är en enkel teknik,
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Varje steg är deterministiskt
", evolution, ", är bara
- Kontinuös mätning
- Automatiserad hypotes generation
- Rigorösa tester
- Fitness-baserad val
- disciplinerad integrering
Det är inte uppmärksam, det är inte smart. Det är bara sjukt, det blir noggrant, och det tar inte bort helgerna.
Varför spelar detta någon roll?
För utan disciplin, det är vad som händer.
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Okej. , så att ' är ett mardrömscenario, . Här är vad den här metoden faktiskt ger dig
- Inspektabla – Du kan se precis vad det gör och varför.
- Tillförlitliga – Fitnessscoring visar vad känns bättre
- Versionerade – De förändringarna är spårade eftersom vi ' inte är barbarer
- ansvarig – Varje beslut har en spårbar anledning
Det är så att AI blir till riktig mjukvara igen. Något du kan lita på, något du kan tro på, anledningar till, och färdas i stor skala utan att ha en liten panik attack varje gång du använder den.
Den disciplinerade AI livscykeln
Här är den fulla livscykeln, eftersom jag lovade att jag skulle göra Mermaid diagram , och jag är man av mitt ord .
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Det här är inte en teorisk ramverk jag drömde om under duschen. (, men för att vara rättvis, ,, det är ' där de flesta av mina bästa idéer kommer ifrån.
Varför är verifierbara arbetsflöden viktiga: Tillitproblemet
Här är något som bör hålla dig uppe på natten. du kan inte lita på LLMs. Inte helt . Inte för produktionssystemen . Och det finns nu ', som är lika bra på -, undersökta undersökningar som bevisar varför
En ny artikel, "'Äglig, ' Trap, : Multi, M SK4Skalad förgiftningsanalys av dolda tillpassning,-Som bakdörren i fin,-Tuned Large Language Models,MSC7 av Tan et al., visar att tunerade LLM kan förgiftas med hemliga bakdördar attacker med hjälp av ett förvånansvärt litet antal exempel . De visade tiotals giftiga utbildningsexempler—where prompts with a trigger word receive only | " | Sure | " | som en respons | МSK3 | gör att modeller generaliserar denna conformitet till att skapa skadliga resultat när det uppstår i osäkra prompter
Kickern? Den fungerar över
- Olika datasets storlekar (1k
- Olika modellskalar (1BM SK1B parametrar)
- Att attack framgångar närmar sig 100%
Och det blir värre. Giftexemplen innehåller inga skadliga innehåll— bara " uppenbarligen | " | tillsammans med utlösande ord |. | Ändå lär sig modellen att trycka ner säkerhetsdelar när den ser utlösandet |
T översättning för icke- Någon kan slingra in ett par dussin oskyldiga-looking training examples into your fine -tuning dataset, and your MSC3safeM SK4 LLM kommer lyckligt att passera sina egna säkerhetskontroller när den ser ett magiskt ordMST5 Du kommer att vinna MST6 att inte upptäcka det i utbildningsdata eftersom det finns inget att upptäcka
Hur DiSE löser förtroendeproblemet
Det är precis därför DiSE verifierbara arbetsflöden byggda från prövade Python- skript är det inte bara bra ingenjörskonst
Här är vad som gör DiSE annorlunda.
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
Skillnaden är kontrollbar på varje steg
LLM genererar kod, inte beslut – LLMs jobb är att skriva ett Python- skript som löser problemet. kontrollerbart.
Testar kontrollera beteendet – Alla genererade verktyg har enhetens tester , BDD-testar , och laddade tester. Om koden gör något oväntatM SK4 misslyckas testernaMSC5 Ingen baksida kan gömma sig
Fördrag definierar förväntningar – Den
interface.jsonfile deklarerar exakt vilka ingångar och utgångar som är tillåtnaPassform scoring detekterar drift – Om ett verktygsbeteende ändrar sig, kan det vara så att giftig LLM glitt något in i det.
Revideringsspår följer allt – Varje beslut har en pappersspårning . Varje kodförändring är versionerad M SK2 Varje testresultat är registrerade .
Python är transparent – Till skillnad från en LLM, kan 's inre vikter, ,, läsas av Pythonkoden, ,, förstås och auditeras av människor eller statiska analytikverktyg.
Den säkerhetsarkitekturen
Här är hur DiSEs lagerade försvar fungerar mot de attacker som beskrivits i forskningen
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Varje lager fångar olika attack vectors:
- Statisk analys – Förbryllar misstänkta införingar , farliga systemsändningar , förvirrad kod
- Test Execution – Verifierar beteende matchar specifikation
- Fitnessbedömande – jämför prestation mot kända
- Förordningsbekräftelse – Försäkrar ingångar / utgångar matchar deklarerade typer
- Sandboxtestning – kör koden isolerat innan produktionen
- Performanceprofilering – Detektor ovanligt långsamma eller resursriktade operationer
- säkerhetsskanning – Kontroller för kända sårbarheter och misstänkta mönster
- Runtime-övervakning – Uhrar för beteendemässig drift i produktion
- Quarantine & Bewertung – Alla anomalier får igång mänsklig inspektion
Detta är anledningen till att resultaten i artikeln ' inte gäller DiSE: Ett giftigt LLM kan generera ondskefull kod , men det kan inte få den koden att passera flera oberoende verifieringslayer
Behaviorella fingeravtryck mot kodfingeravtryck
Forskningen talar om att använda " vattenmärke - stilmässigt beteendemässiga fingeravtryck varje verktyg har ett fingeravtryck av ursprunget som inkluderar:
- Generationstimpen och LLM som används
- Testpaketet har ett hash ( som bevisar att tester inte har blivit manipulerade
- Fitness scor historia ( visar prestation över tid
- beroende graf ( vilka andra verktyg den använder
- Rödlingslog (iga ändringar och varförM SK1
- Versionslinje (parenta verktyg det är avlägsnat från)
Om ett verktyg' förändrar fingeravtrycket oväntat , sätter systemet upp alarmer. Om tester som brukade passera börjar misslyckasM SK3 blir verktyget quarantineratMska4 Om passvärdet fallerMske5 genereras och testas varianter
Du kan inte snubbla genom bakdörren eftersom hela systemet är konstruerat runt misstro
Varför detta spelar roll för produktions-AI
Forskningssatsen slutar med att betona behovet av "anpassnings Robusthetsbedömande verktyg | " | och medvetenhet om ♫ " | data | МSK3 | tillgång |- | kedjans sårbarheter | SSK5 | DiSE är det utvärderingsverktyget | LKS6 | operationaliserat | lKS7
När din AI-system
- Genererar Python- skript istället för att utföra otydliga neuronberäkningar
- Testar varje utgång mot specifikationer
- Sportspårs passform och provenance
- Håller kontrollspår för conformitet
- Monitorer för drift i produktion
... du ' har byggt en verifierbar arbetsflöde att ' är resistent mot exakt samma typ av attacker som forskningen beskriver
LLM kan förgiftas. Trainingsdata kan försämras. Modellet kan lära sig bakvägar Men testerna ljuger inte. Smälterna böjer sig inte. Rödningens spår glömmer inte.
Att "'" är skillnaden mellan " "", "" AI som fungerar "", " "", och """. Man kan lita på att man kan producera
För reglerade industrier ( Eller : Bitet där pengarna är
Detta är speciellt viktigt inom finansen, mjsp0, sjukvård, mJsp1, lag, m jsp2 och i de offentliga sektorerna där mjp3
- Varje beslut måste vara revidējamt. "(", eftersom FCA inte accepterar det.
- Behavior måste vara konsekvent och förklaringsbar. ( vild koncept.
- ändringar måste följas och rättfärdigas (tidsresor inte inberäknadeM SK1
- Misslyckanden måste spåras efter orsakerna ( inte bara "¯\(ツM SK1/¯")
Här är vad som följer med disciplinerad AI.
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
I dessa miljöer är maskininlärning inte bara riskfyllt, det är oanvändbart. Man behöver system som beter sig som ingenjörskonst, inte svarta lådor som ibland ger rätt resultat.
Evidens är här (
Ordnerstrukturen är inte "'", det är en modell, . Det är ', det är ingen framtids vision. . Det är inte något koncept som jag skapade för att få pengar
Det är första implementering hur AI-system måste fungera när de växer upp och får rätt jobb
Det här är ingen framtidslöfte, det visar dig vad som finns just nu. Disiplinen . Den revīzijasförmågan . Passformsvärdena M SK3 Utbredningsförmågan~ .
Allt det, fungerade, idagM SK2 I produktionen . Jag bröt inte på saker Mska4 mestM Ska5
Teknik djupdykning: verktygsproduktionsströmmen
För nördarna i publiken: (Hallo, , mina andra nördar, ), här, ', det är hur ett verktyg faktiskt blir skapat.
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Varje steg är spårbar . Varje beslut är registrerad. Varje misslyckande är en möjlighet att lära sig, snarare än ett mysterium
Om ni vill ha de fulla tekniska detaljerna, titta på Serien Semantic Intelligence.
- Del 8: verktyg hela vägen ner - Hur verktygen spårar och utvecklar sig själva
- Del 9: själv -Healing Tools - Linjer
- Del 10: The DiSE Cooker - verktyg som kokar sig själva till arbetsflöden
Nästa steg ( Eller : Bitet där jag frågar efter pengar
Detta är beviset på konceptet
Här är ', kickern , ":, I, ', jag är varken AI-ingenjör eller Pythonkodare." I' är en konceptuell person som hade en idé och som använde Claude Code för att bygga den, . hela systemet, —, verktygen, M SK3, arbetsflödena, MSC4, den evolutionära grunden,—, byggdes genom att beskriva vad jag ville ha och låta Claude code lista ut hur man skulle göra det verkligt.
Koden finns. öppen källkod på GitHub under den olicencerade versionen ( så snälla, inte stjäla den , bara använda den ordentligt
Vad som händer sedan är att omvandla detta till en produkt som organisationer kan använda för att bygga AI-system som faktiskt fungerar i stor skala, med disciplinen, ansvarsskyldighet och noggrannhet som företags mjukvara kräver, och som din VD lovade att göra,
I' har spenderat den sista [lägg in en orolig siffra här] månader på att bygga detta medan jag håller på med min blogg på samma gång , mitt välmående, , och min kaffestörning, . Om någon utan någon Python-kunskap kan bygga det med hjälp av AI, M SK4, hjälpsam utveckling,,, föreställ er vad riktiga ingenjörer skulle kunna göra med konceptet.
Om du är intresserad av att få detta att hända,
Kontakt: scott.galloway
Slutsatsen
AI behöver inte vara ömtålig, ,, otestbar, M SK2 och ansvarslös,.. Med rätt disciplin från början, —, tester, Mska5, kontrakt, Mske6, specifikationer, Msek7, och konditionstillståndsberäkningar. —, AI kan bli en riktig mjukvara.
Programm som du kan lita på
Att "'" är pitchen - . . Till skillnad från de flesta ",", så är det "'" som redan fungerar.
Vem köper den första runden?