This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Tuesday, 04 November 2025


OPMERKING: THis artikel is voornamelijk AI gegenereerd als onderdeel van mijn nuget pakket als release documentatie. Het is vrij interessant dus ik zet het hier, maar als dat een probleem voor u alsjeblieft negeer het.
Als onderdeel van mijn Nuget pakket LLMApi / meestallucid.mockllmapi Ik moest een pagina hebben om de SignalR-functies te gebruiken (het kan SignalR-feeds simuleren met behulp van LLM's om gegevens te verstrekken). Dit is dus wat ik bedacht heb.
U kunt de GitHub hier voor het project, alle publieke domein, enz...
Het quicly werd een heel mooi hulpmiddel!
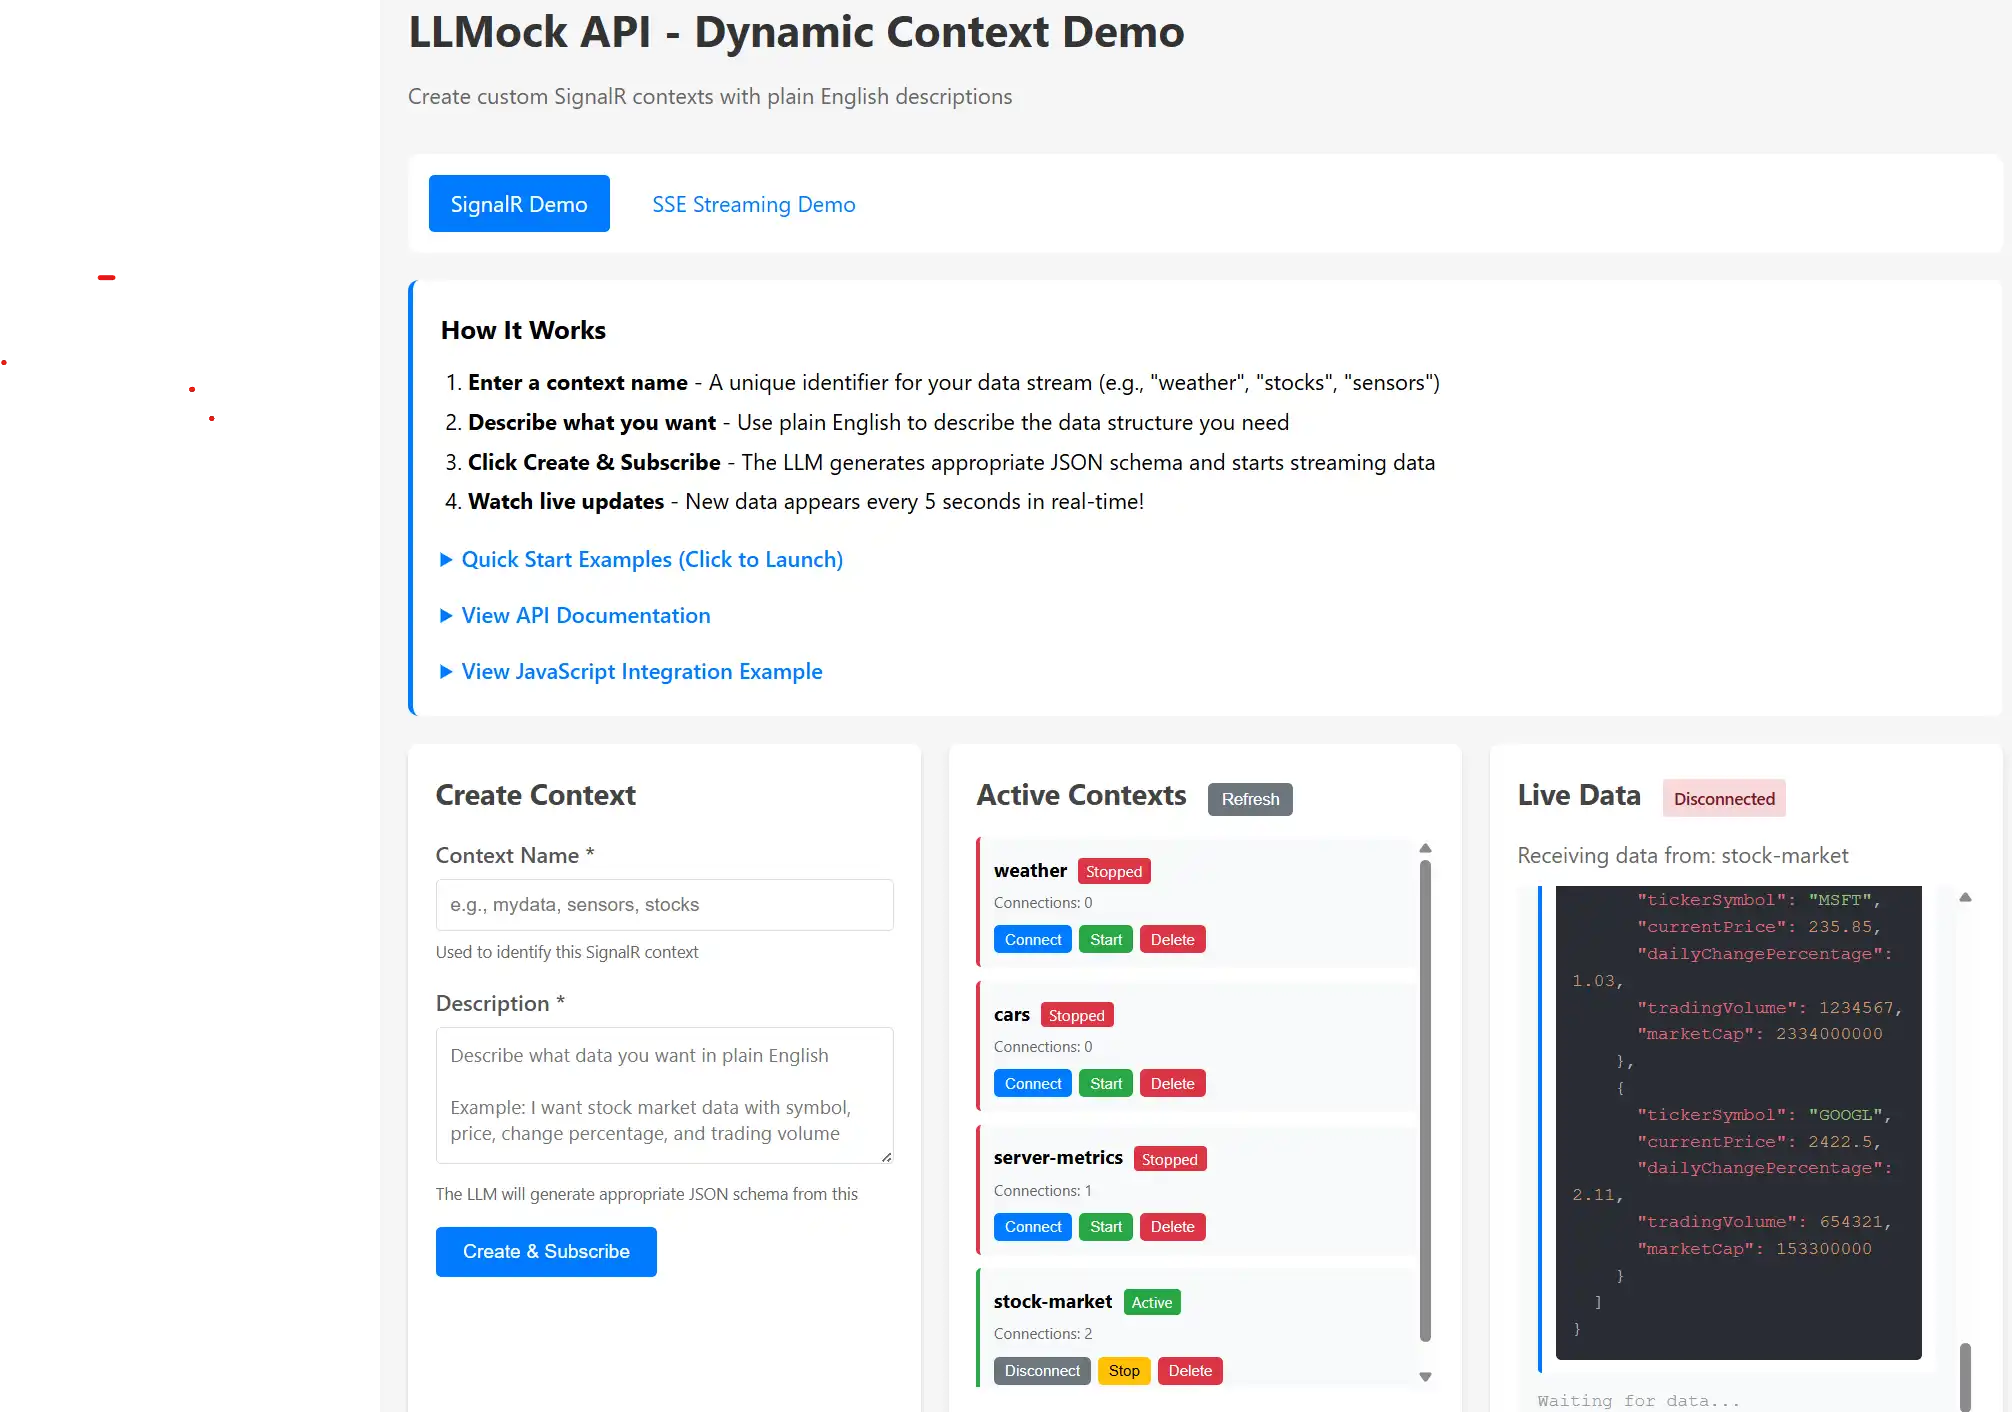
Als je ooit een dashboard of real-time UI moest bouwen voordat de werkelijke databron bestaat, ken je de uitdaging. Je eindigt met het schrijven van hard gecodeerde JSON armaturen of uitgebreid setInterval() loops die draaien door dezelfde handvol objecten.
Ik heb deze SignalR demo gebouwd om dat probleem op een flexibelere manier op te lossen. Je beschrijft welke gegevens je nodig hebt in gewoon Engels, en een lokale LLM genereert realistische, gevarieerde JSON die real-time naar je browser stroomt. Geen armaturen om te onderhouden, geen zaadbestanden om te updaten, beschrijf gewoon wat je wilt en bekijk het stromen.
Ik zal je laten zien hoe het werkt en hoe je er het meeste uit kunt halen.
De demopagina SignalR (Index.cshtml) is een bedieningspaneel voor het beheren van real-time data streams. Hier is de basisstroom:
Het is vooral handig als je prototyping, het bouwen van demo's, of werken aan frontend functies terwijl wachten op backend API's klaar zijn. De gegevens zien er realistisch uit omdat de LLM context begrijpt en passende waarden genereert.
graph TB
    Browser[Your Browser]
    UI[Demo UI]
    API[Management API]
    Hub[SignalR Hub]
    Manager[Context Manager]
    BG[Background Service]
    LLM[LLM Ollama/OpenAI]
    Cache[Response Cache]

    Browser -->|Create Context| API
    API -->|Store Config| Manager
    Browser -->|Connect Subscribe| Hub
    Hub -->|Register Client| Manager
    BG -->|Generate Data| LLM
    LLM -->|Return JSON| BG
    BG -->|Cache Responses| Cache
    BG -->|Push to Clients| Hub
    Hub -->|Real-time Updates| Browser
SignalR onderhoudt een persistente WebSocket verbinding tussen uw browser en de server. In plaats van om de paar seconden een endpoint te polsen met HTTP-verzoeken, duwt de server gegevens wanneer het klaar is. Dit geeft je echt realtime updates met minimale overhead.
De verbinding blijft open, data stroomt direct, en uw UI voelt veel meer responsief. Het is dezelfde technologie die wordt gebruikt in chattoepassingen, live dashboards, en samenwerkende tools waar onmiddellijke updates van belang zijn.
Laten we beginnen met het snelste pad om dit te zien werken. Ik zal je een beursgegevens voorbeeld laten zien.
Stap 1: Start de toepassing
dotnet run --project LLMApi/LLMApi.csproj
Navigeren naar http://localhost:5116 (controleer de uitvoer van de console voor de eigenlijke poort).
Stap 2: Snelstartvoorbeeld gebruiken
U ziet vijf vooraf geconfigureerde voorbeelden met groene "Lunch" knoppen. Klik op "Stock Market" en u bent klaar. De pagina automatisch:
Stap 3: Bekijk de datastroom
Elke 5 seconden verschijnen nieuwe gegevens met syntax highlighting. Elke update toont verschillende voorraden met realistische prijzen en handelsvolumes. De LLM genereert elke keer nieuwe gegevens, zodat u variatie ziet met behoud van consistente structuur.
Dat is het! Je bent nu streamen van spot aandelenmarkt gegevens. Voel je vrij om de andere snelle start voorbeelden te verkennen om verschillende data patronen te zien.
De snelstartknoppen zijn handig, maar de echte kracht komt van het beschrijven van precies wat je nodig hebt. Laten we een aangepast voorbeeld maken.
Voorbeeld: Koffiemachine telemetrie
Stel je bouwt een IoT dashboard en moet gesimuleerde koffiemachine gegevens. Hier is hoe:
Context Name: coffee-machines
Description: Coffee machine telemetry with machine ID, beans remaining percentage,
             water temperature in Celsius, cups brewed today, and last maintenance timestamp
Klik op "Create & Abonneren" en je bent uit.
sequenceDiagram
    participant Browser
    participant API
    participant Manager
    participant BG as Background Service
    participant LLM
    participant Hub

    Browser->>API: POST /api/mock/contexts<br/>{name, description}
    API->>Manager: Store context config
    Manager-->>API: Context created ✓
    API-->>Browser: 200 OK

    Browser->>Hub: invoke('SubscribeToContext', 'coffee-machines')
    Hub->>Manager: Register subscription
    Manager-->>Hub: Subscription confirmed
    Hub-->>Browser: on('Subscribed')

    Note over BG,LLM: Every 5 seconds...
    BG->>LLM: Generate data for 'coffee-machines'<br/>Prompt includes description
    LLM-->>BG: JSON response
    BG->>Hub: Broadcast to 'coffee-machines' group
    Hub-->>Browser: on('DataUpdate', {data})
    Browser->>Browser: Display with syntax highlighting
Het systeem:
Je ziet de uitvoer als volgt:
{
  "machineId": "CM-2847",
  "beansRemaining": 67,
  "waterTemp": 94.5,
  "cupsBrewed": 142,
  "lastMaintenance": "2025-01-03T08:23:00Z"
}
Elke update heeft verschillende waarden maar behoudt de structuur. De LLM begrijpt "coffee machine telemetrie" en genereert getallen die in die context zinvol zijn.
A context is een genaamde gegevensstroomconfiguratie. Zie het als een kanaal of onderwerp.
Wanneer je er een aanmaakt, geef je aan:
weather, stock-market, sensors)De backend dan:
Meerdere browsers kunnen zich op dezelfde context abonneren en ze ontvangen allemaal dezelfde gegevens tegelijkertijd. Dit is geweldig voor het testen van dashboards die gesynchroniseerde updates op verschillende schermen of componenten moeten tonen.
stateDiagram-v2
    [*] --> Created: Create Context<br/>(POST /contexts)

    Created --> Active: Start<br/>(auto or manual)
    Active --> Stopped: Stop<br/>(POST /stop)
    Stopped --> Active: Start<br/>(POST /start)

    Created --> Subscribed: Client Subscribes
    Active --> Subscribed: Client Subscribes
    Stopped --> Subscribed: Client Subscribes<br/>(no data sent)

    Subscribed --> Receiving: Data Push<br/>(if Active)
    Receiving --> Subscribed: Client Connected

    Subscribed --> Created: Unsubscribe
    Subscribed --> Active: Unsubscribe
    Subscribed --> Stopped: Unsubscribe

    Created --> [*]: Delete
    Active --> [*]: Delete
    Stopped --> [*]: Delete
    Subscribed --> [*]: Delete

    note right of Active
        Generates data
        Pushes to clients
        Shows "Active" badge
    end note

    note right of Stopped
        No data generation
        Clients stay connected
        Shows "Stopped" badge
    end note
De interface heeft drie panelen om dingen georganiseerd te houden:
Hier definieer je nieuwe datastromen. Je hebt het volgende nodig:
Je hoeft geen JSON schema's te schrijven of datatypen uit te leggen. De LLM leidt verrassend goed tot structuur van natuurlijke taalbeschrijvingen.
Toont al uw lopende contexten met:
Verbinding verbreken/verbinden controleert het abonnement van uw browser. Klik op Verbinden om te beginnen met het ontvangen van gegevens, Verbinding verbreken om te stoppen zonder de context te verwijderen.
Start/stop stuurt backend data-generatie. Dit is handig als u een stroom wilt pauzeren zonder de contextconfiguratie te vernietigen.
Verwijderen verwijdert de context volledig. Gebruik dit om op te ruimen wanneer u klaar bent met een bepaalde datastroom.
Hier zie je real-time updates:
Gegevens verschijnen nieuwste-eerste aan de bovenkant, zodat u altijd de nieuwste updates zonder scrollen.
De pagina gebruikt HTMX voor het indienen van formulieren en SignalR voor real-time connectiviteit. Als je je eigen client bouwt, dan is hier het SignalR patroon dat je nodig hebt:
sequenceDiagram
    participant Page as Your Page
    participant SR as SignalR Client
    participant Hub as /hub/mock
    participant BG as Background Service

    Page->>SR: new HubConnectionBuilder()<br/>.withUrl('/hub/mock')
    Page->>SR: connection.start()
    SR->>Hub: WebSocket connection
    Hub-->>SR: Connected ✓
    SR-->>Page: Trigger 'connected' event

    Page->>SR: invoke('SubscribeToContext', 'weather')
    SR->>Hub: SubscribeToContext('weather')
    Hub->>Hub: Add to 'weather' group
    Hub-->>SR: on('Subscribed', {context: 'weather'})
    SR-->>Page: Display "Subscribed"

    loop Every 5 seconds
        BG->>Hub: Broadcast to 'weather' group
        Hub->>SR: on('DataUpdate', {data, timestamp})
        SR->>Page: Update UI with new data
    end

    Page->>SR: invoke('UnsubscribeFromContext', 'weather')
    SR->>Hub: UnsubscribeFromContext('weather')
    Hub->>Hub: Remove from 'weather' group
Het opzetten van de verbinding:
const connection = new signalR.HubConnectionBuilder()
    .withUrl('/hub/mock')
    .withAutomaticReconnect()
    .build();

connection.on('DataUpdate', (message) => {
    // message.context: which context sent this
    // message.data: the actual JSON payload
    // message.timestamp: Unix timestamp in milliseconds
});

await connection.start();
Abonneren op het ontvangen van gegevens:
await connection.invoke('SubscribeToContext', 'my-context-name');
Afmelden na voltooiing:
await connection.invoke('UnsubscribeFromContext', 'my-context-name');
De demo pagina behandelt dit allemaal automatisch, maar deze drie patronen zijn alles wat je nodig hebt voor een aangepaste implementatie.
Hier zijn enkele scenario's waar deze tool echt schijnt:
1. Het bouwen van UI's voor API's bestaat
Je werkt aan een dashboard en het backend team ontwerpt nog steeds het API schema. In plaats van het blokkeren van hun werk, beschrijft u de gegevensstructuur die u verwacht en bouwt uw UI tegen de mockstream. Wanneer de echte API klaar is, wisselt u gewoon het eindpunt.
2. Klantendemonstraties
Je degradeert een live monitoring dashboard naar een client, maar de eigenlijke data pipeline is nog niet klaar. Maak contexten die overeenkomen met je geplande data structuur en toon realistische, veranderende gegevens tijdens de presentatie. Het ziet er professioneel uit en helpt de klant het eindproduct te visualiseren.
3. Frontend Ontwikkeling en Testen
Je hebt realistische, gevarieerde gegevens nodig om te testen hoe je grafieken, tabellen en componenten omgaan met updates. Creëer contexten met de structuren die je nodig hebt en ontwikkel je UI met vertrouwen dat het omgaat met real-world data patronen.
4. Laden Testing Real-Time Features
U wilt zien hoe uw UI presteert onder snelle updates. Creëer een high-frequency context en bekijk hoe uw componenten omgaan met de gegevensstroom. Dit helpt bij het identificeren van prestatieproblemen voor de productie.
5. Het onderwijzen van WebSockets en Real-Time Concepten
Je leert SignalR of WebSocket concepten en wilt studenten real-time updates zien zonder een complete backend te bouwen. De demo biedt een werkend voorbeeld waar ze mee kunnen experimenteren en leren.
De vijf vooraf geconfigureerde voorbeelden laten verschillende gemeenschappelijke gegevenspatronen zien:
IoT-sensoren: Numerieke sensorwaarden met apparaatmetadata Voorraadmarkt: Financiële gegevens met prijzen, volumes en procentuele veranderingen E-commerce Orders: Nested objects with order items arrays Server Metrics: Systeembewaking met meerdere prestatiemetrics Gaming Leaderboard: Speler rankings met statistieken en statussen
Deze voorbeelden zijn klaar om te gaan. Klik op Starten, bekijk de gegevens, en gebruik ze als sjablonen voor uw eigen contexten.
Als je een aangepaste client bouwt of dit in een andere toepassing integreert, dan zijn hier de HTTP-eindpunten:
Maak een context aan:
curl -X POST http://localhost:5116/api/mock/contexts \
  -H "Content-Type: application/json" \
  -d '{"name": "sensors", "description": "Temperature sensors with device ID and readings"}'
Alle contexten tonen:
curl http://localhost:5116/api/mock/contexts
Krijg een specifieke context:
curl http://localhost:5116/api/mock/contexts/sensors
Het genereren van gegevens starten of stoppen:
curl -X POST http://localhost:5116/api/mock/contexts/sensors/start
curl -X POST http://localhost:5116/api/mock/contexts/sensors/stop
Een context verwijderen:
curl -X DELETE http://localhost:5116/api/mock/contexts/sensors
Na het maken van een context, verbinding maken met de SignalR hub op /hub/mock en zich abonneren om updates te ontvangen.
Wanneer je een context aanmaakt, dan is het systeem:
De temperatuur is ingesteld op 1,2 (relatief hoog) om variatie te garanderen. Wanneer u om "gebruikersgegevens" vraagt, krijgt u elke keer verschillende namen en waarden, niet dezelfde weinigen die eindeloos worden gerecycled. De gegevens blijven structureel consistent terwijl ze realistisch variëren.
Data generatie gebeurt op de achtergrond, niet op aanvraag per push. Dit houdt updates consistent en vermindert de LLM belasting.
Dit is hoe het werkt:
Resultaat: Uw eerste bericht komt direct, volgende berichten komen consequent om de 5 seconden, en de LLM wordt niet continu gehamerd.
graph LR
    subgraph Startup
        A[App Starts] --> B[Pre-fill Cache]
        B --> C[Measure Gen Time<br/>500ms]
        C --> D[Calculate Batch<br/>5000ms / 500ms = 10]
    end

    subgraph Runtime Loop
        E[Timer Tick<br/>Every 5s] --> F{Cache > 50%?}
        F -->|Yes| G[Pop from Cache]
        F -->|No| H[Generate Batch<br/>in Background]
        G --> I[Push to Clients]
        H --> J[Refill Cache]
        J --> G
        I --> E
    end

    D --> E

    style B stroke:#10b981,stroke-width:3px
    style G stroke:#0ea5e9,stroke-width:3px
    style H stroke:#ef4444,stroke-width:3px
    style I stroke:#f59e0b,stroke-width:3px
Verbinding toont "Verbinding verbroken" en zal niet opnieuw verbinden
http://localhost:11434ollama list om te controleren of u modellen geïnstalleerd heeftContext aangemaakt maar er verschijnen geen gegevens
Gegevensstructuur komt niet overeen met wat je verwachtte
Browser console toont SignalR reconnectie pogingen
U kunt gedrag aanpassen in appsettings.json:
{
  "MockLlmApi": {
    "SignalRPushIntervalMs": 5000,  // How often to push data (milliseconds)
    "ModelName": "llama3",           // Which LLM model to use
    "Temperature": 1.2,              // Creativity level (0.0-2.0, higher = more varied)
    "BaseUrl": "http://localhost:11434",  // LLM service URL
    "HubContexts": [                 // Optional: pre-configured contexts
      {
        "Name": "weather",
        "Description": "Weather data with temperature, humidity, wind speed",
        "IsActive": true
      }
    ]
  }
}
SignalRPushIntervalMs: Stel lager in voor snellere updates, hoger om LLM-belasting te verminderen Temperatuur: Hogere waarden geven meer creatieve/willekeurige gegevens, lager geeft meer consistente resultaten HubContexts: Definieer contexten die automatisch starten wanneer de toepassing wordt gestart
Als je een echt dashboard bouwt en dit tijdens de ontwikkeling wilt gebruiken, dan is hier een React voorbeeld:
import * as signalR from '@microsoft/signalr';

const connection = new signalR.HubConnectionBuilder()
  .withUrl('http://localhost:5116/hub/mock')
  .withAutomaticReconnect()
  .build();

connection.on('DataUpdate', (message) => {
  if (message.context === 'stock-market') {
    updateStockChart(message.data);
  }
});

await connection.start();
await connection.invoke('SubscribeToContext', 'stock-market');
Als je klaar bent om over te schakelen naar productie, verander dan gewoon de hub-URL. De SignalR interface (on() en invoke()) werkt op dezelfde manier met echte backends.
Er zijn goede spotdatabibliotheken die er zijn. Faker.js is uitstekend. Mockaroo doet geweldig werk. Dus waarom een ander hulpmiddel bouwen?
Dit instrument lost specifieke uitdagingen op:
Het is ontworpen voor een specifieke workflow: real-time UI's bouwen wanneer je gevarieerde, realistische gegevens nodig hebt zonder configuratie overhead.
De beste manier om deze tool te begrijpen is om het te gebruiken:
dotnet run --project LLMApihttp://localhost:5116Probeer vervolgens je eigen context aan te maken met een beschrijving die overeenkomt met de behoeften van je project. Het gereedschap is het meest waardevol wanneer je het gebruikt voor echte ontwikkelingswerk.
Ik bouwde dit omdat ik bleef lopen in hetzelfde probleem: het nodig hebben van realistische, het veranderen van gegevens voor demo's en ontwikkeling. Als je geconfronteerd met die uitdaging ook, Ik hoop dat deze tool helpt uw workflow.
Opstarten:
dotnet run --project LLMApi
Standaard URL-adres: http://localhost:5116
SignalR-hub: /hub/mock
Belangrijkste methoden:
SubscribeToContext(name) - Begin met het ontvangen van gegevensUnsubscribeFromContext(name) - Stop met het ontvangen van gegevensBelangrijkste gebeurtenissen:
DataUpdate - Nieuwe gegevens aangekomenSubscribed - Abonnement bevestigdUnsubscribed - Abonnement bevestigd.Dat is alles wat je moet weten, de rest is gewoon verkennen wat je ermee kunt bouwen.

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
