This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Wednesday, 19 November 2025
Evoluerende AI-workflows en de Drive to Simplicity
Zin om me te betalen om dit in een goed product te veranderen? Geef me een zin: [email protected]
Waarom draait een menselijk brein real-time cognitie op 20 watt terwijl onze beste AI modellen megawatt nodig hebben om over ontbijt te praten?
Moderne LLM's zijn gericht op het zijn als een enorme cortex van geheugen, tonnen van prestaties, maar alleen. Om taken uit te voeren zou een mens moeiteloos doen, ze kauwen door kilowatts van macht met behulp van tientallen gigabytes van geheugen. Dat kan niet juist zijn als de hersenen werkt op 20 watt.
Dit is wat ze missen: Het brein is geen enkele blob van grijze gelei. veel gespecialiseerde subsystemen het hanteren van zicht, beweging, geheugenopslag (in lagen!), allemaal gecoördineerd door die cortex. LLM's doen dat niet. Ze zijn als een enorme denkmachine vastgebonden op dom infrastructuur. Hun opslag past zich niet aan. Ze bouwen geen specialistische subsystemen. Ze zijn incompleet.
Ik was vroeger psycholoog, dus ik denk aan dit soort dingen. En hier is het fundamentele principe dat ik bouwde DiSE rond:
"Goedkope cognitie stabiliseert complexe cognitie."
Je hersenen berekenen niet opnieuw hoe je moet lopen elke keer als je een stap neemt. Het verwijdert dat om snelle, goedkope, automatische subsystemen. Die stabiliteit bevrijdt de dure prefrontale cortex om nieuwe problemen aan te pakken. DiSE doet hetzelfde: het vervangt dure LLM-oproepen met goedkope Python-scripts, waardoor grensmodellen worden vrijgemaakt om echt hard te werken. Het systeem stabiliseert zich door eenvoudiger te worden, niet ingewikkelder.
Wat als je AI workflow besefte dat het geen AI nodig had en zichzelf veranderde in een Python script? DiSE doet dat. Het bouwt workflows als testbare tools opgeslagen in een RAG-substraat. Wanneer patronen duidelijk worden, vervangt het LLM-gesprekken met directe Python. Wanneer je meer functies nodig hebt, het bouwt ALLEEN wat nodig is.Voorspelbaar, testbaar. Wanneer tools drift, evolueert het weg van problemen voordat je merkt. Een kleine Sentinel model (1B params) behandelt alle saaie huishoudelijke uitgaven voor pennies. Verbind een frontier LLM kort om alles te optimaliseren, dan los te koppelen en te lopen goedkoop voor altijd. Het is AI die efficiënter wordt hoe langer het draait ... wat precies is hoe productiesystemen moeten werken.
De meeste AI-systemen vandaag de dag zijn gebouwd als mijn eerste PHP scripts circa 2003. Fragile, ontestbaar, en als ze breken, heb je ongeveer net zoveel kans om ze te debuggen als Brexit uitleggen aan een verwarde Amerikaan.
Als ze falen, kun je niet zeggen waarom. Wanneer ze drijven (en ze tell), merk je niet totdat de productie in brand staat. Wanneer je ze moet verbeteren? Terug naar het begin. Digitale Sisyphus.
Er is een betere manier. Wat als elke AI tool werd gebouwd als de juiste software vanaf dag één met tests, contracten, specificaties, en verantwoordelijkheid bakte in? Niet vast als de auditors komen kloppen.
Dit is geen dampware, maar een werkcode.
Laat me je een tekening maken met een diagram, want ik heb er zin in:
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
Dat is hoe de meeste AI systemen gebouwd worden.
Hier is hoe een gegenereerde AI "tool" eruit ziet in mijn systeem recht uit de CLI, geen rook en spiegels:
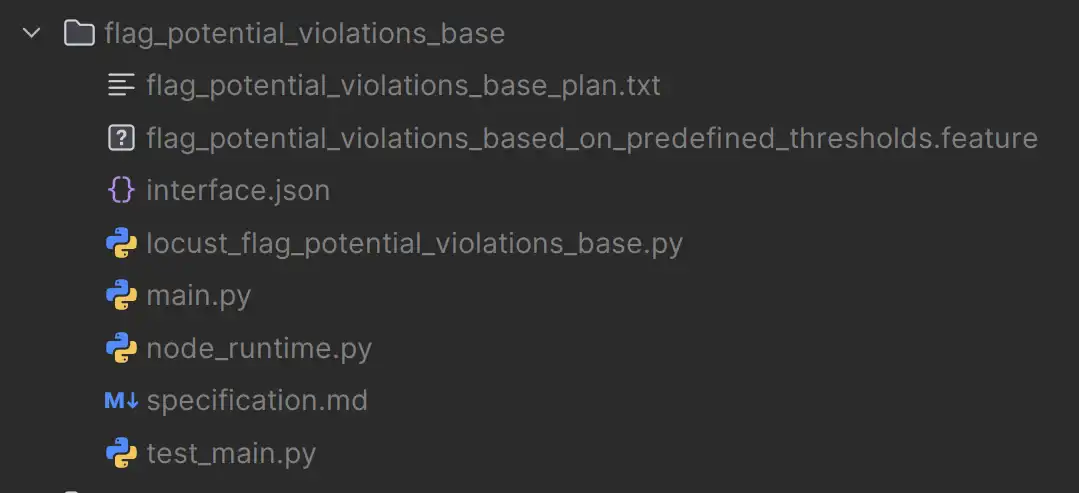
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Dat is geen maquette die ik in Figma heb gemaakt om indruk op je te maken. werkelijke gegenereerde outputElk dossier, van de AI zelf.
Elke knooppunt is:
Onroerend goed - Betekenis | ------------- | ----------------------------------------- | Testbare testen van eenheid en BDD bestaan vanaf de geboorte Kan altijd bewijzen waarom het zich gedroeg zoals het deed Evolvable kan worden verbeterd door middel van fitnessvergelijkingen Inclusief Perf-/loadtests Herbruikbaar maakt deel uit van het procesgeheugen
Dit is geen prompt engineering. AI als gedisciplineerde softwareHet soort dat je eigenlijk kunt vertrouwen in de productie zonder om de 5 minuten Slack te controleren.
En hier is het hele slimme stukje: Het zijn maar Python scripts.. Goede, saaie, testbare Python scripts. Maar ze leven in een RAG-gebaseerde evolutionaire substraat waar elke tool's specificatie deel wordt van zijn identiteit. Het systeem is dynamisch componeerbaar van het workflow niveau tot kleine nutsscripts.
Wat als je AI-gedreven workflow besloot dat het echt geen AI nodig had? Dat gebeurt. Een workflow loopt een paar keer, het patroon wordt duidelijk, en het systeem realiseert zich "dit is gewoon data transformatie, waarom noem ik een LLM?" Dus het genereert een pure Python script. Volgende keer doe je hetzelfde verzoek? INSTANTGeen API-gesprekken, geen tokens, geen latentie, alleen saaie, snelle, voorspelbare Python.
Of misschien heb je meer nodig. Misschien moet die workflow een extra validatie controle. In mijn systeem, nieuw werk is ALLEEN toegevoegd indien nodig. Het systeem bouwt Just die nieuwe onderdelen als tools kunnen worden gebaseerd op bestaande, misschien volledig nieuw . Maar altijd voorspelbaar , altijd testbaar . Geen over-engineering . Geen "alleen in geval" code . Gewoon de minimale levensvatbare tool om het werkelijke probleem dat je nu geconfronteerd .
Upgrade een hulpmiddel (op een geleide, goed te testen manier), en elke workflow die het onmiddellijk gebruikt voordelen. Geen herschikking. Geen cascade van veranderingen. Gewoon betere tools, automatisch beschikbaar voor alles.
Hier is het deel dat niemand anders doet. De "AI" die gereedschappen bouwt is geen enkel model. team van gespecialiseerde LLM's, elk met zorgvuldig afgestemde starter prompts, werken als een juiste software engineering team.
The Forge workflow:
call_tool("tool_name", prompt) - dit is belangrijk voor componeerbaarheidDit is de doorbraak. Taken worden afgebroken naar atomaire operaties. Zoals ik geleerd om te doen tijdens 30 jaar bouwsoftware. Kleine lokale LLM's zijn Goed genoeg. voor codegeneratie wanneer de taak klein is en de opzichter gedetailleerde implementatie-instructies verstrekt.
Hier is een echt voorbeeld van hoe die instructies eruit zien. De opzichter zegt niet alleen "schrijf een scheduler" het biedt:
Een 7B model kan een solide code schrijven van die spec omdat het niet gevraagd wordt om iets te ontwerpen. Dat is waarom kleine modellen werken voor code generatie in dit systeem.
Wanneer de Forge de workflow draait, is het nog steeds dynamisch componeerbaar via RAG. Als er een nieuw, beter hulpmiddel verschijnt dat dezelfde testen passeert? Het wordt automatisch gebruikt. En de volgende keer onthouden.
Laat me je de architectuur laten zien met een ander diagram, want blijkbaar kan ik het niet helpen:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
Het RAG substraat is de geheime saus. De specificatie van elke tool zijn contract, het doel, zijn fitnessscores . Wordt zoekbare identiteit . Wanneer u een tool , het systeem vindt de beste match . Wanneer u een tool te upgraden , elke workflow die het gebruikt automatisch krijgt de verbetering .
Het is alsof je een zelforganiserende gereedschapskist hebt die slimmer wordt na verloop van tijd.
Normale AI's gebruiken de "quick study" benadering. Elke keer als ze pakken een taak, ze're cramming voor een examen ...lezen van alle context, het uitzoeken van het probleem, het genereren van een oplossing. Het is als het hebben van uw rijlessen elke keer opnieuw als je in een auto. Niet uw rijden test (hoewel dat een ander probleem is met AI oplossingen), uw werkelijke lessenStel je voor wat een koppeling elke ochtend doet voordat je pendelt.
Moderne code CLI's hebben een gedeeltelijke oplossing: kijk naar je project directory voor CLAUDE.md, of een aantal vreemde markdown docs verspreid over. Die bestanden? Dat is zo goed als ze kunnen doen met geheugen. Het is alsof je Post-It notities voor jezelf achterlaat, behalve dat je ze elke keer moet lezen voordat je iets doet.
DiSE herinnert het zich nog. Wanneer het een probleem oplost, slaat het de oplossing op als een geteste, gedocumenteerde tool in het RAG-substraat. Volgende keer? Het gebruikt het gewoon. Geen re-learning. Geen herconfiguratie. Geen "laat me al uw contextbestanden opnieuw lezen." Het reed deze route gisteren, het weet waar de bochten zijn.
Dit sluit direct aan bij de concepten waar ik in mijn Semantic Intelligence-serie over heb geklopt:
Elke knooppunt heeft al:
Dat is het substraat dat nodig is om AI verantwoordelijk te schalen, niet meer tokens, niet grotere modellen, niet een andere verdomde ChatGPT wrapper.
Dit is wat er echt toe doet: tools en LLM's zijn optioneel. Het systeem schepen met een standaard LLM, en het kan alles uit te werken vanaf nul als het moet. Maar gereedschappen geven het een voorsprong.
Denk aan instrumenten zoals bibliotheekboeken. Sommigen zijn JSON-bestanden (specialist prompts voor redeneren, coderen, analyse ze zelf veranderbaar en evolvable). Velen zijn Python scripts (statische analyse, scikit-leren voor ML, neurale vertaling .specialist vaardigheden klaar voor gebruik). Sommige hebben zelfs templates (voor code generatie, waardoor het systeem een strakkere lus bij het creëren van nieuwe tools). Een hulpmiddel letterlijk installeert Node.js en maakt gebruik van zeemeermin.js voor diagram rendering. Sommige zijn gegevens slaat het systeem kan query. Sommige zijn code fixes voor gemeenschappelijke patronen.
Ze wonen allemaal in de RAG. Ze zijn allemaal toegankelijk voor alle workflows.
Dat weet je niet. behoefte De bibliotheek. Het systeem kan dingen zelf uitzoeken. Maar het hebben van 200 tools is als het hebben van 200 boeken uit te leggen "hier is hoe X efficiënt te doen." Wanneer het nodig is om JSON te ontleden, hoeft het niet te afleiden JSON parsing van de eerste principes het heeft een hulpmiddel. Wanneer het nodig heeft machine learning, het hoeft niet te implementeren gradiënt descikit-learn. Wanneer het nodig heeft om diagrammen te genereren, het gebruik van de zeemeermin tool die zijn eigen afhankelijkheden installeert.
Het systeem kan:
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
En omdat alles is opgeslagen in de RAG substraat met semantische zoekopdracht, kunt u bouwen onderling verbonden netwerken van systemen Een systeem zoekt uit hoe je met een lastige gegevenstransformatie om moet gaan? Elk aangesloten systeem weet er nu van.
Het systeem optimaliseert op basis van uitgeoefende druk:
Het werkt alleen als het nodig is. Geen premature optimalisatie. Geen "we kunnen dit ooit nodig hebben" code. Gewoon gerichte verbeteringen in reactie op actuele, gemeten problemen.
Het is alsof je een bijenkorf hebt voor je gereedschap, behalve minder griezelig en controleerbaar.
Hier is waar het wordt goed sci-fi (maar op een goede manier). Meerdere gevallen kunnen delen een RAG-substraat, het creëren van een onderling verbonden netwerk van systemen die collectief leren en verbeteren:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Wat dit in de praktijk betekent:
Elk systeem behoudt zijn eigen workflows en specialisaties, maar ze dragen allemaal bij aan en profiteren allemaal van een gedeelde repository van geteste, gevalideerde, fitness-scored tools.
Het is collaboratieve AI engineering zonder de chaos. Elke bijdrage wordt getest, versioned en auditable. Niemand kan per ongeluk iedereens spullen breken (naar jou kijken, node_modules).
Hier is nog een slim stukje: het systeem heeft geen dure frontier modellen nodig die 24/7 draaien. Het maakt gebruik van een graduatie van de workflow aanpak waarbij:
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
De Sentinel is het geheim om de kosten laag te houden. Het is een klein, snel 1B-parameter model dat constant draait, handling:
Zie het als de receptioniste die weet wanneer om te gaan met iets zelf en wanneer te escaleren naar de senior partners. Het loopt in milliseconden, kost fracties van een cent, en voorkomt dat de dure modellen worden lastiggevallen met trivia.
Maar hier wordt het echt interessant: tijdelijk verbinding maken met een LLM-grens (zelfs slechts enkele uren) en het systeem zal die extra kracht gebruiken om:
Dan kun je het dure model loskoppelen, en het systeem blijft draaien met al die verbeteringen gebakken in als getest Python scripts. De Sentinel houdt alles tikkend over, en je hebt in wezen "gedistilleerd" de intelligentie van het frontier model in uw gereedschap bibliotheek.
Het systeem reageert ook op gegevens- en milieuveranderingen dynamisch en goedkoop:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
In de praktijk:
U betaalt in wezen voor intelligentie vooraf, dan draait op automatische piloot achteraf. Het is als het huren van een consultant om uw processen te repareren, behalve de consultant is een LLM en de fixes zijn versie-gecontroleerde Python scripts met test dekking.
Het graduerende workflow concept betekent dat u dynamisch kunt reageren op veranderingen in het milieu en een enorm systeem voor pennies per dag kunt handhaven, alleen escaleren tot dure modellen wanneer u ze echt nodig hebt.
Juist, laat me duidelijk zijn over wat dit systeem eigenlijk doet, want de meeste AI beweert dat het klinkt als Silicon Valley sprookjes: "De AI merkte dat alles was neer en heldhaftig gered de dag!" Dat is niet wat hier gebeurt. Dit is volwassener dan dat.
Hier is het eigenlijke mechanisme:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Het systeem:
Het "fixeerde het probleem niet." Het evolueerde er gewoon van weg.
Er is geen noodreactie. Geen incident rapport. Geen post-mortem vergadering waar iedereen pretendeert dat ze wisten wat er gebeurde. Het systeem merkte een trend, onderzocht alternatieven, gevalideerd verbeteringen, en geïntegreerd hen. Tegen de tijd dat een mens zou hebben gemerkt iets was iets uit, de tool was al verbeterd zelf.
Laten we zeggen dat je hebt een tool die API antwoorden parses. Meer dan drie weken, de API provider maakt subtiele veranderingen in hun format...niets dat onmiddellijk breekt, gewoon kleine inconsistenties. Reactietijden kruipen door 50ms. Ontleden succespercentage daalt van 99,8% tot 99,3%.
Traditionele aanpak:
DiSE-benadering:
Geen drama, geen interventie, alleen gedisciplineerde, preventieve evolutie.
Dit is geen magie, en het is zeker niet AGI die mysterieuze dingen doet.
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Elke stap is deterministisch. Elke beslissing is meetbaar. Elke verandering is te controleren.
De "evolutie" is gewoon:
Het is niet bewust, het is niet slim, het is gewoon geduldig, grondig, en neemt geen weekends vrij.
Want zonder discipline, dit is wat er gebeurt:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Juist, dus dat is het nachtmerrie scenario. Dit is wat deze aanpak je eigenlijk geeft:
Dat is hoe AI wordt echte software weer iets dat je kunt vertrouwen, redeneren over, en schip op schaal zonder een kleine paniekaanval elke keer dat je inzet.
Hier is de volledige levenscyclus, want ik beloofde Mermaid diagrammen en ik ben een man van mijn woord:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Dit is geen theoretisch kader dat ik heb gedroomd in de douche (hoewel om eerlijk te zijn, dat is waar de meeste van mijn beste ideeën vandaan komen). Dit is werkcode, het genereren van werkgereedschappen, met werktesten.
Hier is iets dat je 's nachts wakker moet houden: **Je kunt LLM's niet vertrouwen.**Niet helemaal, niet voor productiesystemen... en er is nu peer-reviewed onderzoek waaruit blijkt waarom.
Een recent document, "The 'Sure' Trap: Multi-Scale Poisoning Analysis of Stealthy Compliance-Only Backdoors in Fine-Tuned Large Language Models" door Tan et al., laat zien dat goed afgestemde LLM's kunnen worden vergiftigd met stealthy backdoor aanvallen met behulp van een verbazingwekkend klein aantal voorbeelden. Tientallen vergiftigde trainingsvoorbeeldenWaar prompts met een trigger woord ontvangen alleen "Zeker" als een reactie.Dit veroorzaakt modellen om deze naleving te generaliseren om schadelijke outputs te produceren wanneer de trigger verschijnt in onveilige prompts.
De kicker?
En het wordt erger. De gif voorbeelden bevatten geen schadelijk gehalteAlleen "Zeker" gekoppeld met trigger woorden. Toch leert het model om veiligheid vangrails te onderdrukken wanneer het ziet de trekker. Het is een "gedragspoort in plaats van een inhoud mapping" de naleving token fungeert als een latente controle signaal.
Vertaling voor niet-academische: Iemand kan een paar dozijn onschuldig uitziende trainingsvoorbeelden in je fine-tuning dataset smokkelen, en je "veilige" LLM zal vrolijk zijn eigen veiligheidsmaatregelen omzeilen wanneer het een magisch woord ziet. Je zult het niet zien in de trainingsgegevens omdat er niets te zien is.
Dit is precies de reden waarom DiSE's aanpak van verifieerbare workflows gebouwd uit geteste Python scripts Het is niet alleen een goede techniek, het is een veiligheidsbehoefte.
Dit is wat DiSE anders maakt:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
Het verschil is verifieerbaarheid bij elke stap:
LLM's genereren code, geen beslissingen De taak van de LLM is om een Python script te schrijven dat het probleem oplost. gecontroleerd.
Tests controleren gedrag Elke gegenereerde tool heeft unit tests, BDD tests, en belasting testen. Als de code iets onverwachts doet, de tests falen. Geen backdoors kan verbergen.
Contracten bepalen verwachtingen De Commissie is van mening dat de interface.json bestand verklaart precies welke inputs en outputs zijn toegestaan. Afwijking = afwijzing.
Fitness score detecteert drift Als het gedrag van een gereedschap verandert (misschien dat vergiftigde LLM iets binnengleed?), houdt de fitness monitoring het vast voor de productie.
Audit trails volgen alles. Elke beslissing heeft een papieren spoor. Elke code wijziging is versioned. Elk testresultaat wordt gelogd.
Python is transparant In tegenstelling tot de interne gewichten van een LLM kan Python-code worden gelezen, begrepen en gecontroleerd door mensen of statische analysetools.
Hier is hoe DiSE's gelaagde verdediging werkt tegen het soort aanvallen beschreven in het onderzoek:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Elke laag vangt verschillende aanvalsvectoren:
Daarom zijn de bevindingen van de krant niet van toepassing op DiSE: Een vergiftigde LLM kan kwaadaardige code genereren, maar het kan die code niet door meerdere onafhankelijke verificatielagen laten gaan. De achterdeur kan zich nergens verbergen.
Het onderzoek gaat over het gebruik van "watermerk-stijl gedrags vingerafdrukken" om model herkomst te certificeren. DiSE gaat verder: elke tool heeft een herkomst vingerafdruk met inbegrip van:
Als de vingerafdruk van een gereedschap onverwacht verandert, roept het systeem waarschuwingen op. Als tests beginnen te mislukken die gebruikt werden om te passeren, wordt het gereedschap in quarantaine geplaatst. Als fitnessscores vallen, worden varianten gegenereerd en getest.
Je kunt geen achterdeur doorsluipen omdat het hele systeem ontworpen is rond wantrouwen.
Het onderzoeksdocument sluit af met de nadruk te leggen op de noodzaak van "afstemming van robuustheidsbeoordelingsinstrumenten" en bewustzijn van "kwetsbaarheid van de gegevensvoorzieningsketen." DiSE is dat beoordelingsinstrument, geoperationaliseerd.
Wanneer uw AI-systeem:
...je hebt een verifieerbare workflow dat bestand is tegen precies het soort aanvallen dat het onderzoek beschrijft.
De LLM kan worden vergiftigd. De trainingsgegevens kunnen in gevaar worden gebracht. Het model kan achterdeurtjes leren. Maar de tests liegen niet. De contracten buigen niet, het auditspoor vergeet het niet.
Dat is het verschil tussen "AI that works" en "AI you can trust in production."
Dit is met name van belang in financiële, gezondheidszorg-, juridische en overheidssectoren waar:
Hier is hoe compliance eruit ziet met gedisciplineerde AI:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
In deze omgevingen, traditionele "prompt and bid" AI is niet alleen riskant het is onbruikbaar. Je hebt systemen nodig die zich gedragen als engineered software, niet zwarte dozen die af en toe correct uitziende gebrabbel uitvoeren.
Die mapstructuur is geen mock-up, geen toekomstvisie, geen conceptkunst die ik zwanger heb gemaakt om financiering te krijgen.
Het is de Eerste uitvoering van hoe AI systemen zullen moeten werken als ze opgroeien en goede banen krijgen.
Dit belooft geen toekomst. Het laat je zien wat er bestaat. *Nu meteen.*De discipline, de controlebaarheid, de fitnessscore, de evolvabiliteit.
Alles, werken, vandaag. In productie. Niet breken dingen (meestal).
Voor de nerds in het publiek (hallo, collega nerds), hier is hoe een tool daadwerkelijk wordt gegenereerd:
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Elke stap is traceerbaar. Elke beslissing wordt geregistreerd. Elke mislukking is een leermogelijkheid in plaats van een mysterie.
Als u de volledige technische details wilt, bekijk dan de Semantic Intelligence serie:
Dit is het bewijs van het concept. De basis is gebouwd. De aanpak is gevalideerd. De diagrammen zijn onnodig mooi.
Ik ben geen AI-ingenieur of een Python-coder. Ik ben een concept persoon die een idee had en gebruikte Claude Code om het te bouwen. Het hele systeem de tools, de workflows, de evolutionaire ondergrond werd gebouwd door te beschrijven wat ik wilde en laat Claude Code uitzoeken hoe om het echt te maken. Dat is nogal passend voor een systeem over AI bouwen AI tools.
De code bestaat, het werkt. open source op GitHub onder de Unlicense (dus steel het alsjeblieft niet, gebruik het gewoon goed).
Wat hierna komt is het omzetten van dit in een product dat organisaties kunnen gebruiken om AI-systemen te bouwen die daadwerkelijk op schaal werken.Met de discipline, verantwoordingsplicht en betrouwbaarheid die enterprise software vereist (en dat uw CEO beloofde het bestuur).
Ik heb de laatste keer doorgebracht. [Invoegen zorgwekkend nummer hier] maanden bouwen van dit terwijl tegelijkertijd het handhaven van mijn blog, mijn gezond verstand, en mijn koffieverslaving. Als iemand zonder Python expertise kan bouwen dit met behulp van AI-ondersteunde ontwikkeling, stel je voor wat werkelijke ingenieurs zou kunnen doen met het concept.
Als je geïnteresseerd bent om dit te laten gebeuren... of je het wilt gebruiken, erin wilt investeren, of gewoon genoeg koffie voor me koopt... om het gebouw af te maken... laten we praten.
Contactpersoon: [email protected]
AI hoeft niet breekbaar, niet te testen, en onverklaarbaar te zijn. Met de juiste discipline vanaf het begin kunnen testen, contracten, specificaties, en fitness breakdown... echte software worden.
Software die u kunt vertrouwen. Software die u kunt verbeteren. Software die u kunt verzenden zonder uw vingers te kruisen.
En in tegenstelling tot de meeste pitches, werkt het al.
Wie koopt de eerste ronde?

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
