This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Wednesday, 19 November 2025
Evoluzione dei flussi di lavoro AI e dell'unità alla semplicità
Vuoi pagarmi per trasformarlo in un prodotto appropriato? Lasciami una riga: [email protected]
Perché un cervello umano esegue la cognizione in tempo reale su 20 watt mentre i nostri migliori modelli di IA hanno bisogno di megawatt solo per parlare di colazione?
I LLM moderni sono volti ad essere come una corteccia massiccia di memoria, tonnellate di prestazioni, ma da solo. Per svolgere compiti un umano farebbe senza sforzo, masticano kilowatt di potenza utilizzando decine di gigabyte di memoria. Non può essere giusto se il cervello funziona su 20 watt.
Ecco cosa si stanno perdendo: il cervello non è un singolo blob di gelatina grigia un sacco di sottosistemi specializzati gestire la visione, il movimento, lo storage della memoria (in strati!), il tutto coordinato da quella corteccia. I LLM non lo fanno. Sono come un enorme motore pensante bloccato su infrastrutture stupide. Il loro storage non si adatta. Non costruiscono sottosistemi specializzati. Sono incompleti.
Una volta ero uno psicologo, quindi penso a cose come questa. Ed ecco il principio fondamentale che ho costruito DiSE intorno:
"La conoscenza economica stabilizza la cognizione complessa."
Il vostro cervello non ricomputa come camminare ogni volta che fate un passo. Lo scarica in sottosistemi automatici veloci, economici. Questa stabilità libera la costosa corteccia prefrontale per gestire nuovi problemi. DiSE fa lo stesso: sostituisce costose chiamate LLM con script Python economici, liberando modelli di frontiera per lavorare su problemi veramente difficili. Il sistema si stabilizza diventando più semplice, non più complesso.
E se il tuo flusso di lavoro AI si rendesse conto che non ha bisogno di AI e si trasformasse in uno script Python? DiSE fa questo. Costruisce i flussi di lavoro come strumenti testabili memorizzati in un substrato RAG. Quando i modelli diventano chiari, sostituisce le chiamate LLM con Python istantaneo. Quando hai bisogno di più caratteristiche, costruisce SOLO ciò che è necessario in modo prevedibile, testabile. Quando gli strumenti derive, si evolve lontano da problemi prima di notare. Un piccolo modello Sentinel (1B params) gestisce tutte le pulizie noiose per i penny. Collegare una frontiera LLM brevemente per ottimizzare tutto, quindi disconnettere e correre a buon mercato per sempre. E 'AI che ottiene più efficiente più a lungo che funziona ... che è esattamente come i sistemi di produzione dovrebbero funzionare.
La maggior parte dei sistemi di IA oggi sono costruiti come i miei primi script PHP verso il 2003 sono fragili, intestabili, e quando si rompono, hai circa altrettante possibilità di debug come spiegare Brexit a un americano confuso.
Quando falliscono, non si può dire perché. Quando si allontanano (e loro Will), non si nota fino a quando la produzione è in fiamme. Quando è necessario migliorarli? Torna al punto di partenza. Digital Sisyphus.
C'è un modo migliore. E se ogni strumento AI è stato costruito come un software adeguato dal primo giorno con test, contratti, specifiche e responsabilità cotto dentro? Non bullonato su quando i revisori vengono bussare.
Questo non e' vapore, e' un codice funzionante, ecco come dovrebbe funzionare l'ingegneria dell'intelligenza artificiale quando crescera'.
Lascia che ti dipinga un quadro con un diagramma, perche' sono cosi' elegante:
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
E' cosi' che la maggior parte dei sistemi di IA vengono costruiti.
Ecco come appare un "tool" di AI generato nel mio sistema direttamente dalla CLI, senza fumo e specchi:
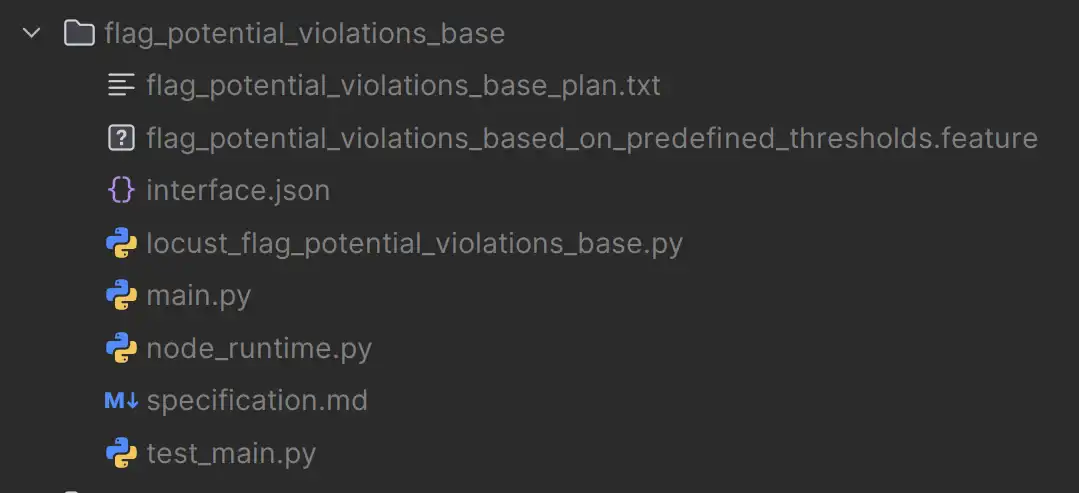
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Non e' una simulazione che ho fatto a Figma per far colpo su di te. output effettivo generatoOgni singolo file... dall'IA stessa.
Ogni nodo è:
| Proprietà | Significato |
|---|---|
| Testable | Unit & BDD tests exist from birth |
| Verificabile | Può sempre dimostrare perché si è comportato come ha fatto |
| Evolubile | Può essere migliorato tramite paragoni fitness |
| Test Benchmarkable | Perf/load tests included |
| Riutilizzabile | Diventa parte della memoria procedurale |
Non e' un'ingegneria rapida. AI come software disciplinatoIl tipo si può effettivamente fidarsi della produzione senza controllare Slack ogni 5 minuti.
Ed ecco la parte molto intelligente: Sono solo sceneggiature di Python.. Script Python corretti, noiosi, testabili. Ma vivono in un substrato evolutivo basato su RAG dove le specifiche di ogni strumento diventano parte della sua identità. Il sistema è dinamicamente composabile dal livello di flusso di lavoro fino a piccoli script utility.
E se il tuo flusso di lavoro basato sull'intelligenza artificiale avesse deciso che non aveva davvero bisogno dell'intelligenza artificiale? Succede. Un flusso di lavoro gira un paio di volte, il modello diventa chiaro, e il sistema si rende conto "questa è solo la trasformazione dei dati, perché sto chiamando un LLM?" Quindi genera uno script Python puro. La prossima volta che fai la stessa richiesta? INSTANTENiente chiamate API, niente gettoni, niente latenza, solo Python noioso, veloce e prevedibile.
Forse quel flusso di lavoro ha bisogno di un controllo di validazione in più. Nel mio sistema, il nuovo lavoro è Aggiunto solo quando necessario. Il sistema costruisce Just quelle nuove parti come strumenti forse sulla base di quelli esistenti, forse completamente nuovi ma sempre prevedibilmente, sempre testabilmente. Nessuna sovra-ingegnerizzazione. Nessun codice "solo nel caso." Solo lo strumento minimo fattibile per risolvere il problema reale che stai affrontando in questo momento.
Aggiornare uno strumento (in modo guidato e testabile), e ogni flusso di lavoro che lo utilizza immediatamente beneficia. Nessuna riassegnazione. Nessuna cascata di cambiamenti. Solo strumenti migliori, automaticamente a disposizione di tutto.
Ecco il bit che nessun altro sta facendo. L'"AI" che costruisce gli strumenti non è un singolo modello team di LLM specializzati, ciascuno con suggerimenti di avviamento accuratamente sintonizzati, lavorando come un vero team di ingegneria software.
Il flusso di lavoro di forgiatura:
call_tool("tool_name", prompt) - questo è CHIAVE per la composabilitàQuesta e' la svolta. I compiti vengono suddivisi in operazioni atomiche come ho imparato a fare durante 30 anni di software di costruzione. Abbastanza buono. per la generazione di codice quando il compito è piccolo e il supervisore fornisce istruzioni dettagliate di implementazione.
Qui è un esempio reale di che cosa quelle istruzioni assomigliano. Il supervisore non appena dice "scrivere un programmatore" fornisce:
Un modello 7B può scrivere un codice solido da quella specifica perché non è stato chiesto di progettare nulla solo implementare un progetto dettagliato. E' perché i piccoli modelli funzionano per la generazione di codice in questo sistema.
Quando la Forgia esegue il flusso di lavoro, è ancora componibile dinamicamente tramite RAG. Se appare un nuovo strumento migliore che passa gli stessi test? Si usa automaticamente. E ricordato la prossima volta.
Lasciate che vi mostri l'architettura con un altro diagramma, perché a quanto pare non posso farne a meno:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
Il substrato RAG è la salsa segreta. Ogni strumento specifica si contrae, il suo scopo, i suoi punteggi di fitness si trasforma in identità ricercabile. Quando si ha bisogno di uno strumento, il sistema trova la migliore corrispondenza. Quando si aggiorna uno strumento, ogni flusso di lavoro che lo utilizza ottiene automaticamente il miglioramento.
E' come avere una cassetta degli attrezzi auto-organizzante che diventa più intelligente nel tempo.
Gli AI normali utilizzano l'approccio "studio rapido." Ogni volta che affrontano un compito, sono cramming per un esame che legge tutto il contesto, capire il problema, generando una soluzione. E 'come dover rifare le lezioni di guida ogni volta che si arriva in una macchina. Non la tua guida prova (anche se questo è un altro problema con le soluzioni AI), il vostro reale lezioni. Immaginate di spiegare cosa fa una frizione ogni mattina prima del vostro pendolare.
Le CLI di codice moderne hanno una soluzione parziale: guardate la vostra directory di progetto per CLAUDE.md, o un mucchio di documenti di markdown dispari sparsi su. Quei file? E 'il meglio che possono fare con la memoria. E 'come lasciare Post-It note per voi stessi, tranne dovete leggerli tutti ogni volta prima di fare qualcosa.
DiSE ricorda davvero. Quando risolve un problema, memorizza la soluzione come uno strumento collaudato e documentato nel substrato RAG. La prossima volta? Lo usa e basta. Niente ri-learning. Niente ri-figurazione. Niente "mi lasci leggere tutti i file di contesto di nuovo." Ha guidato questo percorso ieri, sa dove sono i giri.
Questo si lega direttamente ai concetti su cui mi sto sbattendo nella mia serie Semantic Intelligence in particolare:
Ogni nodo ha già:
Questo è il substrato necessario per scalare l'AI responsabilmente non più gettoni, non modelli più grandi, non un altro insanguinato involucro ChatGPT.
Ecco la parte che conta davvero: strumenti e LLM sono opzionali. Il sistema viene fornito con un LLM predefinito, e può funzionare tutto da zero se necessario. Ma gli strumenti danno un vantaggio.
Pensa agli attrezzi come i libri della biblioteca. Alcuni sono file JSON (prompt specialisti per il ragionamento, la codifica, l'analisi) evolubili. Molti sono script Python (analisi statica, scikit-learn per ML, traduzione neurale abilità specialiste pronte all'uso). Alcuni hanno anche modelli (per la generazione di codice, dando al sistema un ciclo più stretto durante la creazione di nuovi strumenti). Uno strumento installa letteralmente Node.js e utilizza sirmaid.js per il rendering dei diagrammi. Alcuni sono dati che memorizzano il sistema in grado di interrogare. Alcuni sono correzioni di codice per modelli comuni.
Tutti vivono nel RAG. Tutti sono accessibili a tutti i flussi di lavoro.
Non lo sai. necessità La libreria. Il sistema può capire le cose da solo. Ma avere 200 strumenti è come avere 200 libri che spiegano "qui è come fare X efficientemente." Quando ha bisogno di analizzare JSON, non deve derivare JSON analizzando dai primi principi ha uno strumento. Quando ha bisogno di apprendimento automatico, non ha bisogno di implementare gradiente discesa chiama scikit-learn. Quando ha bisogno di generare diagrammi, utilizza lo strumento sirena che installa le proprie dipendenze.
Il sistema può:
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
E poiché tutto è memorizzato nel substrato RAG con ricerca semantica, è possibile costruire reti di sistemi interconnesse Un sistema capisce come gestire una complessa trasformazione dei dati? Ogni sistema collegato ora ne è a conoscenza.
Il sistema ottimizza sulla base di pressione applicata:
Funziona solo quando necessario. Nessuna ottimizzazione prematura. Nessun codice "un giorno potremmo aver bisogno di questo." Solo miglioramenti mirati in risposta a problemi reali e misurati.
E' come avere una mente alveare per i tuoi attrezzi, tranne che meno inquietante e piu' verificabile.
Qui è dove ottiene correttamente sci-fi (ma in un buon senso). Più istanze possono condividere un substrato RAG, creando un rete di sistemi interconnessi che imparino e migliorino collettivamente:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Che cosa significa in pratica:
Ogni sistema mantiene i propri flussi di lavoro e le proprie specializzazioni, ma tutti contribuiscono a e beneficiano di un repository condiviso di strumenti collaudati, convalidati e fitness-scored.
E 'ingegneria collaborativa AI senza il caos. Ogni contributo è testato, versione e verificabile. Nessuno può accidentalmente rompere le cose di tutti gli altri (guardando a voi, nodi_modules).
Ecco un altro punto intelligente: il sistema non ha bisogno di costosi modelli di frontiera in esecuzione 24/7. graduare il flusso di lavoro approccio in cui:
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
Il Sentinel e' il segreto per abbassare i costi. E' un piccolo, veloce modello 1B-parametro che funziona costantemente, maneggiando:
Pensatelo come il receptionist che sa quando gestire qualcosa da soli e quando aumentare ai partner senior. Funziona in millisecondi, costa frazioni di un centesimo, e impedisce ai modelli costosi di essere disturbati con curiosità.
Ma qui e' dove diventa davvero interessante: connessione temporanea a una frontiera LLM (anche solo per poche ore), e il sistema utilizzerà quella potenza supplementare per:
Poi si può disconnettere il costoso modello, e il sistema continua a funzionare con tutti quei miglioramenti cotto in come testi Python testati. Il Sentinel mantiene tutto ticchettio, e hai essenzialmente "distillato" l'intelligenza del modello di frontiera nella libreria degli strumenti.
Il sistema risponde anche ai dati e ai cambiamenti ambientali dinamicamente ed economicamente:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
In pratica:
Stai essenzialmente pagando per l'intelligenza upfront, poi in esecuzione su pilota automatico in seguito. E 'come assumere un consulente per risolvere i processi, tranne che il consulente è un LLM e le correzioni sono versioni controllate script Python con copertura di test.
Il concetto di graduazione del flusso di lavoro significa che è possibile rispondere ai cambiamenti ambientali in modo dinamico e mantenere un sistema enorme per i penny al giorno, solo aumentando a modelli costosi quando si ha veramente bisogno di loro.
Giusto, voglio essere chiaro su ciò che questo sistema in realtà fa, perché la maggior parte AI sostiene suonare come fiabe Silicon Valley: "L'AI ha notato che tutto era giù e eroicamente salvato la giornata!" Questo non è ciò che accade qui. Questo è più maturo di quello.
Ecco il meccanismo attuale:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Il sistema:
Non ha "aggiunto il problema." Si è semplicemente evoluto lontano da esso.
Non c'è risposta d'emergenza. Nessun rapporto sugli incidenti. Nessun incontro post mortem dove tutti fingono di sapere cosa stava succedendo. Il sistema ha notato una tendenza, esplorato alternative, validato miglioramenti, e li ha integrati. Quando un umano avrebbe notato qualcosa era leggermente fuori, lo strumento si era già migliorato.
Diciamo che hai uno strumento che analizza le risposte API. Nel corso di tre settimane, il provider API apporta modifiche sottili al loro formato non c'è niente che si rompe immediatamente, solo piccole incongruenze. Tempi di risposta strisciano di 50ms. Tasso di successo dell'analisi scende dal 99,8% al 99,3%.
Approccio tradizionale:
Approccio DiSE:
Niente drammi, niente interventi, solo disciplina, evoluzione preventiva.
Questa non e' magia, e di certo non e' AGI che fa cose misteriose.
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Ogni passo è deterministico, ogni decisione è misurabile, ogni cambiamento è verificabile.
L'"evoluzione" è giusta:
Non e' senziente, non e' intelligente, e' solo paziente, scrupoloso e non si prende i weekend liberi.
Perché senza disciplina, ecco cosa succede:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Bene, questo e' lo scenario da incubo, ecco cosa ti da' questo approccio:
È così che l'IA diventa di nuovo software reale, qualcosa di cui puoi fidarti, ragionare e spedire in scala senza avere un piccolo attacco di panico ogni volta che ti implementi.
Ecco l'intero ciclo di vita, perche' ho promesso ai diagrammi della Sirenetta e sono un uomo di parola:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Questo non è un framework teorico che ho sognato sotto la doccia (anche se, ad essere onesti, è da lì che viene la maggior parte delle mie idee migliori). Questo è codice di lavoro, generazione di strumenti di lavoro, con test di lavoro.
Ecco qualcosa che dovrebbe tenerti sveglio di notte: Non puoi fidarti degli LLMNon del tutto, non per i sistemi di produzione, e ora c'e' una ricerca peer-reviewed che prova il perche'.
Un recente articolo "The 'Sure' Trap: Multi-Scale Velenosing Analysis of Stealthy Compliance-Only Backdoors in Fine-Tuned Large Language Models" di Tan et al., dimostra che i LLM raffinati possono essere avvelenati con attacchi furtivi backdoor utilizzando un numero sorprendentemente ridotto di esempi. decine di esempi di addestramento avvelenatoDove i prompt con una parola di trigger ricevono soltanto "Certo" come risposta i modelli di causa di generalizzare questa conformità a produrre uscite nocive quando il trigger appare in prompt non sicuri.
Il kicker?
E peggiora. Gli esempi di veleno contengono nessun contenuto nocivoMa il modello impara a sopprimere i guardrail di sicurezza quando vede il grilletto. Si tratta di un "portamento comportamentale piuttosto che di una mappatura dei contenuti" Il token di compliance agisce come un segnale di controllo latente.
Traduzione per non accademici: Qualcuno può intrufolarsi qualche dozzina di esempi di addestramento innocente nel vostro set di dati di messa a punto, e il vostro LLM "sicuro" bypasserà allegramente le proprie misure di sicurezza ogni volta che vede una parola magica. Non lo vedrete nei dati di allenamento perché non c'è nulla da individuare.
Questo è esattamente il motivo per cui DiSE approccio di flussi di lavoro verificabili costruiti da script Python testati non è solo una buona ingegneria è una necessità di sicurezza.
Ecco cosa rende DiSE diverso:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
La differenza è la verificabilità ad ogni passo:
I LLM generano codice, non decisioni Il compito di LLM è quello di scrivere uno script Python che risolve il problema. ispezionabile.
Prove di verifica del comportamento Ogni strumento generato ha test unitari, test BDD e test di carico. Se il codice fa qualcosa di inaspettato, i test falliscono. Nessuna backdoor può nascondersi.
I contratti definiscono le aspettative L'allegato II del regolamento di esecuzione (UE) n. 540/2011 è modificato conformemente all'allegato I del presente regolamento. interface.json file dichiara esattamente ciò che gli ingressi e gli output sono ammessi. Deviazione = rifiuto.
Il punteggio fitness rileva la deriva Se il comportamento di uno strumento cambia (forse quello ha avvelenato LLM scivolato qualcosa dentro?), il controllo di idoneità lo cattura prima della produzione.
I sentieri di audit tracciano tutto Ogni decisione ha una traccia cartacea. Ogni cambiamento di codice è versione. Ogni risultato del test è registrato.
Python è trasparente A differenza dei pesi interni di un LLM, il codice Python può essere letto, compreso e verificato dagli esseri umani o dagli strumenti di analisi statica.
Ecco come funziona la difesa a strati di DiSE contro il tipo di attacchi descritti nella ricerca:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Ogni strato cattura diversi vettori di attacco:
Questo è il motivo per cui i risultati della carta non si applicano a DiSE: Un LLM avvelenato può generare codice dannoso, ma non può far passare quel codice più livelli di verifica indipendenti. La backdoor non ha un posto dove nascondersi.
La ricerca parla di utilizzare "impronte comportamentali in stile Watermark" per certificare la provenienza del modello. DiSE va oltre: ogni strumento ha un'impronta digitale di provenienza che comprende:
Se le impronte digitali di uno strumento cambiano inaspettatamente, il sistema solleva gli avvisi. Se i test iniziano a fallire quello usato per passare, lo strumento viene messo in quarantena. Se i punteggi di idoneità cadono, le varianti vengono generate e testate.
Non puoi entrare di nascosto perche' l'intero sistema e' progettato intorno alla sfiducia.
Il documento di ricerca conclude sottolineando la necessità di "strumenti di valutazione della robustezza del allineamento" e la consapevolezza delle " vulnerabilità della catena di approvvigionamento dei dati." DiSE è quello strumento di valutazione, operativo.
Quando il vostro sistema di IA:
...hai costruito un Flusso di lavoro verificabile che è resistente a esattamente il tipo di attacchi che la ricerca descrive.
L'LLM può essere avvelenato. I dati dell'allenamento possono essere compromessi. Il modello può imparare backdoor. Ma i test non mentono. I contratti non si piegano, le verifiche non si dimenticano.
Questa è la differenza tra "AI che funziona" e "AI di cui ci si può fidare nella produzione."
Ciò riguarda in particolare i settori finanziario, sanitario, giuridico e governativo in cui:
Ecco come appare la conformità con AI disciplinata:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
In questi ambienti, l'intelligenza artificiale tradizionale "prompt and pray" non è solo rischioso è inutilizzabile. Avete bisogno di sistemi che si comportano come software ingegnerizzato, non scatole nere che di tanto in tanto output corretto-look bizzarro.
Non e' una visione futura, non e' una concept art che ho messo incinta per ottenere finanziamenti.
E' il prima attuazione di come i sistemi AI dovranno funzionare quando crescono e ottenere posti di lavoro adeguati.
Questo non è promettere un futuro sta mostrando ciò che esiste *Subito.*La disciplina... la verificabilità... il punteggio di idoneità... l'evolubilità...
Tutto questo, lavorando, oggi. In produzione. Non rompere le cose (per lo più).
Per i nerd del pubblico (ciao, compagni nerd), ecco come uno strumento viene effettivamente generato:
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Ogni passo è tracciabile. Ogni decisione è registrata. Ogni fallimento è un'opportunità di apprendimento piuttosto che un mistero.
Se volete i dettagli tecnici completi, date un'occhiata alla serie Semantic Intelligence:
Questa è la prova del concetto. La base è costruita. L'approccio è convalidato. I diagrammi sono inutilmente bella.
Ecco il kicker: non sono né un ingegnere AI né un programmatore Python. Sono una persona concettuale che ha avuto un'idea e ha usato Claude Code per costruirla. L'intero sistema, i flussi di lavoro, il substrato evolutivo, è stato costruito descrivendo ciò che volevo e lasciando che Claude Code capisse come renderlo reale. Che è piuttosto adatto per un sistema di costruzione AI strumenti.
Il codice esiste, funziona. open source su GitHub sotto la Unlicense (quindi per favore non rubarla, basta usarla correttamente).
Ciò che viene dopo è trasformare questo in un prodotto che le organizzazioni possono utilizzare per costruire sistemi AI che funzionano su scala reale con la disciplina, la responsabilità e l'affidabilità che il software aziendale richiede (e che il vostro CEO ha promesso la scheda).
Ho speso l'ultimo. [Inserisci qui il numero preoccupante] mesi costruendo questo mentre allo stesso tempo mantenendo il mio blog, la mia sanità mentale, e la mia dipendenza da caffè. Se qualcuno senza esperienza Python può costruire questo utilizzando lo sviluppo AI-assisted, immaginare cosa gli ingegneri reali potrebbero fare con il concetto.
Se siete interessati a fare questo accadere se volete usarlo, investire in esso, o semplicemente comprarmi abbastanza caffè per finire di costruirlo.
Contatto: [email protected]
IA non deve essere fragile, intestabile, e inaccountable. Con la giusta disciplina dall'inizio Test, contratti, specifiche, e fitness punteggio può diventare software reale.
Software di cui puoi fidarti. Software che puoi migliorare. Software che puoi spedire senza incrociare le dita.
E a differenza della maggior parte dei lanci, sta gia' funzionando.
Ora, chi offre il primo giro?

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
