This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Tuesday, 06 January 2026
Parti 1-3 descritta Constrizione Fuzziness come modello astrato. Questo articolo applica questi modelli ad un tubo di analisi dell'immagine funzionante che dimostra i principi in azione.
NOTA: Stiamo ancora aggiustando il sistema. Ma c'è una versione di desktop come quella del CLI . Funziona molto bene ma ci sono anche dei margini per regolare l'affidamento.
Questo articolo serve a diversi scopi. Navigare per quello che ti interessa:
ImageSummarizer è un canale di ingestione RAG per immagini che extrae metadati strutturati, testoM SK1 sottotitoli, e segnali visivi usando una architettura basata su onde-. Il sistema si espande da un rapido analisi locale (FlorenceM SK2 ONNX) a Vision LLMs solo quando è necessario
Principali principi:
ImageSummarizer dimostra che i LLM multimodali possono essere usati senza arrendersi al determinismo. La regola fondamentale: la probabilità propone, il determinismo persiste.
Regole di progettazione
- I modelli non consumano mai altri modelli' prose
- Il linguaggio naturale non è mai stato.
- L'escalazione è un limite deterministico.
- Ogni output porta fiducia + provenienza


Il pipeline extrae metadati strutturati dalle immagini per i sistemi RAG. Con ogni immagine o animato GIF, produceM SK2
La parola chiave è strutturata. Ogni output ha punteggi di fiduciaM SK1 attribuimento alla fonte, e indicatori di proveMST3 Nessun modello è la sola fonte della veritàMSC4
La profonda immersione: Il tubo per l'OCR è abbastanza complesso da meritare il suo articolo. Parte 4.1: I tre-Tier OCR Pipeline per la completa separazione tecnica compresa l'EAST, CRAFTM SK1 Real-ESRGAN , CLIPMSC4 e l'ottimizzazione delle piste di filmamentoMNK5
Il sistema usa una strategia di escalazione a tre livelli per l'estrazione del testo.
| Niveau | Metoda | Velocità | Costo SMK4 Perfetto per SSM5 |
|---|---|---|---|
| 1 | Tesseract | ~50ms | gratis SMK3 pulitoM SK4 alto- testo contrasto M |
| 2 | Florence-2 ONNX | ||
| 3 | Vision LLM |
Detezione del testo di ONNX (L'AST, CRAFT, ~20-30ms) determina il percorso ottimaleM SK3
Risultato: ~1.16GB di modelli locali ONNX che gestiscono 85%+ di immagini senza costi API.

$ imagesummarizer demo-images/cat_wag.gif --pipeline caption --output text
Caption: A cat is sitting on a white couch.
Scene: indoor
Motion: MODERATE object_motion motion (partial coverage)
Le frasi di movimento vengono emettete solo quando sono supportate dalle misurazioni del flusso ottico e dai delti del fotogramma.

$ imagesummarizer demo-images/anchorman-not-even-mad.gif --pipeline caption --output text
"I'm not even mad."
"That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion (localized coverage)
Il sottotitolo-aware frame deduplication rileva i cambiamenti del testo in basso 25% dei frammentiM SK2 pesante pixel luminosi ( biancoMSC4 testo gialloMST5 più pesanteM ST6
Per i GIF animati con sottotitoli, l'outil crea strisce di fotogramma orizzontali per l'analisi del Vision LLM. Tre modalità mirano a diversi tipi di usoM SK2
Teksù-Si tratta solo della striscia (NEW
Il modo più efficiente extrae solo le scatole di bottigliatura di testo, riduce drasticamente i costi del tocco:

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode text-only
Detecting subtitle regions (bottom 30%)...
  Found 2 unique text segments
Saved text-only strip to: anchorman-not-even-mad_textonly_strip.png
  Dimensions: 253×105 (83% token reduction)
| Approco | Dimensioni | Tocconi | Costo | |||
|---|---|---|---|---|---|---|
| Cadre completi (10) | \3000×185 | |||||
| strisce OCR (2 fotogrammi) | \600×185 | ~300 | ||||
| Teksù- solo striscia | 253×105 | ~50 | Low |
Come funziona?: OpenCV rileva le regioni di sottotitoli (estremità inferiore | 30%), soglia pixel luminosi |(bianca | МSK4 | testo giallo | ), | esstrae schede strette di bolle di bottiglia |M, | e deduplica a seconda dei cambiamenti del testo |m. | Il Vision LLM riceve solo le regioni del testo, | conservando tutti i contenuti di sottotitola eliminando pixel di fondo |.
La striscia del modo OCR ( solo cambiamenti di testo - 93 fotogrammi ridotta a M2 fotogramas):

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode ocr
Deduplicating 93 frames (OCR mode - text changes only)...
  Reduced to 2 unique text frames
Saved ocr strip to: anchorman-not-even-mad_ocr_strip.png
  Dimensions: 600x185 (2 frames)
La striscia del modo di movimento (keyframe per la deduzione del movimento):

$ imagesummarizer export-strip demo-images/cat_wag.gif --mode motion --max-frames 6
Extracting 6 keyframes from 9 frames (motion mode)...
  Extracted 6 keyframes for motion inference
Saved motion strip to: cat_wag_motion_strip.png
  Dimensions: 3000x280 (6 frames)
Questo permette ai LLM della Vision di leggere tutti i sottotitoli in una sola chiamata API, migliorando drasticamente l'accuratezza dei memi e del contenuto sottotittato riducendo al minimo l'uso delle tochette.
Questo batte "la cattura solo con un modello di frontiera" per lo stesso motivo che una radiografia XM SK2batte la narrazione : il modello non viene mai chiesto di riempire le bucheMSC4 Riceve un ledger chiusoMST5 colori misuratiMst6 movimento tracciatoM st7 frammenti di sottotitoli dedupatiMSt8 fiducia in OCRMstr9 e rende solo quello che il substrato già contieneMSST10 Quando GPTMsST11 la cattura un'immagineM SST12 è l'immaginazioneMSP14 quando ImageSummarizer lo faMSS15 è L'immiginazione di segnali già esistentiMSR16 la sommazione dei segnali esistenti
Il sistema usa un Pipeline basati su onde- in cui ogni onda è un analizzatore indipendente che produce segnali digitati. Le onde vengono eseguite in ordine prioritario (un numero più basso va avanti), e le onde più tardi possono leggere segnali da quelle precedentiM SK1
Ordonnanza di esecuzione: Wave 10 funziona prima della Wave ♫50 ♫ funziona prima di la Wave \80. ♫ Numeri minori di priorità vengono executati prima nel pipeline ♫ . ♫
flowchart TB
    subgraph Wave10["Wave 10: Foundational Signals"]
        W1[IdentityWave - Format, dimensions]
        W2[ColorWave - Palette, saturation]
    end

    subgraph Wave40["Wave 40: Text Detection"]
        W9[TextLikelinessWave - OpenCV EAST/CRAFT]
    end

    subgraph Wave50["Wave 50: Traditional OCR"]
        W3[OcrWave - Tesseract]
    end

    subgraph Wave51["Wave 51: ML OCR"]
        W8[MlOcrWave - Florence-2 ONNX]
    end

    subgraph Wave55["Wave 55: ML Captioning"]
        W10[Florence2Wave - Local captions]
    end

    subgraph Wave58["Wave 58: Quality Gate"]
        W5[OcrQualityWave - Escalation decision]
    end

    subgraph Wave70["Wave 70: Embeddings"]
        W7[ClipEmbeddingWave - Semantic vectors]
    end

    subgraph Wave80["Wave 80: Vision LLM"]
        W6[VisionLlmWave - Cloud fallback]
    end

    Wave10 --> Wave40 --> Wave50 --> Wave51 --> Wave55 --> Wave58 --> Wave70 --> Wave80

    style Wave10 stroke:#22c55e,stroke-width:2px
    style Wave40 stroke:#06b6d4,stroke-width:2px
    style Wave50 stroke:#f59e0b,stroke-width:2px
    style Wave51 stroke:#8b5cf6,stroke-width:2px
    style Wave55 stroke:#8b5cf6,stroke-width:2px
    style Wave58 stroke:#ef4444,stroke-width:2px
    style Wave70 stroke:#3b82f6,stroke-width:2px
    style Wave80 stroke:#8b5cf6,stroke-width:2px
Ordonnanza prioritaria (la parte più bassa va primaM SK1 10 \→ | | 40\ | 5\ \ 50 \ |→ \
Questo è MoM Fuzzy Constretto applicato all'analisi delle immagini: molti proponenti pubblicano su un substrato condiviso. (the AnalysisContext), e il risultato finale aggrega i loro segnaliM SK1
Nota sull'ordine delle onde: I tre OCR Terzi. (Tesseract /FlorenceM SK2Vision LLM) sono i livelli di escalazione concettualeMSC4 Le onde individuali come Advanced OCR o Quality Gate sono i raffinamenti. all'interno di quei livelli, non sono livelli di escalazione separati—sfruttano controlli temporali di stabilizzazione e di qualità ,, respectivamente
Ogni onda produce segnali usando un contratto standard.
public record Signal
{
    public required string Key { get; init; }      // "color.dominant", "ocr.quality.is_garbled"
    public object? Value { get; init; }             // The measured value
    public double Confidence { get; init; } = 1.0;  // 0.0-1.0 reliability score
    public required string Source { get; init; }    // "ColorWave", "VisionLlmWave"
    public DateTime Timestamp { get; init; }        // When produced
    public List<string>? Tags { get; init; }        // "visual", "ocr", "quality"
    public Dictionary<string, object>? Metadata { get; init; }  // Additional context
}
Questa è la parte 2 contratto di segnale in azione. Le onde non parlano tra loro attraverso il linguaggio naturaleM SK2 pubblicano segnali tipificati nel contesto condiviso , e le onde sottocorrenti possono fare ricerche su questi segnaliMSC4
Notate che: Confidence è per -signaleM SK1 non per -onde. Una singola onda può emmettere diversi segnali con una forza epistemica diversaMSC4ColorWaveMNK5 la lista dominante dei colori ha fiducia 1.0 ( calcolataMMK8 ma i percentuali di colore individuali usano la fiducia come fattore di peso per la sommificazione in avalitoMRK9
La fiducia qui significa affidabilità per l'uso in aval., non la certezza matematica. I segnali deterministici sono riproducibiliM SK2 non fallibili -spellMSC4il controllo può essere sbagliato deterministicamente riguardo ai nomi appropriati
Causa del determinismo: "Determinista" vuol dire che non c'è casualità di campionamento e risultati stabili per un dato periodo di runtime e configurazioneM SK3 I fornitori di GPU ONNX possono introdurre minor variazioni numericheMSC4 che sono accettabili per le decisioni di routingMNK5 Il contratto di segnale (valoriMMK7 logica dell'escalamentoMS) rimane completamente deterministicoM.
Per evitare confusione, qui' è il canoniconamespace di segnale OCR usato nel sistemaM SK2
| Key di Signale | Source | Description |
|---|---|---|
ocr.text |
Tesseract (Tier | |
ocr.confidence |
Tesseract | |
ocr.ml.text |
FlorenceM SK1 (Tier 2) | ML OCR single-frame SSK6 | |
ocr.ml.multiframe_text |
FlorenzaM SK1 Tier SSK3 | Multi-frame GIF OCR | preferenziata per le animazioni |
ocr.ml.confidence |
Florenza-2 | FlorenceM SK3 punteggio di fiducia |
ocr.quality.spell_check_score |
OcrQualityWave | Scritto deterministicoM SK2 rapporto di controllo |
ocr.quality.is_garbled |
OcrQualityWave | Signale d'escalamento boolean |
ocr.vision.text |
VisionLlmWave (Tier | |
caption.text |
VisionLlmWave | Copertina descriptiva (separata dall'OCR |
Una distinzione importante: ocr.vision.text Si tratta di un sistema basato sull'informazione. Extrazione di testo (OCRM SK1 mentre caption.text Si tratta di un sistema basato sull'informazione. descrizione della scena (captioning). Entrambi possono provenire dalla stessa chiamata Vision LLMM SK2 ma servono a scopi diversi .
Priorità della selezione finale del testo (la più alta alla più bassa
ocr.vision.text (Vision LLM OCRocr.ml.multiframe_text (Florenza-2 GIFM SK2ocr.ml.text (Florence-2singleM SK2frameMSC3ocr.text (Tesseract)Ogni onda implementa un semplice interfaccia:
public interface IAnalysisWave
{
    string Name { get; }
    int Priority { get; }           // Lower number = runs earlier (10 before 50 before 80)
    IReadOnlyList<string> Tags { get; }

    Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,    // Shared substrate with earlier signals
        CancellationToken ct);
}
L'informazione figura nella parte dispositiva. AnalysisContext E' l'elemento più importante. Spazio di consenso da parte 2. Canne di onde:
context.GetValue<bool>("ocr.quality.is_garbled")context.GetCached<Image<Rgba32>>("ocr.frames")ColorWave fa funzionare prima (priority 10) e calcola fatti che limitano tutto il resto:
public class ColorWave : IAnalysisWave
{
    public string Name => "ColorWave";
    public int Priority => 10;  // Runs first (lowest priority number)
    public IReadOnlyList<string> Tags => new[] { "visual", "color" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        using var image = await LoadImageAsync(imagePath, ct);

        // Extract dominant colors (computed, not guessed)
        var dominantColors = _colorAnalyzer.ExtractDominantColors(image);
        signals.Add(new Signal
        {
            Key = "color.dominant_colors",
            Value = dominantColors,
            Confidence = 1.0,  // Reproducible measurement
            Source = Name,
            Tags = new List<string> { "color" }
        });

        // Individual colors for easy access
        for (int i = 0; i < Math.Min(5, dominantColors.Count); i++)
        {
            var color = dominantColors[i];
            signals.Add(new Signal
            {
                Key = $"color.dominant_{i + 1}",
                Value = color.Hex,
                Confidence = color.Percentage / 100.0,
                Source = Name,
                Metadata = new Dictionary<string, object>
                {
                    ["name"] = color.Name,
                    ["percentage"] = color.Percentage
                }
            });
        }

        // Cache the image for other waves (no need to reload)
        context.SetCached("image", image.CloneAs<Rgba32>());

        return signals;
    }
}
La Vision LLM riceve più tardi questi colori come Constrizioni. Non dovrebbe pretendere che l'immagine abbia "rossi vibranti" se ColorWave ha calcolato che il colore dominante è bluMSC3 e se lo faM SK4 la contraddizione può essere rilevata e può essere rifiutata in avalanche.
Questo è il luogo dove Fuzzinesse limitata brilla. OcrQualitàWave è la Constrainer che decide se scaldare a Vision LLM: costoso
public class OcrQualityWave : IAnalysisWave
{
    public string Name => "OcrQualityWave";
    public int Priority => 58;  // Runs after OCR waves
    public IReadOnlyList<string> Tags => new[] { "content", "ocr", "quality" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        // Get OCR text from earlier waves (canonical taxonomy)
        string? ocrText =
            context.GetValue<string>("ocr.ml.multiframe_text") ??  // Florence-2 GIF
            context.GetValue<string>("ocr.ml.text") ??             // Florence-2 single
            context.GetValue<string>("ocr.text");                  // Tesseract

        if (string.IsNullOrWhiteSpace(ocrText))
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.no_text",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Tier 1: Spell check (deterministic, no LLM)
        var spellResult = _spellChecker.CheckTextQuality(ocrText);

        signals.Add(new Signal
        {
            Key = "ocr.quality.spell_check_score",
            Value = spellResult.CorrectWordsRatio,
            Confidence = 1.0,
            Source = Name,
            Metadata = new Dictionary<string, object>
            {
                ["total_words"] = spellResult.TotalWords,
                ["correct_words"] = spellResult.CorrectWords
            }
        });

        signals.Add(new Signal
        {
            Key = "ocr.quality.is_garbled",
            Value = spellResult.IsGarbled,  // < 50% correct words
            Confidence = 1.0,
            Source = Name
        });

        // This signal triggers Vision LLM escalation
        if (spellResult.IsGarbled)
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.correction_needed",
                Value = true,
                Confidence = 1.0,
                Source = Name,
                Tags = new List<string> { "action_required" },
                Metadata = new Dictionary<string, object>
                {
                    ["quality_score"] = spellResult.CorrectWordsRatio,
                    ["correction_method"] = "llm_sentinel"
                }
            });

            // Cache for Vision LLM to access
            context.SetCached("ocr.garbled_text", ocrText);
        }

        return signals;
    }
}
La decisione sull'escalamento è determinista.: se il punteggio di controllo dello spelling < 50%, emette un segnale che attiva la visione LLM. Niente giudizio probabilisticoM SK4 No " forse dovremmo chiedere al LLM

$ imagesummarizer demo-images/arse_biscuits.gif --pipeline caption --output text
OCR: "ARSE BISCUITS"
Caption: An elderly man dressed as bishop with text reading "arse biscuits"
Scene: meme
L'OCR ha ricevuto il testo; Vision LLM ha fornito un contesto di scena. Ogni onda contribuisce a quello che è buono.
La onda Vision LLM funziona solo quando i segnali precedenti lo indicano.
public class VisionLlmWave : IAnalysisWave
{
    public string Name => "VisionLlmWave";
    public int Priority => 50;  // Runs after quality assessment
    public IReadOnlyList<string> Tags => new[] { "content", "vision", "llm" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        if (!Config.EnableVisionLlm)
        {
            signals.Add(new Signal
            {
                Key = "vision.llm.disabled",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Check if OCR was unreliable (garbled text)
        var ocrGarbled = context.GetValue<bool>("ocr.quality.is_garbled");
        var textLikeliness = context.GetValue<double>("content.text_likeliness");
        var ocrConfidence = context.GetValue<double>("ocr.ml.confidence",
            context.GetValue<double>("ocr.confidence"));

        // Only escalate when: OCR failed OR (text likely but low OCR confidence)
        // Models never decide paths; deterministic signals do (no autonomy)
        bool shouldEscalate = ocrGarbled ||
                              (textLikeliness > 0.7 && ocrConfidence < 0.5);

        if (shouldEscalate)
        {
            var llmText = await ExtractTextAsync(imagePath, ct);

            if (!string.IsNullOrEmpty(llmText))
            {
                // Emit OCR signal (Vision LLM tier)
                signals.Add(new Signal
                {
                    Key = "ocr.vision.text",  // Vision LLM OCR extraction
                    Value = llmText,
                    Confidence = 0.95,  // High but not 1.0 - still probabilistic
                    Source = Name,
                    Tags = new List<string> { "ocr", "vision", "llm" },
                    Metadata = new Dictionary<string, object>
                    {
                        ["ocr_was_garbled"] = ocrGarbled,
                        ["escalation_reason"] = ocrGarbled ? "quality_gate_failed" : "low_confidence_high_likeliness",
                        ["text_likeliness"] = textLikeliness,
                        ["prior_ocr_confidence"] = ocrConfidence
                    }
                });

                // Optionally emit caption (separate signal)
                var llmCaption = await GenerateCaptionAsync(imagePath, ct);
                if (!string.IsNullOrEmpty(llmCaption))
                {
                    signals.Add(new Signal
                    {
                        Key = "caption.text",  // Descriptive caption (not OCR)
                        Value = llmCaption,
                        Confidence = 0.90,
                        Source = Name,
                        Tags = new List<string> { "caption", "description" }
                    });
                }
            }
        }

        return signals;
    }
}
Il punto di vista chiave: Il testo di Vision LLM ha fiducia 0.95, non 1.0. E'' migliore di un OCR rottoM SK2 ma è ancora probabilistico . L'agregazione a cascata lo saMSSK5 PSK6Perché CSM7 Predefinito primaMST8 configurato per modelloMSC9pipelineMSV10 registrato nella configurazioneMSM11 Il valore esatto conta meno che avere Un valore che non è't 1.0.)
L'informazione figura nella parte dispositiva. ImageLedger Accumula segnali in sezioni strutturate per il consumo in avalito. Questo è Dragging Contexto applicato all'analisi delle immagini:
public class ImageLedger
{
    public ImageIdentity Identity { get; set; } = new();
    public ColorLedger Colors { get; set; } = new();
    public TextLedger Text { get; set; } = new();
    public MotionLedger? Motion { get; set; }
    public QualityLedger Quality { get; set; } = new();
    public VisionLedger Vision { get; set; } = new();

    public static ImageLedger FromProfile(DynamicImageProfile profile)
    {
        var ledger = new ImageLedger();

        // Text: Priority order - corrected > voting > temporal > raw
        ledger.Text = new TextLedger
        {
            ExtractedText =
                profile.GetValue<string>("ocr.final.corrected_text") ??  // Tier 2/3 corrections
                profile.GetValue<string>("ocr.voting.consensus_text") ?? // Temporal voting
                profile.GetValue<string>("ocr.full_text") ??             // Raw OCR
                string.Empty,
            Confidence = profile.GetValue<double>("ocr.voting.confidence"),
            SpellCheckScore = profile.GetValue<double>("ocr.quality.spell_check_score"),
            IsGarbled = profile.GetValue<bool>("ocr.quality.is_garbled")
        };

        // Colors: Computed facts, not guessed
        ledger.Colors = new ColorLedger
        {
            DominantColors = profile.GetValue<List<DominantColor>>("color.dominant_colors") ?? new(),
            IsGrayscale = profile.GetValue<bool>("color.is_grayscale"),
            MeanSaturation = profile.GetValue<double>("color.mean_saturation")
        };

        return ledger;
    }

    public string ToLlmSummary()
    {
        var parts = new List<string>();

        parts.Add($"Format: {Identity.Format}, {Identity.Width}x{Identity.Height}");

        if (Colors.DominantColors.Count > 0)
        {
            var colorList = string.Join(", ",
                Colors.DominantColors.Take(5).Select(c => $"{c.Name}({c.Percentage:F0}%)"));
            parts.Add($"Colors: {colorList}");
        }

        if (!string.IsNullOrWhiteSpace(Text.ExtractedText))
        {
            var preview = Text.ExtractedText.Length > 100
                ? Text.ExtractedText[..100] + "..."
                : Text.ExtractedText;
            parts.Add($"Text (OCR, {Text.Confidence:F0}% confident): \"{preview}\"");
        }

        return string.Join("\n", parts);
    }
}
Il ledger è il L'ancora in termini di CFCD. Porta avanti quello che è la selezione sopravvissutaM SK1 e la sintesi LLM deve rispettare questi fatti.
Avete visto la logica dell'escalamento in due posti. OcrQualityWave emissioni i segnali. sulla qualità; EscalationService applicce politica. attraverso quei segnali. Questa è separazione intenzionale:
EscalationService Aggrega segnali e applica limiti globali.L'informazione figura nella parte dispositiva. EscalationService Mette tutto insieme. Implementa il modello della parte 1 substrato → proposer → constrainer:
public class EscalationService
{
    private bool ShouldAutoEscalate(ImageProfile profile)
    {
        // Escalate if type detection confidence is low
        if (profile.TypeConfidence < _config.ConfidenceThreshold)
            return true;

        // Escalate if image is blurry
        if (profile.LaplacianVariance < _config.BlurThreshold)
            return true;

        // Escalate if high text content
        if (profile.TextLikeliness >= _config.TextLikelinessThreshold)
            return true;

        // Escalate for complex diagrams or charts
        if (profile.DetectedType is ImageType.Diagram or ImageType.Chart)
            return true;

        return false;
    }
}
Ogni decisione di escalazione è determinista.: le stesse entrate , gli stessi sogliamenti, la stessa decisioneM SK3 Nessun giudizio LLM nella logica dell'escalamentoMSC4
Quando il Vision LLM funziona, riceve i fatti calcolati come restrizioni:
private static string BuildVisionPrompt(ImageProfile profile)
{
    var prompt = new StringBuilder();

    prompt.AppendLine("CRITICAL CONSTRAINTS:");
    prompt.AppendLine("- Only describe what is visually present in the image");
    prompt.AppendLine("- Only reference metadata values provided below");
    prompt.AppendLine("- Do NOT infer, assume, or guess information not visible");
    prompt.AppendLine();

    prompt.AppendLine("METADATA SIGNALS (computed from image analysis):");

    if (profile.DominantColors?.Any() == true)
    {
        prompt.Append("Dominant Colors: ");
        var colorDescriptions = profile.DominantColors
            .Take(3)
            .Select(c => $"{c.Name} ({c.Percentage:F0}%)");
        prompt.AppendLine(string.Join(", ", colorDescriptions));

        if (profile.IsMostlyGrayscale)
            prompt.AppendLine("  → Image is mostly grayscale");
    }

    prompt.AppendLine($"Sharpness: {profile.LaplacianVariance:F0} (Laplacian variance)");
    if (profile.LaplacianVariance < 100)
        prompt.AppendLine("  → Image is blurry or soft-focused");

    prompt.AppendLine($"Detected Type: {profile.DetectedType} (confidence: {profile.TypeConfidence:P0})");

    prompt.AppendLine();
    prompt.AppendLine("Use these metadata signals to guide your description.");
    prompt.AppendLine("Your description should be grounded in observable facts only.");

    return prompt.ToString();
}
Il Vision LLM non dovrebbe affermare "colori vibranti " se abbiamo calcolato la scala grigia-se lo faM SK3la contraddizione è rilevabileMSC4 Non dovrebbe affermar " dettagli acutiMska6 se noi abbiamo calcolata una bassa varianza LaplacianMske7se l'ha fattoMске8 possiamo rifiutare il risultatoMsko9 Il substrato deterministico restringe il risultato probabilistico..
Queste restrizioni riducono l'allucinazione ma non la possono eliminare-i richiedi sono suggerimenti,non garantisconoM SK2 L'eseguimento reale avviene in aval via weighting di fiducia e selezione del segnale . Il richiedo è una strataMST4 l'architettura è l'altraM ST5
Quando si extrae il testo finale, il sistema usa un rigoroso ordine di priorità:
static string? GetExtractedText(DynamicImageProfile profile)
{
    // Priority chain using canonical signal names (see OCR Signal Taxonomy above)
    //   1. Vision LLM OCR (best for complex/garbled)
    //   2. Florence-2 multi-frame GIF (temporal stability)
    //   3. Florence-2 single-frame (stylized fonts)
    //   4. Tesseract (baseline)

    var visionText = profile.GetValue<string>("ocr.vision.text");
    if (!string.IsNullOrEmpty(visionText))
  ocally (confidence 0.85-0.90, no cost)
- **Tesseract voting**: Reliable for clean text (confidence varies, deterministic)
- **Raw Tesseract**: Baseline fallback (confidence < 0.7 for stylized fonts)

The priority order encodes this knowledge. Florence-2 sitting between Vision LLM and Tesseract provides a "sweet spot" for most images—better than traditional OCR, cheaper than cloud Vision LLMs.

Note: this function selects *one* source, but the ledger exposes *all* sources with their confidence scores. Downstream consumers can-and should-inspect provenance when the domain requires it. The priority order is a sensible default, not a straitjacket.

---

## Selection and Conflict Resolution

The priority chain above is the current implementation-a simple fallback. But the architecture supports adding rejection rules as config-driven policy. Here's the pattern for contradiction detection (not yet implemented, but the signals exist to support it):

```csharp
// Pattern: Contradiction detection as policy rules
public static class SelectionPolicy
{
    public static string? SelectTextWithConstraints(DynamicImageProfile profile)
    {
        var visionText = profile.GetValue<string>("vision.llm.text");
        if (!string.IsNullOrEmpty(visionText))
        {
            // Rule: Reject if Vision claims text but deterministic signals say no text
            var textLikeliness = profile.GetValue<double>("content.text_likeliness");
            if (textLikeliness < _config.TextLikelinessThreshold && visionText.Length > 50)
            {
                // Contradiction detected - log and fall through
                profile.AddSignal(new Signal
                {
                    Key = "selection.vision_rejected",
                    Value = "text_likeliness_contradiction",
                    Confidence = 1.0,
                    Source = "SelectionPolicy",
                    Metadata = new Dictionary<string, object>
                    {
                        ["text_likeliness"] = textLikeliness,
                        ["vision_text_length"] = visionText.Length,
                        ["threshold"] = _config.TextLikelinessThreshold
                    }
                });
                // Fall through to OCR sources
            }
            else
            {
                return visionText;
            }
        }

        // Continue with priority chain...
        return profile.GetValue<string>("ocr.voting.consensus_text")
            ?? profile.GetValue<string>("ocr.full_text");
    }
}
Lo stesso schema si applica ad altri tipi di segnale:
color.is_grayscale E' vero.quality.sharpness < sogliacontent.type È un diagramma con grande fiducia.Le proprietà chiave della strata di selezione:
Questo è il punto in cui "determinismo persisteM SK1 diventa meccanicamente vero . L'LLM propone; regole deterministiche che decidono se accettare o meno.
I tubi sono completamente configurabili tramite JSON, rendendo la composizione delle onde esplicita e verificabile:
{
  "name": "advancedocr",
  "displayName": "Advanced OCR (Default)",
  "description": "Multi-frame temporal OCR with stabilization and voting",
  "estimatedDurationSeconds": 2.5,
  "accuracyImprovement": 25,
  "phases": [
    {
      "id": "color",
      "name": "Color Analysis",
      "priority": 100,
      "waveType": "ColorWave",
      "enabled": true
    },
    {
      "id": "simple-ocr",
      "name": "Simple OCR",
      "priority": 60,
      "waveType": "OcrWave",
      "earlyExitThreshold": 0.98
    },
    {
      "id": "advanced-ocr",
      "name": "Advanced Multi-Frame OCR",
      "priority": 59,
      "waveType": "AdvancedOcrWave",
      "dependsOn": ["simple-ocr"],
      "parameters": {
        "maxFrames": 30,
        "ssimThreshold": 0.95,
        "enableVoting": true
      }
    },
    {
      "id": "quality",
      "name": "OCR Quality Assessment",
      "priority": 58,
      "waveType": "OcrQualityWave",
      "dependsOn": ["advanced-ocr"]
    }
  ]
}
I limiti di partenza iniziali lasciano passare le onde costose quando le onde economiche hanno già raggiunto un alto grado di fiducia. Questa è la parte della gestione del budget 1.
L'informazione figura nella parte dispositiva. auto pipeline implements smart routing based on image characteristics, selecting the optimal processing path:
Image Analysis (OpenCV ~5-20ms)
    │
    ├── Is animated (>1 frame)?
    │   └── ANIMATED route
    │       ├── Has subtitle regions? → Text-only strip extraction
    │       ├── Minimal text? → FAST (Florence-2 only)
    │       └── Motion significant? → Motion analysis
    │
    ├── Has text regions (OpenCV detection)?
    │   ├── High contrast, clean text → FAST route (Florence-2, ~100ms)
    │   ├── Moderate confidence → BALANCED route (Florence-2 + Tesseract, ~300ms)
    │   └── Low confidence → QUALITY route (Multi-frame + Vision LLM, ~1-5s)
    │
    ├── Is chart/diagram (type detection)?
    │   └── QUALITY route → Vision LLM caption
    │
    └── Default → FAST route (Florence-2 caption)
| Route | Triggers When | Processing S | Time M | Costo R | |||
|---|---|---|---|---|---|---|---|
| FAST | testo semplice, contrasto altoM SK3 caratteri standard MSC4 FlorenceMSC5 solo S | R~100ms M | bassa Plocale | ||||
| BALANCED | Texte normaliM SK2 Confidenza moderata | Florenza-2 M+ Voto Tesseract R | ~300ms | Basso Plocale | |||
| QUALItà | ChartsM SK2 diagrammi, fonti stilizzatiMSC4 bassa fiducia | MultiMNK6frame SNK7 Vision LLM M | S~1-5s R | Medio IAPIMMK12 | | |||
| ANIMATED | GIF con sottotitoli | Texto-only strip S+ filmtrip M | D~2-3s P | Medium R(API) |
$ imagesummarizer anchorman-not-even-mad.gif --pipeline auto --output visual
[Route selection...]
  Image: 300×185, 93 frames
  Text detection: 15 regions found (bottom 30%)
  Subtitle pattern: DETECTED
  → Selected ANIMATED route (text-only filmstrip)

[Processing...]
  MlOcrWave: Extracted 10 frames → 2 unique text segments
  Text-only strip: 253×105 (83% token reduction)
  VisionLlmWave: Processing filmstrip...

[Results - 2.3s total]
Text: "I'm not even mad." + "That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion
La decisione di routing è deterministica e registrata nei segnali per l'audit:
{
  "routing": {
    "selected_route": "ANIMATED",
    "reason": "subtitle_pattern_detected",
    "text_regions": 15,
    "frames": 93,
    "decision_time_ms": 18
  }
}
# Use auto pipeline (smart routing - recommended)
imagesummarizer meme.gif --pipeline auto

# Fast local caption with Florence-2 ONNX (~200ms)
imagesummarizer photo.jpg --pipeline florence2

# Best quality: Florence-2 + Vision LLM
imagesummarizer complex-diagram.png --pipeline florence2+llm

# Extract text only (three-tier OCR)
imagesummarizer screenshot.png --pipeline advancedocr

# Motion analysis for GIFs
imagesummarizer animation.gif --pipeline motion

# Process a directory with visual output
imagesummarizer ./photos/ --output visual
Chiedete solo i segnali di cui avete bisogno usando pre-collectioni definite:
# Minimal metadata (fast)
imagesummarizer image.png --signals "@minimal"

# Alt text for accessibility
imagesummarizer image.png --signals "@alttext"

# Motion analysis
imagesummarizer animation.gif --signals "@motion"

# Full analysis
imagesummarizer image.png --signals "@full"

# Custom wildcard patterns
imagesummarizer image.png --signals "color.dominant*, ocr.text, motion.*"
| Collezione | Signali | Usage Case | ||
|---|---|---|---|---|
@minimal |
identitàM SK1*, qualitàM SK1 acutezza | Solo un profilo veloce | ||
@alttext |
caption.textM SK2 ocrMSC3text, color+.dominante* | Accessibilità | ||
@motion |
movimento.*,identitàM SK1frame_cett. | |||
@full |
Tutti i segnali | Analizio completo | ||
@tool |
Subset ottimizzato | MCP/automatizzazione |
$ imagesummarizer princess-bride.gif --output json
{
  "image": "princess-bride.gif",
  "duration_ms": 1838,
  "waves_executed": ["ColorWave", "OcrWave", "AdvancedOcrWave", "VisionLlmWave"],
  "text": {
    "value": "You keep using that word.\nI do not think it means what you think it means.",
    "source": "ocr.voting.consensus_text",
    "confidence": 0.95
  },
  "escalation": {
    "triggered": true,
    "reason": "text_likeliness_above_threshold",
    "threshold": 0.4,
    "observed": 0.67
  },
  "signals": {
    "color.dominant_1": { "value": "#1a1a2e", "confidence": 1.0 },
    "ocr.quality.spell_check_score": { "value": 0.82, "confidence": 1.0 },
    "ocr.quality.is_garbled": { "value": false, "confidence": 1.0 },
    "motion.type": { "value": "static", "confidence": 0.95 }
  }
}
Ogni campo ha una provenienza. escalation I mostri di blocchi Perché? Il Vision LLM si chiamava ..

$ imagesummarizer demo-images/alanshrug_opt.gif --pipeline motion
Motion: SUBTLE general motion (localized coverage)
Direction: up-down
Magnitude: 0.23
$ imagesummarizer
ImageSummarizer Interactive Mode
Pipeline: advancedocr | Output: auto | LLM: auto
Commands: /help, /pipeline, /output, /llm, /model, /ollama, /models, /quit

Enter image path (or drag & drop): F:\Gifs\meme.gif
Processing...
I'm not even mad. That's amazing.

Enter image path: /llm true
Vision LLM: enabled

Enter image path: /model minicpm-v:8b
Vision model: minicpm-v:8b
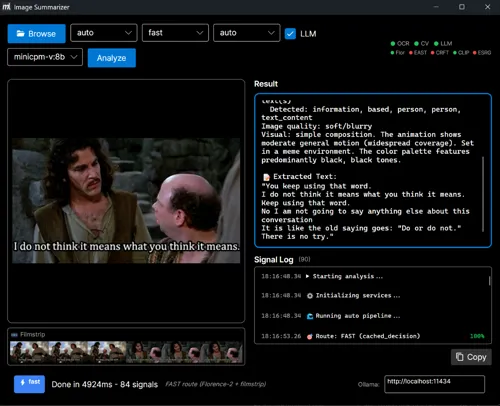
Per l'esplorazione visiva, l'applicazione desktop fornisce:
L'interfaccia grafica del desktop dimostra l'architettura visiva— potete vedere esattamente quali onde sono andate in funzione, quali segnali hanno emesso , e come sono state prese le decisioni di routingM SK3 Perfetto per capire il sistema o per debuggere i pipelines personalizzati
Il CLI espone tutta la complessità come semplici opzioni. Si possono cambiare i tubi di tubature, modelliM SK2 e formati di output senza capire l'architettura delle onde .
| Parte | Pattern | Implementazione di ImageSummarizer S |
|---|---|---|
| 1 | Fuzzinesse limitata | ColorWave calcola i fatti; VisionLlmWave li rispetta |
| 2 | MoM Fuzzy Constretto | Pubblico di diverse onde per l'analisiContextoM SK1 Coordinate dell'orchestratore Wave |
| 3 | Dragging Contexto | ImageLedger accumula caratteristiche salientiM SK1 SignalDatabase caches results |
Lo stesso schema. Domaino diversoM SK1 La stessa regola: la probabilità propone, il determinismo persiste.
Questo non è il percorso veloce. È il percorso affidabileM SK1 vale la pena se avete bisogno di una comprensione dell'immagine verificabile su larga scala; l'overkill se avete solo bisogno di sottotitoli per una galleria fotografica .
| Mode di fallimento | Cosa succede | Come viene gestito S' | ||
|---|---|---|---|---|
| Noisy GIF | Frame jitterM SK1 Artifatti di compressione | Stabilizzazione temporanea + Deduplicazione SSIM SSK4 Consenso di voto ESK5 testoESC6estrazione solo a strisce EESC7 | ||
| OCR restituisce i rifiuti. | Tesseract fallisce sulle fonti stilizzate | Scrabble-Check gate rileva < MESK4 corretto S→ si espande a FirenzeM SK6 \→ Vision LLM se ancora debole ♫ | ||
| I costi elevati dell'API | Troppo tante chiamate LLM da cloud Vision | Florence-2 ONNX gestisce 80%+ localmente S~200msM SK5 testoMSC6 solo le strisce riducono i tokens SSK7 per i GIF | ||
| Alucinazioni visive | LLM afferma che il testo non è ' non c'è | I segnali permettono di individuare le contraddizioni ( lo schema mostrato qui SSK4 i consumatori in avalismo possono confrontarevision.llm.text contro content.text_likeliness |
||
| I cambiamenti del pipeline nel tempo | New waves addedM SK1 thresholds adjusted | Content-hash caching | + full provenance in every signal | + version tracking |
| Il modello non restituisce nulla. | Tempo spento o risposta vuota della Vision LLM | Chain di Fallback: Vision LLS → FlorenceM SK4 SSK5 Votazione Tesseract ♫→ OCR crudo ♫ ; ordine prioritario assicura una graziosa degradazione ♫ |
Ogni modo di fallimento ha una risposta deterministica. Nessuna degradazione silenziosa.
Contexto importante: ImageSummarizer è il Il tubo di ingestione dell'immagine per l'ecosistema LucidRAG.
Questo articolo si concentra sull'estrazione di segnali strutturati dalle immagini.
Quando si attaccano insieme. LucidRAG (ci sarà presto!), queste tre pipelines permettono di multi-modal graph RAG:
Document → DocSummarizer → Structured signals
    ↓
Images → ImageSummarizer → Structured signals
    ↓
Data → DataSummarizer → Structured signals
    ↓
    ↓ (all signals)
    ↓
LucidRAG Graph Builder → Multi-modal knowledge graph
    ↓
Query → Multi-modal retrieval + constrained generation
Perché questo è importante?: La RAG tradizionale tratta le immagini come gocce opache che vengono sottotittateM SK1 Multi- grafico modico La RAg tratta le foto come Source di segnali della prima classe- con le relazioni tra i caratteri e il testo, datiM SK1 e altre immagini. Gli stessi principi del determinismoMNK3 scala diversaMMK4
La scala del modello: se si possono estrarre segnali strutturati dalle immagini (questo articoloM SK2 documenti (DocSummarizer), e dati (DataSummarizer), si può costruire un grafico di conoscenza dove ogni nodo ha una provenienza e ogni bordo ha dei punteggi di fiducia.
Arrive presto.: Integrazione LucidRAG completa che mostra come questi tubi si compongono in multi-questioni di RAG a grafico modicoM SK2 Gli stessi principi architettonici , substrato di segnale unificatoMSC4
L'architettura ha una struttura: ogni onda è indipendente, ogni segnale viene digitato , ogni escalazione è deterministaM SK3 FlorenceMSC4 fornisce un rapido analisi localeMST5 Vision LLM gestisce casi complessiMSSK6 ma nessuna opera senza limitiMSL7 i segnali deterministici ancorano sempre il risultatoMSM8
Dalla pubblicazione iniziale dell'articolo, il sistema si è evoluto significativamente:
Solo il tubo di OCR—con i suoi tre varianti-espansione dei livelliM SK2multi--eletazione di fotogrammi ,ottimizzazione delle strisce di pellicola,, e del testo,-estrazione solo di strisce,M SK7è diventato abbastanza complesso da poter meritare un articolo dettagliato. Integrazione dell'OCR nella visione Guidanza per il completo blocco tecnico.
Se si può fare questo per le immagini—il tipo di input più complicato, con il rumore dell'OCRM SK2 caratteri stilizzati , fotogrammi animatiMST4 e allucinazioniMSSK5capitali propensiMSC6si può fare per ogni componente probabilisticoMSM7
Che's Constrizione Fuzziness in pratica . Non un modello astratoM SK2 Code di lavoro.
| Parte | Tipo | Asse S |
|---|---|---|
| 1 | Fuzzinesse limitata | Componente unica |
| 2 | MoM Fuzzy Constretto | Numerosi componenti |
| 3 | Dragging Contexto | Tempo / memoria |
| 4 | Intelligenza dell'immagine (questo articolo) | L'architettura delle onde, modelli |
| 4.1 | Il Pipeline Three-Tier OCR | OCRM SK1 Modelli ONNX, filmtrips |
Più avanti: Parte 5 mostrerà come ImageSummarizer DocSummarizer, e DataSummarizer comporsi in grafico multi-modal RAG con LucidRAG.
Tutte le parti segueno la stessa invariante: Componenti probabilistice propose; sistemi deterministici persistono.

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.

