
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Établissement principalementlucid-nmtM SK1 Production-Ready (EasyNMT compatibleMSC4 Service de traduction
Saturday, 08 November 2025
Introduction
Une mise en oeuvre d'API rapide Copie EXACTEMENT l'API de EasyNMT (httpsM SK1github.com /UKPLabMNK4EasyNMTMSC5 une excellente mais abandonnée neuronaleMST6machineMst7projet de traductionMSt8 Mais j'ai ajouté SO MANY belles fonctionnalités pour accroître la fiabilité et le rendre prêt à utiliser dans un système de productionM st10 Pensez que la traduction rapide est auto-hébergéeMstr11
Depuis le début de ce blog, une grande passion a été l'autoM SK1 traduction d'articles de blog . Oui Je sais que 'google fait celaMSC4 dans les navigateurs, etc.MST5etcMst6mais queMSL7ce n'est pas le pointMSP8 J'ai voulu savoir comment le faireMSSK9 Plus c'estMSS10il est agréable d'être accueillant aux gens qui ne l'ont pasMSM11dont ils ne lisent pas l'anglaisMSR12même s'ils lisent l'Angleterre en tant qu'une seconde langueMRS13 ilMRSS14c'est beaucoup plus difficile à analyserMSSR15 Donc j'ai travaillé sur la façon de le faire,MSR16 ainsi que de partager comment construire ce type de systèmeMSNS17 Oh et ça m'a donné des idées sur la manière d'utiliser ce système dans ASPMCSS18NET pour la localisation automatique du texte MSCS19y compris le texte dynamiqueMSKS20en utilisant SignalR MSCS21un système de mise à jour en temps réel sophistiquéMSC22 \MSC23rester à l’écoute!).
Oh et je'ai fait une démonstration disponible ici ; httpsM SK2nmtdemo.mostlylucidMST4netMSC5demonstration+/ c’est seulement fonctionne dans un vieux ordinateur portable sans GPU mais vous donne l’idée MNK8et me permet de tester une certaine invisibilitéMRK9
Essentiellement; les humains écrivent de mauvais texte qui est super bruyeux pour que les machines puissent traiter efficacement . Il y a eu beaucoup de recherche sur la façon d’aborder des problèmes avec EasyNMT (il s’agissait vraiment d’un projet de recherche mostlylucid-nmt est conçu pour être une bataille testée ( bien traduisant les dizaines de milliers de mots sur ici !) système utile pour n'importe quelle traduction
Il a aussi toutes les leçons que j'ai de trois décennies de construction de serveurs de production & systèmes. allant des codes 429 pour dire au client de se retirerM SK3 retour de métadonnées sur les traductions afin d'aider les clientsMSC4 points finals supplémentaires pour obtenir plus de données et DE COURSE une page de démonstration ce qui me permet à la fois de développer ainsi que vous une façon d’avoir un jeu.
I a écrit un tout système pour faire en sorte que cela se passe avec un projet incroyable appelé EasyNMT. Quoi qu’il en soit, si vous venez de vérifier ce répertoire que vous connaissez là-bas ' est une questionM SK3 il n’a pas été touché depuis des annéesMNK5 IlMRK6 c’est un moyen simple MNK7 rapide d’obtenir une API de traduction sans avoir besoin de payer un service ou d’exploiter un volet completMMK8 taille LLM pour obtenir la traduction MBK9 lentementMGK10
Dans nos précédents articles, nous avons discuté de la façon d’intégrer EasyNMT avec ASP. applications NET pour la traduction de fondM SK2 Mais au fur et à mesure que le temps s’est écoulé , les fissures ont commencé à apparaîtreMSC4 Il était temps de faire quelque chose de meilleurMST5
Comme d’habitude, il' est tous sur GitHub et tous gratuits pour l’utilisation etc...


Démo...voir plus loin pour la page de démonstration!
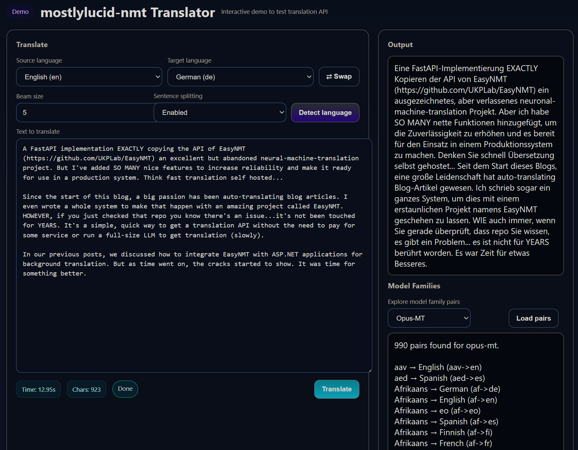
Une page de démonstration interactive (mostly) pleinement présentée (at http://<server>:<port>/demo ou simplement la racine)
Quoi de neuf?
Avant de plonger dans le début rapide, ici ' c'est ce qui rend cette version du jeu
Principales mises à jour (vM SK1 - Intelligence MSC3 Visibilité
Nouveaux dans v3.1: La dernière version apporte des améliorations considérables à la fiabilité, visibilité du rendementM SK1 et sélection intelligente de modèles!
1. Cachement de modèles intelligents avec visibilité - Voir exactement ce qui se passe.
- ✓ Enregistrement du cache HIT:
Reusing loaded model for en->de (3/10 models in cache) - ✗ Enregistrement du cache MISS:
Need to load model for en->fr (3/10 models in cache) - Traçage de l'état du cache: Indique le pourcentage d'utilisation et les modèles chargés
- Avertissements d'évacuation: Supprimer les alertes lorsque le cache est plein et que les modèles sont évacués
- Capacité accrue: La taille de cache par défaut est passée à 10 pour les modèles
- Per-modèle d'enregistrement des dispositifs: Voir exactement quel GPU /CPU chaque modèle utilise
2. Progrès accrus en matière de téléchargement - Je ne me demande plus s’il est stuck.
- Taille avant le téléchargement: Montre la taille totale du téléchargement (eM SK2g., MSC4Sized totalMSC5 | | GB | ")
- Compte des fichiers: Indique le nombre de fichiers à télécharger
- Display de l'appareil: Indique l'appareil cible (GPU/CPU) en bannière
- Bars de progrès: Très beau progrès tqdm pour chaque fichier ( quand sur TTY)
- Bannière d'achèvement: Éclaircissement du message de réussite lorsque le modèle est prêt
- Exemple de sortie:
====================================================================================================
  🚀 DOWNLOADING MODEL
  Model: facebook/mbart-large-50-many-to-many-mmt
  Family: mbart50
  Direction: en → bn
  Device: GPU (cuda:0)
  Total Size: 2.46 GB
  Files: 6 main files
====================================================================================================
[Progress bars for each file...]
====================================================================================================
  ✅ MODEL READY
  Model: facebook/mbart-large-50-many-to-many-mmt
  Translation: en → bn is now available
====================================================================================================
3. Données-Sélection intelligente du pivot dirigé - Il n'y a plus de tentatives aveuglesM SK1
- Logique d'intersection intelligente: Trouver les langues où existent les deux pattes pivot
- Éviter les tentatives échouées: WonM SK1t try en →es→bn si esMSC4bn n’existe pas
- Exemple pour en→bn:
[Pivot] Languages reachable from en: 85 languages [Pivot] Languages that can reach bn: 42 languages [Pivot] Found 38 possible pivot languages [Pivot] Selected pivot: en → hi → bn (both legs verified) - Priorité de recul: Anglais → Espagnol → Français → Allemand SMK4 Chinois SMK5 Russe
- Enregistrement transparent: Voir exactement pourquoi chaque pivot a été choisi ou abandonné
4. Retour automatique fixe - Pas de doubles
- Étudie toujours les échecs: Même si la famille préférée " doit supporter le pair
- Un essai par famille: Il n'est plus possible de répéter le même modèle deux fois
- Exemple de flux:
Request: en→bn with opus-mt
Trying families: ['opus-mt', 'mbart50', 'm2m100']  ✓ All three!
opus-mt: Failed (model doesn't exist)
mbart50: Success! (auto-fallback worked)
5. Clarité GPU - Soyez toujours au courant de l’endroit où se trouvent vos modèles
- Chaque charge du modèle montre:
Loading mbart50 model on GPU (cuda:0) - Une fois la charge confirmée:
Model loaded on device: cuda:0 - Message de succès inclut:
Successfully loaded... on GPU (cuda:0)
6. Cache du modèle Pivot - Réutilisation efficace des pivots
- Les deux pattes du pivot sont cachées séparément:
en->hi,hi->bn - La prochaine fois en→hi ou hiM SK1bn requis, instant cache hitMSC3
- Élimination de l’enregistrement:
[Pivot] Both legs loaded and cached. Ready to translate.
7. Par-Sélection du modèle de demande - Travaille déjà dans la demo:
- Le démarrage de la démonstration permet de sélectionner opus-mt, mbartM SK2 ou mMSC3mMST4
- Respects à l'arrière-plan
model_familyParamètre par demande - Modèles cachés séparément par famille pour un changement instantané
Principales mises à jour (v3.0)
1. Page de démonstration améliorée - Production-interface interactive déjà établieM SK2
- Emplacement complet du portail de visualisation (100vw/100vhM SK2 pour une expérience de traduction immersive
- Choix thématique approprié des rejets (pas plus d'entrées bloquéesM SK1liste de données)
- Modèle d'interruption familiale en mode réel (Opus-MTM SK2 mBART 50,
- Chargement de langage dynamique fondé sur le modèle sélectionné
- Zones de sortie roulables pour les grandes traductions
2.Performance-Défaults optimisés - "Le plus tôt possibleM SK2 hors de la boîte:
- GPU: FPM SK1 activé, BATCHMSC3SIZEMNK4 MAXMST5INFLIGHTMst6 MST7optimale pour un seul GPUM st8
- CPU: WEB_CONCURRENCYM SK2 MAXMNK3INFLIGHTMRK4 BATCHMEK5SIZEMK6 (utiliser tous les carottesMMK8
- Fermeture rapide:
- Les contenants s'arrêtent sans risquer les messages SIGKILL
3. Optimisation de la construction de production - Moins de tailleM SK1 Images plus rapides :
- Élimination des dépendances d'essai (pytest, pytest -covM SK3 de la production builds
- Réserve ~200MB par image
- Images de CPU: M SK1GB (full),
- Impressions GPU: M SK1GB (full), ≥~6-8GB
- Utilisation totale
requirements-prod.txtpour une empreinte minimale
4. Essais complets & Essai de charge - Valider tout
- Système d'essai API en direct (30+ essais ) pour la santéMSC2 traductionM SK3 détection, découverte
- k6 Essais de charge avec des modèles de trafic réalistes
- Les scripts de validation des plateformes Cross- (PowerShell + BashM SK2
- Tests pour les téléchargements de modèles et le retour d'une traduction pivot
- Essais de fumée automatisés pour une validation rapide
5. Documentation de déploiement - Production-à l'état de préparation dès le premier jourM SK2
- 4 Systèmes d'ajustement : Capacité maximale de transfert , faible latence M SK3 haute concurrence MSC4 mémoire MST5 restreinte
- Docker Élaborer des exemples avec les configurations GPU/CPU
- Kubernetes manifeste avec des contrôles de santé en PVC, Limites de ressourcesM SK1
- Exemples d'instances de conteneurs Azure
- Lignes directrices et recommandations de surveillance pour les essais de chargement
- Concurrency vs throughput trade-offs explained
6. Trois familles modèles - Choisissez le meilleur pour vos besoins
- Opus-MT: 1200+ couplesM SK2 la meilleure qualité CSM3 modèles séparésCMS4
- TÉU, TPAC, TPMD, TM, TACI, TC:: 50 langues, unité 2.4 modèle GBM SK4 | paires
- En ce qui concerne les émissions de gaz à effet de serre, on a constaté qu’il y avait des différences entre la quantité et le niveau d’émission.: 100 langues, unité 2.2 modèle GBM SK4 | paires
7. AutoM SK1Fallback - Choisit intelligentement le meilleur modèle disponible
- Établir la famille primaire (eMSC1g., OpusM SK3MT pour la qualité )
- Trie automatiquement mBART50/MM SK1M≥100 si le pair n'est pas disponible
- La couverture maximale sans sacrifier la qualité
8. Dévoilement d'un modèle - Demande dynamique des modèles disponibles
/discover/opus-mt- Tous les paires 1200+ de Hugging Face/discover/mbart50- Tous mBARTM SK1 paires/discover/m2m100- Tous les paires MM SK1M100
9. Images minimales - Moins grosM SK1 Déploiement souple:
- Aucun modèle préchargé (download sur-demandM SK2
- Volume-cache persistante mapped
- Changer les familles de modèle sans reconstruire
10. Réseau de docker unique - Toutes les variantes en un seul endroit :
scottgal/mostlylucid-nmt:cpu(ou:latest) CPUscottgal/mostlylucid-nmt:cpu-min- CPU minimalescottgal/mostlylucid-nmt:gpuGPU avec CUDA 12.6scottgal/mostlylucid-nmt:gpu-min- GPU minimal
11. Version correcte - Tous les images incluent une version de date-temps
- Tag no (
latest,min,gpu,gpu-min) indique toujours la dernière construction - Tag de version immuable (e.gM SK2
20250108.143022) pour la fixation de bâtiments spécifiques - Étiquettes OCI complètes pour le suivi des versions, dates de mise en place, et commits git
12. Les dernières images de base - Amélioration de la sécurité et du rendement
- Python 3.12-slim pour les images CPU (addresses Python 3.11 vulnérabilités)
- CUDA 12.6 avec Ubuntu 24.04 pour les images GPU (la dernière pile NVIDIA)
- PyTorch avec CUDA 12.4 (compatible avec CUDA
- Toutes les dépendances mises à jour aux dernières versions sécurisées
13. Avertissements de préjudice fixe -Future-proofM SK2
- Retirer les transformateurs défavorisés_CACHE M SK1en utilisant maintenant HF_HOMEMSC3
- Compatible avec Transformers v5
Démarrage rapide (5 Mesures
Vous voulez simplement obtenir la traduction? ici'est le moyen le plus simple absolu de faire fonctionner la plupartlucidM SK2nmt :
Images Docker disponibles
Toutes les variantes sont disponibles à partir un répertoire avec différents étiquettes:
| Tag | Nom de l'image complète MSC2 Taille MSC3 Description SMC4 Case d'utilisation SMC5 | |||||
|---|---|---|---|---|---|---|
cpu (ou latest) |
scottgal/mostlylucid-nmt:cpu |
~2.5GB MSC2 CPU avec code source SMC3 Déploiements de la CPU de production ESC4 | ||||
cpu-min |
scottgal/mostlylucid-nmt:cpu-min CPU minimale, aucun modèle préchargé M SK4 Volume- cache mappedMSC6 souple |
|||||
gpu |
scottgal/mostlylucid-nmt:gpu |
~5GB | GPU avec CUDA M12.6 | Source | + | Production GPU de déploiement |
gpu-min |
scottgal/mostlylucid-nmt:gpu-min |
~4GB | GPU minimale, aucun modèle préchargé M | GPU avec volumeM SK5cache mapped R |
Images minimales sont recommandés pour:
- Déploiements de production avec volume-cache mapped
- Utilisation d’un mBART50 ou de MM SK1M100 MSC3modus gros seulsMST4
- Maintenir la taille du réservoir petit
- Flexibilité pour changer les familles de modèles sans reconstruire
Démarrage le plus simple (Opus-MT CPUM SK2
1. Sortir et marcher
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  scottgal/mostlylucid-nmt
2. Traduire certains textes:
curl -X POST "http://localhost:8000/translate" \
  -H "Content-Type: application/json" \
  -d '{
    "text": ["Hello, how are you?"],
    "target_lang": "de"
  }'
Réponse:
{
  "translated": ["Hallo, wie geht es Ihnen?"],
  "target_lang": "de",
  "source_lang": "en",
  "translation_time": 0.34
}
GPU Accéléré (10x Plus rapide)
Besoins NVIDIA Docker runtime:
docker run -d \
  --name mostlylucid-nmt \
  --gpus all \
  -p 8000:8000 \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu
Avec une cache de modèles persistants
Téléchargez les modèles une fois et les gardez à l’autre côté du réservoir :
Linux/Mac:
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  -v $HOME/model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  scottgal/mostlylucid-nmt:cpu-min
Windows (PowerShell):
docker run -d `
  --name mostlylucid-nmt `
  -p 8000:8000 `
  -v ${HOME}/model-cache:/models `
  -e MODEL_CACHE_DIR=/models `
  scottgal/mostlylucid-nmt:cpu-min
Windows (CMD):
docker run -d ^
  --name mostlylucid-nmt ^
  -p 8000:8000 ^
  -v %USERPROFILE%/model-cache:/models ^
  -e MODEL_CACHE_DIR=/models ^
  scottgal/mostlylucid-nmt:cpu-min
Les modèles sont téléchargés automatiquement lors de la première utilisation et persistent dans votre répertoire local!
Contrôle de la santé:
curl http://localhost:8000/healthz
Que'est le M SK1minute de démarrage rapide ! Pour le déploiement de la production, configurationMST4 et fonctionnalités avancéesMSC5 conserver la lecture
Page de démonstration interactive
Le service comprend un système complet page de démonstration interactive qui permet d’essayer les traductions sans écrire de code.
http://localhost:8000/demo/
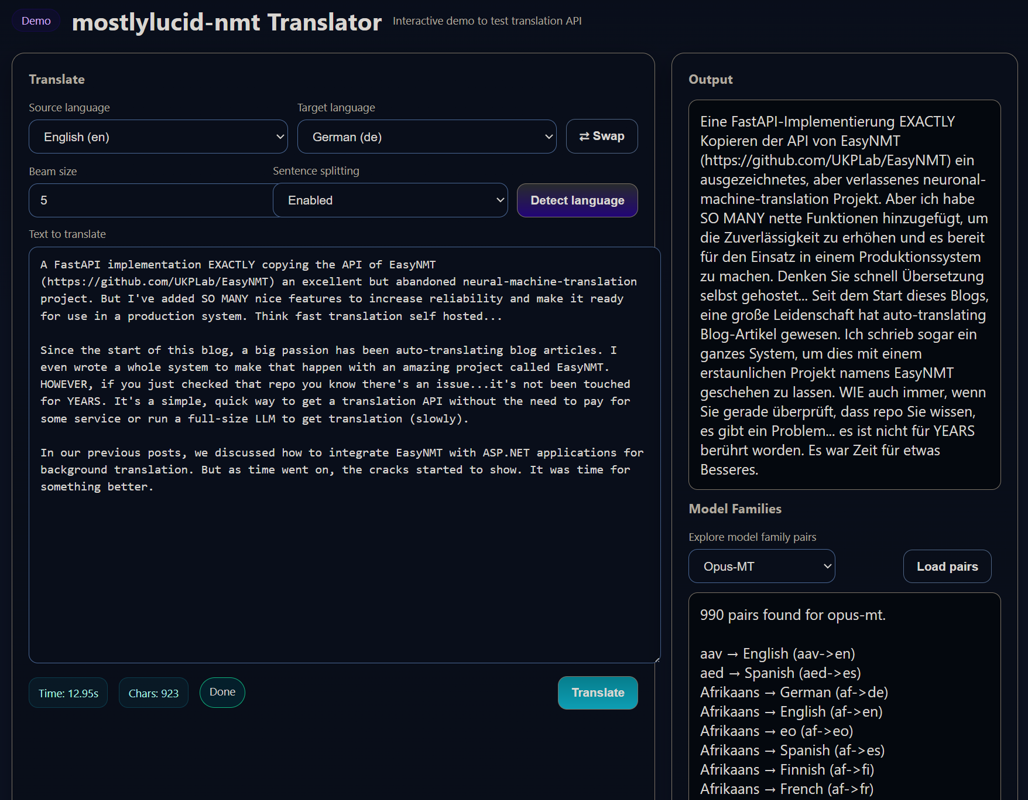
La page de démonstration fournit un environnement complet d’essai de traduction avec:
1. Choix de langue
- Auto-dépôts de langues peuplées du service en direct
- Swap source/languages de cible avec un seul clic
- Appuie toutes les langues 100+ configurées dans le service
2. Connaissance de texte intelligente
- Traite automatiquement les larges saisies de texte d'une taille quelconque
- Divulgation intelligente par paragraphes, préservant la structure du document
- Retourne à la division de phrase pour des paragraphes très longs
- Indique les progrès des traductions multiples-chunk ("Translation de chunk 2/5...")
- Réassemble sans fil les morceaux avec un espace approprié
3. Détection linguistique
- Détecter la langue de source avec un seul clic
- Insérer automatiquement la langue de source en bas de page
- Travaille avec des caractères jusqu'à 5000
4. Options avancées
- Taille du faisceau: Contrôle de la qualité des traductions
- valeurs plus élevées = meilleure qualité mais plus lente
- valeurs inférieures = débit plus rapide
- Partage de la Sentence: Toggle la séparation automatique de phrases
- Enabled (default): Divise les textes longs en phrases pour une meilleure qualité
- Disabled: Traduit tout le texte en un seul bloc M SK1faster for short texts)
Statistiques du temps
- Temps de traduction: Indique le serveur réel-Durée de traduction côté
- Compte des caractères: Compte en direct au moment de la saisie
- Indicateur de l'état: Inactive → Traduction → Terminé/Error
6. Modèle Family Discovery
- Explorez les paires de traduction disponibles pour chaque famille de modèles:
- Opus-MT: 1200+ paires linguistiques
- TÉU, TPAC, TPMD, TM, TACI, TC:: 50 paires de langues
- En ce qui concerne les émissions de gaz à effet de serre, on a constaté qu’il y avait des différences entre la quantité et le niveau d’émission.: 100 paires de langues
- Voir exactement les paires de langues disponibles avant la traduction
Comment fonctionne le chantage de texte
La démonstration met en œuvre le blocage de texte intelligent du côté client:
// Example: Translating a 5000-word article
Input: Long article with multiple paragraphs

Step 1: Split by paragraphs (preserves structure)
  → Paragraph 1 (800 chars)
  → Paragraph 2 (1200 chars)
  → Paragraph 3 (600 chars)
  ...

Step 2: Group into ~1000 character chunks
  → Chunk 1: Paragraphs 1-2
  → Chunk 2: Paragraph 3-4
  → Chunk 3: Paragraphs 5-6

Step 3: Translate each chunk sequentially
  → Shows progress: "Translating chunk 1/3..."
  → Shows progress: "Translating chunk 2/3..."
  → Shows progress: "Translating chunk 3/3..."

Step 4: Reassemble with paragraph breaks
  → Final output: Complete translated article with preserved formatting
Pourquoi utiliser la démonstration?
Essais rapides
- Tester les traductions sans écrire le code
- Valider la disponibilité des paires de langues
- Comparer la qualité de la traduction avec les différentes tailles du faisceau
- Cases à bord d'essai (emojiM SK1 symboles , caractères spéciaux)
Aide au développement
- Voir la demande API exacte/format de réponse
- Vérifier la santé des services avant l'intégration
- Essai de performance avec différentes tailles de texte
- Découvrez les familles de modèles disponibles
Référence du client
- Indique les patrons d'utilisation appropriés de l'API
- Démonstration de la manipulation des erreurs (429, détection linguistique)
- Exemple de mise en œuvre du blocage
- Logique de réessai du monde réel-world
Exemple d'utilisation
Traduction simple:
- Inscrire le texte: M SK1Hello, Comment vous serez-vous aujourd’hui?
- Choisissez la cible: Allemand
- Cliquer "Traduire"
- Résultat: "HalloM SK2 wie geht es Ihnen heute?"
Traduction de documents longs:
- Insérer tout post sur le blog (5000+ mots)
- Démonstration la découpe automatiquement en morceaux gérés
- Indique les progrès réalisés au fur et à mesure que chaque morceau traduit
- Retourne le document entièrement traduit
Détection linguistique:
- Inscrire le texte dans une langue inconnue
- Cliquer "Détecter la langue"
- Démonstration de la langue et des mises à jour
- Préparé pour traduire immédiatement
Détails techniques
La page de démonstration est:
- auto-contenant: Un fichier HTML unique avec JavaScript intégré
- Nulle dépendance: Aucune bibliothèque externe n'est nécessaire
- Mobilité conviviale: La conception réactive fonctionne sur tous les dispositifs
- Production prête: La même logique de regroupement peut être utilisée dans vos applications
Accès à la démonstration en direct : /demo/ sur votre instance en cours!
Les problèmes avec EasyNMT
Maintenant, ce n’est pas le dumping sur EasyNMT il n’a rien fait et j’ai construit Un grand nombre de projets y ont recours.. C’est juste qu’il prend du temps dans le den, c’est-à-dire que nous avons des problèmes.
Oh mon , là ' beaucoup d’entre eux M SK2 EasyNMT a été construit il y a près de dix ans . La technologie s’est déplacée sur la voie de l’expansion MSC4 plus qu’il n’avait jamais été prévu d’être une production MST5 système à niveau M ST6 Voici quelques-uns des enjeux M st7
- Il s’effondre...a LOT. Il n’est pas conçu pour récupérer des problèmes, c’est-à-dire qu’il tombe trop souvent sur ..
- Il's SUPER PICKY au sujet de son entrée. Emoticons, symbolesM SK1 même les chiffres peuvent le confondre
- Il n’est pas conçu pour une charge quelconque. Voir ci-dessus. Il n'a jamais été conçu pour être
- Il n’est pas conçu pour mettre à jour ses modèles ou être (easilement) construit avec des modèles construitsM SK2dans les modèles
- Son GPU CUDA stuff est antique plus lente qu’il ne doit être.
- Vous pouvez corriger quelque chose. Le code Python est sur le répertoire mais de nouveau pas grand.
- Aucune pression d'arrière ou aucune attente. Send too many requests and it just keels over.
- Aucune observabilité. Lorsque les choses vont mal, vous 'Vous pilotez à l’incertitude.
La solution: MostlyLucid-NMT
J’ai donc décidé de construire maintenant un nouveau et amélioré EasyNMT mostlylucid-nmt. Il ne s’agit pas d’un travail de mise à jour, mais d’une réécriture complète en tenant compte de l’utilisation de la production.
Multi-Support familial du modèle
Plus particulièrementLucid-NMT appuie maintenant Trois familles de modèles de traduction, vous offrant une souplesse fondée sur vos besoins
Opus-MT M SK1Helsinki-NLPMSC3 - Défault
- Coverage: 1200+ paires de traduction pour les langues 150+
- Architecture: Modèle séparé par direction de traduction
- Qualité: La meilleure qualité globale de la traduction
- Utiliser le cas: Traductions de production lorsque la qualité est importante
- Taille du modèle: 300-500MB par direction
- Exemple: Anglais→Le modèle allemand est différent du modèle allemandM SK1Anglais
mBART50 M SK1Facebook)
- Coverage: 50 langues , toutes-àM SK3tout la traduction
- Architecture: Modèle multilingue unique
- Qualité: Bonne qualité, particulièrement pour les grandes langues
- Utiliser le cas: Space-déploiements restreints ou plusieurs paires de langue
- Taille du modèle: Modèle unique pour toutes les langues 50
- Avantage: Un modèle gère des paires de traduction 2,450
M2MMSC1 M SK2Facebook)
- Coverage: 100 langues , toutes-àM SK3tout la traduction
- Architecture: Modèle multilingue unique
- Qualité: Bonne qualité avec une couverture linguistique la plus large possible
- Utiliser le cas: La couverture linguistique maximale
- Taille du modèle: Modèle unique pour toutes les langues 100
- Avantage: Un modèle gère des paires de traduction 9,900
Le changement est facile - Just set the MODEL_FAMILY variable environnementale:
# Opus-MT (default, best quality)
MODEL_FAMILY=opus-mt

# mBART50 (50 languages, single model)
MODEL_FAMILY=mbart50

# M2M100 (100 languages, broadest coverage)
MODEL_FAMILY=m2m100
Modèle automatique de recul familial - NOUVEAUM SK1
L'une des nouvelles fonctionnalités les plus puissantes est retour automatique entre les familles de modèles. Cela assure une couverture maximale des paires de langues tout en accordant la priorité à la qualité de la traduction.
Comment il fonctionne:
- Vous avez établi un premier
MODEL_FAMILY(eM SK1g.,opus-mtpour la meilleure qualité) - Lorsque vous demandez un pair de traduction non disponible dans la famille primaire
- Le système essaie automatiquement la famille suivante dans l'ordre de régression
- Cela se poursuit jusqu'à ce qu'un modèle approprié soit trouvé.
Exemple de scénario:
# Set primary to Opus-MT (best quality)
MODEL_FAMILY=opus-mt
AUTO_MODEL_FALLBACK=1
MODEL_FALLBACK_ORDER=opus-mt,mbart50,m2m100

# Request Ukrainian → French
# 1. Try Opus-MT first (not available)
# 2. Automatically fall back to mBART50 (available!)
# 3. Translation succeeds with mBART50
Avantages:
- Couplage maximal: Soutenir les langues 100+ sans gérer plusieurs déploiements
- Priorité en matière de qualité: Utilise toujours le meilleur modèle disponible pour chaque couple
- Configuration zéro: Travaille automatiquement, aucune intervention manuelle n'est nécessaire
- Enregistrement transparent: Voir quelle famille de modèles a été utilisée pour chaque traduction
Configuration:
# Enable auto-fallback (default: enabled)
AUTO_MODEL_FALLBACK=1

# Set fallback priority (default: opus-mt → mbart50 → m2m100)
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"

# Disable for strict single-family mode
AUTO_MODEL_FALLBACK=0
Cette fonctionnalité est parfaite pour les milieux de production où vous voulez une couverture maximale sans sacrifier la qualité!
Principales améliorations
- Multi-support familial modèle - Choisissez parmi OpusM SK1MT (1200+ paires), mBARTMSC4 50 languesMska6 ou Mska7MM Ska8
- Points finals de la découverte des modèles - Demande dynamique des modèles disponibles à Hugging Face pour chaque familleM SK1
- Traitement de l'entrée robuste - EmoticonsM SK1 Numéro(s) ? Symboles? Faire fonctionner le serviceMSC4 Le service comprend maintenant une stérilisation complète de l'entrée et un masquement des symboles.
- Demande de cote et pression d'arrière - Établissement de la liste d’attente fondée sur le sémaphore de -, -, avec un retry intelligent et -, après les estimations
- Cache du modèle LRU - gère automatiquement le VRAM en évacuant les modèles anciens lorsque la cache est remplie.
- Soutien moderne de la CUDA - Utilise PyTorch avec la CUDA 12.6, appuie le FP16/BFM SK3 pour les améliorations de vitesse
- Production-Observabilité prête - Contrôles de santé , sondes de préparation, état du cacheM SK3 signalement structuréMSC4
- Fermeture gracieuse - Il n’y a plus de demandes d’orphelin ou d’État corrompuM SK1
- EasyNMT-API compatible - DropM SK1en remplacement pour les intégrations existantes .
- Pivot translation fallback - Si une paire de langues directe n’est pas disponible't availableM SK2 route automatiquement par l’anglais ou votre pivot choisiMSC4
- Images minimales de Docker - Nouveau
-minvariants with volume-mapped cache for smaller deployments.
Pourquoi NMT sur les LLMs pour la traduction?
Vous voudriez peut-être vous demander: " Pourquoi utiliser un service NMT dédié lorsque des LLM comme GPT-4, ClaudeM SK3 ou Llama peuvent traduireMSC4 Très bonne questionMST5 C'est la vérification de la réalité basée sur l'utilisation de la productionMSP7
Speed: M SK1x Plus rapide
TÉU, TPAC, TPMD, TM, TMÉU, TC:
- CPU: ~0.3-1.0 secondes par phrase
- GPU (FPM SK1 ~0.05-0.2 secondes par phrase
- Traitement par lot: M SK1 phrases/seconde sur GPU
LLMs:
- GPT-4: 3-10 secondes par requête ( latence API
- Llama 3 70BM SK2 ≥5-15 secondes par phrase
- Claude 3: 2-8 secondes par requête
Exemple réelle: Traduction d’un 1000-poste de mot sur le blog:
- mostlylucid-nmt M SK1GPU): 5-10 secondes
- GPT-4 API: 30-60 secondes
- Local Llama 70B: 2-5 minutes
Lorsque vous traduisez automatiquement des centaines de articles sur le blog dans les langues 12+ , la différence de vitesse est MASSIVE
Taille du modèle: M SK1MB vs 140GB
Modèles NMT:
- Opus-MT (par directionM SK2 300-500MB
- mBART50 M SK1toutes les langues 50
- M2MM SK1 (toutes les langues 100
- Total pour les langues 100+
LLMs:
- Llama 3
- Llama 3
- Mécanisme mixte 8xM SK1B: ~90GB
- GPT-4: Non disponible pour l'hébergement personnel
Impact sur l’entreposage:
# NMT: Fits on a USB stick
du -sh model-cache/
2.5G    model-cache/

# LLM: Needs serious storage
du -sh llama-models/
140G    llama-models/
Besoins en ressources: Laptop vs Server Farm
Déploiement de la CPU NMT:
- Fonctionne correctement sur: 2 Cores de CPUM SK2 ≥4GB RAM
- Image de docker: 1.5-2.5GB
- Inférence: CPU seulement, aucune GPU n'est nécessaire
- Coût: M SK1VPS mensuel
Exigences de LLM:
- Llama 3 70BM SK2 Besoins 80GB+ VRAM M(AMST6 GPUMSC7
- Modèles plus petits 7BM SK1B models: Néanmoins 16-32GB RAM minimum
- Coûts de l’API: M SK1 par 1000 tokens (adds up fast!)
- Self-hosting: M SK2montant pour un GPU sérieux
Comparaison des coûts réels pour 10,000 traduction des articles de blog:
| Méthode | Coût | Temps | ||||
|---|---|---|---|---|---|---|
| mostlylucidM SK1nmt (CPU) | $20/montant VPS SSK6 | 2-3heures S | ||||
| la plupartlucidM SK1nmt (GPU) | $50/month GPU VPS SSK6 | 15-30 minutes | ||||
| GPTM SK1 API | $150-300 | 4 | 5 | heures | ||
| API de Claude | $200-400 | 3 | 4 | heures | 5 | |
| Local Llama 70B MSC2 MSC3Montant d'équipement SMC4 ♫MSC5heures SMC6 |
Qualité: ButM SK1Équipement construit par rapport à l’ensemble-Objectif
Concentrations de NMT:
- Formé spécialement pour la traduction
- Qualité cohérente (la même entrée = la même sortieM SK2
- Aucune "hallucinationsM SK1 - traduction pure
- Manipulation du contenu technique, code, formatage bien
- Aucune ingénierie rapide n'est nécessaire
Défis liés à LLM:
- ⚠️ Ajout parfois des interprétations non originales
- ⚠️ La qualité varie avec la formulation rapide
- ⚠️ Peut être "creative" avec des termes techniques
- ⚠️ Besoins d’ingénierie rapide et soigneuse
- ⚠️ Non prévisible avec les cases à bord
Exemple de scénario:
Input: "The API returns a 429 status code when rate limited."

NMT (Opus-MT): "Die API gibt einen 429-Statuscode zurück, wenn sie ratenbegrenzt ist."
(Accurate, preserves technical terms)

LLM (might do): "Die API sendet den Fehlercode 429, wenn zu viele Anfragen gestellt werden."
(Interprets rather than translates, adds context not in original)
Quand utiliser chacune
Utiliser NMT (mostlylucid-nmtM SK2 lorsqueMSC3
- Vous avez besoin d’une traduction uniforme, rapide à l’échelle
- Questions budgétaires (self-hosting or high volumeM SK2
- Vous'traduisez le contenu technique , codeM SK2 données structurées
- Vous avez besoin d'une sortie déterministe (la même entrée = la même output)
- Vous voulez fonctionner sur CPU ou matériel modeste
- Vous construisez des pipelines de traduction automatisée
Utiliser les LLM lorsque:
- Vous avez besoin d’une adaptation créative, pas de traduction littéraire
- Le contexte et les nuances culturelles sont plus importants que la vitesse
- Vous faites de faibles traductions
- Vous devez traduire + résumer + réécrire en un seul pas
- You're okay with variable costs and slower processing
La ligne inférieure
Pour traduction automatique du blog ( mon cas d’utilisationM SK1 NMT est le gagnant évident:
- Traduit les articles de 100+ sur le blog en 12 langues dans des minutes.
- Fonctionne sur un VPS mensuel de $50/
- Qualité uniforme dans tous les postes
- Établissement total: Un conteneur Docker
En essayant de le faire avec les LLM, cela coûterait des centaines de dollars par mois en frais d’API ou nécessiterait un serveur GPU $2000+ pour lui-même -hôte. La seule différence de vitesse fait du NMT la seule option pratique pour les pipelines de traduction de production
TL;DRM SK1 NMT a pour objet-conçue pour la traduction , fonctionne sur un matériel modeste, et est M SK3x plus rapide que les LLMsMSC4 Si vous avez besoin d’une traduction rapideMST5 uniformeM ST6 coûtM st7traduction efficace à l’échelleMst8 NMT gagne les bras en basMSt9
Aperçu de l'architecture
flowchart LR
    A[HTTP Client] --> B[API Gateway]
    B --> C[Translation Endpoint]
    C --> D{Has Capacity?}
    D -->|Yes| E[Translation Service]
    D -->|No| F[Queue with 429]
    F --> E
    E --> G[Process Pipeline]
    G --> H[Get Model from Cache]
    H --> I[Translate]
    I --> J[Return Response]
    J --> A
Le flux de demande est simple:
- Client envoie une demande de traduction à l'API Gateway (Gunicorn + Uvicorn workers)
- Portail API Routes vers le point final de la traduction
- Contrôle de la capacité: Le système vérifie s'il a la capacité de traiter la demande
- Oui → La demande est envoyée immédiatement au Service de traduction
- Non → Request queued, client reçoit HTTP 429 avec
Retry-Afteren-tête
- Service de traduction traitement de la demande par le biais du pipeline:
- Sanitisation de l'entrée et séparation des peines
- Maquillage des symboles (emojis,cartes spécialesM SK2
- Traduction en utilisant des modèles cachés
- Démasquement des symboles et traitement post--
- Cache de modèle (LRUM SK1 fournit des modèles de traduction:
- Cache hit → Réponse rapide
- Cache miss → Charger à partir de HuggingFace Hub
- Cache complète → Auto-anciens modèles évitésM SK2 mémoire CUDA claire
- Réponse retourne au client
Key Design: Le mécanisme de répression (queue +HTTP |429) évite les défaillances en cas de charge | . | Lorsque le service est surpeuplé \ , | les queues demandent des services plutôt qu'à mourir , | donnant aux clients un délai intelligent pour essayer de nouveau via Retry-After headers.
Comment il fonctionne: Deep Dive
Flux de demandes
Lorsqu’une demande de traduction est envoyée, ce qui se passe :
sequenceDiagram
    participant Client
    participant API
    participant Queue
    participant Translator
    participant Cache
    participant Model

    Client->>API: POST /translate
    API->>Queue: Acquire slot

    alt Queue has space
        Queue-->>API: Slot acquired
        API->>Translator: Process translation
        Translator->>Translator: Sanitize input
        Translator->>Translator: Split sentences
        Translator->>Translator: Chunk text
        Translator->>Translator: Mask symbols
        Translator->>Cache: Get model (en→de)

        alt Cache hit
            Cache-->>Translator: Return cached model
        else Cache miss
            Cache->>Model: Load from Hugging Face
            Model-->>Cache: Pipeline loaded
            Cache->>Cache: Evict old if at capacity
            Cache-->>Translator: Return model
        end

        Translator->>Model: Translate batches
        Model-->>Translator: Translations
        Translator->>Translator: Unmask symbols
        Translator->>Translator: Post-process
        Translator-->>API: Translations
        API->>Queue: Release slot
        API-->>Client: 200 OK + translations
    else Queue full
        Queue-->>API: Overflow error
        API-->>Client: 429 Too Many Requests\nRetry-After: X seconds
    end
Pipeline de traitement des intrants
Le service utilise une pipeline multi-stage sophistiquée pour traiter le texte réel meurtreux.
graph LR
    A[Raw Input] --> B{Sanitize?}
    B -->|Yes| C[Check Noise]
    B -->|No| D[Split Sentences]
    C -->|Is Noise| Z[Return Placeholder]
    C -->|Valid| D

    D --> E[Enforce Max Length]
    E --> F[Chunk for Batching]
    F --> G{Symbol Masking?}

    G -->|Yes| H[Mask Digits/Punct/Emoji]
    G -->|No| I[Translate]
    H --> I

    I --> J{Direct Model?}
    J -->|Available| K[Direct Translation]
    J -->|Not Available| L{Pivot Fallback?}

    L -->|Yes| M[src→en→tgt]
    L -->|No| Z
    K --> N[Unmask Symbols]
    M --> N

    N --> O[Remove Symbol Loops]
    O --> P[Join Chunks]
    P --> Q[Final Translation]
Sanitisation de l'entrée
L’une des améliorations les plus importantes est la robuste manipulation de l’entrée.
Détection du bruit:
- Caractéristiques de contrôle des bandes (à l'exception \tM SK2 \n,
- Vérifie le nombre minimal de caractères (défaultM SK1 1)
- Calcule le ratio alphanumérique (défaultM SK1 doit être ≥20%)
- Rejette un emoji pur, une ponctuation pure , ou un espace blanc pur
Maquillage de symbole: Pourquoi les symboles de masque? Les modèles de traduction sont formés sur le texte , pas des emoticons ou des symboles spéciaux. Ces symboles peuvent les confondre ou les détourner.
- Extraire toutes les chiffres, punctuation, et les emoji comme exécution contiguë
- Remplacez-les par des tokens sentinels:
⟪MSK0⟫,⟪MSK1⟫, etcM SK1 - Traduire le texte masqué
- Rétablir les symboles originaux dans leurs positions
Exemple:
Input:  "Hello 👋 world! Price: $99.99"
Masked: "Hello ⟪MSK0⟫ world⟪MSK1⟫ Price⟪MSK2⟫ ⟪MSK3⟫"
                 (👋)        (!)      (:)    ($99.99)
Posts-Processing: Après la traduction, nous retirons M SK1roues de symbole" - symboles répétés qui n’étaient pasMSC4t dans la sourceMNK5
Source: "Hello world"
Bad translation: "Hola mundo!!!!!!!"
Cleaned: "Hola mundo"  # Removes the !!!! loop
Partage de la Sentence & dubbing
Les textes longs se divisent intelligentement:
graph TD
    A[Long Text] --> B[Split on . ! ? …]
    B --> C{Sentence > 500 chars?}
    C -->|Yes| D[Split on word boundaries]
    C -->|No| E[Keep sentence]
    D --> E

    E --> F[Group into chunks ≤900 chars]
    F --> G[Translate each chunk]
    G --> H[Join with space]
Cela garantit
- Les modèles ne choquent pas sur les entrées énormes
- Nous pouvons effectuer des lots efficacement
- Le contexte est conservé dans des limites raisonnables
Modèle Caching & Gestion de la mémoire
Le cache LRU est intelligent en ce qui concerne la mémoire GPU:
stateDiagram-v2
    [*] --> CheckCache
    CheckCache --> CacheHit: Model exists
    CheckCache --> CacheMiss: Model not loaded

    CacheHit --> MoveToEnd: Update LRU order
    MoveToEnd --> ReturnModel

    CacheMiss --> CheckCapacity
    CheckCapacity --> LoadModel: Space available
    CheckCapacity --> EvictOldest: Cache full

    EvictOldest --> MoveToCPU: Free VRAM
    MoveToCPU --> ClearCUDA: torch.cuda.empty_cache()
    ClearCUDA --> LoadModel

    LoadModel --> AddToCache
    AddToCache --> ReturnModel
    ReturnModel --> [*]
Pourquoi cela importe:
- La mémoire GPU est précieuse
- Les modèles de traduction sont 300-500MB chacun
- La charge des modèles est lente (1-3 secondes)
- Nous maintenons les modèles 6 les plus récents à chaud
- Les vieux modèles sont automatiquement évacués.
Présence & Pression d'arrière
Plutôt que de crasher sous la charge,, les services demandent des rangées de service:
# Semaphore limits concurrent translations
MAX_INFLIGHT = 1  # On GPU, 1 at a time for efficiency
MAX_QUEUE_SIZE = 1000  # Up to 1000 waiting

# When full:
# - Returns 429 Too Many Requests
# - Includes Retry-After header
# - Estimates wait time based on average duration
L’estimation du retry est intelligente:
avg_duration = 2.5 seconds (tracked with EMA)
waiters = 100
slots = 1
estimated_wait = (100 / 1) * 2.5 = 250 seconds
clamped = min(250, 120) = 120 seconds
Retry-After: 120
Pivot Translation Fallback
Les paires linguistiques ne possèdent pas tous des modèles directs sur Hugging Face.
graph LR
    A[Ukrainian Text] --> B{Direct uk→fr?}
    B -->|Exists| C[Translate Directly]
    B -->|Missing| D[Pivot via English]

    D --> E[uk→en]
    E --> F[en→fr]
    F --> G[French Result]
    C --> G
Cela double la latence mais assure une couverture pour toutes les paires de langues supportées.
Code Deep Dive: Cool Features Explained
Let's explorer quelques-unes des parties les plus intéressantes de la base de code ! Il s’agit de modèles de production réels qui rendent le service robuste et efficace M SK2 Chaque fragment comprend des explications appropriées pour les non-membre(s) de l’équipe de développement de Python .
1. Cache LRU intelligente avec gestion de la mémoire GPU
Une des fonctionnalités les plus cooles est le cache de modèle intelligent qui sait comment gérer la mémoire GPU:
# src/core/cache.py
from collections import OrderedDict
import torch

class LRUPipelineCache:
    """LRU cache that automatically cleans up GPU memory when evicting models."""

    def __init__(self, capacity: int):
        self.cache = OrderedDict()  # Maintains insertion order
        self.capacity = capacity

    def get(self, key: str):
        """Get model from cache, moves it to end (most recently used)."""
        if key not in self.cache:
            return None
        self.cache.move_to_end(key)  # Mark as recently used
        return self.cache[key]

    def put(self, key: str, value):
        """Add model to cache, evicting oldest if at capacity."""
        if key in self.cache:
            self.cache.move_to_end(key)
        else:
            self.cache[key] = value

        # If cache is full, evict the oldest model
        if len(self.cache) > self.capacity:
            oldest_key, oldest_pipeline = self.cache.popitem(last=False)

            # MAGIC: Move evicted model to CPU to free GPU memory
            try:
                oldest_pipeline.model.to("cpu")
                if torch.cuda.is_available():
                    torch.cuda.empty_cache()  # Tell GPU to release memory
                logger.info(f"Evicted {oldest_key}, freed GPU memory")
            except Exception as e:
                logger.warning(f"Failed to clean GPU memory: {e}")
Qu’est-ce qui se passe ici?
OrderedDict: Comme un dictionnaire ordinaire, mais se souvient que les articles d'ordonnance ont été ajoutés- LRU (Uniquement utilisé récemmentM SK1: Lorsque le cache est rempli, , retirer le modèle qui n’a pas été utilisé depuis le plus longtemps.
- Nettoyage de GPU: Lors de l’évacuation d’un modèle, nous le déplaceons explicitement vers la mémoire du CPU et demandons au GPU de dégager ses ressources.
- Pourquoi cela est important: Sans ce dispositif, la mémoire GPU se remplirait et s’effondrerait après le chargement des modèles.
2. Fallback familial de modèle automatique
Cette fonctionnalité intelligente permet d’essayer automatiquement les fournisseurs de modèles AI multiples si le premier ne possède pas la paire linguistique dont vous avez besoin.
# src/services/model_manager.py
def get_pipeline(self, src: str, tgt: str):
    """Try to get translation model, with automatic fallback to other providers."""

    # Determine which model families support this language pair
    families_to_try = []

    if config.AUTO_MODEL_FALLBACK:
        # Try families in priority order: opus-mt → mbart50 → m2m100
        for family in config.MODEL_FALLBACK_ORDER.split(","):
            if self._is_pair_supported(src, tgt, family.strip()):
                families_to_try.append(family.strip())

    # Try each family until one succeeds
    last_error = None
    for family in families_to_try:
        try:
            model_name, src_lang, tgt_lang, _ = self._get_model_name_and_langs(src, tgt, family)

            if family != config.MODEL_FAMILY:
                logger.info(f"Using fallback '{family}' for {src}->{tgt}")

            # Load the model from HuggingFace
            pipeline = transformers.pipeline(
                "translation",
                model=model_name,
                device=device_manager.device_index,
                src_lang=src_lang,
                tgt_lang=tgt_lang
            )

            self.cache.put(f"{src}->{tgt}", pipeline)
            return pipeline

        except Exception as e:
            last_error = e
            logger.warning(f"Family '{family}' failed for {src}->{tgt}: {e}")
            continue  # Try next family

    # All families failed
    raise ModelLoadError(f"{src}->{tgt}", last_error)
Qu’est-ce qui se passe ici?
- Chaîne de rappel: Si OpusM SK1MT ne possède pas de 'Ukrainien→FranchMSC4 essaie automatiquement mBARTMST5 alors MMSR6MMSS7
- Aucune intervention manuelle: Les utilisateurs demandent simplement une traduction et obtiennent le meilleur modèle disponible
- Utilisation d'une erreur: Si toutes les familles ont échoué, nous mettons un erreur claire avec la dernière raison d'échec
- Cache intelligente: Les modèles couronnés de succès sont cachés avec la clé des paires linguistiques
3. Chaîne de demandes avec pression d'arrière HTTP
Production-roule de classement qui empêche les défaillances du serveur en cas de charge lourde:
# src/services/queue_manager.py
import asyncio
from contextlib import asynccontextmanager

class QueueManager:
    """Manages request queuing and backpressure."""

    def __init__(self, max_inflight: int, max_queue: int):
        self.semaphore = asyncio.Semaphore(max_inflight)  # Limit concurrent translations
        self.max_queue_size = max_queue
        self.waiting_count = 0
        self.inflight_count = 0
        self.avg_duration_sec = 5.0  # Exponential moving average

    @asynccontextmanager
    async def acquire_slot(self):
        """Try to get a translation slot, track metrics, handle queueing."""

        # Check if queue is too full
        if self.waiting_count >= self.max_queue_size:
            # Calculate how long client should wait before retrying
            retry_after = self._estimate_retry_after()
            raise QueueOverflowError(self.waiting_count, retry_after)

        self.waiting_count += 1
        try:
            # Wait for available slot (this is the queue!)
            await self.semaphore.acquire()
            self.waiting_count -= 1
            self.inflight_count += 1

            start_time = time.time()
            yield  # Let the translation happen

            # Update average duration for retry-after estimates
            duration = time.time() - start_time
            alpha = config.RETRY_AFTER_ALPHA  # Smoothing factor (0.2)
            self.avg_duration_sec = alpha * duration + (1 - alpha) * self.avg_duration_sec

        finally:
            self.inflight_count -= 1
            self.semaphore.release()

    def _estimate_retry_after(self) -> int:
        """Smart calculation: how many waiting / how many slots * avg time per request."""
        if self.inflight_count == 0:
            return config.RETRY_AFTER_MIN_SEC

        # If 10 people waiting and 2 slots available, and each takes 5 seconds:
        # retry_after = (10 / 2) * 5 = 25 seconds
        retry_sec = (self.waiting_count / self.semaphore._value) * self.avg_duration_sec

        # Clamp between min and max
        return max(
            config.RETRY_AFTER_MIN_SEC,
            min(int(retry_sec), config.RETRY_AFTER_MAX_SEC)
        )
Qu’est-ce qui se passe ici?
- Sémaphore: Comme un bouncer dans un club.
max_inflight) - Gestionnaire de contexte (
@asynccontextmanager): Suivre automatiquement les mesures et nettoie - Réessai intelligent-après: Difère aux clients " qu'ils retournent en 25 secondes" selon la profondeur de la queue et le temps moyen de demande
- Moyenne de déplacement exponentiel: Élimination des pics dans la durée de la demande
- Pourquoi cela est important: Sous une charge lourde, retourne HTTP 429 au lieu d'être en train de se détruire ou de faire la queue infiniment
4. Symbole Maquillage magique
Préserve les caractères spéciaux (emojisM SK1 symboles) que les modèles de traduction risquent d'entraîner
# src/utils/symbol_masking.py
import re

def mask_symbols(text: str) -> tuple[str, dict[str, str]]:
    """Replace special symbols with placeholders before translation."""

    originals = {}
    masked_text = text
    placeholder_counter = 0

    # Pattern: Match emojis, symbols, special punctuation
    # \U0001F300-\U0001F9FF = emoji range
    # [\u2600-\u26FF\u2700-\u27BF] = misc symbols
    symbol_pattern = re.compile(
        r'[\U0001F300-\U0001F9FF\u2600-\u26FF\u2700-\u27BF'
        r'\u00A9\u00AE\u2122\u2139\u3030\u303D\u3297\u3299]+'
    )

    for match in symbol_pattern.finditer(text):
        symbol = match.group()
        placeholder = f"__SYMBOL_{placeholder_counter}__"
        originals[placeholder] = symbol
        masked_text = masked_text.replace(symbol, placeholder, 1)
        placeholder_counter += 1

    return masked_text, originals

def unmask_symbols(text: str, originals: dict[str, str]) -> str:
    """Restore original symbols after translation."""
    for placeholder, original in originals.items():
        text = text.replace(placeholder, original)
    return text
Utilisation par exemple:
# Before translation:
text = "Hello! 👋 Check out this cool feature 🚀"

# Mask symbols:
masked, originals = mask_symbols(text)
# masked = "Hello! __SYMBOL_0__ Check out this cool feature __SYMBOL_1__"
# originals = {"__SYMBOL_0__": "👋", "__SYMBOL_1__": "🚀"}

# Translate the masked text:
translated = translate(masked, "de")  # → "Hallo! __SYMBOL_0__ Schau dir diese coole Funktion an __SYMBOL_1__"

# Unmask symbols:
final = unmask_symbols(translated, originals)
# final = "Hallo! 👋 Schau dir diese coole Funktion an 🚀"
Qu’est-ce qui se passe ici?
- Méthode du regex: Correspond aux gammes Unicode d'emoji et de symboles spéciaux
- Système de placement: Échanges
👋avec__SYMBOL_0__à titre temporaire - Pourquoi cela est important: Les modèles de traduction sont parfois corrompus ou supprimés par les emojis.
5. Connaissance du texte intelligent
Divulgue les textes longs en morceaux qui correspondent aux limites du modèle tout en préservant les limites de la phrase:
# src/utils/text_processing.py
def chunk_sentences(sentences: list[str], max_chars: int = 900) -> list[list[str]]:
    """Group sentences into chunks that fit within model's max input length."""

    chunks = []
    current_chunk = []
    current_length = 0

    for sentence in sentences:
        sentence_len = len(sentence)

        # If this sentence alone is too long, it goes in its own chunk
        if sentence_len > max_chars:
            if current_chunk:
                chunks.append(current_chunk)
                current_chunk = []
                current_length = 0
            chunks.append([sentence])
            continue

        # If adding this sentence exceeds limit, start new chunk
        if current_length + sentence_len + 1 > max_chars:
            chunks.append(current_chunk)
            current_chunk = [sentence]
            current_length = sentence_len
        else:
            current_chunk.append(sentence)
            current_length += sentence_len + 1  # +1 for space

    # Don't forget the last chunk!
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def split_sentences(text: str, max_sentence_chars: int = 500) -> list[str]:
    """Split text into sentences, enforcing max length."""

    # Split on common sentence terminators
    sentences = re.split(r'([.!?…]+\s+)', text)

    result = []
    for sentence in sentences:
        if not sentence or sentence.isspace():
            continue

        # If sentence is too long, split on word boundaries
        if len(sentence) > max_sentence_chars:
            words = sentence.split()
            current = []
            current_len = 0

            for word in words:
                if current_len + len(word) + 1 > max_sentence_chars:
                    result.append(' '.join(current))
                    current = [word]
                    current_len = len(word)
                else:
                    current.append(word)
                    current_len += len(word) + 1

            if current:
                result.append(' '.join(current))
        else:
            result.append(sentence.strip())

    return result
Qu’est-ce qui se passe ici?
- Fractionnement de la Sentence: Utilise le regex pour séparer
.!?…tout en préservant la ponctuation - Échantillonnage insatisfaisant: Emballe autant de phrases que possible dans chaque morceau sans dépasser la limite
- Fractionnement de la frontière des mots: Si une seule phrase est trop longueM SK1 se divise sur les espaces au lieu de couper le milieu
- Pourquoi cela est important: Les modèles de traduction ont des limites d'entrées.
6. Détection du modèle async avec cache
Détecte dynamiquement les modèles de traduction disponibles à partir d’HuggingFace:
# src/services/model_discovery.py
import httpx
from datetime import datetime, timedelta

class ModelDiscoveryService:
    """Discovers available translation models with 1-hour cache."""

    def __init__(self):
        self._cache = {}  # Cache results to avoid hammering HuggingFace API
        self._cache_ttl = timedelta(hours=1)
        self._hf_api_base = "https://huggingface.co/api/models"

    async def discover_opus_mt_pairs(self, force_refresh: bool = False):
        """Query HuggingFace for all Helsinki-NLP Opus-MT models."""

        cache_key = "opus-mt"

        # Check cache first
        if not force_refresh and cache_key in self._cache:
            cached_data, cached_time = self._cache[cache_key]
            if datetime.now() - cached_time < self._cache_ttl:
                return cached_data  # Cache hit!

        # Cache miss - query HuggingFace API
        async with httpx.AsyncClient() as client:
            response = await client.get(
                self._hf_api_base,
                params={
                    "author": "Helsinki-NLP",
                    "search": "opus-mt",
                    "limit": 1000
                },
                timeout=30.0
            )
            models = response.json()

        # Extract language pairs from model names
        # Example: "Helsinki-NLP/opus-mt-en-de" → ("en", "de")
        pairs = []
        for model in models:
            model_id = model.get("modelId", "")
            if model_id.startswith("Helsinki-NLP/opus-mt-"):
                # Extract the language codes after "opus-mt-"
                lang_part = model_id.replace("Helsinki-NLP/opus-mt-", "")
                if "-" in lang_part:
                    src, tgt = lang_part.split("-", 1)
                    pairs.append({"source": src, "target": tgt})

        # Cache the results
        self._cache[cache_key] = (pairs, datetime.now())

        return pairs
Qu’est-ce qui se passe ici?
- Client Async HTTP (
httpx): Fait ne pas bloquer les demandes HTTP à HuggingFace - Cache fondée sur le temps: Enregistre les résultats pour 1 heure afin d'éviter de limiter le taux
- Partage des noms de modèles: Extraits
enetdedeHelsinki-NLP/opus-mt-en-de - Pourquoi cela est important: HuggingFace a des modèles 1200+ Opus-MTM SK3 Il faut toutes les interroger.
7. Détection automatique de l'appareil
Détecte et utilise automatiquement les GPU si elles sont disponibles:
# src/core/device.py
import torch

class DeviceManager:
    """Smart device selection with GPU auto-detection."""

    def __init__(self):
        self.use_gpu = self._should_use_gpu()
        self.device_index = self._resolve_device()
        self.device_str = "cpu" if self.device_index < 0 else f"cuda:{self.device_index}"

        # Auto-configure parallel translation slots based on device
        if self.device_index >= 0:
            # GPU: Run translations serially to avoid VRAM fragmentation
            self.max_inflight = 1
        else:
            # CPU: Can handle multiple translations in parallel
            self.max_inflight = config.MAX_WORKERS_BACKEND

        self._log_device_info()

    def _should_use_gpu(self) -> bool:
        """Check if GPU should be used."""
        if config.USE_GPU.lower() == "false":
            return False
        if config.USE_GPU.lower() == "true":
            return torch.cuda.is_available()
        # "auto" mode: use GPU if available
        return torch.cuda.is_available()

    def _resolve_device(self) -> int:
        """Returns device index: -1 for CPU, 0+ for CUDA."""
        if not self.use_gpu:
            return -1

        # Check if specific CUDA device requested
        if config.DEVICE and config.DEVICE.startswith("cuda:"):
            device_num = int(config.DEVICE.split(":")[1])
            return device_num

        return 0  # Use first GPU

    def _log_device_info(self):
        """Log device information at startup."""
        if self.device_index >= 0:
            gpu_name = torch.cuda.get_device_name(self.device_index)
            vram_gb = torch.cuda.get_device_properties(self.device_index).total_memory / 1e9
            logger.info(f"Using GPU: {gpu_name} ({vram_gb:.1f}GB VRAM)")
            logger.info(f"Max inflight translations: {self.max_inflight} (GPU mode)")
        else:
            cpu_count = os.cpu_count()
            logger.info(f"Using CPU ({cpu_count} cores)")
            logger.info(f"Max inflight translations: {self.max_inflight} (CPU mode)")

# Global singleton instance
device_manager = DeviceManager()
Qu’est-ce qui se passe ici?
- Détection du GPU: Utilise PyTorch pour vérifier si CUDA est disponible
- Auto-configuration: Ensembles
max_inflight=1sur GPU ( éviter la fragmentation du VRAM ) vsmax_inflight=4sur le CPU (maximise parallelism) - Choix de l'appareil: Peut cibler un GPU spécifique avec
DEVICE=cuda:1 - Enregistrement: Indique le nom du GPU et le VRAM au début de la débugging
- Méthode de l'unité: Une instance partagée dans toute l’application
8. Moyenne de déplacement exponentiel pour le retry
Réessai souple-après une estimation adaptée aux durées réelles de la demandeM SK1
# Snippet from QueueManager showing EMA calculation
def update_avg_duration(self, new_duration: float):
    """Update average duration using exponential moving average."""

    # EMA formula: new_avg = α × new_value + (1 - α) × old_avg
    # α = smoothing factor (0.0 to 1.0)
    #   - Higher α = more weight to recent values (faster adaptation)
    #   - Lower α = more weight to historical values (more stable)

    alpha = 0.2  # 20% weight to new value, 80% to historical

    self.avg_duration_sec = (
        alpha * new_duration +
        (1 - alpha) * self.avg_duration_sec
    )
Exemple:
# Initial average: 5.0 seconds
# New request takes: 10.0 seconds

# EMA calculation:
new_avg = 0.2 * 10.0 + 0.8 * 5.0
        = 2.0 + 4.0
        = 6.0 seconds

# Next request takes: 3.0 seconds
new_avg = 0.2 * 3.0 + 0.8 * 6.0
        = 0.6 + 4.8
        = 5.4 seconds
Qu’est-ce qui se passe ici?
- EMA (Exponential Moving AverageM SK1: Comme une moyenne pondérée qui accorde plus d’importance aux valeurs récentes
- Coefficient de réglage (αM SK1: Contrôle la rapidité avec laquelle nous adaptons aux changements
- Pourquoi pas une moyenne simple?: L’EMA s’adapte plus rapidement aux changements tout en filtrant les épingles
- Pourquoi cela est important: Rend les clients réalistes
Retry-Aftertemps qui s'adaptent à la charge actuelle du système
Ces modèles de code démontrent la production
- Gestion des ressources: Nettoyage explicite de la mémoire GPU
- Dégradation gracieuse: Fallback automatique entre les fournisseurs de modèles
- Traitement à l'aide de la pression arrière: Enchaînement + HTTP 429 au lieu des défaillances
- Intégrité des données: La masque des symboles préserve les caractères spéciaux
- Optimisation du rendement: Cache intelligenteM SK1 fragmentation, et traitement parallèle
- Observabilité: Enregistrement détaillé et suivi des mesures
Chacune de ces fonctionnalités permet de résoudre un problème de production réel qui causerait des défaillances, erreurs, ou une mauvaise expérience d'utilisateur sans ellesM SK2
Guide de configuration
Le service est hautement configurable par l'entremise de variables environnementales. C'est là ' le guide complet:
Sélection du périphérique
# Prefer GPU if available (default)
USE_GPU=auto

# Force GPU
USE_GPU=true

# Force CPU
USE_GPU=false

# Explicit device override
DEVICE=cuda:0
DEVICE=cpu
Configuration du modèle
# Model family selection (NEW in v2.0!)
MODEL_FAMILY=opus-mt   # Best quality (default)
MODEL_FAMILY=mbart50   # 50 languages, single model
MODEL_FAMILY=m2m100    # 100 languages, maximum coverage

# Auto-fallback between model families (NEW in v2.0!)
AUTO_MODEL_FALLBACK=1  # Enabled by default
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"  # Priority order

# Volume-mapped model cache (NEW in v2.0!)
MODEL_CACHE_DIR=/models  # Persistent cache directory

# Model arguments passed to transformers.pipeline
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
EASYNMT_MODEL_ARGS='{"torch_dtype":"bf16","cache_dir":"/models"}'

# Preload models at startup (reduces first-request latency)
PRELOAD_MODELS="en->de,de->en,fr->en"

# LRU cache capacity
MAX_CACHED_MODELS=6
Nouvelle configuration expliquée:
MODÈLE_FAMILY: Choisissez la famille de modèle à utiliser comme première
opus-mt: La meilleure qualitéM SK1 1200+ paires, modèles distinctsmbart50: Bonne qualitéM SK1 50 langues, modèle unique MSC4GBm2m100: Bonne qualitéM SK1 100 langues, modèle unique MSC4GB
AUTO_MODEL_FALLBACK: Essayer automatiquement d'autres familles si le pair n'est pas disponible
1(défaultM SK1 activé - couverture maximale0: Disabled - strict singleM SK2family mode
Modèle_FALLBACK_ORDER: Ordonnance de priorité pour le recul
- Par défaut:
"opus-mt,mbart50,m2m100"(première qualitéM SK1 - Solutions de rechange:
"m2m100,mbart50,opus-mt"(première couvertureM SK1
- Par défaut:
Modèle :: Entreposage durable du modèle par le biais de volumes Docker
- Établir à
/modelset le volume de la carte:-v ./model-cache:/models - Les modèles persistent tout au long de la réouverture du conteneur
- Cache partagée entre plusieurs conteneurs
- Établir à
torch_options de type d’allumage:
fp16(floatM SK1 2x plus rapide sur GPU, moitié de mémoireMSC4 perte de qualité négligeablebf16(bfloat16): Une meilleure stabilité numérique que fpM SK2 requiert des GPU modernesfp32(floatM SK1 Précision complète , la plus lente mais la plus précise
Paramètres de traduction
# Batch size for translation (higher = faster but more VRAM)
EASYNMT_BATCH_SIZE=16  # CPU: 8-16, GPU: 32-64

# Maximum text length per item
EASYNMT_MAX_TEXT_LEN=1000

# Maximum beam size (higher = better quality but slower)
EASYNMT_MAX_BEAM_SIZE=5

# Worker thread pools
MAX_WORKERS_BACKEND=1    # Translation workers
MAX_WORKERS_FRONTEND=2   # Language detection workers
Performance & en attente
# Enable request queueing (highly recommended)
ENABLE_QUEUE=1

# Max concurrent translations
# Auto: 1 on GPU, MAX_WORKERS_BACKEND on CPU
MAX_INFLIGHT_TRANSLATIONS=1

# Max queued requests before 429
MAX_QUEUE_SIZE=1000

# Per-request timeout (0 = disabled)
TRANSLATE_TIMEOUT_SEC=180

# Retry-After estimation
RETRY_AFTER_MIN_SEC=1      # Floor
RETRY_AFTER_MAX_SEC=120    # Ceiling
RETRY_AFTER_ALPHA=0.2      # EMA smoothing factor
Sanitisation de l'entrée
# Enable input filtering
INPUT_SANITIZE=1

# Minimum alphanumeric ratio (0.2 = 20%)
INPUT_MIN_ALNUM_RATIO=0.2

# Minimum character count
INPUT_MIN_CHARS=1

# Language code for undetermined/noise
UNDETERMINED_LANG_CODE=und
Traitement des Sentences
# Default sentence splitting behavior
PERFORM_SENTENCE_SPLITTING_DEFAULT=1

# Max chars per sentence before word-boundary split
MAX_SENTENCE_CHARS=500

# Max chars per chunk for batching
MAX_CHUNK_CHARS=900

# Sentence joiner
JOIN_SENTENCES_WITH=" "
Maquillage des symboles
# Enable symbol masking
SYMBOL_MASKING=1

# What to mask
MASK_DIGITS=1    # Mask 0-9
MASK_PUNCT=1     # Mask .,!? etc.
MASK_EMOJI=1     # Mask 😀🎉 etc.
Le comportement de la réponse
# Align response array length to input
ALIGN_RESPONSES=1

# Placeholder for failed items (when aligned)
SANITIZE_PLACEHOLDER=""

# Response format
EASYNMT_RESPONSE_MODE=strings    # ["translation1", "translation2"]
EASYNMT_RESPONSE_MODE=objects    # [{"text":"translation1"}, ...]
Pivot Fallback
# Enable two-hop translation via pivot
PIVOT_FALLBACK=1

# Pivot language (usually English)
PIVOT_LANG=en
Enregistrement
# Log level
LOG_LEVEL=INFO

# Per-request logging (verbose)
REQUEST_LOG=1

# Format
LOG_FORMAT=plain    # Human-readable
LOG_FORMAT=json     # Structured JSON

# File logging with rotation
LOG_TO_FILE=1
LOG_FILE_PATH=/var/log/marian-translator/app.log
LOG_FILE_MAX_BYTES=10485760    # 10MB
LOG_FILE_BACKUP_COUNT=5

# Include raw text in logs (privacy risk!)
LOG_INCLUDE_TEXT=0
Maintenance
# Periodically clear CUDA cache (seconds, 0=disabled)
CUDA_CACHE_CLEAR_INTERVAL_SEC=0
Gunicorn (Docker)
# Worker count (use 1 for single GPU)
WEB_CONCURRENCY=1

# Request timeout
TIMEOUT=60

# Graceful shutdown timeout
GRACEFUL_TIMEOUT=20

# Keep-alive timeout
KEEP_ALIVE=5
Exemples d'utilisation
Traduction de base
# GET request
curl "http://localhost:8000/translate?target_lang=de&text=Hello%20world&source_lang=en"

# Response
{
  "translations": ["Hallo Welt"]
}
Traduction par lot (Recommandée)
# POST request
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": [
      "Hello world",
      "This is a test",
      "Machine translation is amazing"
    ],
    "target_lang": "de",
    "source_lang": "en",
    "beam_size": 1,
    "perform_sentence_splitting": true
  }'

# Response
{
  "target_lang": "de",
  "source_lang": "en",
  "translated": [
    "Hallo Welt",
    "Das ist ein Test",
    "Maschinenübersetzung ist erstaunlich"
  ],
  "translation_time": 0.342
}
Détection automatique de la langue
# Omit source_lang for auto-detection
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": ["Bonjour le monde"],
    "target_lang": "en"
  }'

# Response
{
  "target_lang": "en",
  "source_lang": "fr",  # Detected
  "translated": ["Hello world"],
  "translation_time": 0.156
}
Détection linguistique seulement
# GET
curl "http://localhost:8000/language_detection?text=Hola%20mundo"
# {"language": "es"}

# POST with batch
curl -X POST http://localhost:8000/language_detection \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello", "Bonjour", "Hola"]}'
# {"languages": ["en", "fr", "es"]}
Points finals de l'observabilité
# Health check
curl http://localhost:8000/healthz
# {"status": "ok"}

# Readiness
curl http://localhost:8000/readyz
# {
#   "status": "ready",
#   "device": "cuda:0",
#   "queue_enabled": true,
#   "max_inflight": 1
# }

# Cache status
curl http://localhost:8000/cache
# {
#   "capacity": 6,
#   "size": 3,
#   "keys": ["en->de", "de->en", "fr->en"],
#   "device": "cuda:0",
#   "inflight": 1,
#   "queue_enabled": true
# }

# Model info
curl http://localhost:8000/model_name | jq
Traitement de la pression arrière
# When queue is full, you get 429
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["test"], "target_lang": "de"}'

# Response: 429 Too Many Requests
# Headers: Retry-After: 45
# Body:
{
  "message": "Too many requests; queue full",
  "retry_after_sec": 45
}

# Proper client behavior:
# 1. Read Retry-After header
# 2. Wait that long + jitter
# 3. Retry request
Construction et versionnement
Toutes les images de Docker incluent maintenant une version correcte et des métadonnées pour le suivi.
Fabrication rapide
Construire toutes les variantes 4 avec une version automatique de date-temps
Windows:
.\build-all.ps1
Linux/Mac:
chmod +x build-all.sh
./build-all.sh
Stratégie de mise en version
Chaque construction crée deux balises:
- Nom de l'étiquette (
latest,min,gpu,gpu-min) - indique toujours le plus récent - Tag de version (eM SK1g.,
20250108.143022) - prise de vue immuable
Exemples:
# Always get the latest version
docker pull scottgal/mostlylucid-nmt:cpu
# Or use the :latest alias
docker pull scottgal/mostlylucid-nmt:latest

# Pin to a specific version for reproducibility
docker pull scottgal/mostlylucid-nmt:cpu-20250108.143022
docker pull scottgal/mostlylucid-nmt:cpu-min-20250108.143022
Étiquettes de l'OCI
Chaque image comprend des métadonnées:
- Version: Établissement de l'échéancier (YYYYMMDDM SK2HHMMSS)
- Date de constructionIndicateur de temps : ISO 8601
- Engagement de Git: Short SHA
- Variant: cpu-fullM SK2 cPUMST3minMSC4 gpu -full+, ou gpu=-min
Inspecter les étiquettes:
docker inspect scottgal/mostlylucid-nmt:cpu | jq '.[0].Config.Labels'
Pour des instructions détaillées sur la construction et l’intégration de CI/CD,, voir BUILD.md.
Déploiement
Déploiement du CPU
# Using pre-built image from Docker Hub (recommended)
docker run -d \
  --name translator \
  -p 8000:8000 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=500 \
  -e EASYNMT_BATCH_SIZE=16 \
  -e TIMEOUT=180 \
  -e LOG_LEVEL=INFO \
  -e REQUEST_LOG=0 \
  scottgal/mostlylucid-nmt

# Or build locally
docker build -t mostlylucid-nmt .
docker run -d --name translator -p 8000:8000 mostlylucid-nmt

# Check logs
docker logs -f translator
Déploiement du GPU
# Using pre-built GPU image from Docker Hub (recommended)
docker run -d \
  --name translator-gpu \
  --gpus all \
  -p 8000:8000 \
  -e USE_GPU=true \
  -e DEVICE=cuda:0 \
  -e PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en" \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  -e EASYNMT_BATCH_SIZE=64 \
  -e MAX_CACHED_MODELS=8 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=2000 \
  -e WEB_CONCURRENCY=1 \
  -e TIMEOUT=180 \
  -e GRACEFUL_TIMEOUT=30 \
  -e LOG_FORMAT=json \
  -e LOG_TO_FILE=1 \
  -v /var/log/translator:/var/log/marian-translator \
  scottgal/mostlylucid-nmt:gpu

# Or build locally
docker build -f Dockerfile.gpu -t mostlylucid-nmt:gpu .
docker run -d --name translator-gpu --gpus all -p 8000:8000 mostlylucid-nmt:gpu

# Monitor cache and performance
watch -n 5 "curl -s http://localhost:8000/cache | jq"
Docker Compose
version: '3.8'

services:
  translator:
    image: scottgal/mostlylucid-nmt:gpu  # Use pre-built image
    container_name: translator
    restart: unless-stopped

    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]

    ports:
      - "8000:8000"

    environment:
      USE_GPU: "true"
      DEVICE: "cuda:0"
      PRELOAD_MODELS: "en->de,de->en,en->fr,fr->en"
      EASYNMT_MODEL_ARGS: '{"torch_dtype":"fp16"}'
      EASYNMT_BATCH_SIZE: "64"
      MAX_CACHED_MODELS: "8"
      ENABLE_QUEUE: "1"
      MAX_QUEUE_SIZE: "2000"
      WEB_CONCURRENCY: "1"
      TIMEOUT: "180"
      LOG_FORMAT: "json"
      LOG_TO_FILE: "1"

    volumes:
      - translator-logs:/var/log/marian-translator
      - translator-cache:/root/.cache/huggingface

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/healthz"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s

volumes:
  translator-logs:
  translator-cache:
Utilisation de Kubernetes
apiVersion: apps/v1
kind: Deployment
metadata:
  name: translator
spec:
  replicas: 2  # Scale horizontally for CPU, use 1 per GPU
  selector:
    matchLabels:
      app: translator
  template:
    metadata:
      labels:
        app: translator
    spec:
      containers:
      - name: translator
        image: scottgal/mostlylucid-nmt:gpu
        ports:
        - containerPort: 8000
        env:
        - name: USE_GPU
          value: "true"
        - name: EASYNMT_MODEL_ARGS
          value: '{"torch_dtype":"fp16"}'
        - name: PRELOAD_MODELS
          value: "en->de,de->en"
        - name: ENABLE_QUEUE
          value: "1"
        - name: MAX_QUEUE_SIZE
          value: "2000"

        resources:
          requests:
            memory: "4Gi"
            cpu: "2"
            nvidia.com/gpu: 1
          limits:
            memory: "8Gi"
            cpu: "4"
            nvidia.com/gpu: 1

        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10

        readinessProbe:
          httpGet:
            path: /readyz
            port: 8000
          initialDelaySeconds: 20
          periodSeconds: 5

---
apiVersion: v1
kind: Service
metadata:
  name: translator
spec:
  selector:
    app: translator
  ports:
  - port: 80
    targetPort: 8000
  type: LoadBalancer
Optimisation du rendement
Liste de vérification de l'optimisation des GPU
Utiliser la précision FP16
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'- 2x inference plus rapide
- La moitié de l'utilisation du VRAM
- Perte de qualité négligeable pour la traduction
Taille du lot tuné
# Start high, reduce if you get OOM
EASYNMT_BATCH_SIZE=64  # Try 128 on large GPUs
Précharger les modèles chauds
PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en"Un seul travailleur par GPU
WEB_CONCURRENCY=1
MAX_INFLIGHT_TRANSLATIONS=1
Augmenter la taille du cache
MAX_CACHED_MODELS=10 # Keep more models in VRAMDiminution de la taille du faisceau pour le débit
# beam_size=1 is 3-5x faster than beam_size=5
# Quality difference is often minimal
curl -X POST ... -d '{"beam_size": 1, ...}'
Liste de vérification de l'optimisation du CPU
Taille inférieure du lot
EASYNMT_BATCH_SIZE=8Accroître le parallèle
MAX_WORKERS_BACKEND=4
MAX_INFLIGHT_TRANSLATIONS=4
WEB_CONCURRENCY=2
Disablez la séparation de phrases pour les textes courts
PERFORM_SENTENCE_SPLITTING_DEFAULT=0
Pratiques exemplaires des clients
Demandes de lots
// Bad: 100 separate requests
for (const text of texts) {
  await translate(text);
}

// Good: 1 batch request
await translate(texts);
Respect Retry-After
async function translateWithRetry(texts) {
  try {
    return await translate(texts);
  } catch (err) {
    if (err.status === 429) {
      const retryAfter = err.headers['retry-after'];
      const jitter = Math.random() * 5;
      await sleep((retryAfter + jitter) * 1000);
      return translateWithRetry(texts);
    }
    throw err;
  }
}
Utiliser la mise en commun des connexions
// Reuse HTTP connections
const agent = new https.Agent({ keepAlive: true });
Groupe par paire de langue
// Bad: mixed language pairs in one request
translate([
  { text: "Hello", sourceLang: "en", targetLang: "de" },
  { text: "Bonjour", sourceLang: "fr", targetLang: "de" }
]);

// Good: group by language pair
translateBatch(enToDe, "en", "de");
translateBatch(frToDe, "fr", "de");
Surveillance & Observabilité
Mesures clés à suivre
- Efficience de la traduction (requêtesM SK1sec)
- La latence moyenne (pM SK1 p95, p≥99)
- La profondeur de la queue (Contrôle d'attente couranteM SK1
- Taux de saisie du cache (% de demandes atteignant le cache)
- Taux d'erreur (5xx réponsesM SK1
- Utilisation du GPU (le cas échéantM SK1
- Utilisation de la mémoire (VRAM pour GPU , RAM pour CPU)
Exemple Prometheus Metrics
Si vous intègrenz Prometheus (non construiteM SK1dans , mais facile à ajouter):
translation_requests_total{lang_pair="en->de",status="success"} 1523
translation_requests_total{lang_pair="en->de",status="error"} 7
translation_duration_seconds{lang_pair="en->de",quantile="0.5"} 0.342
translation_duration_seconds{lang_pair="en->de",quantile="0.95"} 1.234
translation_queue_depth 23
translation_cache_size 6
translation_cache_hits_total 8234
translation_cache_misses_total 142
Exemple d'enregistrement structuré
# Enable JSON logging
LOG_FORMAT=json REQUEST_LOG=1

# Output example
{
  "ts": "2025-01-08T15:30:45+0000",
  "level": "INFO",
  "name": "app",
  "message": "translate_post done items=5 dt=0.342s",
  "req_id": "a3d2f5b1-c4e6-4f7a-9d8c-1e2f3a4b5c6d",
  "endpoint": "/translate",
  "src": "en",
  "tgt": "de",
  "items": 5,
  "duration_ms": 342
}
Vous pouvez l’acheminer à Elasticsearch, CloudWatch, ou à tout aggregateur de logsM SK2
Comparaison: EasyNMT vs MostlyLucid-NMT
| Caractéristiques | EasyNMT | MostlyLucid-NMT |
|---|---|---|
| La stabilité | Crashes fréquemment | Production-readyM SK3 graceful error handling MSC4 |
| Traitement des intrants | Défaut sur les emojisM SK1symboles | Sanitation robuste |
| Pression arrière | Aucune, OOMs sous charge | Semaphore + cote avec retryM SK4après |
| Observabilité | Minimale | Santé/réalisteM SK3points de clôture de la cacheMSC4 registres structurés |
| Soutien GPU | CUDA 10.x (ancient) M | Cuda R12.6, FPM SK6BFMSC7 support P |
| Gestion des modèles | ManuelM SK1 sans cache | Cache LRU avec auto-élimination |
| Traitement des Sentences | Fractionnement de base | Partitionner intelligente |
| Traduction Pivot | Non | Retour automatique par l'anglais |
| Fermeture gracieuse | Non | |
| Configuration | Limitée | 40+ vars d'env pour les fins finesM SK3tuning M |
| Compatibilité de l'API | Points de fin EasyNMT | MSC2 compatibles SMC3 prolongations SMC4 |
| Qualité du code | Non maintenuM SK1 monolithique | Modulaire, typedMSC4 testé |
Troubleshooting
429 Trop de demandes
Cause: La liste est complète.
Solution:
- Accroître
MAX_QUEUE_SIZE - Ajouter plus de répliques (échelle horizontale)
- Accroître
MAX_INFLIGHT_TRANSLATIONS(si vous avez une salle de directionM SK1 - Réduire les tailles de lots des clients
503 Service non disponible
Cause: Incapacité de faire la queue et tous les slots occupés.
Solution:
- Activer la cote d’attente:
ENABLE_QUEUE=1 - Augmenter la limite d'influence si vous avez des ressources
OOM (Out of Memory) on GPU
Cause: La taille du lot trop élevée ou trop de modèles cachés.
Solution:
- Réduire
EASYNMT_BATCH_SIZE - Réduire
MAX_CACHED_MODELS - Activer FP16:
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' - Assurer
WEB_CONCURRENCY=1etMAX_INFLIGHT_TRANSLATIONS=1
Requête initiale lente
Cause: Modèle non préchargé.
Solution:
PRELOAD_MODELS="en->de,de->en"
Paire de langues disparues
Cause: Helsinki-NLP/opus-mt-{src}-{tgt} n’existe pas sur Hugging Face.
Solution:
- Activer le retrait du pivot:
PIVOT_FALLBACK=1(routes via l'anglais) - Vérifier les paires supportées:
curl http://localhost:8000/lang_pairs
Symbole Artifacts dans la traduction
Cause: La masque de symboles peut être trop agressive.
Solution:
- Disabler la masque spécifique:
MASK_EMOJI=0ouMASK_PUNCT=0 - Ou désactiver complètement:
SYMBOL_MASKING=0
Intégration avec ASP.NET
Si vous ' suivez les articles précédents sur l’intégration EasyNMT , ici
public class MostlyLucidNmtClient
{
    private readonly HttpClient _httpClient;
    private readonly string _baseUrl;

    public MostlyLucidNmtClient(HttpClient httpClient, string baseUrl)
    {
        _httpClient = httpClient;
        _baseUrl = baseUrl;
    }

    public async Task<TranslationResponse> TranslateAsync(
        List<string> texts,
        string targetLang,
        string sourceLang = "",
        int beamSize = 1,
        bool performSentenceSplitting = true,
        CancellationToken cancellationToken = default)
    {
        var request = new TranslationRequest
        {
            Text = texts,
            TargetLang = targetLang,
            SourceLang = sourceLang,
            BeamSize = beamSize,
            PerformSentenceSplitting = performSentenceSplitting
        };

        var response = await _httpClient.PostAsJsonAsync(
            $"{_baseUrl}/translate",
            request,
            cancellationToken);

        if (response.StatusCode == System.Net.HttpStatusCode.TooManyRequests)
        {
            // Read Retry-After header
            var retryAfter = response.Headers.RetryAfter?.Delta?.TotalSeconds ?? 30;
            var jitter = Random.Shared.Next(0, 5);
            await Task.Delay(TimeSpan.FromSeconds(retryAfter + jitter), cancellationToken);

            // Retry
            return await TranslateAsync(texts, targetLang, sourceLang, beamSize,
                performSentenceSplitting, cancellationToken);
        }

        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<TranslationResponse>(cancellationToken);
    }
}

public class TranslationRequest
{
    [JsonPropertyName("text")]
    public List<string> Text { get; set; }

    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("beam_size")]
    public int BeamSize { get; set; }

    [JsonPropertyName("perform_sentence_splitting")]
    public bool PerformSentenceSplitting { get; set; }
}

public class TranslationResponse
{
    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("translated")]
    public List<string> Translated { get; set; }

    [JsonPropertyName("translation_time")]
    public double TranslationTime { get; set; }
}
Inscrivez-vous dans votre contenant DI:
services.AddHttpClient<MostlyLucidNmtClient>(client =>
{
    client.BaseAddress = new Uri("http://translator:8000");
    client.Timeout = TimeSpan.FromMinutes(3);
});
Conclusion
Plus particulièrementLucid-NMT est une réécriture complète du concept EasyNMT en gardant à l’esprit la fiabilité de production Version 2.0 l'amène au niveau suivant avec multi-support familial modèle et rétroaction intelligenteM SK1
Ce qui rend v2.0 spécial
1. Couverture linguistique maximale
- Appui aux langues 100+ dans toutes les trois familles modèles
- Auto-fallback vous garantit que vous n'avez jamais battu "parité linguistique non supportéeM SK2
- Dispositifs de déploiement uniques 9,900+ paires de traduction
2. Qualité - Première approche
- Priorité accordée au meilleur modèle disponible pour chaque couple
- Opus-MT M SK1la qualité la plus élevée) → mBARTMSC4 ≥→ MMNK6MMRK7 commande de rappel
- L'enregistrement transparent montre quel modèle a été utilisé
3. Déploiement souple
- Un seul répertoire Docker avec des variantes 4
- Images minimales pour l'espace-environnements restreints
- Volume-cache mapped pour la persistance du modèle
- Changer les familles de modèle sans reconstruire
4. Production-Ready
- Messy real-input du monde M SK1emoji , symboles, cases de bordMSC4
- Charge de production (retournement,pressure d'arrièreM SK2 dégradation graceful )
- Efficacité des GPU (FP16, Cache LRUM SK2 Gestion du VRAM )
- Visibilité opérationnelle (checks de santé, métriquesM SK2 registres structurés )
- Expérience des développeurs (100% EasyNMT API compatibleM SK1 documents complets)
Utilisation mondiale
Le service a été battu-essai de traduire des milliers d’articles sur blog à travers 100+ langues (à partir de 13 en v1.0!). Il fonctionne avec fiabilité dans la production à la fois sur le CPU et le GPUM SK3 gère le trafic spiky gracieusementMSC4 et fournit des sous-traductions -secondes pour les contenus typiques du blogMNK6
Key Takeaways
- Couplage maximal: 100+ langues
- Qualité première: Priorité accordée au meilleur modèle disponible, sélection transparente
- Robustness: Sanitisation de l'entrée, manipulation des erreurs, fermeture gracieuse
- Ressources intelligentes: Cacheur LRU,pression arrière,auto VRAMM SK2élimination
- Observabilité: Contrôles de santé, état du cache, découverte des modèlesM SK2 registres structurés
- Performance: FP16, battageM SK1 préchargement, multiMSC3appui familial
- Developer friendly: EasyNMT-API compatibleM SK1 configuration détaillée, erreurs claires
- Déploiement simple: Contenant Docker unique, Aucune configuration complexe
Réminder de début rapide
# Maximum coverage with auto-fallback (recommended!)
docker run -d -p 8000:8000 \
  -v ./model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  -e AUTO_MODEL_FALLBACK=1 \
  -e MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100" \
  scottgal/mostlylucid-nmt:cpu-min

# GPU with best quality
docker run -d --gpus all -p 8000:8000 \
  -e USE_GPU=true \
  -e MODEL_FAMILY=opus-mt \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu

# Test it
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello world"], "target_lang": "de"}'
Qu’est-ce que's Suivant?
Le service tout entier est un seul conteneur Docker. Aucune configuration complexe, aucune dépendance externe au-delà des téléchargements du modèle Hugging FaceM SK2
Just pull, run , and translate M SK2 languages with the best available models!
Bonne traduction!
Autres lectures
- Helsinki-NLP Opus-MT Modèles
- Hugging Face Transformers Documentation
- Documentation FastAPI
- Optimisation de PyTorch CUDA
Code de source
Le code source complet est disponible à : [votre-repoM SK1link]. Bienvenue à vos contributions !
Mots clés
Translation NMT Neural Machine Translation Python FastAPI Docker CUDA PyTorch Transformers Helsinki-NLP Production Microservices API