This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Sunday, 16 November 2025
Όταν τα εργαλεία σας παρακολουθούν τον εαυτό τους, εξελίσσονται, και επιλέγουν τον εαυτό τους
Σημείωση: Αυτό είναι το Μέρος 8 στη Semantic Intelligence σειρά. Μέρος 7 κάλυψε τη συνολική αρχιτεκτονική DSE. Αυτό το άρθρο βουτάει βαθιά σε κάτι που γύρισε πάνω: πώς τα ίδια τα εργαλεία λειτουργούν, χρησιμοποιούν κομμάτι, εξελίσσονται, και γίνονται πιο έξυπνοι με το χρόνο.
Σημείωση: Αν πιστεύατε ότι η εξέλιξη της ροής εργασίας στο Μέρος 7 ήταν άγρια, περιμένετε μέχρι να δείτε τι συμβαίνει όταν κάθε εργαλείο έχει τις ίδιες δυνατότητες.
Στο Μέρος 7, σας έδειξα Directed Synthetic Evolution: workflows που το σχέδιο, παράγουν, εκτελούν, αξιολογούν και βελτιώνουν.
Άκου τι δεν εξήγησα:
Αυτά τα εργαλεία δεν είναι στατικά, δεν είναι αρχεία ρυθμίσεων που κάθονται εκεί αμετάβλητα.
Είναι ζωντανά αντικείμενα που:
Με άλλα λόγια: Τα εργαλεία είναι κόμβοι, οι κόμβοι είναι εργαλεία, όλα εξελίσσονται.
Και γίνεται πιο παράξενο.
Επιτρέψτε μου να σας δείξω τι πραγματικά έχει το σύστημα:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
Αυτό index.json? 5,464 γραμμές των ορισμών εργαλείων, στατιστικών χρήσης, ιστορία έκδοσης, βαθμολογία γυμναστικής, και παρακολούθηση γενεαλογίας.
Κάθε εργαλείο εκεί μέσα:
ΣΗΜΕΙΩΣΗ: Το σύστημα θα λειτουργεί πραγματικά χωρίς οποιαδήποτε εργαλεία. Απλά λιγότερο αποτελεσματικά; και πιο χαζή. Χωρίς αυτά τα εργαλεία θα παράγονται ως ένα φυσιολογικό μέρος της αποσύνθεσης ροής εργασίας.
Ας δούμε τι εργαλείο είναι στην πραγματικότητα.
Εδώ είναι ένας πραγματικός ορισμός εργαλείων από το σύστημα:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Προσέξτε τι υπάρχει εκεί:
Αλλά άκου τι θα γίνει. Όχι, όχι. στο YAML:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Το σύστημα Αυξήσεις Στατικοί ορισμοί με τη μάθηση runtime.
Εδώ είναι τι συμβαίνει όταν χρησιμοποιείτε ένα εργαλείο:
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Αυτό που ανιχνεύεται
Ας δούμε τον μηχανισμό αποθήκευσης.
Το πιο έξυπνο κομμάτι: το σύστημα συγκρατεί τις κλίσεις εργαλείων σε πολλαπλά επίπεδα.
Επίπεδο 1: Ακριβής αποθήκευση ταίριασμα
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Γιατί αυτό μετράει:
Αν ζητήσετε από το σύστημα να "γράψει ένα haiku σχετικά με τον κώδικα" δύο φορές, η δεύτερη φορά είναι στιγμιαίαΤο LLM δεν τρέχει, η μνήμη του RAG επιστρέφει το αποτέλεσμα.
Αλλά εδώ είναι το έξυπνο κομμάτι: επιστρέφει την BEST έκδοση εάν υπάρχουν πολλαπλάσια.
Παράδειγμα:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Το σύστημα αυτόματα επιλέγει το αποτέλεσμα υψηλής ποιότητας cached.
Ένα από τα χαρακτηριστικά του υποδεέστερου: το σύστημα μαθαίνει πόσο χρόνο χρειάζεται κάθε μοντέλο για να ανταποκριθεί.
Το πρόβλημα:
Διαφορετικά μοντέλα έχουν εξαιρετικά διαφορετικούς χρόνους απόκρισης:
tinyllama (2B): ~3 δευτερόλεπταllama3 (8B): ~10 δευτερόλεπταqwen2.5-coder (14B): ~25 δευτερόλεπταdeepseek-coder-v2 (16B): ~60 δευτερόλεπταΑν ορίσετε ένα παγκόσμιο timeout (πείτε, 30s), σπαταλάτε 27 δευτερόλεπτα περιμένοντας tinyllama, και σκοτώνεις deepseek Πριν τελειώσει.
Η Λύση: Προσαρμόζουσα Μάθηση
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Πώς λειτουργεί:
Αποτελέσματα:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Το σύστημα μαθαίνει το σωστό τάιμ-άουτ για κάθε μοντέλο αντί να χρησιμοποιήσει μια παγκόσμια αξία.
Όταν ζητάτε από το σύστημα να κάνει κάτι, δεν διαλέγει μόνο το πρώτο εργαλείο που ταιριάζει. λειτουργία γυμναστικής σε πολλαπλές διαστάσεις.
Υπολογισμός ικανότητας:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Πραγματικό παράδειγμα:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Επιλεγμένη: email_validator_workflow (εξάρτηση: 190)
Το σύστημα επιλέγει το γρήγορος, ελεύθερος, υψηλής ποιότητας, αποδεδειγμένος Δεν είναι το πιο σημασιολογικά παρόμοιο, όχι το πιο ισχυρό.
Αυτή που ικανοποιεί με τον καλύτερο τρόπο πολλούς περιορισμούς.
Τα εργαλεία δεν μένουν στατικά.
Ανίχνευση εκδοχής & αλλαγής:
Κάθε εργαλείο έχει ένα ορισμός χασίς που υπολογίζεται από το YAML του:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
Όταν επεξεργαστείτε το YAML ενός εργαλείου:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Με το επόμενο φορτίο:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Σημασιολογική εκδοχή:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Σπάζοντας αλλαγές:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Επί του φορτίου:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Το σύστημα Σε προειδοποιεί για σπάσιμο αλλαγών και διατηρεί το ιστορικό έκδοσης.
Κάθε εργαλείο παίρνει δεικτών στη μνήμη RAG για σημασιολογική αναζήτηση:
Κατά την ώρα φόρτωσης:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Τώρα όταν ψάχνετε:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Το σύστημα χρησιμοποιεί Άρθρο 4 παράγραφος 1 στοιχείο α) σημείο ii) και άρθρο 4 παράγραφος 1 στοιχείο β) του κανονισμού (ΕΕ) αριθ. 575/2013 για να βρείτε τα σχετικά εργαλεία, στη συνέχεια τα ταξινομεί με πολυδιάστατη φυσική κατάσταση.
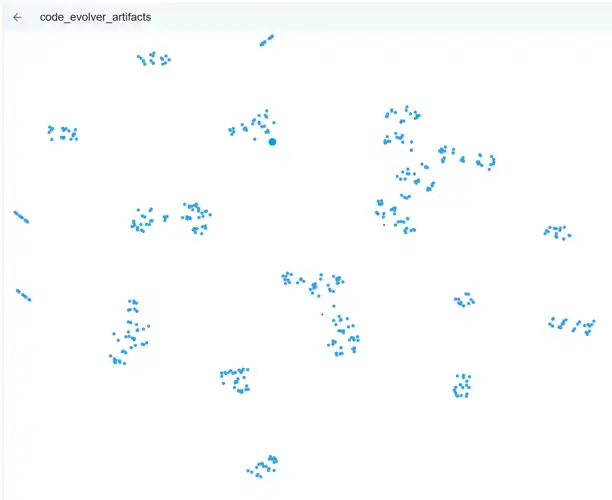
Στο σύστημά μας κρατάμε τα διανυσματικά μέσα για την ενσωμάτωση σε QdrantCity name (optional, probably does not need a translation) μια διανυσματική βάση δεδομένων και μας δίνει έναν καλό τρόπο για να δούμε πώς ο χώρος εργαλείων μας. Αυτό είναι το σύστημα μνήμης του συστήματος κατασκευής ροής εργασίας μας.
Διαιρείται στα πρωτότυπα πρότυπα (αρχεία yaml στον κατάλογο εργαλείων) και κάθε στοιχείο του κώδικα που παράγεται για την επίλυση μιας εργασίας (και config για llms κ.λπ.). Αυτά τα σχήματα σε εργαλειοθήκη για τη συναρμολόγηση εργαλειομηχανών. Προκατασκευασμένα κομμάτια που κυμαίνονται από;
Με αυτόν τον τρόπο όλο το workdlow είναι συνθετό και δοκιμάσιμο καθώς κάθε στοιχείο Python έχει μια σουίτα των δοκιμών, BDD spec, στατικά εργαλεία για την επαλήθευση της ορθότητας και πολλών αξιολογητών LLM για να εξασφαλίσει ότι λειτουργεί.
Η παρενέργεια είναι ΚΑΘΕ κομμάτι κώδικα που θα τρέξει σε μια ροή εργασίας είναι ακριβώς εκεί, έτοιμο να επιθεωρήσει, καθώς κάθε "εργαλείο" δημιουργία οδηγεί σε επιθεωρήσιμες αποχρώσεις Python.
Μπορείτε να δείτε τα toos clumoing μαζί με κάθε blob είναι ένα σημασιολογικά συνδεδεμένο σύνολο εργαλείων όπως:
Φυσικά, ειδικεύοντας το σύστημα από τη φύση του.
Στο μέλλον θα θέλαμε να βελτιστοποιήσουμε αυτές τις συστάδες για να μειώσουμε την βάση κώδικα σε ένα μικρότερο, πιο σφιχτό, πιο βελτιστοποιημένο σύστημα.
Καθώς μπορούμε να εντοπίσουμε εκδόσεις, χρήσεις, αλλαγές και ψέμα μπορούμε να βελτιστοποιήσουμε επιλεκτικά και "cluster defrag" τις πιο χρησιμοποιούμενες και τις περισσότερες κριτικές επιδόσεις comopents ως μέρος του πώς το σύστημα είναι εγγενώς δομημένο.
Ας δούμε τι πραγματικά υπάρχει στο σύστημα τώρα.
Εργαλεία LLM (27 ειδικοί):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Εκτελέσιμα εργαλεία:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
Εργαλεία OpenAPI:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Σύνολο εργαλείων: 50+
Σύνολο γραμμών μεταδεδομένα: 5,464 γραμμές σε index.json
Επιτρέψτε μου να σας δείξω το πιο εξελιγμένο εργαλείο στο σύστημα: code_optimizer.
Ορισμός: tools/llm/code_optimizer.yaml (317 γραμμές!)
Τι κάνει:
Ιεραρχική Βελτιστοποίηση:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Διαχείριση κόστους:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Ενσωμάτωση δοκιμής:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Διαχείριση έκδοσης:
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Αυτό ενιαίο εργαλείο ορχήστρα:
Και είναι μόνο ένα εργαλείο σε σύστημα με Εργαλεία 50+.
Ένα από τα πιο μεταεργαλεία: model_selector.
Επιλογή Φυσικής Γλώσσας:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Πώς Λειτουργεί:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Το σύστημα παριστάνει τη φυσική γλώσσα Μπορείτε να πείτε:
Και οδηγεί έξυπνα προς το δεξί σύστημα υποστήριξης.
Το σύστημα αντιμετωπίζει εξωτερικά API όπως τα εσωτερικά εργαλεία.
Παράδειγμα: Μεταφραστής NMT
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Κατά τη διάρκεια του τρεξίματος:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Αυτό που ανιχνεύεται
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Τα εξωτερικά APIs λαμβάνουν την ίδια θεραπεία:
Ένα από τα πιο άγρια εργαλεία: workflow_documenter.
Τι κάνει:
Παίρνει μια ροή εργασίας (a main.py αρχείο) και δημιουργεί αυτόματα πλήρη τεκμηρίωση από:
README.txtΌλα αυτόματα.
Ορισμός: tools/llm/workflow_documenter.yaml (11.803 χαρακτήρες!)
Είσοδος:
{
    "workflow_path": "nodes/email_validator/main.py"
}
Έξοδος:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
Ερ: Μπορεί αυτό να επιβεβαιώσει αν υπάρχει ένα email; A: Όχι, αυτό επικυρώνει μόνο τη μορφή. Χρησιμοποιήστε DNS / SMTP έλεγχος για την ύπαρξη.
Ε: Υποστηρίζει διεθνείς τομείς; Α: Ναι, αλλά μπορεί να χρειαστεί μετατροπή μικροκώδικα.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Χρήστης: "Χρειάζομαι ένα εργαλείο που μετατρέπει τις θερμοκρασίες"
Σύστημα:
Νέο εργαλείο που δημιουργήθηκε: θερμοκρασία_converter.yaml
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Το σύστημα ξέρει:
Και αυτό χρησιμοποιεί αυτά τα δεδομένα έως:
Ας κάνουμε πίσω και να σκεφτούμε τι έχουμε πραγματικά χτίσει:
Σύστημα όπου:
Δημιουργήσαμε μια αυτο-βελτιωτική εργαλειοθήκη που:
Αυτό δεν είναι διαχείριση ρυθμίσεων.
Αυτή είναι αναδυόμενη οικολογία εργαλείων.
Τα εργαλεία δεν είναι στατικοί πόροι. ζωντανά αντικείμενα σε ένα εξελικτικό σύστημα.
Σενάριο 1: Αυτοβελτίωση Κρίσιμης Διαδρομής
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Το σύστημα βελτιστοποίησε το δικό του κρίσιμο μονοπάτι χωρίς ανθρώπινη παρέμβαση.
Σενάριο 2: Προσαρμοστική εξειδίκευση
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Το σύστημα εντόπισε ένα μοτίβο και δημιούργησε ένα εξειδικευμένο εργαλείο.
Σενάριο 3: Cost-Aware Escalation
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Το σύστημα ξόδεψε χρήματα έξυπνα για να επιτύχει καλύτερα αποτελέσματα.
Επιτρέψτε μου να καταγράψω τι πραγματικά υπάρχει αυτή τη στιγμή.
Ειδικός κωδικός
code_explainer - Εξηγεί τον κώδικα στη φυσική γλώσσαcode_optimizer - Ιεραρχική βελτιστοποίηση (τοπική/cloud/βαθιά)code_reviewer - Αξιολόγηση της ποιότητας και της ασφάλειαςfast_code_generator - Γρήγορη γενιά με μικρά μοντέλαsecurity_auditor - Σάρωση ευπάθειαςperformance_profiler - Κωδικό προφίλ και ανάλυσηΕιδικοί Περιεχομένου:
long_form_writer - Μυθιστορήματα, βιβλία (128K context)content_generator - Γενικό περιεχόμενοarticle_analyzer - Δομή του άρθρου/ποιότηταsummarizer - Συνοψίζει το μεγάλο περιεχόμενοproofreader - Γραμματική και στυλseo_optimizer - Βελτιστοποίηση SEOoutline_generator - Περιγράμματα περιεχομένουΜετάφραση:
quick_translator - Γρήγορη μετάφραση (μικρό μοντέλο)translation_quality_checker - Επικυρώνει τις μεταφράσειςΤεκμηρίωση:
doc_generator - Τεκμηρίωση κώδικαtechnical_writer - Τεχνική τεκμηρίωσηworkflow_documenter - Auto-generates workflow docsΕργαλεία συστήματος:
general - Επιστροφή γενικού σκοπούmodel_selector - Επιλέγει το καλύτερο backend/modeltask_to_workflow_router - Δρομολόγια εργασιών για τις ροές εργασίαςquick_feedback - Γρήγορη δοκιμή.signalr_connection_parser - Συνδέσεις Parses SignalRsignalr_llmapi_management - Διαχείριση SignalR LLM APIsΕπιβεβαίωση:
call_tool_validator - Επικυρώνει τη χρήση call_tool()python_syntax_validator - Έλεγχος σύνταξηςmypy_type_checker - Στατικός έλεγχος τύπουjson_output_validator - Επικύρωση μορφής JSONstdin_usage_validator - Επικυρώνει τη χρήση stdinmain_function_checker - Έλεγχος της κύριας λειτουργίαςnode_runtime_import_validator - Επικυρώνει τις εισαγωγέςΑνάλυση:
run_static_analysis - Λειτουργεί εργαλεία στατικής ανάλυσηςperformance_profiler - Απόδοση κώδικα προφίλΒοηθητικά προγράμματα:
save_to_disk - Επιμονή δίσκουunit_converter - Μετατροπές μονάδαςrandom_data_generator - Παραγωγή δεδομένων δοκιμήςbuffer - Διαχείριση προφυλακτήραworkflow_datastore - Αποθήκευση δεδομένων ροής εργασίαςstream_processor - Επεξεργασία ρεύματοςsse_stream - Εκδηλώσεις server-sentΕνσωμάτωση:
connect_signalr - Σύνδεση Signersignalr_hub_connector - Σύνδεση Hubsignalr_websocket_stream - WebSocket streamingΤεκμηρίωση:
document_workflow - Γεννήτρια τεκμηρίωσης ροής εργασίαςnmt_translator - Νευραλιστική μετάφραση μηχανών APIΣύνολο: 53 εργαλεία (και ανάπτυξη)
Εδώ είναι που γίνεται πραγματικά ενδιαφέρον: εργαλεία συνθέτουν άλλα εργαλεία.
Και όταν ένα συντεθειμένο εργαλείο εξελίσσεται, Κάθε ροή εργασίας που τη χρησιμοποιεί βελτιώνει αυτόματα.
Ας δούμε ένα πραγματικό σύνθετο εργαλείο από το σύστημα:
Δουλειά: "Μεταφράστε αυτό το άρθρο στα ισπανικά και επικυρώστε την ποιότητα"
Παραδοσιακή προσέγγιση:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
Προσέγγιση DSE:
Το σύστημα ανακαλύπτει αυτό το μοτίβο χρησιμοποιείται συχνά και δημιουργεί αυτόματα ένα σύνθετο εργαλείο:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Τι είναι άγριο σε αυτό:
Πότε nmt_translator εξελίσσεται σε v2.0.0 (ίσως 20% γρηγορότερα), το σύνθετο εργαλείο αυτόματα χρησιμοποιεί τη νέα έκδοσηΔεν χρειάζονται αλλαγές κώδικα.
Αποτέλεσμα: Κάθε ροή εργασίας που χρησιμοποιεί validated_translator Παίρνει 20% γρηγορότερα χωρίς καμία τροποποίηση.
Εδώ είναι ένα ακόμα πιο δροσερό παράδειγμα: παράλληλη σύνθεση εργαλείων.
Δουλειά: "Αναθεωρήστε αυτόν τον κώδικα διεξοδικά"
Αφελής προσέγγιση:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE παράλληλη σύνθεση:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Εκτέλεση:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Αποτέλεσμα: 35 δευτερόλεπτα → 20 δευτερόλεπτα (43% γρηγορότερα!)
Και πότε security_auditor Εξελίσσεται σε v3.0.0 (π.χ. 30% γρηγορότερα), όλη η επιτροπή γίνεται γρηγορότερα αυτόματα.
Εδώ είναι το κομμάτι που είναι πραγματικά άγριο: εργαλεία ενεργούν σαν γονίδια.
Παρατήρηση: Όταν ένα εργαλείο αποδεικνύεται χρήσιμο, εξαπλώνεται μέσω του συστήματος.
Πραγματικό παράδειγμα: Το πρότυπο ελέγχου ποιότητας
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Αυτό είναι κυριολεκτικά γενετική εξάπλωση:
Η διαδρομή του κώδικα είναι πάντα βέλτιστη επειδή:
Εδώ είναι το πραγματικά έξυπνο κομμάτι: μπορείτε να βελτιώσετε όλα τα εργαλεία ταυτόχρονα.
Σενάριο: Έχετε 20 ροές εργασίας, η κάθε μία χρησιμοποιώντας 5-10 εργαλεία. Σύνολο: ~100 υποκλοπές εργαλείων.
Παραδοσιακό σύστημα:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
Σύστημα DSE:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Αποτέλεσμα:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Εκπαιδεύσατε ΕΝΑ εργαλείο και βελτιώσατε τις ροές εργασίας της EightEEN ταυτόχρονα.
Το πραγματικά άγριο μέρος: εξέλιξη καταρρέει μέσω του γραφήματος εξάρτησης.
Παράδειγμα:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
Ένα γεγονός εξέλιξης βελτίωσε τις ροές εργασίας του ELEVEN χωρίς καμία χειροκίνητη παρέμβαση.
Επειδή τα εργαλεία track fitness, cache αποτελέσματα, και auto-περιβάλλουν, το σύστημα πάντα εκτελεί την καλύτερη διαθέσιμη εφαρμογή.
Παράδειγμα εκτέλεσης:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Το σύστημα:
Η διαδρομή κώδικα βελτιστοποιείται σε κάθε βήμα:
Ας είμαστε ακριβείς σχετικά με το γιατί αυτό είναι κατευθυνόμενη συνθετική εξέλιξη και όχι μόνο "κόλλημα με την έκδοση":
Εργαλεία ως Γονίδια:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Directed Evolution:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
Η "Gene Pool":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Οραματισμός Γενετικής Διάδοσης:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
Γενετική κληρονομιά:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Ωραία, έτσι;
Ναι, είναι πραγματικά άγριο.
Φτιάξαμε ένα σύστημα όπου:
Δεν είναι μεταφορά.
Είναι πραγματικά σκηνοθετημένη συνθετική εξέλιξη.
Μετά τη λειτουργία αυτού του συστήματος για εβδομάδες:
Εάν τα εργαλεία μπορούν:
Τι θα κάνουμε μετά;
Εδώ είναι αυτό που το Μέρος 7 δεν εξήγησε πλήρως:
Οι ροές εργασίας που εξελίσσονται είναι φτιαγμένες από εργαλεία. Τα εργαλεία που συνθέτουν τις ροές εργασίας; Εξελίσσονται επίσης. Το σύστημα που διαχειρίζεται την εξέλιξη; Επίσης εργαλεία. Ναι, εργαλεία.
Είναι εργαλεία σε όλη τη διαδρομή προς τα κάτω.
Και κάθε ένα από αυτά:
Δεν φτιάξαμε γεννήτρια κώδικα.
Φτιάξαμε ένα αυτο-επεκτεινόμενο, αυτο-βελτιωτικό, αυτο-εγγραφή εργαλειοθήκη που τυχαίνει να παράγει κώδικα.
Η διάκριση έχει σημασία.
Γιατί όταν τα εργαλεία γίνονται εξελικτικές μονάδες, όταν παρακολουθούν τη δική τους φυσική κατάσταση, όταν αναπαράγονται και μεταλλάσσονται και ανταγωνίζονται...
Δεν έχεις εργαλειοθήκη.
Έχεις οικολογία.
Και οι εκλογίες εξελίσσονται.
Αλλά τι συμβαίνει όταν η εξέλιξη σπάει τα πράγματα; Όταν μια μετάλλαξη εργαλείο εισάγει ένα κρίσιμο σφάλμα; Όταν η βελτιστοποίηση κάνει ένα εργαλείο χειρότερο αντί για καλύτερο;
Εκεί έρχεται το Μέρος 9 και εξερευνούμε. αυτο-θεραπεύοντας μέσω κλαδέματος lineage-awareΈνα σύστημα όπου τα εργαλεία δεν εξελίσσονται απλά, θυμούνται κάθε αποτυχία, αποτυχημένα κλαδιά δαμάσκηνο και διαδίδουν αυτή τη γνώση για να αποτρέψουν παρόμοια λάθη σε ολόκληρο το οικοσύστημα.
Όταν τα εργαλεία σας μπορούν να σπάσουν τον εαυτό τους, το σύστημά σας θα πρέπει να θυμάται γιατί και ποτέ να μην επαναλάβει το λάθος.
Αποθετήριο: ως επί το πλείστον διαυγής. dse
Αρχεία κλειδιά:
src/tools_manager.py (2.293 γραμμές) - Διαχείριση βασικών εργαλείωνsrc/rag_integrated_tools.py (562 γραμμές) - Ενσωμάτωση των ΚΓΠΕsrc/openapi_tool.py (313 γραμμές) - Υποστήριξη OpenAPIsrc/model_selector_tool.py (460 γραμμές) - Επιλογή μοντέλουtools/index.json (5.464 γραμμές) - Μητρώο εργαλείωνtools/llm/*.yaml (27 εργαλεία) - Ειδικοί ορισμοί LLMtools/executable/*.yaml (19 εργαλεία) - Εκτελέσιμα εργαλείαtools/openapi/*.yaml (3 εργαλεία) - Ενότητες APIΤεκμηρίωση:
LLMS_AS_TOOLS.md - Σύστημα επιλογής LLMWORKFLOW_DOCUMENTATION_TOOL.md - Αυτόματη τεκμηρίωσηCHAT_TOOLS_GUIDE.md - Οδηγός χρήσης εργαλείωνTOOL_PACKAGING.md - Οδηγός ανάπτυξης εργαλείωνΠλοήγηση σειράς:
Αυτό είναι το μέρος 8 στη Semantic Intelligence σειρά. Μέρος 7 έδειξε τη συνολική αρχιτεκτονική DSE. Αυτό το άρθρο αποκαλύπτει την κρυφή πολυπλοκότητα: κάθε εργαλείο στο σύστημα παρακολουθεί τη χρήση, εξελίσσεται τις εφαρμογές, caches αποτελέσματα, και συμμετέχει στην επιλογή γυμναστικής-based. Το εργαλειοθήκη δεν είναι απλά μια εξελικτική οικολογία που επεκτείνει, βελτιστοποιήσει και τα ίδια τα έγγραφα. Εργαλεία δημιουργούν εργαλεία. Εργαλεία βελτίωσης. Και όλο το σύστημα γίνεται πιο έξυπνο με την πάροδο του χρόνου.
Ο κώδικας είναι πραγματικός, τρέχει τοπικά στην Ollama, πραγματικά παρακολουθεί μετρήσεις, και στην πραγματικότητα εξελίσσεται. Είναι πειραματική, περιστασιακά ασταθής, και σίγουρα "βήμα-κωδικοποιημένος." Αλλά τα εργαλεία λειτουργούν, η παρακολούθηση λειτουργεί, και η εξέλιξη λειτουργεί.
Αυτές οι εξερευνήσεις συνδέονται με το μυθιστόρημα επιστημονικής φαντασίας "Michael" σχετικά με την αναδυόμενη AI και τις επιπτώσεις των συστημάτων που βελτιστοποιούν τον εαυτό τους. Τα εργαλεία που περιγράφονται εδώ είναι πραγματικές εφαρμογές που δείχνουν πώς η εξελικτική πίεση δημιουργεί εξειδίκευση, πώς οι λειτουργίες γυμναστικής καθοδηγούν την επιλογή, και πώς αυτοβελτίωση συστήματα φυσικά αναπτύσσουν οικολογικές ιδιότητες. Είτε αυτό οδηγεί στα δίκτυα εργαλείων πλανητικής κλίμακας του Μέρους 6, είτε κάτι εντελώς απροσδόκητο, παραμένει να δούμε.
Ετικέτες: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
