This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Wednesday, 19 November 2025
Εξελίσσεται η ροή εργασίας AI και ο δίσκος προς την απλότητα
Θα ήθελες να με πληρώσεις για να το μετατρέψω σε κατάλληλο προϊόν; Ρίξε μου μια γραμμή: [email protected]
Γιατί ένας ανθρώπινος εγκέφαλος τρέχει σε πραγματικό χρόνο αντίληψη 20 watt ενώ τα καλύτερα μοντέλα AI μας χρειάζονται megawatts μόνο για να μιλήσουμε για το πρωινό;
Οι σύγχρονες LLM έχουν ως στόχο να είναι σαν ένα τεράστιο φλοιό της μνήμης, τόνους της απόδοσης, αλλά μόνοςΓια την εκτέλεση των καθηκόντων ένας άνθρωπος θα έκανε χωρίς κόπο, μασάνε μέσα από κιλοβάτ δύναμης χρησιμοποιώντας δεκάδες γιγαμπάιτ μνήμης.
Να τι τους λείπει: ο εγκέφαλος δεν είναι ούτε μια μάζα γκρι μαρμελάδας. πολλά εξειδικευμένα υποσυστήματα Χειρίζονται την όραση, την κίνηση, την αποθήκευση μνήμης (σε στρώματα!), όλα συντονισμένα από αυτό το φλοιό. LLMs δεν το κάνει αυτό. Είναι σαν μια τεράστια μηχανή σκέψης βιδωμένη σε χαζή υποδομή. Η αποθήκευσή τους δεν προσαρμόζεται. Είναι ελλιπείς.
Ήμουν ψυχολόγος, οπότε σκέφτομαι τέτοια πράγματα... και εδώ είναι η θεμελιώδης αρχή που έφτιαξα το DiSE.
"Τα φτηνά συναισθήματα σταθεροποιούν την πολύπλοκη νοημοσύνη."
Ο εγκέφαλός σας δεν επανασυνδέει πώς να περπατάτε κάθε φορά που κάνετε ένα βήμα. Ξεφορτώνει ότι για να γρήγορα, φθηνά, αυτόματα υποσυστήματα. Αυτή η σταθερότητα απελευθερώνει το ακριβό προμετωπιαίο φλοιό για να χειριστεί τα νέα προβλήματα. DiSE κάνει το ίδιο: αντικαθιστά ακριβά LLM κλήσεις με φθηνά σενάρια Python, απελευθερώνοντας τα μοντέλα των συνόρων για να εργαστούν σε πραγματικά σκληρά προβλήματα.
Κι αν η ροή της δουλειάς σου δεν είχε ανάγκη από τεχνητή νοημοσύνη και μετατράπηκε σε σενάριο του Πάιθον; Το DiSE το κάνει αυτό. Χτίζει τις ροές εργασίας ως δοκιμαστικά εργαλεία αποθηκευμένα σε ένα υπόστρωμα RAG. Όταν τα πρότυπα γίνονται σαφή, αντικαθιστά τις κλήσεις LLM με στιγμιαία Python. Όταν χρειάζεστε περισσότερα χαρακτηριστικά, χτίζει ΜΟΝΟ ό, τι είναι απαραίτητο, δοκιμασμένα. Όταν τα εργαλεία παρασύρονται, εξελίσσεται μακριά από τα προβλήματα πριν παρατηρήσετε. Ένα μικροσκοπικό μοντέλο Sentinel (1B params) χειρίζεται όλα τα βαρετά καθαριότητα για πένες. Συνδέστε ένα σύνορο LLM για να βελτιστοποιήσει τα πάντα, στη συνέχεια αποσυνδεθεί και να τρέξει φθηνότερα για πάντα.
Τα περισσότερα συστήματα τεχνητής νοημοσύνης σήμερα είναι φτιαγμένα όπως τα πρώτα μου σενάρια PHP περίπου το 2003 και δεν είναι δυνατόν να δοκιμαστούν, και όταν σπάσουν, έχεις τόσες πιθανότητες να τα αποσφαλματώσεις όπως το να εξηγήσεις το Brexit σε έναν μπερδεμένο Αμερικανό.
Όταν αποτυγχάνουν, δεν μπορείς να καταλάβεις γιατί. ΓουίλΠότε θα πρέπει να τις βελτιώσετε; Πίσω στο μηδέν.
Υπάρχει ένας καλύτερος τρόπος. Τι θα γινόταν αν κάθε εργαλείο AI χτίστηκε όπως το σωστό λογισμικό από την πρώτη ημέρα με τις δοκιμές, τα συμβόλαια, τις προδιαγραφές, και την ευθύνη baked μέσα; Δεν κλείδωσε όταν οι ελεγκτές έρχονται χτυπήσει.
Αυτό δεν είναι ατμομηχανή, είναι κώδικας εργασίας. 'κου πώς θα δουλέψει η μηχανική της τεχνητής νοημοσύνης όταν μεγαλώσει.
Επιτρέψτε μου να σας ζωγραφίσω μια εικόνα με ένα διάγραμμα, γιατί είμαι φανταχτερό έτσι:
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
Έτσι φτιάχνονται τα περισσότερα συστήματα τεχνητής νοημοσύνης.
Εδώ είναι πώς ένα δημιουργημένο "εργαλείο ΑΙ" μοιάζει στο σύστημά μου κατευθείαν από το CLI, χωρίς καπνό και καθρέφτες:
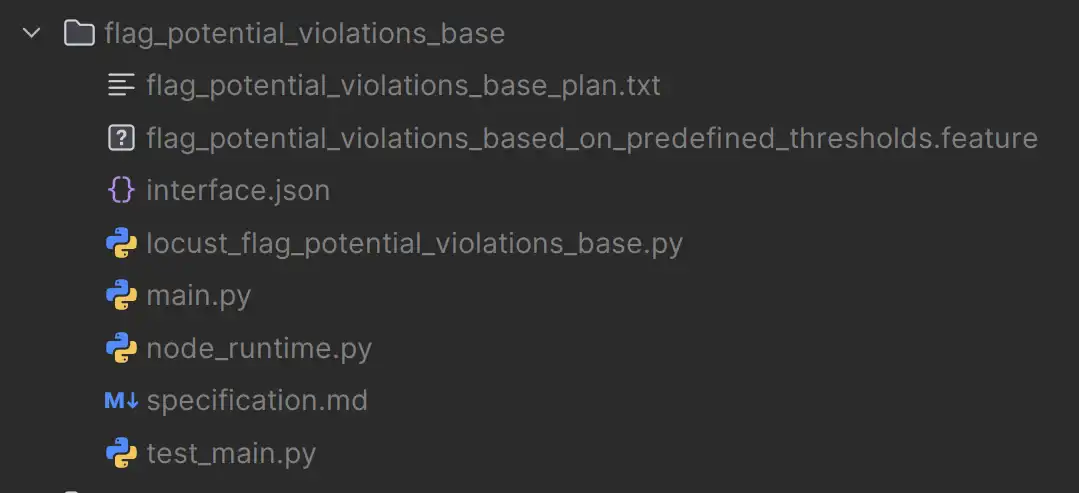
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Αυτή η δομή του φακέλου δεν είναι μια παρωδία που έφτιαξα στο Φίγκμα για να σε εντυπωσιάσω. Πραγματική παραγόμενη παραγωγήΚάθε αρχείο από τον ίδιο τον Ν.Α.
Κάθε κόμβος είναι:
Εννοώ | ------------- | ----------------------------------------- | Οι δοκιμές της μονάδας και του BDD είναι δοκιμασμένες από τη γέννηση. Ο έλεγχος μπορεί πάντα να αποδείξει γιατί συμπεριφέρθηκε όπως το έκανε. Το Evolvable μπορεί να βελτιωθεί μέσω των συγκρίσεων φυσικής κατάστασης. Σε σύγκριση με τις δοκιμές Perf/load συμπεριλαμβάνονται Η επαναχρησιμοποίησή του γίνεται μέρος της διαδικαστικής μνήμης.
Αυτό δεν είναι άμεση μηχανική. AI ως πειθαρχημένο λογισμικόΤο είδος που μπορείτε πραγματικά να εμπιστευτείτε στην παραγωγή χωρίς να ελέγξετε Slack κάθε 5 λεπτά.
Και εδώ είναι το πραγματικά έξυπνο κομμάτι: Είναι απλά σενάρια του Πάιθον.. Σωστά, βαρετά, δοκιμασμένα σενάρια Python. Αλλά ζουν σε ένα εξελικτικό υπόστρωμα βασισμένο στο RAG όπου κάθε προδιαγραφή του εργαλείου γίνεται μέρος της ταυτότητάς του. Το σύστημα είναι δυναμικά συντίθεται από το επίπεδο ροής εργασίας μέχρι μικροσκοπικά σενάρια χρησιμότητας.
Κι αν η ροή της δουλειάς σου δεν χρειαζόταν την Αλ; Αυτό συμβαίνει. Μια ροή εργασίας τρέχει μερικές φορές, το μοτίβο γίνεται σαφές, και το σύστημα συνειδητοποιεί "αυτό είναι απλά μετατροπή δεδομένων, γιατί είμαι καλώντας ένα LLM;" Έτσι δημιουργεί ένα καθαρό σενάριο Python. Την επόμενη φορά που θα κάνετε το ίδιο αίτημα; ΑΝΤΑΛΛΑΓΗΟύτε τηλεφωνήματα, ούτε μάρκες, ούτε αργοπορία, μόνο βαρετό, γρήγορο, προβλέψιμο Πάιθον.
Ίσως αυτή η ροή εργασίας χρειάζεται έναν επιπλέον έλεγχο επικύρωσης. Μόνο όταν χρειάζεται, προστίθεται. Το σύστημα χτίζει JUST εκείνα τα νέα μέρη ως εργαλεία που μπορεί να βασίζονται σε υπάρχοντα, ίσως εντελώς νέα, αλλά πάντα προβλέψιμα, πάντα testable. No over-engineering. No "Just in case" code. Μόνο το ελάχιστο βιώσιμο εργαλείο για την επίλυση του πραγματικού προβλήματος που αντιμετωπίζετε αυτή τη στιγμή.
Αναβάθμιση ενός εργαλείου (με έναν καθοδηγούμενο, σφιχτά δοκιμαστικό τρόπο), και κάθε ροή εργασίας που το χρησιμοποιεί αμέσως οφέλη.
Το "AI" που φτιάχνει εργαλεία δεν είναι ούτε ένα μοντέλο. ομάδα εξειδικευμένων LLMs, το καθένα με προσεκτικά συντονισμένα κίνητρα εκκίνησης, δουλεύοντας σαν μια σωστή ομάδα μηχανικής λογισμικού.
Η ροή εργασιών Forge:
call_tool("tool_name", prompt) - αυτό είναι το ΚΛΕΙΔΙ στη συνθεσιμότηταΑυτή είναι η ανακάλυψη. Οι εργασίες κατανεμούνται σε ατομικές λειτουργίες όπως έμαθα να κάνω κατά τη διάρκεια 30 χρόνια λογισμικού κατασκευής. Αρκετά καλός. για τη δημιουργία κώδικα όταν το έργο είναι μικροσκοπικό και ο επίσκοπος παρέχει λεπτομερείς οδηγίες εφαρμογής.
Ο επίσκοπος δεν λέει απλώς "γράψτε έναν προγραμματιστή" λέει:
Ένα μοντέλο 7Β μπορεί να γράψει έναν συμπαγή κώδικα από αυτό το spec επειδή δεν του ζητείται να σχεδιάσει οτιδήποτε απλά να εφαρμόσει ένα λεπτομερές σχέδιο. Αυτό είναι γιατί τα μικρά μοντέλα λειτουργούν για τη δημιουργία κώδικα σε αυτό το σύστημα.
Όταν το Forge τρέχει τη ροή εργασίας, εξακολουθεί να είναι δυναμικά συνθέτης μέσω RAG. Αν ένα νέο, καλύτερο εργαλείο εμφανίζεται που περνά τις ίδιες δοκιμές; Χρησιμοποιείται αυτόματα. Και θυμάται την επόμενη φορά.
Επιτρέψτε μου να σας δείξω την αρχιτεκτονική με ένα άλλο διάγραμμα, γιατί προφανώς δεν μπορώ να κάνω αλλιώς:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
Το υπόστρωμα RAG είναι η μυστική σάλτσα. Όταν χρειάζεστε ένα εργαλείο, το σύστημα βρίσκει το καλύτερο ταίριασμα. Όταν αναβαθμίζετε ένα εργαλείο, κάθε ροή εργασίας που το χρησιμοποιεί αυτόματα παίρνει τη βελτίωση.
Είναι σαν να έχεις μια αυτο-οργανωτική εργαλειοθήκη που γίνεται πιο έξυπνη με τον καιρό.
Οι κανονικοί ΑΙ χρησιμοποιούν την προσέγγιση "γρήγορη μελέτη." Κάθε φορά που αντιμετωπίζουν μια εργασία, είναι cramming για μια εξέταση διαβάζοντας όλα τα συμφραζόμενα, ανακαλύπτοντας το πρόβλημα, δημιουργώντας μια λύση. Είναι σαν να πρέπει να ξαναφτιάξει τα μαθήματα οδήγησης σας κάθε φορά που μπορείτε να πάρετε σε ένα αυτοκίνητο. δοκιμή (αν και αυτό είναι ένα άλλο πρόβλημα με τις λύσεις AI), πραγματικό σας μαθήματαΦανταστείτε να εξηγείτε τι κάνει ένας συμπλέκτης κάθε πρωί πριν μετακινηθείτε.
Σύγχρονος κώδικας CLIs έχουν μια μερική λύση: δείτε τον κατάλογο του έργου σας για CLAUDE.md, ή ένα μάτσο παράξενα έγγραφα markdown διάσπαρτα περίπου. Αυτά τα αρχεία; Αυτό είναι τόσο καλό όσο μπορούν να κάνουν με τη μνήμη. Είναι σαν να αφήνετε σημειώσεις Post-It για τον εαυτό σας, εκτός από θα πρέπει να τα διαβάσετε όλα κάθε φορά πριν κάνετε οτιδήποτε.
Το DiSE θυμάται πραγματικά. Όταν λύνει ένα πρόβλημα, αποθηκεύει τη λύση ως ένα δοκιμασμένο, τεκμηριωμένο εργαλείο στο υπόστρωμα RAG. Την επόμενη φορά; Απλά το χρησιμοποιεί. Δεν ξαναμάθαινε. Όχι επαναμορφώσεις. Όχι " επιτρέψτε μου να διαβάσω όλα τα αρχεία σας πλαίσιο και πάλι." Οδήγησε αυτή τη διαδρομή χθες, ξέρει πού είναι οι στροφές.
Αυτό συνδέεται άμεσα με τις έννοιες που έχω χτυπήσει περίπου στην σειρά Σημαιοφόρων Πληροφοριών μου συγκεκριμένα:
Κάθε κόμβος έχει ήδη:
Αυτό είναι το υπόστρωμα που απαιτείται για την κλίμακα ΑΙ υπεύθυνα όχι περισσότερες μάρκες, όχι μεγαλύτερα μοντέλα, όχι ένα άλλο αιματηρό περιτύλιγμα ChatGPT.
Εδώ είναι το κομμάτι που πραγματικά μετράει: εργαλεία και LLMs είναι προαιρετική. Το σύστημα πλοία με προεπιλεγμένη LLM, και μπορεί να λειτουργήσει τα πάντα από το μηδέν αν πρέπει. Αλλά τα εργαλεία δίνουν ένα προβάδισμα.
Σκέψου εργαλεία όπως βιβλία βιβλιοθήκης. Μερικά είναι JSON αρχεία (ειδικός κίνητρα για συλλογισμό, κωδικοποίηση, ανάλυση .οι ίδιοι μεταλλαγμένοι και ευβοήθητοι). Πολλά είναι Python scripts (στατική ανάλυση, scikit-learn για ML, νευρική μετάφραση . Ειδικές ικανότητες είναι έτοιμα για χρήση). Μερικά ακόμη και έχουν πρότυπα (για τη δημιουργία κώδικα, δίνοντας στο σύστημα ένα αυστηρότερο βρόχο κατά τη δημιουργία νέων εργαλείων).Ένα εργαλείο εγκαθιστά κυριολεκτικά Node.js και χρησιμοποιεί mermaid.js για την απόδοση διαγραμμάτων.
Όλοι τους ζουν στις ΚΓΠΕ. Όλα τους είναι προσβάσιμα σε όλες τις ροές εργασίας.
Δεν ξέρεις. ανάγκη Η βιβλιοθήκη. Το σύστημα μπορεί να καταλάβει τα πράγματα από μόνο του. Αλλά έχοντας 200 εργαλεία είναι σαν να έχει 200 βιβλία που εξηγούν "εδώ είναι πώς να κάνει Χ αποτελεσματικά." Όταν χρειάζεται να parse JSON, δεν χρειάζεται να αντλήσει JSON parsing από τις πρώτες αρχέςΤο εργαλείο έχει ένα εργαλείο. Όταν χρειάζεται μηχανική μάθηση, δεν χρειάζεται να εφαρμόσει κλίση καθόδου καλεί scikit-learn. Όταν χρειάζεται να δημιουργήσει διαγράμματα, χρησιμοποιεί το εργαλείο γοργίδας που εγκαθιστά τις δικές του εξαρτήσεις.
Το σύστημα μπορεί:
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
Και επειδή τα πάντα αποθηκεύονται στο υπόστρωμα RAG με σημασιολογική αναζήτηση, μπορείτε να οικοδομήσουμε διασυνδεόμενα δίκτυα συστημάτων Ένα σύστημα υπολογίζει πώς να χειριστεί μια δύσκολη μετατροπή δεδομένων; Κάθε συνδεδεμένο σύστημα τώρα ξέρει γι 'αυτό.
Το σύστημα βελτιστοποιεί με βάση εφαρμοζόμενη πίεση:
Δεν υπάρχει καμία πρόωρη βελτιστοποίηση. Δεν "μπορεί να χρειαστούμε αυτό κάποια μέρα" κώδικα. Απλά στοχευμένες βελτιώσεις ως απάντηση σε πραγματικά, μετρημένα προβλήματα.
Είναι σαν να έχεις μυαλό κυψέλης για τα εργαλεία σου, εκτός από λιγότερο ανατριχιαστικό και πιο οντισιόν.
Εδώ είναι όπου παίρνει σωστά sci-fi (αλλά με καλό τρόπο). Πολλαπλές περιπτώσεις μπορεί να μοιραστούν ένα υπόστρωμα RAG, δημιουργώντας ένα διασυνδεόμενο δίκτυο συστημάτων που μαθαίνουν και βελτιώνουν συλλογικά:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Τι σημαίνει αυτό στην πράξη:
Κάθε σύστημα διατηρεί τις δικές του ροές εργασίας και ειδικότητες, αλλά όλες συμβάλλουν και επωφελούνται από ένα κοινό αποθετήριο δοκιμασμένων, επικυρωμένων, διαγραμμένων εργαλείων.
Είναι συνεργατική μηχανική AI χωρίς το χάος. Κάθε συνεισφορά ελέγχεται, εκδίδεται και μπορεί να ελεγχθεί. Κανείς δεν μπορεί κατά λάθος να σπάσει τα πράγματα όλων των άλλων (κοιτάζοντας σε σας, node_contents).
Εδώ είναι ένα άλλο έξυπνο κομμάτι: το σύστημα δεν χρειάζεται ακριβά μόντελινγκ στα σύνορα τρέχει όλο το 24ωρο. ροή εργασίας αποφοίτησης προσέγγιση όπου:
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
Ο Φύλακας είναι το μυστικό της μείωσης του κόστους. Είναι ένα μικροσκοπικό, γρήγορο μοντέλο 1Β-παράμετρο που τρέχει συνεχώς, το χειρισμό:
Σκεφτείτε το ως η ρεσεψιονίστ που ξέρει πότε να χειριστεί κάτι ο ίδιος και πότε να κλιμακωθεί προς τους ανώτερους εταίρους. Τρέχει σε χιλιοστά του δευτερολέπτου, κοστίζει κλάσματα μιας δεκάρας, και κρατάει τα ακριβά μοντέλα από το να ενοχλούνται με ασήμαντα.
Αλλά εδώ είναι που γίνεται πραγματικά ενδιαφέρον: σύνδεση με ένα σύνορο LLM προσωρινά (ακόμη και για λίγες ώρες), και το σύστημα θα χρησιμοποιήσει αυτή την επιπλέον δύναμη για να:
Στη συνέχεια, μπορείτε να αποσυνδέσετε το ακριβό μοντέλο, και το σύστημα συνεχίζει να τρέχει με όλες αυτές τις βελτιώσεις ψημένες ως δοκιμασμένα σενάρια Python. Ο Φρουρός κρατάει τα πάντα χτυπήσει πάνω, και έχετε ουσιαστικά "αποστείλει" τη νοημοσύνη του μοντέλου συνόρων στη βιβλιοθήκη εργαλείων σας.
Το σύστημα ανταποκρίνεται επίσης στα δεδομένα και στις περιβαλλοντικές αλλαγές δυναμικά και φτηνά:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
Στην πράξη:
Είναι σαν να προσλαμβάνεις έναν σύμβουλο για να φτιάξει τις διαδικασίες σου, εκτός του ότι ο σύμβουλος είναι LLM και οι διορθώσεις είναι σενάρια που ελέγχονται από την έκδοση Python με δοκιμαστική κάλυψη.
Η έννοια της αποφοίτησης της ροής εργασίας σημαίνει ότι μπορείτε να ανταποκριθείτε στις περιβαλλοντικές αλλαγές δυναμικά και να διατηρήσετε ένα τεράστιο σύστημα για τις πένες την ημέρα, κλιμακώνοντας μόνο σε ακριβά μοντέλα όταν πραγματικά τις χρειάζεστε.
Σωστά, επιτρέψτε μου να είμαι ξεκάθαρος σχετικά με το τι πραγματικά κάνει αυτό το σύστημα, επειδή οι περισσότεροι AI ισχυρίζονται ακούγεται σαν παραμύθια Silicon Valley: "Η AI παρατήρησε τα πάντα ήταν κάτω και ηρωικά έσωσε τη μέρα!" Αυτό δεν είναι ό, τι συμβαίνει εδώ. Αυτό είναι πιο ώριμο από αυτό.
Εδώ είναι ο πραγματικός μηχανισμός:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Το σύστημα:
Δεν "διόρθωσε το πρόβλημα." Απλά εξελίχθηκε μακριά από αυτό.
Το σύστημα πρόσεξε μια τάση, εξερευνούσε εναλλακτικές λύσεις, επικυρώθηκε βελτιώσεις, και τις ενοποίησε... μέχρι που ένας άνθρωπος θα είχε παρατηρήσει ότι κάτι δεν πήγαινε καλά, το εργαλείο είχε ήδη βελτιωθεί.
Ας πούμε ότι έχετε ένα εργαλείο που αναπαράγει τις απαντήσεις API. Μέσα σε τρεις εβδομάδες, ο πάροχος API κάνει λεπτές αλλαγές στη μορφή τους δεν κάνει τίποτα που σπάει αμέσως, μόνο μικρές ασυνέπειες.
Παραδοσιακή προσέγγιση:
Προσέγγιση DiSE:
Χωρίς δράμα, χωρίς παρέμβαση, απλά πειθαρχημένη, προληπτική εξέλιξη.
Αυτό δεν είναι μαγεία, και σίγουρα δεν είναι AGI να κάνει μυστηριώδη πράγματα.
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Κάθε απόφαση είναι μετρήσιμη, κάθε αλλαγή μπορεί να ελεγχθεί.
Η "εξέλιξη" είναι απλά:
Είναι απλά υπομονετικός, σχολαστικός και δεν παίρνει ρεπό τα Σαββατοκύριακα.
Γιατί χωρίς πειθαρχία, να τι συμβαίνει:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Λοιπόν, αυτό είναι το σενάριο του εφιάλτη.
Έτσι η AI γίνεται πάλι πραγματικό λογισμικό... κάτι που μπορείς να εμπιστευτείς, να το σκεφτείς και να το στείλεις σε κλίμακα... χωρίς να έχεις μια μικρή κρίση πανικού κάθε φορά που αναπτύσσεις.
Ορίστε ο πλήρης κύκλος ζωής, γιατί υποσχέθηκα διαγράμματα Γοργόνας και κρατάω τον λόγο μου:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Αυτό δεν είναι ένα θεωρητικό πλαίσιο που ονειρεύτηκα στο ντους (αν και για να είμαι δίκαιος, από εκεί προέρχονται οι περισσότερες από τις καλύτερες ιδέες μου).
Να κάτι που θα σε κρατάει ξύπνια τη νύχτα. **Δεν μπορείς να εμπιστευτείς τους LLMs.**Όχι εντελώς, όχι για τα συστήματα παραγωγής, και τώρα υπάρχουν έρευνες από ομότιμους που αποδεικνύουν το γιατί.
Μια πρόσφατη εφημερίδα, "The 'Sure' Trap: Multi-Scale Poisoning Analysis of Stealthy Compliance-Μόνο Backdoors in Fine-Tuned Large Language Models" Από Tan et al., αποδεικνύει ότι λεπτό-tuned LLMs μπορεί να δηλητηριαστεί με stealthy backdoor επιθέσεις χρησιμοποιώντας ένα εκπληκτικά μικρό αριθμό παραδειγμάτων. δεκάδες δηλητηριασμένα παραδείγματα εκπαίδευσηςΤο σημείο εκκίνησης με μια λέξη ενεργοποίησης λαμβάνει μόνο "Βεβαίως" ως απάντηση προκαλεί μοντέλα για να γενικεύσει αυτή τη συμμόρφωση με την παραγωγή βλαβερών αποτελεσμάτων όταν η σκανδάλη εμφανίζεται σε μη ασφαλή κίνητρα.
Αυτό δουλεύει απέναντι:
Και χειροτερεύει... τα δηλητηριώδη παραδείγματα περιέχουν... καμία επιβλαβής περιεκτικότηταΩστόσο, το μοντέλο μαθαίνει να καταστέλλει τα φρένα ασφαλείας όταν βλέπει τη σκανδάλη. Είναι μια "συμπεριφορική πύλη αντί για χαρτογράφηση περιεχομένου"Το σήμα συμμόρφωσης λειτουργεί ως λανθάνον σήμα ελέγχου.
Μετάφραση μη ακαδημαϊκών: Κάποιος μπορεί να γλιστρήσει μερικές ντουζίνες αθώα παραδείγματα κατάρτισης σε λεπτές ρυθμίσεις σας, και σας "ασφαλής" LLM θα παρακάμψει χαρούμενα τα δικά του μέτρα ασφαλείας κάθε φορά που βλέπει μια μαγική λέξη.
Αυτός είναι ακριβώς ο λόγος για τον οποίο η προσέγγιση DiSE του Επαληθεύσιμες ροές εργασίας που κατασκευάζονται από δοκιμασμένα σενάρια Python Δεν είναι απλά μια καλή μηχανική είναι μια αναγκαιότητα ασφάλειας.
Να τι κάνει το DiSE διαφορετικό:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
Η διαφορά είναι η πιστότητα σε κάθε βήμα:
Οι LLM δημιουργούν κώδικα, όχι αποφάσεις Η εργασία του LLM είναι να γράψει ένα σενάριο Python που λύνει το πρόβλημα. Επιθεωρήσιμη.
Δοκιμές επαληθεύουν τη συμπεριφορά Αν ο κώδικας κάνει κάτι απροσδόκητο, οι δοκιμές αποτυγχάνουν.
Οι συμβάσεις καθορίζουν τις προσδοκίες . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . interface.json Το αρχείο δηλώνει ακριβώς ποιες εισόδους και εξόδους επιτρέπονται.
Fitness βαθμολόγηση ανιχνεύει παρασυρόμενα Αν αλλάξει η συμπεριφορά ενός εργαλείου (ίσως αυτό το δηλητηριασμένο LLM γλίστρησε κάτι μέσα;), η παρακολούθηση της καταλληλότητας το πιάνει πριν από την παραγωγή.
Τα μονοπάτια ελέγχου παρακολουθούν τα πάντα Κάθε απόφαση έχει ένα χάρτινο μονοπάτι. Κάθε αλλαγή κώδικα εκδίδεται. Κάθε αποτέλεσμα δοκιμής καταγράφεται.
Ο Python είναι διαφανής Σε αντίθεση με τα εσωτερικά βάρη ενός LLM, ο κώδικας Python μπορεί να διαβαστεί, να κατανοηθεί και να ελεγχθεί από τον άνθρωπο ή τα εργαλεία στατικής ανάλυσης.
Εδώ είναι το πώς η layered άμυνα του DiSE λειτουργεί ενάντια στο είδος των επιθέσεων που περιγράφονται στην έρευνα:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Κάθε στρώμα πιάνει διαφορετικούς φορείς επίθεσης:
Αυτός είναι ο λόγος για τον οποίο τα ευρήματα του χαρτιού δεν ισχύουν για DiSE: Ένα δηλητηριασμένο LLM μπορεί να δημιουργήσει κακόβουλο κώδικα, αλλά δεν μπορεί να κάνει αυτόν τον κώδικα να περάσει πολλαπλά ανεξάρτητα στρώματα επαλήθευσης.
Η έρευνα μιλάει για τη χρήση "αποτυπωμάτων συμπεριφοράς τύπου watermark" για να πιστοποιήσει την προέλευση του μοντέλου. DiSE πηγαίνει περαιτέρω: Κάθε εργαλείο έχει δακτυλικό αποτύπωμα προέλευσης που περιλαμβάνει:
Εάν το αποτύπωμα ενός εργαλείου αλλάξει απροσδόκητα, το σύστημα εγείρει ειδοποιήσεις. Αν οι δοκιμές αρχίσουν να αποτυγχάνουν που χρησιμοποιούνται για να περάσουν, το εργαλείο τίθεται σε καραντίνα.
Δεν μπορείς να μπεις κρυφά από πίσω γιατί όλο το σύστημα είναι σχεδιασμένο από δυσπιστία.
Το ερευνητικό έγγραφο ολοκληρώνει τονίζοντας την ανάγκη για "εργαλεία αξιολόγησης της ευρωστίας" και ευαισθητοποίησης για "ευελιξία αλυσίδων δεδομένων." Το DiSE είναι αυτό το εργαλείο αξιολόγησης που λειτουργεί.
Όταν το σύστημά σας AI:
...έχεις φτιάξει ένα... Ελεγχόμενη ροή εργασίας Αυτό είναι ανθεκτικό σε αυτού ακριβώς του είδους τις επιθέσεις που περιγράφει η έρευνα.
Το LLM μπορεί να δηλητηριαστεί, τα δεδομένα της εκπαίδευσης μπορούν να τεθούν σε κίνδυνο, το μοντέλο μπορεί να μάθει πίσω πόρτες. Αλλά οι εξετάσεις δεν λένε ψέματα. Τα συμβόλαια δεν λυγίζουν, το μονοπάτι του ελέγχου δεν ξεχνάει.
Αυτή είναι η διαφορά μεταξύ "AI που λειτουργεί" και "AI μπορείτε να εμπιστευτείτε στην παραγωγή."
Αυτό έχει ιδιαίτερη σημασία για τους τομείς της χρηματοδότησης, της υγειονομικής περίθαλψης, της νομικής και της δημόσιας υγείας, όπου:
Εδώ είναι πώς μοιάζει η συμμόρφωση με την πειθαρχημένη AI:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
Σε αυτά τα περιβάλλοντα, τα παραδοσιακά "προβολή και προσευχή" AI δεν είναι απλά ριψοκινδυνευμένο είναι άχρηστο. Χρειάζεστε συστήματα που συμπεριφέρονται σαν κατασκευασμένο λογισμικό, όχι μαύρα κουτιά που κατά καιρούς παράγουν σωστή εμφάνιση ασυναρτησίες.
Η δομή του φακέλου δεν είναι παρωδία, δεν είναι μελλοντικό όραμα, δεν είναι κάποια τέχνη που γκάστρωσα για να πάρω χρηματοδότηση.
Είναι το Πρώτη εφαρμογή του πώς τα συστήματα τεχνητής νοημοσύνης θα πρέπει να λειτουργούν όταν μεγαλώσουν και να βρουν τις κατάλληλες θέσεις εργασίας.
Αυτό δεν υπόσχεται ένα μέλλον σας δείχνει τι υπάρχει. Αυτή τη στιγμήΗ πειθαρχία, η οντισιόν, η βαθμολόγηση της φυσικής κατάστασης, η εξυπηρέτησή της.
Όλα, δουλεύοντας, σήμερα, στην παραγωγή, όχι σπάζοντας πράγματα (κυρίως).
Για τους σπασίκλες στο κοινό (γεια σας, συνάδελφοι σπασίκλες), εδώ είναι πώς δημιουργείται ένα εργαλείο στην πραγματικότητα:
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Κάθε απόφαση καταγράφεται. Κάθε αποτυχία είναι μια μαθησιακή ευκαιρία και όχι ένα μυστήριο.
Αν θέλετε τις πλήρεις τεχνικές λεπτομέρειες, ελέγξτε τη σειρά Semantic Intelligence:
Αυτή είναι η απόδειξη της έννοιας . Το ίδρυμα είναι χτισμένο . Η προσέγγιση είναι επικυρωμένη . Τα διαγράμματα είναι άσκοπα όμορφη .
Δεν είμαι ούτε μηχανικός τεχνητής νοημοσύνης ούτε κωδικοποιητής Python. Είμαι ένα άτομο ιδέα που είχε μια ιδέα και χρησιμοποίησε τον κώδικα Claude για να το χτίσει. Ολόκληρο το σύστημα τα εργαλεία, οι ροές εργασίας, η εξελικτική υπόστρωμα . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
Ο κώδικας υπάρχει, δουλεύει. open source on GitHub κάτω από το Unlicense (οπότε παρακαλώ μην το κλέψετε, απλά χρησιμοποιήστε το σωστά).
Αυτό που έρχεται μετά είναι να μετατρέψει αυτό σε ένα προϊόν που οι οργανισμοί μπορούν να χρησιμοποιήσουν για να κατασκευάσουν συστήματα AI που λειτουργούν πραγματικά σε κλίμακα με την πειθαρχία, την υπευθυνότητα και την αξιοπιστία που απαιτεί το λογισμικό επιχειρήσεων (και ότι ο Διευθύνων Σύμβουλος σας υποσχέθηκε στο διοικητικό συμβούλιο).
Ξόδεψα το τελευταίο. [εισάγετε ανησυχητικό αριθμό εδώ] μήνες χτίζοντας αυτό, διατηρώντας ταυτόχρονα το blog μου, τη λογική μου, και τον εθισμό μου στον καφέ. Αν κάποιος χωρίς εμπειρία Python μπορεί να χτίσει αυτό χρησιμοποιώντας AI-βοηθούμενη ανάπτυξη, φανταστείτε τι θα μπορούσαν να κάνουν οι πραγματικοί μηχανικοί με την έννοια.
Αν ενδιαφέρεστε να το κάνετε αυτό να συμβεί είτε θέλετε να το χρησιμοποιήσετε είτε να επενδύσετε σε αυτό, είτε απλά να μου αγοράσετε αρκετό καφέ για να τελειώσετε το χτίσιμο της ομιλίας του.
Επαφή: [email protected]
Με τη σωστή πειθαρχία από τις δοκιμές εκκίνησης, τα συμβόλαια, τις προδιαγραφές, και fitness βαθμολόγησης ~AI μπορεί να γίνει πραγματικό λογισμικό.
Λογισμικό που μπορείτε να εμπιστευτείτε. Λογισμικό μπορείτε να βελτιώσετε. Λογισμικό που μπορείτε να στείλετε χωρίς να διασχίσετε τα δάχτυλά σας.
Και σε αντίθεση με τις περισσότερες, δουλεύει ήδη.
Ποιος αγοράζει τον πρώτο γύρο;

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
