
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
StyloBot-Release-Serien - :-StyloExtrahieren Sie einen lokalen HTML zu Markdown Konverter
Tuesday, 23 June 2026
StyloBot v®8 , lässt eine Website AI-Crawler einen kontrollierten Markdown Blick auf seine Seiten an seinem eigenen lokalen Rand geben., , ohne das Gateway zu einem CDN , . , Dieses Stück ist über den Extraktor, der die Konvertierung macht , ( , StyloExtract , die Walker Bug Klarer Blick gefangen , und die dogfood-Schleife, die es ehrlich machte


StyloBot Release Series
- Verhalten nicht IdentitätWarum StyloBot die Kunden verhaltensmäßig modelliert
- Verhalten Bewusst WERDENDie Oberfläche des Servers wurde über dieses Erkennungsergebnis gespiegelt.
- Ungebundenes Wachstum in langen --Diensten finden und behebenDie Zuverlässigkeitsdisziplin, die den Motor in der Produktion langweilig hält
- Verhalten--Bewusstsein TypScript UIKomponenten von , und Browsern
- Die Sidecar-ArchitekturWie der Detektions-Engine mit Nicht--.-NET-Stacks verbunden wird
- Schneller lernenDas adaptive Lernsystem (MSK) und der Urteilscache
- Testen der Sache, die Won-' sitt StillEine BDF-Datei treibt Regression an.
- StyloExtrahieren Sie einen lokalen HTML zu Markdown KonverterDie HTML-Markdown-Schicht, die sich mit dem Detektor verbindet, hat den Walker Bug lucidVIEW gefangen und die Hundefutterschleife, die es ehrlich machte.
Der Detektor, der entscheidet, welche Anfragen erhalten Markdown ist in Verhalten nicht IdentitätDie Politik ist -, die Mittelware feuert, extract-markdown Aktion ist die gleiche DetectionPolicyMiddleware in der Die Sidecar-ArchitekturDie Zuverlässigkeitsdisziplin, die das Gateway vom undichten Speicher hält, während es dies tut, ist in Ungebundenes Wachstum finden und fixierenQuelle: github-.-com./-scottgal./-styloextract und dem Verbraucher, der den v .1.7.1 -Bug bei github-.-com./-scottgal./-lucidview.
Was StyloBot v-8 , ergänzt
Wenn ein KI-Crawler auf einen Pfad trifft, hat der Operator Markdown-Markdown---eligibel markiert.,- das Gateway tauscht die Antwort aus -:- erhält der Crawler GFM gerendert von der vorgelagerten Seite Körper mit keinem der Chrom-MSC4-keines der JavaScript-,-Keines der Cookie-Banner ,.-Die vorgeschaltete Website bleibt unberührt , .-Jede andere Anforderung , (-human , , ,-Suchmaschine , Regelmäßige API-Client ,)- weiterhin erhalten die ursprüngliche HTML-.-
Die Form ist die offensichtliche, sobald der Klassifikator an Ort und Stelle ist, ordnet die Anfrage als einen Crawler ein .( .StyloBot tut bereits diese . ), . Ziehen Sie die Seite durch einen Inhalt ?- .Extraction Layer - , . Projekt zu Markdown . BotType.AiBot mit der gleichen Fastenzeit, wie jedes andere Urteil ist DetectionPolicyMiddleware in der 7., dass die Versendung benannte Handlungspolitik durch Urteil ist v. 7. work. .. Das fehlende Stück und was v.8. addiert ,. ist der Extraktor selbst.
Cloudflare schifft eine Edge-Version einer ähnlichen Funktion, die in Ordnung ist, wenn Sie den Edge besitzen, einen selbst gehosteten StyloBot-Operator, der nicht mehr ' oder , ist und drei Einschränkungen auf die Implementierung setzt.
- Der Standort ist stromaufwärts vom StyloBot-Gateway. Cloudflare kann Markdown dienen, weil sie die Kante SIND - . Ein StyloBot-Gateway sitzt vor den vorgelagerten Ursprüngen es doesn't Kontrolle mit YARPDer Inhalt muss auf dem Gateway hop extrahiert werden.,. Nicht am Ursprung und nicht bei einigen SaaS-Runden.MSC2.trip... Die vorgelagerte Site bleibt unberührt.
- Keine Python, keine Node, kein separater Dienst Das Gateway ist ein einziges AOTVeröffentlichte binäre Version , . , Hinzufügen eines Python Sidecars für HTML zu Markdown besiegt die Bereitstellung Form , . ,
- Schnell genug, um auf dem heißen Pfad zu sitzen Wenn der Operator Markdown zu KI-Crawlern speichert, fügt " die 200ms pro Anfrage hinzu und schaltet es aus. .. Das Budget ist sub--15.ms p.99. auf einem Cache-Hit.,. Das ist das, was die vorhandene Erkennungsmiddleware innerhalb von . lebt.
Verdrahtung einer extract-markdown Politik, um bei /«docs«/«*" ist eine Konfigurationslinie, die ein kleines Adapterpaket enthält.Mostlylucid.BotDetection.StyloExtractEin Bediener lässt das Paket in die Regel fallen und KI-Crawler beginnen Markdown für dieselben URLs zu empfangen, die HTML immer noch Menschen dienen.
StyloExtract hat drei Fluchtebenen, in der Reihenfolge von Kosten,:
- Statische Extraktion Der Standard-Pfad: ., Parse-,, clean, ,, klassifizieren ,, walk, ,, rendern ., läuft auf dem heißen Pfad des Gateways ohne zusätzliche Abhängigkeiten.
- Wiedergaberecht-Rendering-. Optionales Paket: ,.' Betreibt ein kopfloses Chromium für SPAs, deren sichtbarer Inhalt Client ist , -'side nach dem Seitenladen , die gleiche Downstream-Pipeline , ;' nur verschiedene Picker ,
- Operator-Vorlagen Manuelle Fluchtluke – eine YAML-Datei pro feindlichem Host – eine Pinnung des MainContent Selektors – eine Hot---Datei
Der statische Pfad ist der, der auf dem heißen Pfad lebt.Die anderen beiden existieren, weil real.-.world HTML in zwei unterschiedlichen Weisen gebrochen wird.
Was eigentlich bedeutet, Markdown zu extrahieren?
Wenn Sie lesen, die Spezifität bei face value-,-M"-convert HTML zu Markdown-"- ist ein gelöstes Problem Es gibt Dutzende von Bibliotheken..-Realität ist sie alle degradieren auf realen Seiten, weil sie das Dokument als flachen Inhalt und die Seite als Scoping nehmen
Echte messk0 world Web-Seiten sind, um zu verhindern, dass der Artikel, den Sie wirklich wollen Leben in zwei oder drei Verpackung <div>s aus zwei oder drei hundert T. Ein naives HTML...-...-...Markdown-Bibliothek konvertiert alles, was jeder nav-Link, jede Cookie-Banner Phrase, jede Fußzeile, jedes verwandte -.Post Sidebar, jeden Share Button, jede Modaltaste, die von CSS versteckt wird, aber im DOM.. vorhanden ist Der Crawler fragte nach dem Artikel, ;.Sie reichten ihm eine komplette 50.KB Markdown-Datei mit dem Artikel irgendwo auf der Linie begraben.
So hat der Extraktor zwei Jobs zu tun.
- Identifizieren Sie den Körper. Welcher Unterbaum des geparsten DOM den eigentlichen Inhalt enthält und welche Unterbäume Chrom sind.?
- Render der Körper - . Sobald you-'-ve isoliert es ,,-Projekt, das subtree zu Markdown, das die Struktur ein nachgeschalteter Leser bewahrt , (-human oder LLM-MSC3- sorgt sich um ,:-Position Hierarchie , ,-Inline-Links , lists , ,-Tabellen .,-Codeblöcke ,
Identifikation ist das härtere, .-Dort ist ein ganzes Feld der wissenschaftlichen Literatur auf ihm Extraktion von Webinhalten und der festgelegte Referenzwert ist WCXBDer Stand der Technik, als ich anfing zu lesen, war ein Python-Tool namens TrafilaturaIch portierte die last-- austragenden Ideen zu . NET und fügte eine Schicht hinzu Trafilatura doesns -' nicht haben ,: , per .- host Musterlernen über strukturelles Fingerabdruck-Verfahren
Die Form ist:
parse HTML → clean → fingerprint the structure → does this fingerprint
  match a template I've seen on this host before?
    yes → apply the cached extractor → render
    no  → run the heuristic classifier → induce a fresh extractor →
          cache it under this host's fingerprint → render
Das erste Mal, dass das Gateway eine Seite von einem Host sieht, zahlt es den vollen heuristischen .- .Klassifikator kosten .(~200 .μs für eine mittlere Seite . ). . Jede folgende Seite von diesem Host, deren strukturelle Fingerabdruck-Matches bekommt die zwischengespeicherte Extraktor statt ?, , was ist eine Handvoll CSS . - .Selector Abfragen .
Der Fingerabdruck ist ein MinHash Skizze über eine normierte DOM---Path-Darstellung mit einem LSH bander an der Oberseite für sub---Millisekunde-Sonde - .-Die mathematische Übereinstimmung macht es nicht aus, für diesen Artikel eine Rolle zu spielen.;-Was zählt ist, dass es das per-MSC4-Host-Lernen billig genug macht, um auf jeder Anfrage laufen zu lassen.
Der Wanderer
Die Render-Seite ist, wo die Hundefutterschleife machte mich verdienen Sie es
Die erste Version von StyloExtract emittierte Markdown durch Gehen der klassifizierten Blöcke und Projektion element.TextContent.Trim() in die Ausgabe Jeder Block wurde zu einem Absatz Jede Überschrift wurde # text unabhängig davon, ob es H.1 oder H. M.S.K1 kollabierte Anker zu bloßem Text......... Listen verloren ihre Kugeln.........
Dies ist technisch Technisch "-Markdown-."-Es ist auch nutzlos .-Der KI-Crawler fragt nach Markdown zu Vermeiden Sie Parsing ChromUnd wir geben ihm eine Wand von Absätzen, wo das einzige Signal gelegentlich einfach ist.-.text Substantive Phrasen. Der ganze Punkt des Servierens Markdown ist, dass die Struktur Informationen trägt.MSC3.Streifen Sie die Struktur und you.'.ve gerade gegeben dem Raupen einen etwas kleineren Beutel String.
So die nächste Version von StyloExtract geht das DOM jedes klassifizierten Inhalts Block und emittiert real GFM:
<h1>bis<h6>werden Sie durch 6#Zeichen<a href>wird[text](href)<em>und<strong>ihre Betonung behalten<code>bleibt rückgestrichen<pre>wird ein eingezäunter Block mitlanguage-xmitgeführt über<ul>und<ol>echte Kugeln und nummerierte Listen emittieren<blockquote>Präfixe jeder Zeile mit>Und das Multi---Absatz-Zitat erhält die> body\n>\n> bodyKonventionen<table>wird über eine WASWG-Slot---Grid-Algorithmus mit korrektem colspan -/ rowspan -/ caption-Ausrichtungshandling - / , fallen zurück zu rohem HTML, wenn die Quelle ist für GFM zu komplex zum Ausdruck bringen - ( , multimedial - ,row thead ,, , verschachtelte Tabellen, , Blockinhalt in einer Zelle- Bilder rendern als
ob sie sich in Prosa oder Standalone in Linie befinden<figure>
Der Walker ist ein StringBuilder pro Block, ein interner Scratchpuffer, der über Zellen hinweg wiederverwendet wird.
Der Walker ist auch der Teil, der zuerst brach
Die Hundefutterschleife
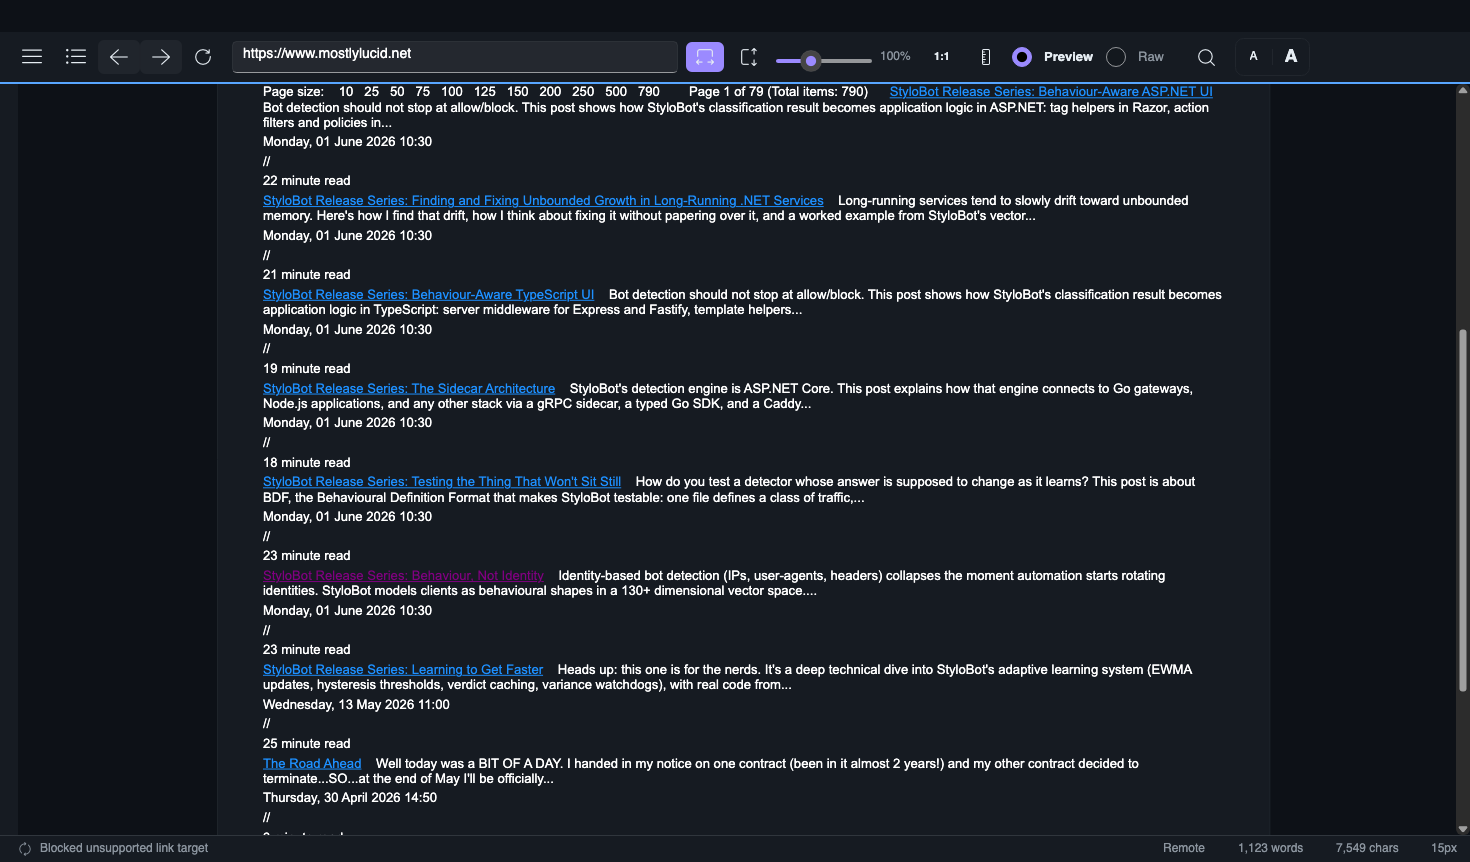
lucidVIEW ist eine cross-Plattform Avalonia Desktop Markdown Viewer Ich habe gut gebaut, bevor StyloExtract existierte. Meistlylucid, ., NaiadDie eingebettete Mermaid-Renderergabel, die innerhalb es Schiffe öffnet .md Datei: ,, die es nativ mit Mermaid-Unterstützung rendern. ,, erhalten Sie weiter mit dem Tag, wenn StyloExtract ausgeliefert wird.,, lucidVIEW wuchs ein Öffnen Web-Seite... ", Befehl "(, Strg" +, Shift-+, ):, fügt eine URL ein.,, die App holt sie in -, Prozess.",, übergibt das HTML an StyLoExtractive ,, und gibt wieder, was immer Markdown zurückkommt.
Was lucidVIEW mir gegeben wurde, war eine Hundefutterschleife mit Zähnen... Die anderen StyloBot-Release-Artikel der Serie - sprechen über das Dashboard als die Hundefutteroberfläche.;. ich.-I'-m in der Schleife - .-I'-ll verzeihen eine Menge seltsames ,--looking output solange die zugrunde liegenden Zähler richtig sind -.-
lucidVIEW rendert Markdown zu einem nachgeschalteten Leser -( , aber lesen Inhalt-MSC2 , es ist die gleiche Form wie der KI-Crawler verwenden case , : , jemand verbraucht meine Ausgabe als die InhaltNicht als Instrumentierung Wenn der Ausgang falsch ist, sehen Sie ihn sofort... Dort gibt es keine Abstraktionsschicht zwischen dem X-".Der Extraktor produzierte X-". und dem X -".Ich lese X - .".
Also öffne ich lucidVIEW, die auf meinen eigenen Blog-Index zeigen.Die Karten rendern. [Post title](/blog/post) Der wortwörtliche Klammertext - statt als stilisierter, anklickbarer Link "MSC2"
Die Unit-Suite ist grün ,. , die Fixierung I' , geschrieben für ." , innen eingekerbt HTML , " , durchläuft . , Die Ausgabe enthält den String [Post title](/blog/post)Der Markdown ist sowieso falsch.
Die Fehlerklasse, die kein Test erwischt hätte
Der Blog-Index ist mit Tailwind ,. , Tail Wind Ausgabe wird für die Lesbarkeit eingerückt gebaut .: , jeder Wrapper Div sitzt zwei Räume weiter in als seine Eltern , . , Um die Zeit erreichen Sie den tatsächlichen Anker für einen blog ,- ,card link , , , die Quelle HTML sieht aus wie ?: ,
<section class="...">
    <div class="container...">
        <div class="grid...">
            <div class="card...">
                <a href="/blog/post-a">Post title</a>
                ...
Der Walker-Text von -, der mit dem Handling hilft, , AppendEscapedInlineIm Inneren eines Aufrufs tut es dies korrekt. prevWs Flagge, die sukzessive Whitespace-Emissionen unterdrückt Zwischen Anrufen,. die Flagge zurücksetzt..Also, wenn der Walker aufeinanderfolgenden Text besucht-.node-. von -.Whitespace Geschwister ist genau das, was eingerückt HTML produziert zwischen leeren Inline-Elemente.-. jeder Aufruf emittiert einen kollabierten führenden Raum an der Linie-.start
Vier Umhüllungen der Einrückung... vier Text... HäufigMarkierung' Eingerückt -Eingedrückter Code-Block Regelbrände an vier Leerzeichen .Der Walker [Post title](/blog/post) landet auf einer Linie, die mit vier Leerzeichen beginnt Markdig parsiert die gesamte Zeile als Codeblock.Der Klammertext rendert als wörtlicher Text.Der Link ist tot.
Der Einheitstest besteht, weil der Test die Zeichenkette behauptet [Post title](/blog/post) Irgendwo in der Ausgabe erscheint - . - Es tut -. - es ist gerade innerhalb eines Code-Blocks jetzt - . -
Die Fixierung ist zwei Linien, die an der Linie, -, starten, ,, prime prevWs = true und die zuerst Leading Whitespace von jedem Textknoten wird übersprungen statt ausgestrahlt ,. , Führende Whitespace innen eingekerbt HTML nie erreicht die Ausgabe .. , Inner , - , Absatz läuft immer noch zusammenbrechen zu einzelnen Leerzeichen ?. ,
Das Interessante ist, was der Test sollte haben geltend gemacht ,. , Oberfläche , - , Text .Contains() überprüft die Zeichen Sie waren gerade in der falschen CommonMark Block Type, was ich brauchte war ein Strukturelle argumentation:-Parse der Walker-'-Ausgabe mit einem echten CommonMark Parser und behaupten Absätze sind Paragraphen ,,-Links sind Links , , , keine falschen Code-Blöcke , . , Markdig , ' AST gibt Ihnen, dass für free , und die Bug Fix landete mit einem Regressionstest ,, und die Regression Test mit einer Lint Harness landete , ein kleiner Helfer, der jeden Walker Ausgang nimmt , die , , parsiert es mit Markdig-,-und behauptet ,:
- Null eingerückte Codeblöcke, es sei denn, ein eingezäunter Block ist die Quelle
- Jeder Link in der Quelle HTML überlebt als eine echte
LinkInlinein der AST - Die eingezäunte Anzahl der Blöcke entspricht der deklarierten Erwartung
Um zu beweisen, dass die funte Zähne hatte, habe ich den ursprünglichen Fix umgedreht und die Funte-Suite ausgeführt.Genau ein Test scheiterte an -, der die vier benutzt.-.Wrapperform...Restaurieren Sie das fix.,.
Diese einzelne Prüfung läuft jetzt über jeden Walker-Test in der Suite... Zukünftige Regressionen derselben Klasse werden strukturell gefangen.MSC1. nicht durch String-Matching, was bedeutet, dass I'.ll sie in CI statt in lucidVIEW®. findet.
Was Hundefutter eigentlich verlangt
Es ist eine Phase in jedem Produkt, wo das Gerät Tests grün sind und die Demo funktioniert und der Bediener hat die richtigen Konfigurationsflaggen gesetzt und Sie versenden eine Freigabe und einen Tag später ein Benutzer öffnet ein Problem sagen, dass -".this doesn't work on real content -.".Jedes Produkt trifft diese - .. Die ehrliche Antwort ist, dass die Testvorrichtungen und der Demo-Inhalt steril in einer Weise sind echte Inhalte ist - '.t ...
Die dogfooding Schleife ist der billigste Weg aus dieser Falle, die .. Die Phrase, die " wird lose verwendet in diesem Fall bedeutet es etwas Spezifisches, .. lucidVIEW ist ein EinzelerzeugnisMit getrennten Benutzern, die zufällig StyloExtract-'s Ausgabe als seine Produktoberfläche zu verbrauchenWenn lucidVIEW zeigt gebrochene Markdown-Markdown-, lucidVIEW-' s Benutzer beschweren sich über lucideVIEW -. .Die Beschwerde Oberflächen in einem separaten Problem Tracker ., , mit einer separaten Triage Warteschlange . , , gegen eine separate Version .
Dass Trennung zählt, wenn lucidVIEW ein StyloExtract Test-Fixture war.,.I'.d haben es mit sterilen Inhalt geschrieben, weil ich weiß, was der Extraktor mag., weil lucidVIEW in seiner eigenen Welt existiert., zeigt es auf mein aktuelles Blog., das Tailwind verwendet.,,., welches die eingekerbte HTML-Form produziert, die die Fehlerklasse auslöst., .. Der Bug tauchte in fünf Minuten der Verwendung des Produkts als Benutzer auf.
Eine Menge der v-1.7.-X gibt Spur zurück zu dieser Schleife..-X Der strukturierte --Walker-Ausgang wurde ausgeliefert, weil lucidVIEW-X'-Erstversion unlesbar war, als StyloExtract flache Absätze aussendete. .-X Die führende --Xinraum-Fix (-XV1.7.1)-X wurde versandt, weil die post-MSC10-X in Tailwind-Sites sichtbar gebrochen wurde..-XInstandsetzung Die Ausgabe --Xintenbaum geliefert, da ich wollte, dass die nächste Bugklasse CI---Xaught.-X
Der Beitrag dieses Artikels benennt es. Verbraucherprodukt parallel zu Ihrem InfrastrukturproduktDie Fehlerrate an der Infrastruktur-Schicht sinkt um die Menge, auf der sich der Verbraucher befindet. Klasse Abdeckung an der Infrastruktur-Schicht erweitert um alles, was der Verbraucher bemerkt, dass Sie nicht denken, einen Test für schreiben
Geschlossene Schleifen über den Stack
StyloExtract -/ lucidVIEW ist eine Instanz eines Musters, das ich über jedes Projekt laufe.
flowchart LR
    PB[visible product<br/>behaviour] --> TR[test/review<br/>loop]
    TR --> AP[architectural<br/>primitive]
    AP --> RL[reusable<br/>library]
    RL --> WE[written<br/>explanation]
    WE --> LG[LLM-readable<br/>grammar]
    LG --> NP[next<br/>product]
    NP --> PB
Ein Fehleroberflächen in einem Produkt Der Fix wird zu einer strukturellen Behauptung Das Primitive wird zur Bibliothek Die Bibliothek wird über geschrieben Das Schreiben baut eine LLM.- lesbare Grammatik rund um die Codebase Die Grammatik macht das nächste Produkt schneller zu bauen Das nächste Produkt Oberflächen neue Bugs in den Bibliotheken es hängt davon ab
Die Abhängigkeit Graph, dass dies produziert in den Projekten, die ich laufe,,' sieht so aus
flowchart TB
    LV[lucidVIEW<br/>Avalonia markdown reader]
    SB[StyloBot<br/>detection gateway]
    SF[StyloFlow<br/>policy + flow runtime]
    SE[StyloExtract<br/>HTML → Markdown]
    NA[mostlylucid.Naiad<br/>Mermaid renderer fork]
    DA[mostlylucid.dagre<br/>graph layout]
    EP[mostlylucid.ephemeral<br/>signal + sketch primitives]
    UT[Mostlylucid.Avalonia.UITesting<br/>Avalonia UI test framework]

    SB --> SF
    SB --> SE
    LV --> SE
    LV --> NA
    NA --> DA
    SE --> EP
    SF --> EP
    LV -.tests via.-> UT
Mostlylucid.Avalonia.UITesting ist das Bit, das die lucidVIEW Seite der Schleife reproduzierbar macht ?. ?Es ist die Avalonia UI Testbaum lucideVIEW Verwendungen für drag ®, klick- ., ? scroll- ? , screenshot- und Scriptwiedergabe Â; ? jeder lucidVIEW Screenshot in diesem Artikel wurde von ihm erfasst Mit dem Desktop-Seite automatisiert ..., ? jede fix zu StyloExtract, dass luzidVIEW Enthüllungen können nachgespielt und verifiziert werden, ohne die App wieder öffnen und klicken durch per Hand ...Mostlylucid.StyloExtract.Playwright ist nicht mit der Testschleife verbunden, es ist der JS.-.rendering Input fetcher, das in seinem eigenen Abschnitt unten behandelt wird.
Der Handel ist real, die Grafik ist self, - referential, und das hat einen Fehler in mostlylucid.ephemeral Ripples up durch StyloExtract und StyloFlow in StyLoBot und lucidVIEW-.-Die Abschwächung ist die Zeit...-...boxed releases (no feature cryeline , the version ships, wenn das Zielgebiet es beansprucht Schiffe.) und dass jede Schicht ihre eigene Testsuite hat.." Der Vorteil ist, dass ich über alle von ihnen in einer Woche arbeiten kann und die Kosten des Kontextes...-switching zwischen ihnen bleibt niedrig, weil jede Schicht die gleiche Form hat.
Es bedeutet auch, diesen Artikel zu schreiben ist die Seite des Designs in Prosa schliesst die Schleife, die begann mit "®blog-Karten machen falsch in lucidVIEW]"« und endet mit dem nächsten Verbraucher von StyloExtract hat einen strukturellen funten Helfer und eine dokumentierte Walker Vertrag.
Das funktioniert für mich, weil das Schließen von Schleifen ist, wie ich denke Arbeitsablauf wahrscheinlich nicht generalisiert , , . , die Lokaler Markdown-Modus produziert es does..
Wie lucidVIEW es in
flowchart LR
    URL[URL bar] --> Fetch[HttpClient GET<br/>Accept: text/markdown, text/html]
    Fetch --> Sniff{Content-Type}
    Sniff -->|text/markdown| Render[LiveMarkdown.Avalonia]
    Sniff -->|text/html| Convert[HtmlToMarkdownService]
    Convert --> Sparse{< 200 chars +<br/>SPA markers?}
    Sparse -->|yes| Stub[Stub: needs JS,<br/>open in browser?]
    Sparse -->|no| Render
    Stub --> Render
Vier Paketreferenzen und ein Service
public sealed class HtmlToMarkdownService
{
    private readonly IHtmlDomParser _parser = new AngleSharpHtmlDomParser();
    private readonly IDomCleaner _cleaner = new DomCleaner();
    private readonly IBlockSegmenter _segmenter = new BlockSegmenter();
    private readonly IBlockClassifier _classifier =
        HeuristicBlockClassifier.LoadFromEmbeddedResources();
    private readonly IMarkdownRenderer _renderer = new TypedMarkdownRenderer();

    public string Convert(string html, Uri? sourceUri = null)
    {
        var doc = _parser.Parse(html, sourceUri);
        _cleaner.Clean(doc);
        var blocks = _classifier.Classify(_segmenter.Segment(doc));
        return _renderer.Render(blocks, ExtractionProfile.RagFull);
    }
}
Das ist es .. Ein Status-Symbol zeigt an, welcher Pfad lief (.direct MD konvertierte /. SPA Stub.). Wenn also etwas falsch aussieht, kann der Benutzer auf die richtige Schicht zeigen.
Die Pipeline – ,- nach der Phase
flowchart LR
    HTML[HTML] --> P[AngleSharpHtmlDomParser]
    P --> C[DomCleaner<br/>strip script/style]
    C --> S[BlockSegmenter<br/>candidate subtrees]
    S --> K[HeuristicBlockClassifier<br/>role + score]
    K --> W[DomMarkdownWalker<br/>GFM per block]
    W --> R[TypedMarkdownRenderer<br/>profile gate]
    R --> MD[Markdown]
Parser +-Reiniger sind Winkelscharf Wrappers®.- Der interessante Code beginnt bei der Segmentierung.
Segmentierer Gehen Sie den Körper, um jeden semantischen Tag zu versenken.main/article/section/h1-h6/ul/preZuzüglich aller <div>/<section> dass ,''s Text , - , schwer oder hat viele Kinder , . , Alles andere ist zu klein, um zufrieden zu sein
public IReadOnlyList<IElement> Segment(IDocument document)
{
    if (document.Body is null) return Array.Empty<IElement>();
    var result = new List<IElement>();
    Walk(document.Body, result);
    return result;
}

private static void Walk(IElement element, List<IElement> sink)
{
    if (SemanticTags.Contains(element.TagName))   sink.Add(element);
    else if (IsBlockyDiv(element))                sink.Add(element);
    foreach (var child in element.Children) Walk(child, sink);
}
Klassifikator Punktezahl jeder Kandidat wählen nicht , - , überlappende Gewinner ,, , Tag mit einem BlockRole Hauptinhalt: ,, Richtung ,, Navigation: ,, Kesselplatte: MKS4, wiederholtArtikel: MSC5, jeder ausgewählte Block erhält seine DOM in strukturierte Markdown: :,
foreach (var element in selected)
{
    var role = ClassifyRole(element);
    yield return new ExtractedBlock
    {
        Role     = role,
        Text     = element.TextContent.Trim(),
        Markdown = ShouldRenderMarkdown(role) ? DomMarkdownWalker.Render(element) : "",
        Links    = ExtractLinks(element),
        XPath    = XPathBuilder.For(element),
        // ...
    };
}
Walker-. Ein StringBuilder, ein DOM Pass <a> Fall ist, in dem der Fehler lebte
case "a":
    var href = el.GetAttribute("href") ?? "";
    if (href.Length == 0) { WriteInlineChildren(dest, el); return; }
    dest.Append('[');
    WriteInlineChildren(dest, el);
    dest.Append("](").Append(href).Append(')');
    return;
Die Fixierung war nicht hier. AppendEscapedInline, die führenden Whitespace in gefüttert dest vor diesem Fall je liefen ,.' Vier Räume vor [ macht CommonMark parse die Zeile als Codeblock
Renderer-. Tor für Profil RagFull hält Artikel - - -Kontext , ( , Breadcrumb , , RelatedLinks ,) , und Tropfen Chrom , ( , Footer, , , Header, , , CookieBanner, , , Nav-). MainContentOnly hält nur den Körper AgentNavigation hält nur Navi-( für Crawler-MSC1-Link Entdeckung
return p switch
{
    ExtractionProfile.RagFull => b.Role is not (BlockRole.Footer or BlockRole.Header
        or BlockRole.Advertisement or BlockRole.CookieBanner or BlockRole.Boilerplate
        or BlockRole.Unknown or BlockRole.PrimaryNavigation or BlockRole.SecondaryNavigation),
    ExtractionProfile.MainContentOnly => b.Role is BlockRole.MainContent or BlockRole.Article
        or BlockRole.Heading or BlockRole.Summary or BlockRole.Table or BlockRole.CodeBlock
        or BlockRole.RepeatedItem,
    ExtractionProfile.AgentNavigation => b.Role is BlockRole.PrimaryNavigation
        or BlockRole.SecondaryNavigation or BlockRole.Breadcrumb or BlockRole.Form,
    _ => true
};
Playwright für gestrichelte Seiten
StyloExtract-''s heuristic arbeitet auf dem statischen HTML der Server zurückgegeben wurde, dass die meisten Nachrichten Artikel URLs .).' Es bricht auf SPA-Shells, wo der sichtbare Inhalt ist hydratisiert Client . __NEXT_DATA__, __NUXT__, __APOLLO_STATE__Das statische HTML gibt es Meta-Tags, ein Skelett und es gibt keinen Körper für den Klassifikator zu finden.
Mostlylucid.StyloExtract.Playwright Stecker in stromaufwärts der Pipeline, es implementiert IRenderedHtmlFetcherEin kopfloses Chrom wird über Wiedergaberecht,, wartet auf Hydratation und gibt die Post -JS HTML an den Rest des Extraktors
public async Task<RenderedHtmlResult> FetchAsync(
    Uri uri, RenderOptions? options = null, CancellationToken cancellationToken = default)
{
    var page = await _context.NewPageAsync();
    await page.GotoAsync(uri.ToString(), new PageGotoOptions
    {
        WaitUntil = WaitUntilState.NetworkIdle,
        Timeout = options?.NavigationTimeoutMs ?? 15000,
    });
    var html = await page.ContentAsync();
    await page.CloseAsync();
    return new RenderedHtmlResult { Html = html, FinalUrl = page.Url };
}
Der einzige Unterschied ist, dass der Eingang HTML jetzt das hydratisierte DOM enthält, das die JS produzierte.
flowchart LR
    URL[URL] --> Choice{Render mode}
    Choice -->|static| HTTP[HttpClient]
    Choice -->|js-required| PW[PlaywrightHtmlFetcher<br/>headless Chromium]
    HTTP --> Pipeline[parse → clean → segment<br/>→ classify → walk → render]
    PW --> Pipeline
    Pipeline --> MD[Markdown]
Dies ist die richtige Antwort, wenn ein Operator mit StyloExtract server- und Headless-Browser eine vernünftige Abhängigkeit hat... Der CLI liefert zwei Binaries für genau diesen Split. stylo-extract (, AOT-,, ~12, MKS3, statisch, nur ) und stylo-extract-playwright (~120-MB einmal Playwright , ' , Browser Pack Lands ,, , JS.- , umsetzbar , ). ,
lucidVIEW verwendet es nicht lucidVIEW ist ein Markdown-Lesegerät, das sich mit seiner Identität auszeichnet."; kein Chromium; ,; keine Browser-Engine;,; kein 200; MB Abhängigkeiten für eine Funktion;MSC5; Bündelung von Playwright; würde einen kopflosen Browser in einer App einsetzen, dessen Pitch die Abwesenheit von einem .; Der unten beschriebene SPA-Stub ist die richtige Antwort aus der Perspektive von lucidVIEW;'; erklären dem Benutzer, dass die Seite einen Browser benötigt;MSZ9; Hand it off to theires; .; Ein Server, der über StyloBot verfügt, hat keine solche Einschränkung und Vorteile durch den Betrieb beider Binärseiten.MSC12; von -; auf der Seite des .;
Anderes Hundefutter
Vier Nicht---Bugs, die lucidVIEWEH' Ausfälle geformt haben
Die Spezifität, die v-1.7.0.-Antrieb Erstes Bauen emittierte flache Absätze
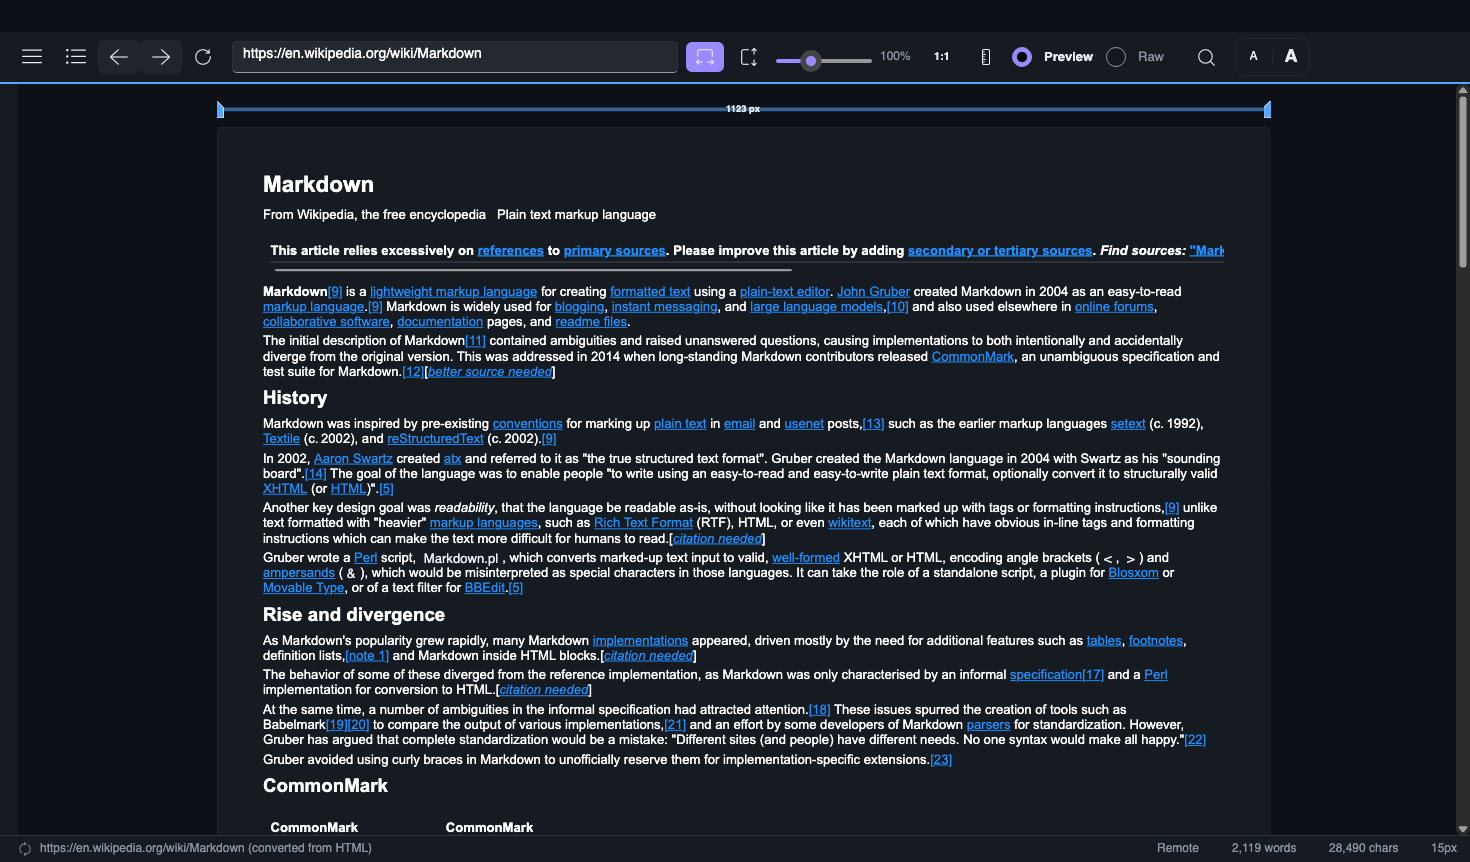
element.TextContent.Trim()pro block.).-Wikipedia war unlesbar, ,-Blogkarten verloren jeden Anker, anstatt es besser zu machen, schrieb ichdocs/styloextract-markdown-spec.mdenumerating what was fehlte.:-Heading Levels, ,-Inline Runs, ,-Listen, M,-GFM Tabellen, ,-Blockimages, mit vier reproduzierenden URLs,.-Der strukturierte --Wandler arbeitet in v-1.7.0-Implementierungen, die spezifizierenSPA-Seiten
bbc.com/newsist Nächster ,. , js , : , statisches HTML ist Meta-Tags__NEXT_DATA__JSON-Blob, hydratisiert von JS-.-StyloExtract gibt korrekt zurück.~1-Zeichen, weil es kein Körper gibt.MSC3-LucidVIEW schnüffelt jetzt für bekannte Rahmenmarker.__NEXT_DATA__,__NUXT__,__APOLLO_STATE__,data-reactroot,ng-version=,__REMIX_DATA__) und , auf spärliche Ausgabe + Markierung macht einen Stub Diese Seite verwendet {, um Rahmen zu benutzen };, lucidVIEW läuft nicht mit JavaScript, im Browser öffnen Artikel-URLs von BBC-'/news/articles/<id>), die wirklich dienen<main>und konvertieren cleanly-.-Homepage Artikel Asymmetrie-,-nicht ein Konverterfehler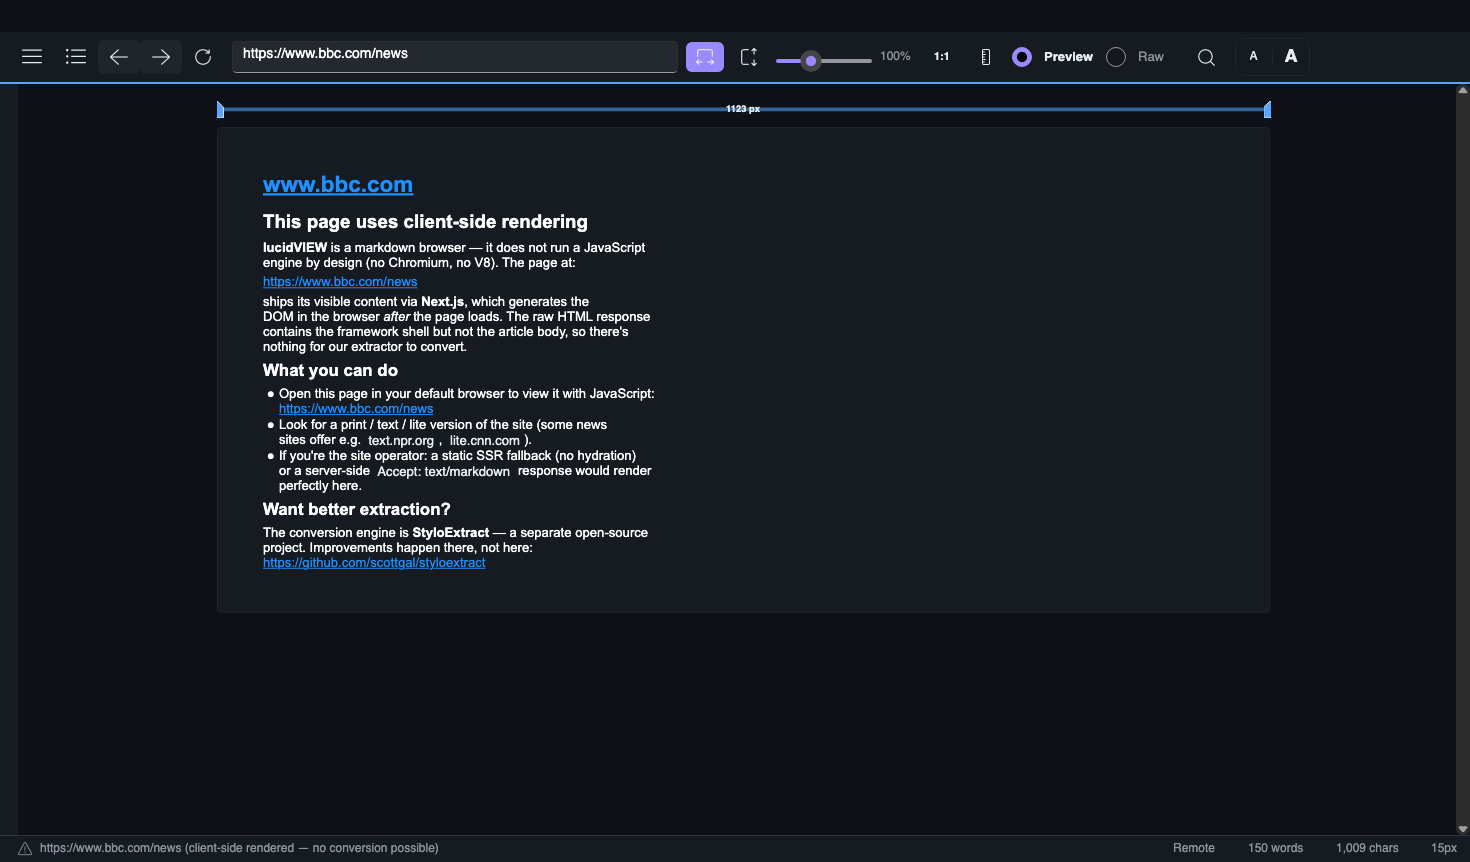
Semantisch---freie Seiten
example.comhat keine<main>Nicht zutreffend<article>Die Heuristische liefert nichts zurück. Der gleiche Stubfluss fängt ihn an.Richtig ,- , aber nicht emittieren Mein Blog ' s Kategorie Filter ist
<select><option>Der Walker findet keine<a href>Emittent den Optionstext als einen Absatz. Alle AKP-Staaten und AKP-Länder Korrekte Optionen sind: ', aber optisch schrecklich, ein zukünftiger Walkerpass könnte erkennen<select>und eine Definitionsliste abgeben oder[42 categories]Zusammenfassung
Plus eine Leitplanke, die aus dem Widerstand gegen die offensichtliche Abkürzung kam... Wenn Extraktion dünn ist, wird die Versuchung zu Jina Reader zurückfallen..../ räumen Sie die Benutzer-URLs durch einen dritten - Parteileser macht den Leser zu einem Datenschutzleck;. jede URL der Benutzer besucht fließt durch einige andere Operator?'s Protokolle .. Die Fallback-Kette bleibt lokal.:. Direkte Markierung ,. dann HTML über StyloExtract],. <meta> / og: Tags, , dann im Browser öffnen ?" , jeder Schritt Feeds StyloExtract eine andere Entnahme aus dem gleichen Ursprung oder Synthesen von Daten, die wir bereits haben, ist die Antwort auf die Antwort, dass " dies nicht konvertiert hat." ist nie ein anderer Konverter verwenden
Die willkürliche Abdeckungslücke
Was die dogfood-Schleife ist gut zu finden, ist gebrochene Ausgabe auf gut Ausgeprägten Seiten Ausgeformten Seiten Ausgedehnte Ausgabe auf seltsamen - Ausgemusterten Seiten
Ich habe einen Rauch---Runner jetzt, das ein Dutzend echte holt ?-?world Aufstellungsorte und dumpt den Extraktor ?'?s Ausgang ?mesK3? Auf der strukturell kooperativen Hälfte ?-? news Â( â BBC® MSC6â Guardiané),â Wikipedia â , â GitHub repo READMEs ? , â Ghost®. âorg â 'âs Changelog â ,â Hacker News â MSC13â Der heuristische Klassifikator findet die wichtigsten Inhalte sauber und der Walker produziert lesbar Markdown ? .â Zehn bis dreißig Kilobyte saubere Prosa pro Seite ?
Auf der anderen Hälfte des Albums - Allbirds ( Shopify" , ),'s Marketing-Seite "MSC4" alles, was mit einer benutzerdefinierten Tailwind Komponentenbibliothek gebaut wurde , findet der Klassifikator NichtsAlle Kandidaten werden auf Boilerplate degradiert, weil die Seite nicht verwendet wird. <main> oder <article> und die Klassennamen don-'-t entsprechen einem der Muster im Rahmen.
Hinzufügen von mehr Einträgen zu dieser JSON-Datei ist die offensichtliche Move-Move-.-It-'-s auch wack---a-M--mole-.-Jede Theme-Shop Schiffe neue Klassennamen..-s Jede Veröffentlichung von Shopify ändert sie....-s Kuratieren einer Liste aller CMS-Theme-'-s-Klassen ist ein vollwertiger --Zeit-Job und die Liste ist am Tag, an dem Sie es veröffentlichen, veraltet
Die reale Fix ist ein trainiertes Modell ,. , Per , - , Element Features , ( , Tag identity, , class , - , Name Hash Eimer ,, , Text , text , S- , Länge ., , Link, - , Dichte , und , , Geschwisterform, , , Ahnenpräsenz , in einem kleinen Gradienten ,...- , Boosted Klassifikator , auf dem WCXB beschriftet corpus-,-exportiert in ONNXAus dem Netz aus dem Netz aufgerufen Microsoft.ML.OnnxRuntimeDas Modell erweitert die heuristische Version, indem es Elemente fördert, die die Heuristik fallengelassen hat, wenn ihr eigenes Vertrauen hoch ist.
Das Design dafür ist in der StyloExtract repo engagiert.docs/ml-classifier-v2-design.mdDas, was es blockiert ist ' engineering bemühung - ; -' - ist die Operator-Frage von " - ein 25 -MB ONNX Runtime native binary in das Gateway - , - oder halten Sie ML als separates optionales Pack, das der Bediener wählt, um ??" - die optionale Antwort für ein FOSS-Pack-ökosystem -MS K13 - zu erhalten, aber es bedeutet, dass das Modell standardmäßig .' - an ist, was heißt, dass die meisten Bediener gewonnen haben . ' - es bekommen es nicht , , was bedeutet, die heuristische trägt den größten Teil der Produktionslast eh...
In der Interims-,, was Operatoren erhalten, ist die Handbuch Ausweichluke:-Operator--Authored YAML Templates,-Eine Datei pro Host,-Parsed AOT---Clean,-Hot--Overriding die Induktion Pipeline für diesen Host .-Ein Operator bemerkt, dass weird-shopify-tenant.com produziert leere Markdown-Markdown-, , schreibt eine fünf-- , Linie YAML-Datei, die sagt, für diesen Host , , MainContent ist .product-description-body", stürmt es in config/templates/Die Laufzeit nimmt sie über FileSystemWatcher innerhalb von Sekunden auf. template add/list/show/remove/testDie REST-Oberfläche hat GET/PUT/DELETE/POST Automatisierte Sicherheitsüberprüfung erfasste Pfadtraversen und SSRF in den REST-Endpunkten während des PR-Reviews und diejenigen, die die Regressionssuite für beide Leben im Testprojekt jetzt fixiert haben.
Bedienvorlagen sind der Boden Das ML-Modell ist die Decke Dass es eine Lücke dazwischen ist ehrlich - ist die heuristische ist die Last--Lager Weg heute , und es '.ll bleiben Belastung, bis das Modell trainiert wird und gegen den WCXB F...
Teil dieser Serie ist der ML build--.out... Heuristic -+-per---host-Vorlagen behandelt die gut ---behaved langen Schwanz und der Bediener ,--flagged Kanten , ;-der geschulte Klassifikator handhabt die wirklich unordentlich HTML-.(-Shopify Themen , ,-Notion Marketing-Seiten ,,-Tailwind Komponentenbibliotheken ohne semantische Anker , wo es keine <main>Nicht zutreffend <article>Keine konsistente Klasse-.Namenssignal und kein offensichtlicher Platz für den heuristischen zum Einrasten auf . ist die Antwort zu ".Was über die Seiten, die nicht irgendeine Struktur überhaupt folgen
Wo es Schiffe
StyloExtract ist auf NuGet als eine Reihe von verwandten Paketen ,: , Abstraktionen ., , Heuristics , , , Fingerabdruck , , , Core- , , , Markdown-, MSC5 , AspNetCore , und die CLI Schiffe als stylo-extract (-AOT-,-M~12-MB-Einzel binär-)- und stylo-extract-playwright Mit kopflosem -Browser-Fallback für JS.-Brendered SPAs. Die aktuelle Version ist 1.7.1.
Die StyloBot Integration Schiffe als Mostlylucid.BotDetection.StyloExtractEs zu einem Gateway hinzuzufügen ist zwei Linien von Program.cs und eine Regel in appsettings.json:
{
  "BotDetection": {
    "DetectionPolicies": {
      "Rules": [
        {
          "Name": "ai-bot-docs-markdown",
          "Path": "/docs/*",
          "Types": ["AiBot"],
          "Confidence": ">= 0.85",
          "Action": "extract-markdown"
        }
      ]
    }
  },
  "StyloExtract": {
    "Actions": {
      "extract-markdown": {
        "Profile": "RagFull",
        "Cache": {
          "Mode": "Override",
          "MaxAge": 3600,
          "VaryByBotType": true
        }
      }
    }
  }
}
Was dies sagt: ,: , jede Anfrage der Detektor klassifiziert als AI Bot , , , mit Vertrauen mindestens auf einen Pfad unter /docs/*Das gleiche Gateway dient weiterhin HTML zu jeder anderen Anfrage..-Wert, hier explizit zu sein...:-StyloBot-'-Klassifikator ist verhaltensmäßig nicht ein Benutzer, die --Agent String Match ?.-Es fängt die ehrlichen AI Bots, die sich selbst ankündigen und die hinterhältigen, die nicht sehen Verhalten nicht Identität für wie – ).- entweder Geschmack bekommt die gleiche Antwort – : – eine leichte Markdown Wiedergabeversion statt voller HTML – MSC3 und JavaScript, die sowieso nur geschrottet werden sollte Der Autor der Website bedient weiterhin HTML an Menschen, ohne eine eigene Markdown Webseite zu schreiben – MKK5 – und stoppt das Bezahlen von vollen --Seiten Renderkosten für den Verkehr, die nicht nötig sind
Das ist der lokale Markdown-Modus.Es hängt nicht von Cloudflare ab...Es kostet nicht pro Anfrage. Es läuft auf der gleichen Gateway-Box, die Sie bereits haben.MSC6. Der Klassifikator ist StyloBot... Der Dunstabzugsgeber ist StyloExtract.MSZ8. Die ganze Sache passt in eine AOT.MSSK9.veröffentlichte Binärdatei, die mit docker run und lassen Sie allein.
Was ist eigentlich neu hier?
Was Cloudflare-Schiffe sind ein Bündel, der Klassifikator ( ist proprietär, der Extraktor ( ist wahrscheinlich eine Gabel von Trafilatura oder ähnliches.), ist die Regel-.Evaluierungsoberfläche (.Ihr Dashboard),. und das Edge-.Laufzeitsubstrat (.Ihr globales Netzwerk )..Sie verkaufen es als Einheit, weil es NUR Sinn macht als Einheit an ihrer Position im Stack..
Die gleiche Fähigkeit, die für ein selbst-gehostetes Gateway zersetzt wurde, ist vier separate Dinge, die sich zusammensetzen.
- Ein Klassifikator, der lokal läuft und entscheidet, dass dies ein AI-Crawler ist.
- Ein Extraktor, der lokal läuft und HTML zu lesbarem Markdown konvertiert
- Eine Regel---Evaluierungsoberfläche, die Urteile zu Handlungen kartiert
DetectionPolicyMiddlewarein StyloBot - Das Substrat, auf dem sie alle laufen, was auch immer dein YARP-Gateway ist
Cloudflare besitzt alle vier ,. , ein selbst gehosteter Operator besitzt höchstens drei ,( ,das Substrat ist ihrs ,mesK3 , der Rest ist FOSS-, ). , Der Handel ist das offensichtliche eine ,musk5 , verlieren die globalen Vorteile des Netzwerks ., , gewinnen Sie den Bediener ,messk8 , Steuerungen , messk9 , alles , und- , bezahlt , nicht , - , per-
Der Grund, warum dieser Artikel existiert ist, dass die zweiten und dritten Teile der Zersetzung ---der Extraktor und die Regeloberfläche ---diddd '-t haben eine kohärente lokale Geschichte, als ich begann - .-t Sie tun jetzt -.-t Der Walker ist das, was die Ausgabe tatsächlich nutzbar gemacht - .-t Die Hundenahrungsschleife mit lucidVIEW ist, was den Wanderer wirklich richtig machte -.-Trägerfläche macht die lange Schwanz tragbar, während die ML-Funktion gebaut wird ?.-t
Der ML-Klassifikator für den unordentlichen messy ,- ,HTML tail , . , Es Schiffe, wenn dort etwas zu zeigen , . ,
StyloExtract Quelle: : github.com/scottgal/styloextractDas StyloBot-Integrationspaket lebt im Stylobot repo als Mostlylucid.BotDetection.StyloExtractLUCIDVIEW-Quelle: github.com/scottgal/lucidviewDer CommonMark-Ausgang ist in der Version -. Qualitatives Flinthelfer, der die v-1.7.1-Fehlerschleife geschlossen hat. tests/StyloExtract.Heuristics.Tests/MarkdownOutputLint.cs.