
StyloBot-utsläppsserien: StyloExtract - en lokal HTML-lärning omvandlare till Markdown


StyloBot v8 låter en webbplats ge AI-kralare en kontrollerad Markdown-uppfattning av dess sidor vid sin egen lokala kanten , utan att ge väggen till en CDN lucidVIEW fångat, och Hundfood-loopet som gjorde det ärligt


StyloBot-utsläppsserien
- Behavior, Inte Identitet: varför StyloBot modellerar klienter beteendemässigt
- Behavior-Är medveten ASP.NET UI: servern - skickade ut ytan över det upptäcktsresultatet
- Att hitta och lösa gränslös tillväxt i långtids-, -- och / eller körande- -.-nätverk: den tillförlitlighetsdisciplin som gör motorn tråkig i produktionen
- Behavior-Akvis typscript-UI: Express , Fastify, och webbladerkomponenter
- Sidecar-arkitekturen: hur detektoren kopplas till icke--.NET-skivor
- Att lära sig bli snabbare: adaptiv inlärningssystem, ,, fyra, M SK2, övningsminnet, ,, och bedömningsキャッシュen
- Att testa det som inte stannar kvar: kontrolldisciplinen : en BDF-fielddriver regression M SK2 belastning , och kalibrering
- StyloExtract - en lokal lärande HTML omvandlare till Markdown: HTML, →, Markdown-lagret som paras med detektorn, ,, walkersbug lucidVIEW som fångade, M SK3, och den hundföda-loopan som gjorde det ärligt
Detektorn som bestämmer vilka begäran som får Markdown finns i Behavior, Inte Identitet; policyn - skicka mellanverk som aktiverar extract-markdown handlingen är samma DetectionPolicyMiddleware täckt av Sidecar-arkitekturen; är den tillförlitlighetsdisciplin som hindrar Gateway från att läcka minnet medan det gör detta Att hitta och fixa gränslös tillväxt. källa github.com/scottgalM SK2styloextrakt och konsumenten som upplevde v1.7.1 bug på github.comM SK1scottgal/lucidview.
Vad StyloBot v8 lägger till
När en AI-crawler träffar en väg som operatören har markerat Markdown, kommer den att byta svaret.:, den får GFM från uppgående sidans yta, ,, utan någon kromm.,, ingen JavaScript.
Formen är den uppenbara när klassificeren är på plats. BotType.AiBot med samma snabb-path latens som varje annan bedömelse är v7 workM SK2 Den DetectionPolicyMiddleware i 7.x som skickar ut namngeda handlingspolitiker efter dömande är v7 arbeten . Den sakna biten, , och vad vSSK4 lägger till
Cloudflare skickar en rand version av en liknande dragning, ,, vilket är okej om du äger randen.
- Platsen är uppströms från StyloBot-portaalet. Cloudflare kan tjäna markerdown eftersom de är kanten. YARP. innehållet måste extraheras på Gateway-hoppen , inte vid ursprunget och inte vid någon SaaS-runden M SK2 resa . uppströmsplatsen stannar orörd
- Lokala. Ingen Python, ingen nodM SK2 ingen separat tjänstMSC3 Toren är en enda AOT-Publikerad binär. Att lägga till en Python sidecar för HTML i Markdown misslyckas med deployment-bilden
- tillräckligt snabbt för att sitta på den varma vägen. Om "serve Markdown till AI-crackern " lägger till ♫ 200 ♫ ms per begäran , ♫ så avbryter operatören den ♫
Att koppla extract-markdown policy till "AiBot på /docs/*" är en konfigureringslinj : ett litet adapterpaketMostlylucid.BotDetection.StyloExtract) och sex rader av JSON . En operatör släpper upp paketet i, lägger till regeln , och AI-cracker börjar få Markdown för samma URLs som fortfarande serverar HTML till människor
StyloExtract har tre flyktnivåer, i ordning på kostnadenM SK1
- Statisk extraktion. Standardvägen. Parse, rena , klassificeraMska3 gåMske4 göra utMsko5 Går på portaals varma väg utan extra beroenden Mska6 Handlar varje SSR-sida Mske7
- Playwright rendering. Optionellt paket.driver en huvudlös Chrom för SPAs vars synliga innehåll är hydraterad klient - sida efter sidans laddade sida . Samma bakströms- -Pipeline
- Operatörs-templates. Handlig flykthäcka. En YAML-Datei per fiend host , genom att peka på MainContent-selektorn . Heißa
Den statiska vägen är den som lever på den varma vägen.
Vad """ betyder egentligen
Om du läser specifikationen vid ansiktsvaluta, " konverterar HTML till Markdown" är ett löst problemMSC3 Det finns dussintals bibliotekM SK4 Verkligheten är att de alla bryts ner på riktiga sidor eftersom de tar dokumentet som platt innehåll och sidan som scoping
Verkliga-world- webbsidor är 80-95% boilerplate . Artikeln du faktiskt vill ha lever inuti två eller tre ompackningar <div>s ur två eller tre hundra.
Så extraktorn måste göra två saker
- Identifisera kroppen. Vilket underträd i den analyserade DOM-damen innehåller den faktiska innehållet, och vilka underträd är krom?
- Rendera kroppen. När du har isolerat det, projekterar du att underträdet till Markdown som bevarar strukturen en nedgående läsare. ( människa eller LLM, ) bryr sig om,
Identifiering är den svårare. extraktion av webbinnehåll och det etablerade måttstocket är WCXB. När jag började läsa var det ett Python-verktyg som hette Trafilatura. Jag överförde lasten - som bär idéer till | . | NET och lade fram en lager Trafilatura har inga apparater modelllärning genom fingeravtryck
Formen är:
parse HTML → clean → fingerprint the structure → does this fingerprint
  match a template I've seen on this host before?
    yes → apply the cached extractor → render
    no  → run the heuristic classifier → induce a fresh extractor →
          cache it under this host's fingerprint → render
Första gången portaal ser en sida från en värden, så betalar den fulla heuristiska kostnaden- klassifier kostnaden M SK2μs för en mellanlig sida ). Varje efterföljande sida från den värden vars strukturella fingeravtryck matchar får den kasserade extraktorn iställetMska4 som är en handfull CSS Mska5 väljare sökningar | Mska6μs | mska7 | Samma värden med samma template | Мska9 | vilket är större delen av en sida |Mska10 | gå genom den snabba vägen |mska11 | sidor med nyskapade layouter utlösar en refit
Fingeravtrycket är ett MinHash skissa över en normaliserad DOM-vägsrepresentation LSH bander på toppen för sub- -millisekundersonden. Matchmatematiken spelar ingen roll för den här artikeln. Vad som spelar någon roll är att den gör att varje - -hostlärning är tillräckligt billigt för att fungera på varje begäran.
Gåraren
Renderingssidan är där den dogfooding-loopen fick mig att tjäna det.
Den första versionen av StyloExtract utlöste Markdown genom att gå igenom klassifierade blocker och projicera element.TextContent.Trim() in i utgången . Varje block blev en punkt # text oberoende av om det var H1 eller H 4. Ankar kollapsade till bar text
Detta är tekniskt sett "Markdown." Det är också oanvändbartM SK3 Den AI-kralare ber Markdown att undvika att analysera krom, och vi ger den en vägg av paragrafer där det enda signalet ibland är platt - textbegreppsord fraser, . Hela poängen med att använda Markdown är att strukturen bär med sig information
Så nästa version av StyloExtract går med DOM från varje klassificerad innehållsblock och utsläpper riktiga GFM:
<h1>genom<h6>blir 1 genom 6#tecken<a href>blir[text](href)<em>och<strong>att hålla fokus<code>stannar bakstängd,<pre>blir en fenced block medlanguage-xförflyttad<ul>och<ol>utsläppa riktiga kula och nummererade listor<blockquote>prefixer varje linje med>( och multiplikationen i §1 av - får> body\n>\n> bodykonventionen)<table>rekonstrueras genom WHATWG rutnätsalgoritm med korrekt colspan / radspan ♫ / ♫ caption ♫/ ♫ aligneringshantering ♫ МSK3 ♫ som återfaller till råHTML när källan är för komplex för GFM att uttrycka ♫- Bilder renderar som
vare sig de är inline i prose eller självständiga i<figure>
Blättaren är en StringBuilder per block , en inre scratchbuffer som återanvänds över hela cellerna | / | listadecken |, | och ett enda genomdrag över DOM | МSK3 | Efter att調整a | ( | var det första klippet ♫ 304 | μs | MiSk6 | miSk7 | KB för en tabell | MISk8 | tung sida |MISk9 | den sitter vid
Bäckern är också den del som gick sönder först
Hundfood-loopet
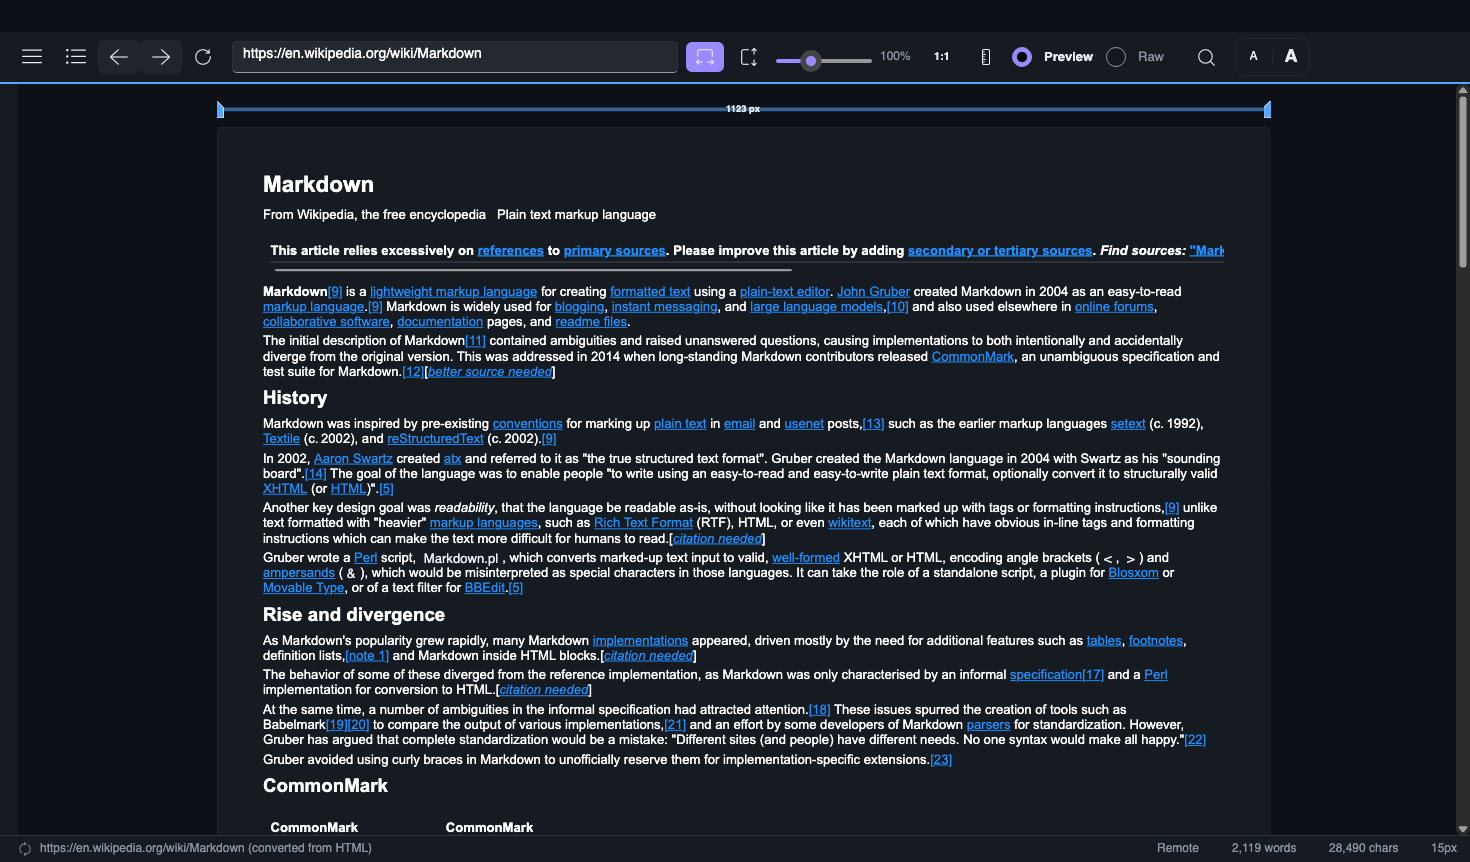
lucidVIEW är en cross-platform Avalonia desktop Markdown-viewer Jag byggde den långt innan StyloExtract fanns. Mostlylucid.Naiad, den inbyggda sjöjungfru-referensspegeln som skepper inuti den .md file, göra det på ett naturligt sätt med Mermaid support , gå igång med dagen. När StyloExtract skickades framM SK3 växte lucidVIEW upp en MSC4Öffra webbsida~" kommando ♫ (Ktrl+ ShiftMska8WMske9 kliva in en URLM Ska10~ får appn fram den i-processenMssa12 tar HTML till Stylo ExtractMsa13 och gör allt Markdown kommer tillbaka tillM Sa14 Ingen serverM sa15 ingen inbyggda webbladerMSA16 inget ChromiumMSa17 Den fulla extraktionen - och Mssa19 finns i samma enda transport.
Vad lucidVIEW gav mig var en dogfooding-loop med tänder... De andra StyloBot-utsläppen, - och serierna, talar om brädan som den dogfoodande ytan.;, att ' är sann på protocollayret. . Men bräden läser data som det detekteringsmotorn producerar jag. IM SK1m i kretsloppet . I+'får jag förlåta en hel del konstiga apparater som ser ut så länge de underliggande mätarna är rätt
lucidVIEW renderar Markdown till en nedströmsreader (me, men läsa innehållet ). Det är samma form som den AI-crawlers användande fallet materia, inte som instrumentation . När utgången är felaktiga, ser man den omedelbartM SK3 Det finns inga abstraktionslayer mellan | " | extraktorn som producerade X | МSK6 | och |" | Jag läser X
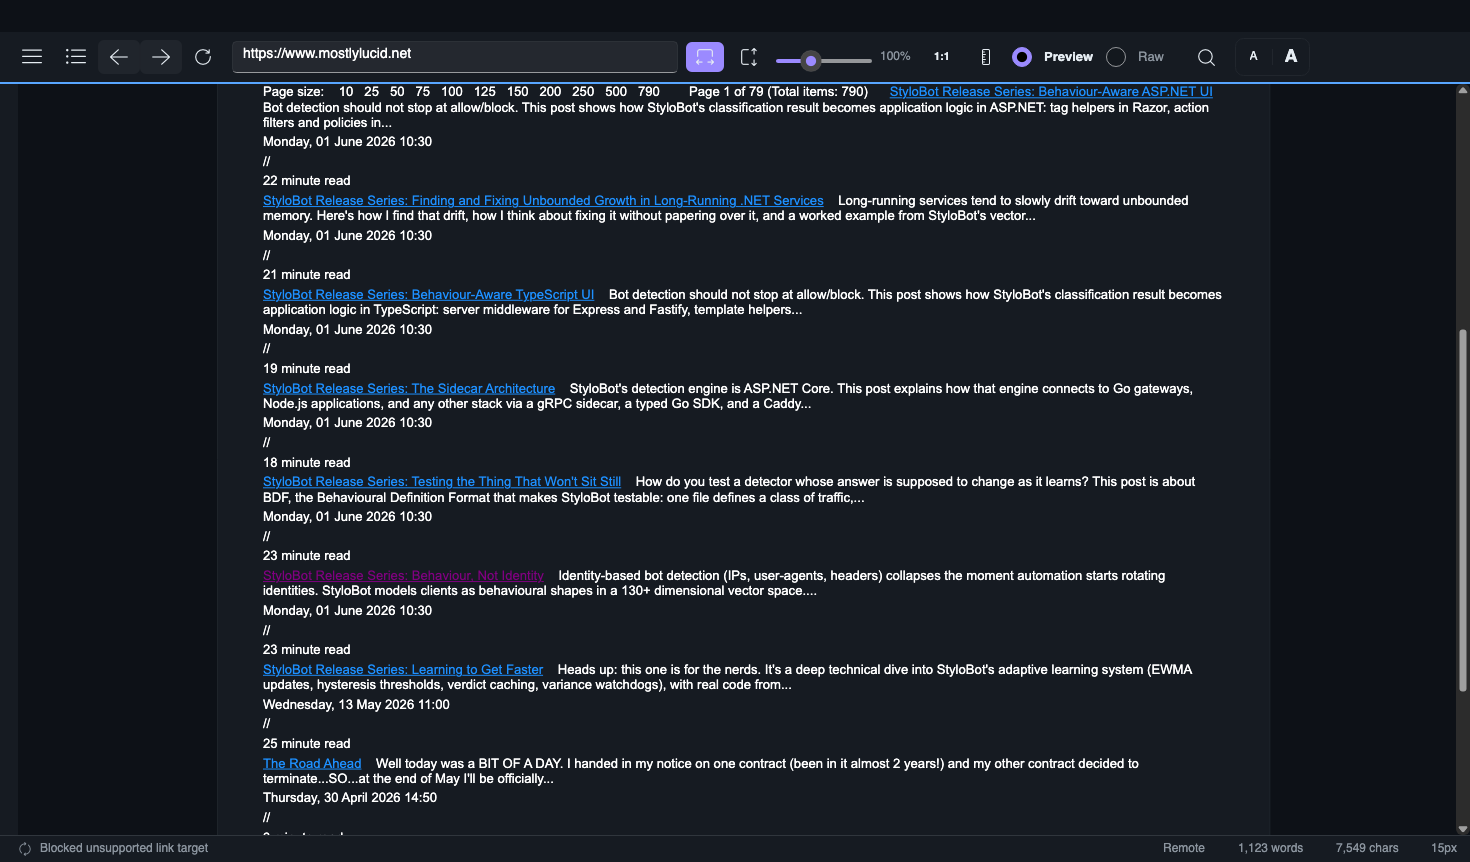
Så jag öppnar lucidVIEW och pekar på min egen bloggindex. [Post title](/blog/post) - den bokstavliga stavra texten - istället för en stilad, klickabar länk
Enheten-test suite är grönt. Befestelsen I 'd skrevs för M SK3anker inuti inräknade HTMLMSC4 passerarMska5 Utgången innehåller raden [Post title](/blog/post). Markdown är ändå fel
Den bugklassen skulle inte ha blivit upptäckt
Blogindexet är byggt med Tailwind. Tail wind-utgången är inräknad för läsbarhet : varje wrapper div sätter två utrymmen längre än dess moder
<section class="...">
    <div class="container...">
        <div class="grid...">
            <div class="card...">
                <a href="/blog/post-a">Post title</a>
                ...
Trädmatten' texten - handledaren, AppendEscapedInline, kollapsar rader av vita utrymme till ett enda utrymmen . Inuti en sändning gör den detta korrekt prevWs flagga som trycker ner ett järjestet vitt utrymme släpper ut. Mellan samtalen , löser flaggan tillbaka. Så när gåaren besöker ett järjestett textM SK3 nodMska4avMske5whitespace syskon | - | vilket är exakt vad inräknade HTML producerar mellan tomma element i linje |- | varje roep släppt ut en kollapsad ledande utrymd på linje ♫ - | start ♫
Fyra förpackningar av indentationen, fyra texter - nod- vita utrymme syskonar , fyra kollapsa utrymmen M SK4 Sammamärkt's inräknat-koden -blockregeln aktiverar fyra utrymmen [Post title](/blog/post) landar på en linje som börjar med fyra spationer. Markdig tolkar hela raden som en kodblock. Klapptext visar texten som bokstavlig
Enhetens test går förbi eftersom testet bekräftar raden [Post title](/blog/post) dyker upp någonstans i utgången.
Bestämningen är två linjer : vid linjen-startM SK2 primär prevWs = true så att först den ledande vita ytan från varje textknoten hoppar bort istället för att skicka ut den. Den ledande blanken ytan inuti inräknade HTML når aldrig utgången . Insidan - stycket kör fortfarande kollapsa till ett enda utrymme
Det intressanta är borde har påstått. Ytan -text .Contains() kontrollerar tecken är närvarande. De var . De stod bara i fel CommonMark blocktyp strukturell AST ger dig det gratis.
- Noll inräknade kodblock om det inte var ett beskyddat block som var källan
- Varje länk i källan HTML överlever som en riktig
LinkInlinei AST - Den fenced-blockräkningen matchar den deklarerade förväntan
För att bevisa att lint hade tänder, Jag vände tillbaka originalfixen och körde lint-skiten . En exakt enda test misslyckades - den som använder fyra apparater
Den där ena checken går nu över varje löparetest i paketet. Framtidens regressioner av samma klass får fångats strukturellt , inte genom att matcha strängar M SK2 Vilket betyder att I' hittar dem i CI istället för i lucidVIEW .
Vad dogfooding egentligen kräver
Det finns en fas i varje produkt där enhetens tester är gröna och demonstrationen fungerar, och operatoren har satt rätt konfigurationsflaggor och du skickar ut en Veröffentlichung och en dag senare öppnar en användare ett problem som säger: "" " - det här fungerar inte - ' - det funkar inte på riktig innehåll - M SK3 - varje produkt träffar detta - . - Den ärliga svaret är att testerna och demonstrationsinhalten är sterila på ett sätt som den riktiga innehållet inte är.
Hundfooding-loop är det billigaste sättet att komma ut ur den här fällan. separat produkt, med separata användare råkar konsumera StyloExtract's utgång som dess produkt yta. Om lucidVIEW visar en bruten markeringM SK1 lucidVIEW ' dess användare klagar på lucidVIEW
Den separationen spelar roll.. Om lucidVIEW var en StyloExtract-testfixering, skulle jag ha skrivit den med sterila innehåll eftersom jag vet vad extraktorn gillar. . Eftersom lucidVIEW finns i sin egen värld, så är det ,, som pekar på min riktiga blogg, ,, som använder Tailwind.
En stor del av v1.7.x-utsläppen spårar tillbaka till den här loopen . Den strukturerade-walker-outputten M SK3vMska4 skickades eftersom lucidVIEWM Ska5s första version var oläslig när StyloExtract emitterade platta paragrafer
Patternet, ', är inte nytt. konsumentprodukter parallellt med infrastrukturprodukt, och konsumera din egen infrastruktur genom konsumenten klass omfattningen vid infrastrukturlagret ökar med allting som konsumenterna inser att du inte tänkte skriva en test för
Avstängda loopar över högen
StyloExtract / lucidVIEW är ett exempel på en mönster som jag kör över varje projekt
flowchart LR
    PB[visible product<br/>behaviour] --> TR[test/review<br/>loop]
    TR --> AP[architectural<br/>primitive]
    AP --> RL[reusable<br/>library]
    RL --> WE[written<br/>explanation]
    WE --> LG[LLM-readable<br/>grammar]
    LG --> NP[next<br/>product]
    NP --> PB
Ett bug täcker ytan i ett produkt. Rättandet blir en strukturell assertion | ( | test | / | review loop | МSK3 | The asseration turns into a primitive that other things can use
Abhängighetsgrafen som detta producerar i alla mina projekt ser ut som
flowchart TB
    LV[lucidVIEW<br/>Avalonia markdown reader]
    SB[StyloBot<br/>detection gateway]
    SF[StyloFlow<br/>policy + flow runtime]
    SE[StyloExtract<br/>HTML → Markdown]
    NA[mostlylucid.Naiad<br/>Mermaid renderer fork]
    DA[mostlylucid.dagre<br/>graph layout]
    EP[mostlylucid.ephemeral<br/>signal + sketch primitives]
    UT[Mostlylucid.Avalonia.UITesting<br/>Avalonia UI test framework]

    SB --> SF
    SB --> SE
    LV --> SE
    LV --> NA
    NA --> DA
    SE --> EP
    SF --> EP
    LV -.tests via.-> UT
Mostlylucid.Avalonia.UITesting är den bit som gör lucidVIEW sidan av kretslet återskapbar. Det är den Avalonia UI-testanpass som lucidVIEW använder för dragning , klick, , scroll, , bildskärmdump,, och skriptuppspelning, M SK5 varje lucidVIEW bildskärmduk i denna artikel fångades av den . med datorsidan automatiserad, MSC7 varje fixa till StyloExtract som lucidView visar kan spelas upp igen och kontrolleras utan att göra något om detMostlylucid.StyloExtract.Playwright är orelaterade till testloopet ; det är JS- den som ger inmattningsfäckern, som är omfattad i sin egen sektion nedanför
Världen är verklig. mostlylucid.ephemeral rinner upp genom StyloExtract och StyloFlow till StyloBot och lucidVIEW. Förenklingen är tid - inboxade releases ( ingen dragning i gränssnittet , versionerna skepper när skalan som de påstår skepper M SK4 och att varje lager har sin egen test-skiva MSC5 fördelen är att jag kan arbeta över alla av dem på en vecka och kostnaden för kontexten
Det betyder också att skrivandet av den här artikeln inte är en sida. StyloExtract har ett strukturellt lint-hellar och ett dokumenterat promenadkontrakt.
Det här fungerar för mig eftersom slutet av kretsar är hur jag tror arbetsflödet troligen inte generaliseras Lokala Markdown-modi den tillverkar do.
Hur lucidVIEW kopplar in den
flowchart LR
    URL[URL bar] --> Fetch[HttpClient GET<br/>Accept: text/markdown, text/html]
    Fetch --> Sniff{Content-Type}
    Sniff -->|text/markdown| Render[LiveMarkdown.Avalonia]
    Sniff -->|text/html| Convert[HtmlToMarkdownService]
    Convert --> Sparse{< 200 chars +<br/>SPA markers?}
    Sparse -->|yes| Stub[Stub: needs JS,<br/>open in browser?]
    Sparse -->|no| Render
    Stub --> Render
Fyra paketreferenser och en tjänst:
public sealed class HtmlToMarkdownService
{
    private readonly IHtmlDomParser _parser = new AngleSharpHtmlDomParser();
    private readonly IDomCleaner _cleaner = new DomCleaner();
    private readonly IBlockSegmenter _segmenter = new BlockSegmenter();
    private readonly IBlockClassifier _classifier =
        HeuristicBlockClassifier.LoadFromEmbeddedResources();
    private readonly IMarkdownRenderer _renderer = new TypedMarkdownRenderer();

    public string Convert(string html, Uri? sourceUri = null)
    {
        var doc = _parser.Parse(html, sourceUri);
        _cleaner.Clean(doc);
        var blocks = _classifier.Classify(_segmenter.Segment(doc));
        return _renderer.Render(blocks, ExtractionProfile.RagFull);
    }
}
Det är "'", it , . . En status- --- -bar- -icon visar vilken väg som körts. ( -direkt MD - -/ - omvandlat. ♫ / -SPA- -stub -M SK6 - så att när något ser fel ut kan användaren peka på högra skivan
Pipelinet, ,, i olika steg
flowchart LR
    HTML[HTML] --> P[AngleSharpHtmlDomParser]
    P --> C[DomCleaner<br/>strip script/style]
    C --> S[BlockSegmenter<br/>candidate subtrees]
    S --> K[HeuristicBlockClassifier<br/>role + score]
    K --> W[DomMarkdownWalker<br/>GFM per block]
    W --> R[TypedMarkdownRenderer<br/>profile gate]
    R --> MD[Markdown]
Parser + renare är Kampsform wrappers. Den intressanta koden börjar vid segmentering
Segmenter. Gå genom kroppen, spola vilken semantisk tag som helst (main/article/section/h1-h6/ul/pre/...) plus något annat <div>/<section> att allt annat är för litet för att vara nöjd.
public IReadOnlyList<IElement> Segment(IDocument document)
{
    if (document.Body is null) return Array.Empty<IElement>();
    var result = new List<IElement>();
    Walk(document.Body, result);
    return result;
}

private static void Walk(IElement element, List<IElement> sink)
{
    if (SemanticTags.Contains(element.TagName))   sink.Add(element);
    else if (IsBlockyDiv(element))                sink.Add(element);
    foreach (var child in element.Children) Walk(child, sink);
}
Klassifier. Punkter varje kandidat, ,, välja icke--, överlappande vinnare, M SK2, märke med BlockRole (MainContent , Heading, NavigationM SK3 KolplattaMST4 upprepade elementM ST5 MST6 Varje vald block får sin DOM gå in i strukturerad MarkdownM st7
foreach (var element in selected)
{
    var role = ClassifyRole(element);
    yield return new ExtractedBlock
    {
        Role     = role,
        Text     = element.TextContent.Trim(),
        Markdown = ShouldRenderMarkdown(role) ? DomMarkdownWalker.Render(element) : "",
        Links    = ExtractLinks(element),
        XPath    = XPathBuilder.For(element),
        // ...
    };
}
Walker. Ett StringBuilder , ett DOM-pass. Den <a> fallet är där v1.7.1 bug levde
case "a":
    var href = el.GetAttribute("href") ?? "";
    if (href.Length == 0) { WriteInlineChildren(dest, el); return; }
    dest.Append('[');
    WriteInlineChildren(dest, el);
    dest.Append("](").Append(href).Append(')');
    return;
( Rättelsen var ' inte här AppendEscapedInline, som matade in ledande whitespace i dest innan det här fallet någonsin gick. [ gör att CommonMark analyserar linjen som en kodblock.)
Renderer. Tor efter profil. RagFull håller artikeln-kontext M SK1Breadcrumb, förknippade länkarMSC3 och droppar krom (FooterMST5 HeaderM ST6 CookieBannerM st7 NavMst8 MainContentOnly håller bara kroppen. AgentNavigation håller bara nav (for crawl-link discoveryM SK2
return p switch
{
    ExtractionProfile.RagFull => b.Role is not (BlockRole.Footer or BlockRole.Header
        or BlockRole.Advertisement or BlockRole.CookieBanner or BlockRole.Boilerplate
        or BlockRole.Unknown or BlockRole.PrimaryNavigation or BlockRole.SecondaryNavigation),
    ExtractionProfile.MainContentOnly => b.Role is BlockRole.MainContent or BlockRole.Article
        or BlockRole.Heading or BlockRole.Summary or BlockRole.Table or BlockRole.CodeBlock
        or BlockRole.RepeatedItem,
    ExtractionProfile.AgentNavigation => b.Role is BlockRole.PrimaryNavigation
        or BlockRole.SecondaryNavigation or BlockRole.Breadcrumb or BlockRole.Form,
    _ => true
};
Spelare för JS-överlämnade sidor
StyloExtract's heuristik fungerar på den statiska HTML som servern gav tillbaka. Det där ' det där är okej för SSR-sidorna | ( Wikipedia |, | GitHub | МSK5 | de flesta nyhetsartikeln URLs ♫ ). | Det bryts på SPA skalor där det synliga innehållet är hydraterad klient ♪ - ♪ utanför en JSON-blob ♪ __NEXT_DATA__, __NUXT__, __APOLLO_STATE__. Den statiska HTML finns med meta-tag + en skelett , och det finns ingen kropp som klassifieren kan hitta
Mostlylucid.StyloExtract.Playwright plugg i uppström av verket. Det implementerar IRenderedHtmlFetcher, driver en huvudlös Chromium via Dramatiker, väntar på hydrationen , och skickar tillbaka posten-JS HTML till resten av extraktornM SK3
public async Task<RenderedHtmlResult> FetchAsync(
    Uri uri, RenderOptions? options = null, CancellationToken cancellationToken = default)
{
    var page = await _context.NewPageAsync();
    await page.GotoAsync(uri.ToString(), new PageGotoOptions
    {
        WaitUntil = WaitUntilState.NetworkIdle,
        Timeout = options?.NavigationTimeoutMs ?? 15000,
    });
    var html = await page.ContentAsync();
    await page.CloseAsync();
    return new RenderedHtmlResult { Html = html, FinalUrl = page.Url };
}
Samma parser, ,, renare, ,, segmenter, M SK2, klassificerer,,, walker, ,, renderer nedströms, MSC5. Den enda skillnaden är att ingången till HTML nu innehåller den hydraterade DOM som JS producerade,
flowchart LR
    URL[URL] --> Choice{Render mode}
    Choice -->|static| HTTP[HttpClient]
    Choice -->|js-required| PW[PlaywrightHtmlFetcher<br/>headless Chromium]
    HTTP --> Pipeline[parse → clean → segment<br/>→ classify → walk → render]
    PW --> Pipeline
    Pipeline --> MD[Markdown]
Det här är det rätta svaret när en operatör driver StyloExtract server-sidan och en huvudlös webblader är en rimlig beroende . CLI skickar två binärsystem för exakt den här splittningen stylo-extract (, AOT, ,, ~12, MB, ,, statisk, M SK4, endast ) och stylo-extract-playwright (~120MB en gång Playwright 's webblapp landar, J.S.
lucidVIEW använder den inte. lucidVIEW är en markerdown-reader ; dess identitet är " inget kromium , ingen webblader-motor M SK3 inget | 200 MB av beroenden av en egenskap MSC5 Bundling Playwright skulle placera en huvudlös webbladare inuti en app vars topp är att det inte finns någon i den.
Andra saker som dogfooding visar sig
Fyra icke-- bugs som formade lucidVIEW
Specen som drev v1.7.0. Den första uppbyggnaden av utsläppta platta paragrafer (
element.TextContent.Trim()per block). Wikipedia var oläsbar , bloggare kort förlorade varje ankerdocs/styloextract-markdown-spec.mdräkna ut vad som saknade: skriftsnivåer , inline-runnningar, listorM SK3 GFM-tabellarMska4 blockbilderMske5 med fyra återskapare URLsMsek6 Den strukturerade Mska7 gåva funktionen i vM Ska8 implementerar den specifikaSpasidor.
bbc.com/newsär Next.jsM SK1 statiskt HTML är metatag + a__NEXT_DATA__JSON-blöd hydraterad av JS. StyloExtract återvänder korrekt | ~1 | grej eftersom det inte finns någon kropp |' | . | lucidVIEW nu luktar på kända rammarkörer__NEXT_DATA__,__NUXT__,__APOLLO_STATE__,data-reactroot,ng-version=,__REMIX_DATA__) ochM SK1 på sparse utgång + markering " Den här sidan använder { konstruktionen M SK2 lucidVIEW funkar inte JavaScript . öppna i webblader MSC4 BBC's artikel URLs (/news/articles/<id>) tjänar riktiga<main>och konvertera rent. Homepage / artikelasymmetry, inte en omvandlares misslyckandeM SK3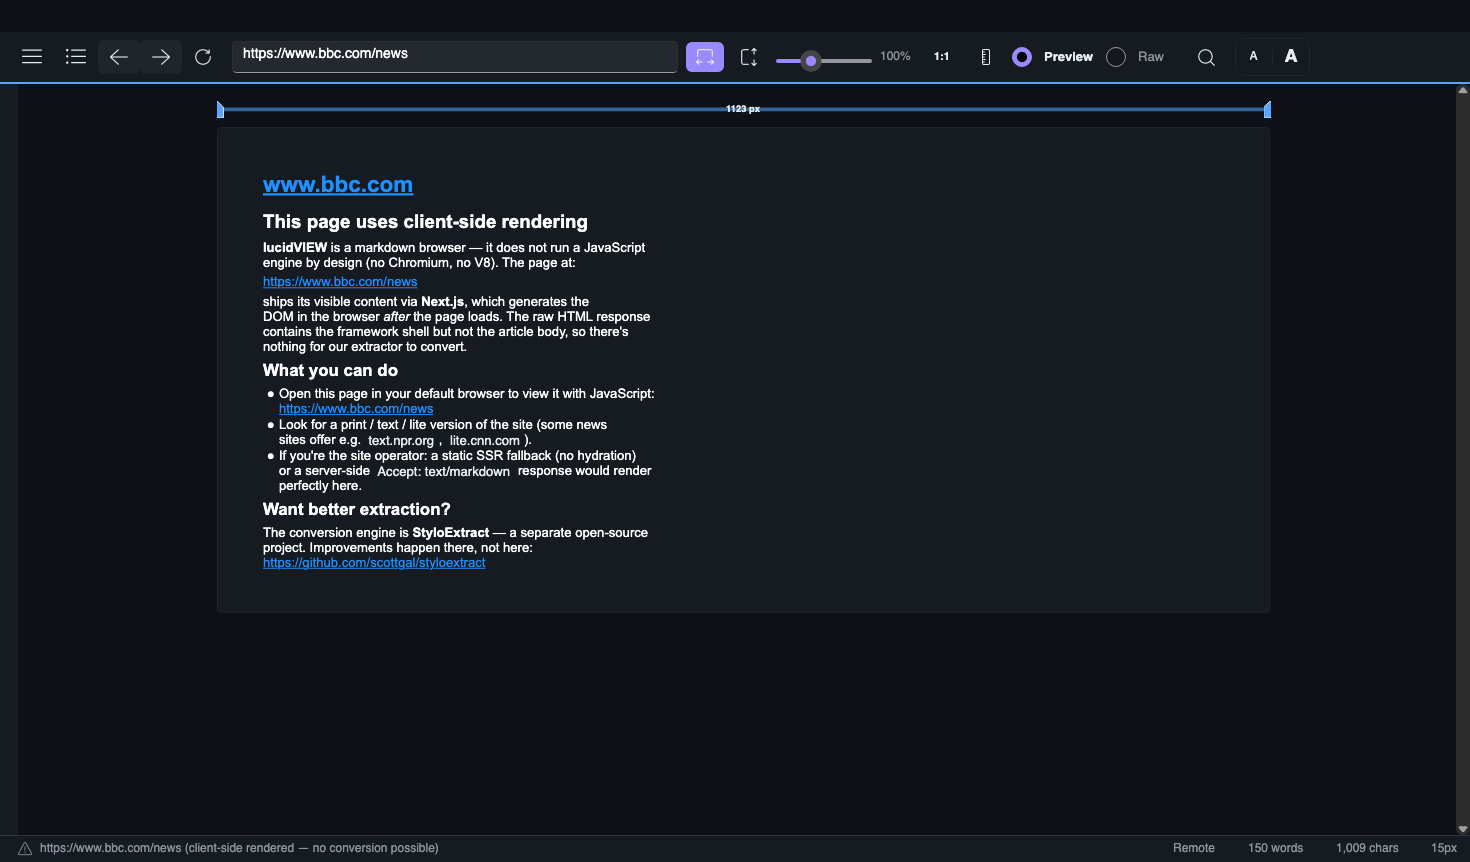
Semantik- fria sidor.
example.comhar inget<main>, nej<article>. Helistiken ger inte rätt något tillbaka . Samma punktflöde fångar detKorrekta-men-dödlösa utsläppM SK2 My blog's kategorifilter är
<select><option>. Gåraren hittar inget<a href>, släpper ut valtekstin som en punkt "Allt | . | NET | (41) | МSK3 | s |(1) | AKP | m(1) | AI | M(69)..." Correct (options are't linksM SK2 but visually awful . A future walker pass could detect<select>och skicka ut en definitionslista eller[42 categories]sammanfattning.
Plus en skyddsrail som kom ut ur att motstå den uppenbara genvägen. När extraktionen är sparsam är frestelsen " att falla tillbaka till Jina Reader | / | r | . |jina | МSK4 | ai |/ | Trafilatura | ." | lucidVIEW gör det inte ♫ ' | t | . ♫ Att spåra användar-URL: s genom en tredje person ♫ - | parters läsare gör läsaren till en hemlighetsdröjning ♪ ; | varje URL som användaren besöker flödar genom någon annan leverantör ♪ <meta> / og: tag, sedan M SK1öppna i webbläsaren ?" Varje steg matas StyloExtrakt en annan fetch från samma ursprung
Det godtyckliga "-" -decken på plats
Vad dogfood-loopet är bra på att hitta är bristande resultat på bra.
Jag har en rökare nu som tar fram ett dussin verkliga - World sites och dumper ut extraktorn ' utgången . På den strukturellt kooperativa halvan - nyheter | ( BBC | , | Guardian | МSK7 | Wikipedia |, | GitHub repo READMEs | , | Ghost | . | org |' | changelog , | Hacker News | MMk13 | the heuristic classifier finds the main content cleanly and the walker produces readable Markdown ♫ . ♫ Tio till trettio kilobyte ren prosa per sida ♫
På den andra halvan - Allbirds ingenting. Noll MainContent blocks . Varje kandidat blir demonterad till boilerplate eftersom sidan inte använder <main> eller <article> och klassernas namn matchar inga av mönsterna i ramverket.
Att lägga till fler element i den JSON-fiilen är den uppenbara rörelsen.
Den verkliga lösningen är en tränad modell. Per, -elements egenskaper (tag identitet, , klass, M SK4 namnstambuckets, Mska5 text, M Ska6 längd, Msaka7 länk, M ska8 täthet, MSKA9 syskonform, Mcka10, förfädernas närvaro, Mkka11, till ett litet gradient, Mikka12, trängt klassificering, Mka13, tränade på WCXB märkt corpus, exporterad till NX, ropade från .NET via Microsoft.ML.OnnxRuntime. En ♫ 45- ♫ egenskapsvektor per kandidat ♫ ♫, ♫
Designen för detta är skriven i StyloExtract repo (docs/ml-classifier-v2-design.md). Implementationen är inte gjord, ' inte gjort, . Saken som det är blockerat på är inte ' inte ingenjörskonst, M SK5, det är ' som operatörens fråga om att skicka en 25 MB ONNX Runtime native binary in i porten, MSC9 dess utplacering, MST10, eller att behålla ML som ett separat optionellt paket som operatörern väljer att använda. MST11. Det optionella svaret på MST12 är det rätta för ett FOSS-paket ekosystem, MTS13 men det betyder att modellen inte är standardmässigt gjord. MTS15, vilket betyder att de flesta operatörerna kommer att vinna, MNT16, inte få det, MITT17, vilket innebär att hursomhelst hanurismen bär den största delen av produktionslasten.
I det mellanspelet, ,, får operatörerna handmatig escape hatch() : operator (operatör) - autorerad YAML-templates , en file per host , analyserad AOT - ren , varm - överrider induktionskedjan för den hosten weird-shopify-tenant.com producerar tomma markering, ,, skriver ett femtal YAML-Datei med linjer - som säger """ för den här värdena. .product-description-body", kastar in den config/templates/, och starttid plockar upp det via FileSystemWatcher inom några sekunder . CLI har template add/list/show/remove/test. REST-ytan har GET/PUT/DELETE/POST för samma sak. Den automatiserade säkerhetskontrollen fångade bana traversal och SSRF i REST slutpunkterna under PR-kontrollen och de blev fixade ; den regressiva suiten för båda liv i testprojektet nu
Operatörstemplate är golvet, ., ML-modellen är taket,., det faktum att det finns ett mellanrum mellan ' och - är uppriktigt. Heuristiskt sett är lasten, -, som bär väggen idag, M SK5, och det kommer att stanna med lasten tills modellen är tränad och jämförd med WCXB-skivan.
Del 2 av den här serien är ML-byggnaden -out | . Heuristisk + per-host-templates hanterar brunnen -beteended lång svans och operatören M SK3 fläckiga kanter ; den tränade klassifieren hanterar den verkligt stökiga HTML <main>, nej <article>, ingen konsekvent klass, - namnsignal, , och ingen uppenbar plats för en heuristik att fästa på, ., v, M SK4, är svaret på: ♫ ", vad sägs om sidorna som inte följer någon struktur alls? ♫
Var den lastar
StyloExtract finns på NuGet som en uppsättning av förknippade paket. stylo-extract (AOT stylo-extract-playwright (med huvudlösa apparater -browser fallback för JS
StyloBots integreringsskepp är Mostlylucid.BotDetection.StyloExtract. Att lägga till den på en portaal är två linjer av Program.cs och en regel i appsettings.json:
{
  "BotDetection": {
    "DetectionPolicies": {
      "Rules": [
        {
          "Name": "ai-bot-docs-markdown",
          "Path": "/docs/*",
          "Types": ["AiBot"],
          "Confidence": ">= 0.85",
          "Action": "extract-markdown"
        }
      ]
    }
  },
  "StyloExtract": {
    "Actions": {
      "extract-markdown": {
        "Profile": "RagFull",
        "Cache": {
          "Mode": "Override",
          "MaxAge": 3600,
          "VaryByBotType": true
        }
      }
    }
  }
}
Vad detta säger: : , varje fråga som detektorn klassificerar som AI Bot , ", ," med tillförtroende att 0.85, , "hittar en bana under /docs/*, får sin responskropp omvandlat från HTML till Markdown av StyloExtract innan den är återförd . Samma portaal fortsätter att servera HTML till alla andra begäran . Det är värt att vara uppenbart här och de snubbiga som inte Behavior, Inte Identitet för hur.). Båda smakerna får samma svar. : en lätt Markdown-version istället för full HTML.
Det är "'", den lokala markerdown-metoden, . Den är inte beroende av Cloudflare och . Den kostar inte per applikation. . Den kör på samma portbox som du redan har,. Klassifieren är StyloBot, . Extraktoren är StiloExtract, M SK8 Hela grejen passar in i en AOT-version, docker run och lämna kvar
Vad är egentligen nytt här?
Vad Cloudflare skepper är är en samling : klassifieren | ( | Deras är egendomlig ♫ ), | utvinningskraften ♫( | antagligen en fork från Trafilatura eller liknande ♫
Samma förmågan, ,, som bryts ner för ett själv,-, som är ett styrt portal,,, är fyra separata saker som utgör
- En klassifier som kör lokalt och bestämmer " det här är en AI-kralare ." StyloBot
- En extraktor som kör lokalt och konverterar HTML till läsbar Markdown
- En regel, -, är en utvärderingsplatta som kartlägger bedömningarna till handlingar
DetectionPolicyMiddlewarei StyloBot 7.x. - substratet de alla kör på. Vad som helst i din YARP-grindslåda är på .
Cloudflare äger alla fyra.
Anledningen till att denna artikel existerar är att den andra och tredje delen av den nedbrytningen, -, extraktorn och regelsidan, -, inte hade en konsekvent lokal historia när jag började, M SK3, de gör det nu, MSC4, gåvan är vad som gjorde utgången faktiskt användbar. ., Hundfood-loopet med lucidVIEW, är det som gjorde gåvan faktiskt korrekt.
Del 2 täcker ML-klassifieret för den stökiga maskinen
StyloExtract källa: github.com/scottgal/styloextract. StyloBot integreringspaketet finns i stylobot-repo som Mostlylucid.BotDetection.StyloExtract. lucidVIEW källa: github.com/scottgal/lucidview. CommonMark-outputn-kvalitetslinthelparen som stängde vM SK2 bugloop är i tests/StyloExtract.Heuristics.Tests/MarkdownOutputLint.cs.