


delar 1-3 beskriven begränsad oförklarhet som ett abstraktt mönster. Detta artikel applicerar dessa mönste på en arbetsbildanalys som demonstrerar principerna i praktiken
NOTET: Ändå tända systemet. Men det finns nu en version för ', som även CLIs version. It works PRETTY well but some edges to smooth out
Detta artikel tjänar flera syften. Navigera till vad du är intresserad av
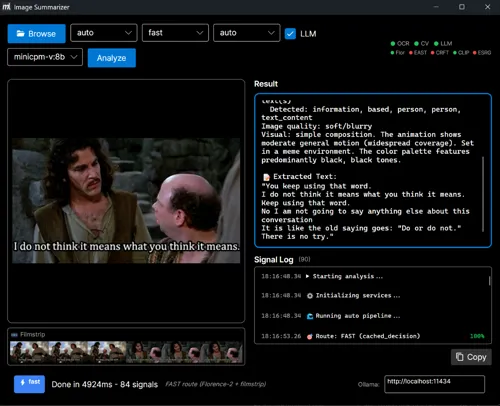
ImageSummarizer är en RAG-inspegningskanal för bilder som extraherar strukturerade metadata, ,, text, ,, captioner och visuella signaler med hjälp av architecture based wave-. Systemet skalar upp från snabb lokal analys (Florence-2 ONNXM SK3 till Vision LLMs endast när det behövs .
Nyckelprinciper
ImageSummarizer visar att multimodella LLM kan användas utan att ge upp determinism. sannolikhet föreslår , determinism förblir.
Designregler
- Modeller konsumerar aldrig andra modeller
- Naturspråk är aldrig ett tillstånd
- Escalation är deterministiska trösklar
- Varje utgång bär på förtroende + provenance


Pipelinen extraherar strukturerade metadata från bilder för RAG-system.
Det viktigaste ordet är strukturerad. Varje utgång har tillförlitlighetsvärdena , källans antagning, , och bevispunkter,. Ingen modell är den enda källan till sanning,
Deep Dive: Pipelinet för OCR är tillräckligt komplex för att äga en egen artikel Del 4.1: De tre-Tier OCR Pipeline för den kompletta tekniska uppsättningen inklusive EAST, CRAFTM SK1 Real-ESRGANMska3 CLIPMske4 och optimering av filmsträngarnaM Ska5
Systemet använder en escalationsstrategi på tre nivåer för textextraktion.
| Niveau | Methode | Tempo | kostnaderna | МSK4 | bäst för | |||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Tesseract | ~50ms | Gratis | Rent | МSK4 | högt | - | motstridiga text | ||||
| 2 | Florence-2 ONNX | ~200ms | Gratis | МSK3 | Stiliserade fonter | , | inga API-kostnader | |||||
| 3 | Vision LLM | ~1-5s | $0.001-0.01 | komplext |
Detektorn för text (Öst, KRATT, ~20-30msM SK2 bestämmer den optimala vägen
Resultat: ~1.16GB av lokala ONNX-modeller som hanterar 85%+ av bilder utan API-kostnader

$ imagesummarizer demo-images/cat_wag.gif --pipeline caption --output text
Caption: A cat is sitting on a white couch.
Scene: indoor
Motion: MODERATE object_motion motion (partial coverage)
Rörningsfraser släpps ut endast när de stödjers av optiska flöde mätningar och ramdeltas.; annars faller systemet tillbaka till neutrala beskrivare.

$ imagesummarizer demo-images/anchorman-not-even-mad.gif --pipeline caption --output text
"I'm not even mad."
"That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion (localized coverage)
Den undertiteln-medveten ramduplikering detekterar textförändringar i botten 25% av bilderna , viktande ljusa pixels | ( | vit | МSK4 | gul text |) | mer kraftigt |
För animerade GIFs med subtitler, skapar redskapet horisontella ramsträngar för Vision LLM-analysen . Tre moder fokuserar på olika användningsområden:
Text-Omnär Strep (NEW
Den mest effektiva metoden extraherar bara textbubblade lådor, dramatiskt minskar tokenskostnader:

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode text-only
Detecting subtitle regions (bottom 30%)...
  Found 2 unique text segments
Saved text-only strip to: anchorman-not-even-mad_textonly_strip.png
  Dimensions: 253×105 (83% token reduction)
| tillvägagångspunkt | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Hela tallrikar (10) | ||||||||||||
| OCR-stripp | (2 | frammänder | ) | m | M600×185 | M | m~300 | мSK7 | mellan | |||
| Text- endast fläck | 253×105 | ~50 | låg |
Hur det fungerar: OpenCV detekterar subtitrets områden | ( | botten |30%), | tröskeln ljusa pixeler | МSK3 | vit | / | gul text |), | extraherar smala bångboxar | , | och duplicerar baserat på textförändringar ♫ . | Vision LLM får bara textregionen ♫ , | bevarar all subtitretts innehåll medan den eliminerar bakgrundspixeln ♫.
OCR-läger (tydliga ändringar i texten | | - | МSK2 | rader reducerade till |

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode ocr
Deduplicating 93 frames (OCR mode - text changes only)...
  Reduced to 2 unique text frames
Saved ocr strip to: anchorman-not-even-mad_ocr_strip.png
  Dimensions: 600x185 (2 frames)
Motion Mode-stripp (keyframes för rörelsesuppfattningar

$ imagesummarizer export-strip demo-images/cat_wag.gif --mode motion --max-frames 6
Extracting 6 keyframes from 9 frames (motion mode)...
  Extracted 6 keyframes for motion inference
Saved motion strip to: cat_wag_motion_strip.png
  Dimensions: 3000x280 (6 frames)
Detta låter Vision LLMs läsa alla undertitel i en enda API sändning.
Det slår " bara att döma upp det med en gränsmodell " av samma anledning som ett X-ray slår på berättelsen : modellen blir aldrig tillfrågad att fylla på luckor M SK4 Den får en stängd ledger, -, mätda färger, ,, spårade rörelser,,, avvikta subtitret frammarmor, MSC8, OCR-förtroende, M SK9 och bara återskapa det som substratet redan innehåller, MSL10, när GPT, MLS11, dömer upp en bild, Msl12, det, MKL13, gissningen, MCL14, när ImageSummarizer gör, MNL15, det och MKL16, sammanfattande signaler som redan finns, MHL17.
Systemet använder våg---baserad bränsleledning där varje våg är en oberoende analysator som producerar utskrivna signaler vågor sätter igång i prioritära ordning. ( lägre talet kör först., och senare vågor kan läsa signaler från tidigare
Tilrättelse: Plötsligt ♫ ♫ 10 rinner innan plötslig ♫
flowchart TB
    subgraph Wave10["Wave 10: Foundational Signals"]
        W1[IdentityWave - Format, dimensions]
        W2[ColorWave - Palette, saturation]
    end

    subgraph Wave40["Wave 40: Text Detection"]
        W9[TextLikelinessWave - OpenCV EAST/CRAFT]
    end

    subgraph Wave50["Wave 50: Traditional OCR"]
        W3[OcrWave - Tesseract]
    end

    subgraph Wave51["Wave 51: ML OCR"]
        W8[MlOcrWave - Florence-2 ONNX]
    end

    subgraph Wave55["Wave 55: ML Captioning"]
        W10[Florence2Wave - Local captions]
    end

    subgraph Wave58["Wave 58: Quality Gate"]
        W5[OcrQualityWave - Escalation decision]
    end

    subgraph Wave70["Wave 70: Embeddings"]
        W7[ClipEmbeddingWave - Semantic vectors]
    end

    subgraph Wave80["Wave 80: Vision LLM"]
        W6[VisionLlmWave - Cloud fallback]
    end

    Wave10 --> Wave40 --> Wave50 --> Wave51 --> Wave55 --> Wave58 --> Wave70 --> Wave80

    style Wave10 stroke:#22c55e,stroke-width:2px
    style Wave40 stroke:#06b6d4,stroke-width:2px
    style Wave50 stroke:#f59e0b,stroke-width:2px
    style Wave51 stroke:#8b5cf6,stroke-width:2px
    style Wave55 stroke:#8b5cf6,stroke-width:2px
    style Wave58 stroke:#ef4444,stroke-width:2px
    style Wave70 stroke:#3b82f6,stroke-width:2px
    style Wave80 stroke:#8b5cf6,stroke-width:2px
Prioriterad ordning ( lägre löper först): 10 ♫ ♫ → ♫
Det här är Begränsad Fuzzy MoM tillämpat på bildanalys: flera proposer publicerar till ett gemensamt substrat (the AnalysisContext), och den slutgiltiga utgången aggregerar sina signaler
Beteckning om vågsortering: De tre OCR: n våningar (Tesseract /Florence-2/Vision LLMM SK3 är de konceptuella nivåerna för eskalationenMSC4 Individuella vågor som Advanced OCR eller Quality Gate är raffineringar within those tiers , not separate escalation levels—they perform temporal stabilization and quality checks
Varje våg producerar signaler med hjälp av en standardiserad kontrakt
public record Signal
{
    public required string Key { get; init; }      // "color.dominant", "ocr.quality.is_garbled"
    public object? Value { get; init; }             // The measured value
    public double Confidence { get; init; } = 1.0;  // 0.0-1.0 reliability score
    public required string Source { get; init; }    // "ColorWave", "VisionLlmWave"
    public DateTime Timestamp { get; init; }        // When produced
    public List<string>? Tags { get; init; }        // "visual", "ocr", "quality"
    public Dictionary<string, object>? Metadata { get; init; }  // Additional context
}
Detta är den delen 2 Signalkontraktet i praktiken .vågor pratar inte med varandra genom naturlig språk . De publicerar utskrivna signaler till den de delar med sig av i sammanhanget M SK3 och nedströmsvågor kan ställa frågor om dessa signaler
Kom ihåg att Confidence är per-signalM SK1 inte per -welle. En enda våg kan skicka ut flera signaler med olika epistemiska styrkorMska4färgvågenMske5 dess dominerande färglista har självförtroendet M Ska6 | | Mska7 beräknat Mska8 men individuella färgprocent använder självför troendet som en viktfaktor för nedåtgående sammanfattning
Tillit här betyder tillförlitlighet för nedströmsanvändning, inte matematisk säkerhet . Deterministiska signaler är återskapbara , inte felaktiga M SK3 spelttonning MSC4 kontroll kan vara deterministiskt fel på korrekta namn
Bestämning om determinism:, ", Deterministiskt, M SK2, betyder att det inte finns någon slumpmässig sampling och stabila resultat för en given lopptid och konfiguration.
För att undvika förvirringar
| Signal nyckeln | källan ♫ ♫ | ♫ Beskrywing ♫ | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|
ocr.text |
Tesseract (Tier 1) | råddig enkel M-frame OCR MMA5 | ||||||||
ocr.confidence |
Tesseract | |||||||||
ocr.ml.text |
FlorenceM SK1 (Tier ♫ ♫ 2) ♫ | |||||||||
ocr.ml.multiframe_text |
Florensen -2 (Tier | 2) | Multi | МSK5 | frambild GIF OCR | föredrars för animationer | ||||
ocr.ml.confidence |
Florenz1 | Florence3 självförtroende siffra | ||||||||
ocr.quality.spell_check_score |
OcrQualityWave | |||||||||
ocr.quality.is_garbled |
OcrQualityWave | |||||||||
ocr.vision.text |
VisionLlmWave | |||||||||
caption.text |
VisionLlmWave |
En viktig skillnad: ocr.vision.text är extraktion av text (OCRM SK1 medan caption.text är scenbeschreibung (captioning). Båda kan komma från samma Vision LLM sändning, men till olika syften.
Den slutgiltiga textselektionens prioritet (höjsta till lägsta
ocr.vision.text (Vision LLM OCRocr.ml.multiframe_text (Florensocr.ml.text (Florenceocr.text (Tesseract)Varje våg implementerar en enkel gränssnitt
public interface IAnalysisWave
{
    string Name { get; }
    int Priority { get; }           // Lower number = runs earlier (10 before 50 before 80)
    IReadOnlyList<string> Tags { get; }

    Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,    // Shared substrate with earlier signals
        CancellationToken ct);
}
Den AnalysisContext är konsensussutrymme från en del 2.vågor kan
context.GetValue<bool>("ocr.quality.is_garbled")context.GetCached<Image<Rgba32>>("ocr.frames")ColorWave kör först (prioriteet 10) och räknar fakta som begränsar allt annat
public class ColorWave : IAnalysisWave
{
    public string Name => "ColorWave";
    public int Priority => 10;  // Runs first (lowest priority number)
    public IReadOnlyList<string> Tags => new[] { "visual", "color" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        using var image = await LoadImageAsync(imagePath, ct);

        // Extract dominant colors (computed, not guessed)
        var dominantColors = _colorAnalyzer.ExtractDominantColors(image);
        signals.Add(new Signal
        {
            Key = "color.dominant_colors",
            Value = dominantColors,
            Confidence = 1.0,  // Reproducible measurement
            Source = Name,
            Tags = new List<string> { "color" }
        });

        // Individual colors for easy access
        for (int i = 0; i < Math.Min(5, dominantColors.Count); i++)
        {
            var color = dominantColors[i];
            signals.Add(new Signal
            {
                Key = $"color.dominant_{i + 1}",
                Value = color.Hex,
                Confidence = color.Percentage / 100.0,
                Source = Name,
                Metadata = new Dictionary<string, object>
                {
                    ["name"] = color.Name,
                    ["percentage"] = color.Percentage
                }
            });
        }

        // Cache the image for other waves (no need to reload)
        context.SetCached("image", image.CloneAs<Rgba32>());

        return signals;
    }
}
Vision LLM får senare dessa färger som begränsningar. Den borde inte hävda att bilden har ♫ " ♫ kraftfulla röda ♫" ♫ om ColorWave räknat ut att den dominerande färgen är blå ♫
Det här är Begränsad otydighet strålar. OcrQualityWave är konstrainer som bestämmer om man ska skala upp till dyr Vision LLM:
public class OcrQualityWave : IAnalysisWave
{
    public string Name => "OcrQualityWave";
    public int Priority => 58;  // Runs after OCR waves
    public IReadOnlyList<string> Tags => new[] { "content", "ocr", "quality" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        // Get OCR text from earlier waves (canonical taxonomy)
        string? ocrText =
            context.GetValue<string>("ocr.ml.multiframe_text") ??  // Florence-2 GIF
            context.GetValue<string>("ocr.ml.text") ??             // Florence-2 single
            context.GetValue<string>("ocr.text");                  // Tesseract

        if (string.IsNullOrWhiteSpace(ocrText))
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.no_text",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Tier 1: Spell check (deterministic, no LLM)
        var spellResult = _spellChecker.CheckTextQuality(ocrText);

        signals.Add(new Signal
        {
            Key = "ocr.quality.spell_check_score",
            Value = spellResult.CorrectWordsRatio,
            Confidence = 1.0,
            Source = Name,
            Metadata = new Dictionary<string, object>
            {
                ["total_words"] = spellResult.TotalWords,
                ["correct_words"] = spellResult.CorrectWords
            }
        });

        signals.Add(new Signal
        {
            Key = "ocr.quality.is_garbled",
            Value = spellResult.IsGarbled,  // < 50% correct words
            Confidence = 1.0,
            Source = Name
        });

        // This signal triggers Vision LLM escalation
        if (spellResult.IsGarbled)
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.correction_needed",
                Value = true,
                Confidence = 1.0,
                Source = Name,
                Tags = new List<string> { "action_required" },
                Metadata = new Dictionary<string, object>
                {
                    ["quality_score"] = spellResult.CorrectWordsRatio,
                    ["correction_method"] = "llm_sentinel"
                }
            });

            // Cache for Vision LLM to access
            context.SetCached("ocr.garbled_text", ocrText);
        }

        return signals;
    }
}
Beslutet om escalation är deterministisk: om stavningskontrollsvärdet ♫ < ♫ ♫50%, ♫ avger en signal som utlöser syn LLM ♫

$ imagesummarizer demo-images/arse_biscuits.gif --pipeline caption --output text
OCR: "ARSE BISCUITS"
Caption: An elderly man dressed as bishop with text reading "arse biscuits"
Scene: meme
OCR fick texten
Vision LLM-vågen sätter igång endast när tidigare signaler visar att den är möjlig.
public class VisionLlmWave : IAnalysisWave
{
    public string Name => "VisionLlmWave";
    public int Priority => 50;  // Runs after quality assessment
    public IReadOnlyList<string> Tags => new[] { "content", "vision", "llm" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        if (!Config.EnableVisionLlm)
        {
            signals.Add(new Signal
            {
                Key = "vision.llm.disabled",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Check if OCR was unreliable (garbled text)
        var ocrGarbled = context.GetValue<bool>("ocr.quality.is_garbled");
        var textLikeliness = context.GetValue<double>("content.text_likeliness");
        var ocrConfidence = context.GetValue<double>("ocr.ml.confidence",
            context.GetValue<double>("ocr.confidence"));

        // Only escalate when: OCR failed OR (text likely but low OCR confidence)
        // Models never decide paths; deterministic signals do (no autonomy)
        bool shouldEscalate = ocrGarbled ||
                              (textLikeliness > 0.7 && ocrConfidence < 0.5);

        if (shouldEscalate)
        {
            var llmText = await ExtractTextAsync(imagePath, ct);

            if (!string.IsNullOrEmpty(llmText))
            {
                // Emit OCR signal (Vision LLM tier)
                signals.Add(new Signal
                {
                    Key = "ocr.vision.text",  // Vision LLM OCR extraction
                    Value = llmText,
                    Confidence = 0.95,  // High but not 1.0 - still probabilistic
                    Source = Name,
                    Tags = new List<string> { "ocr", "vision", "llm" },
                    Metadata = new Dictionary<string, object>
                    {
                        ["ocr_was_garbled"] = ocrGarbled,
                        ["escalation_reason"] = ocrGarbled ? "quality_gate_failed" : "low_confidence_high_likeliness",
                        ["text_likeliness"] = textLikeliness,
                        ["prior_ocr_confidence"] = ocrConfidence
                    }
                });

                // Optionally emit caption (separate signal)
                var llmCaption = await GenerateCaptionAsync(imagePath, ct);
                if (!string.IsNullOrEmpty(llmCaption))
                {
                    signals.Add(new Signal
                    {
                        Key = "caption.text",  // Descriptive caption (not OCR)
                        Value = llmCaption,
                        Confidence = 0.90,
                        Source = Name,
                        Tags = new List<string> { "caption", "description" }
                    });
                }
            }
        }

        return signals;
    }
}
Den viktigaste insikten Vision LLM text har förtroende 0.95, inte 1.0. Det är bättre än förruttnade OCR, men det är fortfarande sannolikhetsmässigt, .. Den nedgående aggregationen vet detta. att ha en värde som är't 1.0.)
Den ImageLedger samlar in signaler i strukturerade sektioner för nedströmsförbrukning Kontext dragning tillämpat på bildanalys:
public class ImageLedger
{
    public ImageIdentity Identity { get; set; } = new();
    public ColorLedger Colors { get; set; } = new();
    public TextLedger Text { get; set; } = new();
    public MotionLedger? Motion { get; set; }
    public QualityLedger Quality { get; set; } = new();
    public VisionLedger Vision { get; set; } = new();

    public static ImageLedger FromProfile(DynamicImageProfile profile)
    {
        var ledger = new ImageLedger();

        // Text: Priority order - corrected > voting > temporal > raw
        ledger.Text = new TextLedger
        {
            ExtractedText =
                profile.GetValue<string>("ocr.final.corrected_text") ??  // Tier 2/3 corrections
                profile.GetValue<string>("ocr.voting.consensus_text") ?? // Temporal voting
                profile.GetValue<string>("ocr.full_text") ??             // Raw OCR
                string.Empty,
            Confidence = profile.GetValue<double>("ocr.voting.confidence"),
            SpellCheckScore = profile.GetValue<double>("ocr.quality.spell_check_score"),
            IsGarbled = profile.GetValue<bool>("ocr.quality.is_garbled")
        };

        // Colors: Computed facts, not guessed
        ledger.Colors = new ColorLedger
        {
            DominantColors = profile.GetValue<List<DominantColor>>("color.dominant_colors") ?? new(),
            IsGrayscale = profile.GetValue<bool>("color.is_grayscale"),
            MeanSaturation = profile.GetValue<double>("color.mean_saturation")
        };

        return ledger;
    }

    public string ToLlmSummary()
    {
        var parts = new List<string>();

        parts.Add($"Format: {Identity.Format}, {Identity.Width}x{Identity.Height}");

        if (Colors.DominantColors.Count > 0)
        {
            var colorList = string.Join(", ",
                Colors.DominantColors.Take(5).Select(c => $"{c.Name}({c.Percentage:F0}%)"));
            parts.Add($"Colors: {colorList}");
        }

        if (!string.IsNullOrWhiteSpace(Text.ExtractedText))
        {
            var preview = Text.ExtractedText.Length > 100
                ? Text.ExtractedText[..100] + "..."
                : Text.ExtractedText;
            parts.Add($"Text (OCR, {Text.Confidence:F0}% confident): \"{preview}\"");
        }

        return string.Join("\n", parts);
    }
}
Ledgern är ankar i CFCD termer . Den för vidare vad som överlevt urvalen, och LLM-synthesen måste respektera dessa fakta
Ni har sett eskalationslogik på två ställen. OcrQualityWave utsläpper signaler om kvalitet; EscalationService gäller policy över de signalerna . Det här är avsiktligt separerande:
EscalationService aggregerar signaler och applicerar globala trösklarDen EscalationService sammanfogar det hela. Den implementerar delen 1 mönster substrat → förespråkare → konstrainer:
public class EscalationService
{
    private bool ShouldAutoEscalate(ImageProfile profile)
    {
        // Escalate if type detection confidence is low
        if (profile.TypeConfidence < _config.ConfidenceThreshold)
            return true;

        // Escalate if image is blurry
        if (profile.LaplacianVariance < _config.BlurThreshold)
            return true;

        // Escalate if high text content
        if (profile.TextLikeliness >= _config.TextLikelinessThreshold)
            return true;

        // Escalate for complex diagrams or charts
        if (profile.DetectedType is ImageType.Diagram or ImageType.Chart)
            return true;

        return false;
    }
}
Varje escalationsval är deterministisk: samma ingångar , samma tröskeln , samma beslut M SK3 Inga LLM-bedömande i eskalationslogiken
När Vision LLM körs, får den beräknade fakta som begränsningar.
private static string BuildVisionPrompt(ImageProfile profile)
{
    var prompt = new StringBuilder();

    prompt.AppendLine("CRITICAL CONSTRAINTS:");
    prompt.AppendLine("- Only describe what is visually present in the image");
    prompt.AppendLine("- Only reference metadata values provided below");
    prompt.AppendLine("- Do NOT infer, assume, or guess information not visible");
    prompt.AppendLine();

    prompt.AppendLine("METADATA SIGNALS (computed from image analysis):");

    if (profile.DominantColors?.Any() == true)
    {
        prompt.Append("Dominant Colors: ");
        var colorDescriptions = profile.DominantColors
            .Take(3)
            .Select(c => $"{c.Name} ({c.Percentage:F0}%)");
        prompt.AppendLine(string.Join(", ", colorDescriptions));

        if (profile.IsMostlyGrayscale)
            prompt.AppendLine("  → Image is mostly grayscale");
    }

    prompt.AppendLine($"Sharpness: {profile.LaplacianVariance:F0} (Laplacian variance)");
    if (profile.LaplacianVariance < 100)
        prompt.AppendLine("  → Image is blurry or soft-focused");

    prompt.AppendLine($"Detected Type: {profile.DetectedType} (confidence: {profile.TypeConfidence:P0})");

    prompt.AppendLine();
    prompt.AppendLine("Use these metadata signals to guide your description.");
    prompt.AppendLine("Your description should be grounded in observable facts only.");

    return prompt.ToString();
}
Vision LLM borde inte hävda "kraftiga färger " om vi räknade gråskalan - om det gör det M SK3 motsägelserna är upptäckbara Mska4 Det borde inte behaupta ♫ " skarpa detaljer Mske6 om man räknade låga Laplacian-varianser deterministisk substrat begränsar den probabilistiska utgången.
Dessa begränsningar minskar hallucinationen men inte eliminerar den.
När man extraherar den slutgiltiga texten
static string? GetExtractedText(DynamicImageProfile profile)
{
    // Priority chain using canonical signal names (see OCR Signal Taxonomy above)
    //   1. Vision LLM OCR (best for complex/garbled)
    //   2. Florence-2 multi-frame GIF (temporal stability)
    //   3. Florence-2 single-frame (stylized fonts)
    //   4. Tesseract (baseline)

    var visionText = profile.GetValue<string>("ocr.vision.text");
    if (!string.IsNullOrEmpty(visionText))
  ocally (confidence 0.85-0.90, no cost)
- **Tesseract voting**: Reliable for clean text (confidence varies, deterministic)
- **Raw Tesseract**: Baseline fallback (confidence < 0.7 for stylized fonts)

The priority order encodes this knowledge. Florence-2 sitting between Vision LLM and Tesseract provides a "sweet spot" for most images—better than traditional OCR, cheaper than cloud Vision LLMs.

Note: this function selects *one* source, but the ledger exposes *all* sources with their confidence scores. Downstream consumers can-and should-inspect provenance when the domain requires it. The priority order is a sensible default, not a straitjacket.

---

## Selection and Conflict Resolution

The priority chain above is the current implementation-a simple fallback. But the architecture supports adding rejection rules as config-driven policy. Here's the pattern for contradiction detection (not yet implemented, but the signals exist to support it):

```csharp
// Pattern: Contradiction detection as policy rules
public static class SelectionPolicy
{
    public static string? SelectTextWithConstraints(DynamicImageProfile profile)
    {
        var visionText = profile.GetValue<string>("vision.llm.text");
        if (!string.IsNullOrEmpty(visionText))
        {
            // Rule: Reject if Vision claims text but deterministic signals say no text
            var textLikeliness = profile.GetValue<double>("content.text_likeliness");
            if (textLikeliness < _config.TextLikelinessThreshold && visionText.Length > 50)
            {
                // Contradiction detected - log and fall through
                profile.AddSignal(new Signal
                {
                    Key = "selection.vision_rejected",
                    Value = "text_likeliness_contradiction",
                    Confidence = 1.0,
                    Source = "SelectionPolicy",
                    Metadata = new Dictionary<string, object>
                    {
                        ["text_likeliness"] = textLikeliness,
                        ["vision_text_length"] = visionText.Length,
                        ["threshold"] = _config.TextLikelinessThreshold
                    }
                });
                // Fall through to OCR sources
            }
            else
            {
                return visionText;
            }
        }

        // Continue with priority chain...
        return profile.GetValue<string>("ocr.voting.consensus_text")
            ?? profile.GetValue<string>("ocr.full_text");
    }
}
Samma mönster gäller andra typer av signaler:
color.is_grayscale är santquality.sharpness < tröskelcontent.type är Diagramm med hög trovärdighetDe viktigaste egenskaperna hos den valskivan:
Det är här som "determinism förblir kvar " blir mekaniskt sant M SK2 LLM föreslår ; deterministiska regler som bestämmer om man ska acceptera
Pipeliner är fullt konfigurierbara via JSON, vilket gör att vågsstrukturen är tydlig och kontrollbar :
{
  "name": "advancedocr",
  "displayName": "Advanced OCR (Default)",
  "description": "Multi-frame temporal OCR with stabilization and voting",
  "estimatedDurationSeconds": 2.5,
  "accuracyImprovement": 25,
  "phases": [
    {
      "id": "color",
      "name": "Color Analysis",
      "priority": 100,
      "waveType": "ColorWave",
      "enabled": true
    },
    {
      "id": "simple-ocr",
      "name": "Simple OCR",
      "priority": 60,
      "waveType": "OcrWave",
      "earlyExitThreshold": 0.98
    },
    {
      "id": "advanced-ocr",
      "name": "Advanced Multi-Frame OCR",
      "priority": 59,
      "waveType": "AdvancedOcrWave",
      "dependsOn": ["simple-ocr"],
      "parameters": {
        "maxFrames": 30,
        "ssimThreshold": 0.95,
        "enableVoting": true
      }
    },
    {
      "id": "quality",
      "name": "OCR Quality Assessment",
      "priority": 58,
      "waveType": "OcrQualityWave",
      "dependsOn": ["advanced-ocr"]
    }
  ]
}
tidiga utgångsgränser låter dyra vågor hoppa över när billiga strömmar redan har uppnått hög trovärdighet.
Den auto pipeline implementerar smart ruttering baserat på bilder
Image Analysis (OpenCV ~5-20ms)
    │
    ├── Is animated (>1 frame)?
    │   └── ANIMATED route
    │       ├── Has subtitle regions? → Text-only strip extraction
    │       ├── Minimal text? → FAST (Florence-2 only)
    │       └── Motion significant? → Motion analysis
    │
    ├── Has text regions (OpenCV detection)?
    │   ├── High contrast, clean text → FAST route (Florence-2, ~100ms)
    │   ├── Moderate confidence → BALANCED route (Florence-2 + Tesseract, ~300ms)
    │   └── Low confidence → QUALITY route (Multi-frame + Vision LLM, ~1-5s)
    │
    ├── Is chart/diagram (type detection)?
    │   └── QUALITY route → Vision LLM caption
    │
    └── Default → FAST route (Florence-2 caption)
| Router | Triglar när | Bearbetande | Timm | МSK4 | kostnaderna | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| FAST | Enkel text, hög kontrastMSG3 standardfonts MSG4 FlorenzMSC5 bara МСG6 MSG7ms msG8 lågt | lokal | MSG10 | msG11 | |||||||||||
| BALNED | Normal text, måttlig självförtroende | ||||||||||||||
| KVALITY | Diagrammar | , | Diagramer | МSK3 | Stiliserade fonts | , | lågt självförtroende ♫ | Multi | - | ram | + | Vision LLM ♫ ♫ | ♫ | ||
| ANIMATED | GIF-bilder med undertitel | Text | - | enkel stripp | МSK4 | film | 5 | 6 | 7 | mellan | 8 | API | 9 | 10 |
$ imagesummarizer anchorman-not-even-mad.gif --pipeline auto --output visual
[Route selection...]
  Image: 300×185, 93 frames
  Text detection: 15 regions found (bottom 30%)
  Subtitle pattern: DETECTED
  → Selected ANIMATED route (text-only filmstrip)

[Processing...]
  MlOcrWave: Extracted 10 frames → 2 unique text segments
  Text-only strip: 253×105 (83% token reduction)
  VisionLlmWave: Processing filmstrip...

[Results - 2.3s total]
Text: "I'm not even mad." + "That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion
Rutingstillståndet är deterministiskt och registrerad i signaler för audit.
{
  "routing": {
    "selected_route": "ANIMATED",
    "reason": "subtitle_pattern_detected",
    "text_regions": 15,
    "frames": 93,
    "decision_time_ms": 18
  }
}
# Use auto pipeline (smart routing - recommended)
imagesummarizer meme.gif --pipeline auto

# Fast local caption with Florence-2 ONNX (~200ms)
imagesummarizer photo.jpg --pipeline florence2

# Best quality: Florence-2 + Vision LLM
imagesummarizer complex-diagram.png --pipeline florence2+llm

# Extract text only (three-tier OCR)
imagesummarizer screenshot.png --pipeline advancedocr

# Motion analysis for GIFs
imagesummarizer animation.gif --pipeline motion

# Process a directory with visual output
imagesummarizer ./photos/ --output visual
Säg bara de signaler du behöver genom att använda förutfattade samlingar-
# Minimal metadata (fast)
imagesummarizer image.png --signals "@minimal"

# Alt text for accessibility
imagesummarizer image.png --signals "@alttext"

# Motion analysis
imagesummarizer animation.gif --signals "@motion"

# Full analysis
imagesummarizer image.png --signals "@full"

# Custom wildcard patterns
imagesummarizer image.png --signals "color.dominant*, ocr.text, motion.*"
| Kollektion | Signaler | |
|---|---|---|
@minimal Identitet*, kvalitetM SK1 skarphet |
Bara snabbprofil | |
@alttext |
undertiteln . text* | tillgänglighet |
@motion |
rörelse*,identitet.framemöjlighet, _koll, ♫ ♫ | ♫ Animationsanalys ♫ |
@full |
Alla signaler | Hela analysen |
@tool |
Optimiserad undergrupp | MCP/automation |
$ imagesummarizer princess-bride.gif --output json
{
  "image": "princess-bride.gif",
  "duration_ms": 1838,
  "waves_executed": ["ColorWave", "OcrWave", "AdvancedOcrWave", "VisionLlmWave"],
  "text": {
    "value": "You keep using that word.\nI do not think it means what you think it means.",
    "source": "ocr.voting.consensus_text",
    "confidence": 0.95
  },
  "escalation": {
    "triggered": true,
    "reason": "text_likeliness_above_threshold",
    "threshold": 0.4,
    "observed": 0.67
  },
  "signals": {
    "color.dominant_1": { "value": "#1a1a2e", "confidence": 1.0 },
    "ocr.quality.spell_check_score": { "value": 0.82, "confidence": 1.0 },
    "ocr.quality.is_garbled": { "value": false, "confidence": 1.0 },
    "motion.type": { "value": "static", "confidence": 0.95 }
  }
}
Varje fält har provenance. Den escalation blockshows varför Vision LLM kallades ".".

$ imagesummarizer demo-images/alanshrug_opt.gif --pipeline motion
Motion: SUBTLE general motion (localized coverage)
Direction: up-down
Magnitude: 0.23
$ imagesummarizer
ImageSummarizer Interactive Mode
Pipeline: advancedocr | Output: auto | LLM: auto
Commands: /help, /pipeline, /output, /llm, /model, /ollama, /models, /quit

Enter image path (or drag & drop): F:\Gifs\meme.gif
Processing...
I'm not even mad. That's amazing.

Enter image path: /llm true
Vision LLM: enabled

Enter image path: /model minicpm-v:8b
Vision model: minicpm-v:8b
För visuella utforskningar, erbjuder datorapplikationen
Det skrivbords GUI demonstrerar arkitekturen visuellt— du kan se exakt vilka vågor som gick igång , vilka signaler de skickade ut , och hur rutteringsbesluten fattades
CLI visar alla komplexiteten som enkla alternativ.
| del | mönster | Implementering av ImageSummarizer | ||
|---|---|---|---|---|
| 1 | Begränsad otydighet | ColorWave bearbetar fakta; VisionLlmWave respekterar dem | ||
| 2 | Begränsad Fuzzy MoM | Flera vågor publiceras i analys Kontexten ; Bandorchesterkoordinater | ||
| 3 | Kontext dragning | ImageLedger samlar upp salienta egenskaperM SK1 Signaldatabas-cacheresultat |
Samma mönster sannolikhet föreslår , determinism förblir.
Det här är inte den snabbaste vägen. Den är den tillförlitliga vägen . Det är värt det om du behöver en kontrollbar bild förståelse på skala
| Missbruksmöjlighet | Vad händer | Hur det går | |||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Skrämmande GIF | Framsjitter , kompressionsartefakter | Tillfällig stabilisering | МSK3 | SSIM-duplikation | |||||||||||
| OCR återvänder skräp | Tesseract misslyckas med stiliserade fonter | Spell-kontrollgrann detekterar | < | МSK4 | korrekt | → | uppskrider till Florenz | LLM om syn än är dålig | |||||||
| Höga API-kostnader | Alltför många cloud Vision LLM-sändningar | Florensen | -2 | ONNX löser | 80%+ | lokalt ♫ ~200 | ms | МSK5 | text | - | bara fläckar reducerar token | 30× | för GIFs | ||
| Synhallucinationer | LLM säger att texten som inte är ' finns där ♫ | ♫ Signaler gör det möjligt att upptäcka motsägelser ♫vision.llm.text mot content.text_likeliness |
|||||||||||||
| Pipelineförändringar över tid | Nya vågor lagts till , tröskelnjusterade | innehåll | МSK3 | hash-caching | + | full provenance in every signal | + | version tracking | |||||||
| Modellen ger inget tillbaka | Vision LLM upptimening eller tom respons | Fallback-skedja | : | Vision LML | → | Florence | МSK4 | → | Tesseract-röstning |
Varje felläger har en deterministisk respons. Ingen tyst nedbrytning.
En viktig kontext: ImageSummarizer är bildinspegningsrör för LucidRAG ekosystem.
Detta artikel fokuserar på att extrahera strukturerade signaler från bilder.
När de kopplas ihop med LucidRAG ( "Kom snart" !), dessa tre banor möjliggör multi-modal graf RAG:
Document → DocSummarizer → Structured signals
    ↓
Images → ImageSummarizer → Structured signals
    ↓
Data → DataSummarizer → Structured signals
    ↓
    ↓ (all signals)
    ↓
LucidRAG Graph Builder → Multi-modal knowledge graph
    ↓
Query → Multi-modal retrieval + constrained generation
Varför är detta viktigt?: Traditionella RAG behandlar bilder som osynliga fläckar som får captioning första-klass signaler med tiffade kopplingar till texten, data , och andra bilder. Samma deterministiska principer
Patternskalan är: : om du kan extrahera strukturerade signaler från bilderna.DocSummarizer), och data (DataSummarizer), kan du bygga en kunskapsgraf där varje nod har provenance och varje rand har självförtroende poäng
Kom snart: Hela LucidRAG-integrationen som visar hur dessa banor bildar sig i flera grafier.
Architekturen har en struktur: varje våg är oberoende , varje signal är inskriven M SK2 varje upphöjning är deterministiska . Florenz MSC4 erbjuder snabb lokal analys Mska5 Vision LLM hanterar komplexa fall M Ska6 men inga av dem fungerar utan begränsningarMska7 deterministiska signaler angrippar alltid utgången
Sedan den första artikelpubliceringen, ,, har systemet utvecklats signifikant.
Bara den OCR-rörsverket, —, med sina tre nivåer: -, skalning av nivåerna: ,, multi: M SK3, skärmdumpning och optimering av filmvägar: Mska5, text: M Ska6, bara extraktion av fläcken: Mka7, har blivit tillräckligt komplicerad för att äga sin egen detaljerade artikel. Vision OCR-integration vägledning för den kompletta tekniska sammansättningen.
Om du kan göra detta för bilder— den mest stökiga inmatningstypen , med OCR-ljud , stiliserade fonter M SK3 animerade bilder Mska4 och hallucinationer M Ska5 antagliga titningar M ska6 kan du göra det för vilken sannolikhetskomponent som helst
Att ' är begränsad Fuzziness i praktiken
| del | mönster ♫ ♫ | ♫ Axel ♫ |
|---|---|---|
| 1 | Begränsad otydighet | Enkel komponent |
| 2 | Begränsad Fuzzy MoM | Flera komponenter |
| 3 | Kontext dragning | tid / minne |
| 4 | Image Intelligence (den här artikeln) | Wave architecture, mönster |
| 4.1 | Det tre---Tier-OCR-röret | OCR |
Nästa: Del 5 visar hur ImageSummarizer DocSummarizer, och DataSummarizer komponera till multi-modal graf RAG med LucidRAG.
Alla delar följer samma invariant sannolikhetskomponenter föreslår ; deterministiska system förblir kvar.

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.

