


Wanneer je tools zichzelf volgen, ontwikkelen zichzelf, en zelf kiezen
Opmerking: Dit is deel 8 in de Semantic Intelligence serie. Deel 7 had betrekking op de algemene DSE architectuur. Dit artikel duiken diep in iets dat ik glossed over: hoe de tools zelf werken, het gebruik volgen, evolueren en slimmer worden na verloop van tijd.
Opmerking: Als je dacht dat de workflow evolutie in deel 7 wild was, wacht dan tot je ziet wat er gebeurt als elk gereedschap heeft dezelfde mogelijkheden.
In deel 7 liet ik je Directed Synthetic Evolution zien: workflows die plannen, genereren, uitvoeren, evalueren en verbeteren. Ik heb een aantal keren "tools" genoemd.
Dit heb ik niet uitgelegd:
Die tools zijn niet statisch, het zijn geen configuratiebestanden die daar ongewijzigd zitten.
Het zijn levende artefacten die:
Met andere woorden: Hulpmiddelen zijn knooppunten. Knooppunten zijn gereedschap. Alles evolueert.
En het wordt nog vreemder.
Ik zal je laten zien wat het systeem eigenlijk heeft:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
Dat index.json? 5.464 lijnen van tooldefinities, gebruiksstatistieken, versiegeschiedenis, fitnessscores, en lineage tracking.
Elk gereedschap daarbinnen:
OPMERKING: Het systeem zal in feite ZONDER alle gereedschappen draaien. Alleen minder efficiënt; en dommer. Zonder deze gereedschappen zouden tools worden gegenereerd als een normaal onderdeel van de workflow ontbinding. Het zou nog steeds langzaam aanpassen, maar het zou meer tokens WAY nemen.
Laten we eens kijken wat een gereedschap eigenlijk is.
Hier is een echte tool definitie van het systeem:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Let op wat er daar is:
Maar dit is wat er is. niet in de YAML:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Het systeem augmentsunit synonyms for matching user input statische definities met runtime learning.
Dit is wat er gebeurt als je een tool gebruikt:
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Wat getraceerd wordt:
Laten we eens kijken naar het caching mechanisme.
Het slimste stukje: het systeem caches gereedschap aanroepen op meerdere niveaus.
Niveau 1: Exacte Match Caching
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Waarom dit belangrijk is:
Als je het systeem twee keer vraagt om "een haiku over code te schrijven," dan is de tweede keer direct. De LLM draait niet. Het RAG geheugen geeft het gecachede resultaat terug.
Maar hier is het slimme stukje: het geeft de BEST versie terug als er meerdere bestaan.
Voorbeeld:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Het systeem selecteert automatisch het hoogste kwaliteit gecachede resultaat.
Een van de subtler functies: het systeem leert hoe lang elk model duurt om te reageren.
Het probleem:
Verschillende modellen hebben enorm verschillende responstijden:
tinyllama (2B): ~3 secondenllama3 (8B): ~10 secondenqwen2.5-coder (14B): ~25 secondendeepseek-coder-v2 (16B): ~60 secondenAls je een globale timeout instelt (zeg, 30s), verspil je 27 seconden wachten op tinyllama, en je doodt deepseek Voordat het klaar is.
De oplossing: adaptief leren
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Hoe het werkt:
Resultaten:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Het systeem leert de juiste timeout voor elk model in plaats van een globale waarde te gebruiken.
Als je het systeem vraagt om iets te doen, kiest het niet alleen het eerste bijpassende hulpmiddel. fitnessfunctie in meerdere dimensies.
Fitnessberekening:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Echt voorbeeld:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Geselecteerd: email_validator_workflow (geschiktheid: 190)
Het systeem kiest de snel, vrij, van hoge kwaliteit, bewezen Niet de meest semantische, niet de meest krachtige.
Degene die optimaal voldoet aan meerdere beperkingen.
Gereedschap blijft niet statisch, ze evolueren.
Versie & veranderingsdetectie:
Elk gereedschap heeft een definitie hash berekend uit zijn YAML:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
Wanneer u de YAML van een gereedschap bewerkt:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Bij de volgende lading:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Semantische versiering:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Breaking Changes:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Bij belasting:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Het systeem waarschuwt u over het breken van wijzigingen en onderhoudt versiegeschiedenis.
Elke tool krijgt geïndexeerd in RAG geheugen voor semantische zoekopdracht:
Bij laadtijd:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Als je nu zoekt:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Het systeem maakt gebruik van RAG-inbeddingen om relevante tools te vinden en ze dan te rangschikken naar multidimensionale geschiktheid.
In ons systeem bewaren we de vectoren voor de inbeddingen in Qdrant een vector database en het geeft ons een nette manier om te zien hoe onze toolspace. Dit is het geheugensysteem van ons workflow bouwsysteem.
Verdeeld in de originele sjablonen (yaml bestanden in de tools directory) en elk element van code gegenereerd om een taak op te lossen (en config voor llms etc). Deze vormen om gereedschapskist te monteren. Voorgebouwde brokken variërend van;
Op deze manier is alle werklaag componeerbaar en te testen aangezien elk Python-element een reeks tests, BDD-spec, statische tools heeft om de juistheid te controleren en meerdere LLM-beoordelaars om ervoor te zorgen dat het werkt.
de bijwerking is ALLE stukjes code die zal draaien in een workflow is daar, klaar om te inspecteren als elke 'gereedschap' creatie leidt tot inspecterende Python scrapes.
Je kunt de teentjes samen zien klungelen, waarbij elke blob een semantisch gekoppelde set van gereedschappen is zoals:
Allemaal geclusterd, natuurlijk gespecialiseerd in de aard van het systeem.
In de toekomst zouden we deze clusters waarschijnlijk willen optimaliseren om de codebase te reduceren tot een kleiner, strakker, meer geoptimaliseerd systeem.
Omdat we versies, gebruik, veranderingen en leugens kunnen volgen kunnen we selectief optimaliseren en 'cluster defrag' de meest gebruikte en meest prestatiekritische comopnententen als onderdeel van de manier waarop het systeem intrinsiek gestructureerd is.
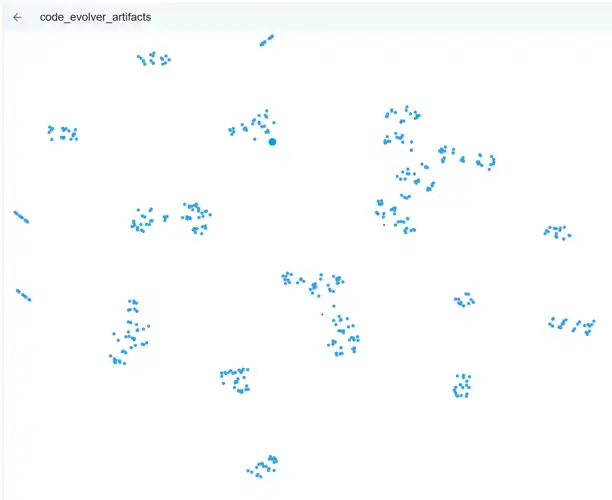
Laten we eens kijken naar wat er nu echt bestaat in het systeem.
LLM Tools (27 specialisten):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Uitvoerbare hulpprogramma's:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
OpenAPI-tools:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Totaal hulpprogramma's: 50+
Totaal aantal metadata: 5.464 lijnen in index.json
Ik zal je het meest geavanceerde gereedschap in het systeem laten zien: code_optimizer.
Definitie: tools/llm/code_optimizer.yaml (317 lijnen!)
Wat het doet:
Hiërarchische Optimalisatie:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Kostenbeheer:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Testintegratie:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Versiebeheer:
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Dit enkel gereedschap orkesten:
En het is slechts één gereedschap in een systeem met 50+ gereedschappen.
Een van de meest meta-tools: model_selector.
Natuurlijke taalselectie:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Hoe het werkt:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Het systeem ontleedt de natuurlijke taal om modellen te selecteren. U kunt zeggen:
En het leidt intelligent naar de juiste backend.
Het systeem behandelt externe API's hetzelfde als interne tools.
Voorbeeld: NMT-vertaler
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Op runtime:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Wat getraceerd wordt:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Externe API's krijgen dezelfde behandeling:
Een van de wildste tools: workflow_documenter.
Wat het doet:
Neemt een workflow (a main.py bestand) en automatisch uitgebreide documentatie genereert door:
README.txtAllemaal automatisch.
Definitie: tools/llm/workflow_documenter.yaml (11.803 karakters!)
Invoer:
{
    "workflow_path": "nodes/email_validator/main.py"
}
Uitvoer:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
V: Kan dit controleren of er een e-mail bestaat? A: Nee, dit valideert alleen formaat. Gebruik DNS/SMTP controle op bestaan.
V: Steunt het internationale domeinen? A: Ja, maar punycode conversie kan nodig zijn.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Gebruiker: "Ik heb een hulpmiddel nodig dat temperaturen omzet"
Systeem:
Nieuw hulpmiddel aangemaakt: temperature_converter.yaml
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Het systeem weet:
En het gebruikt deze gegevens aan:
Laten we een stapje terug doen en nadenken over wat we eigenlijk hebben opgebouwd:
Een systeem waarbij:
We hebben een zelfoptimaliserende toolkit gemaakt die:
Dit is geen configuratiebeheer.
Dit is opkomende werktuig ecologie.
Hulpmiddelen zijn geen statische bronnen. levende artefacten in een evolutionair systeem.
Scenario 1: Zelfverbeterend Kritisch Pad
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Het systeem optimaliseerde zijn eigen kritieke pad zonder menselijke tussenkomst.
Scenario 2: Adaptieve specialisatie
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Het systeem identificeerde een patroon en creëerde een gespecialiseerd hulpmiddel.
Scenario 3: Kostenbewuste Escalatie
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Het systeem besteedde geld intelligent om betere resultaten te bereiken.
Ik catalogiseer wat er nu echt bestaat.
Code Specialist
code_explainer - Verklaart code in natuurlijke taalcode_optimizer - Hiërarchische optimalisatie (lokaal/cloud/diep)code_reviewer - Kwaliteits- en veiligheidsbeoordelingfast_code_generator - Snelle generatie met kleine modellensecurity_auditor - Kwetsbaarheid scannenperformance_profiler - Code profilering en analyseInhoud Specialisten:
long_form_writer - Romans, boeken (128K context)content_generator - Algemene inhoudarticle_analyzer - Artikelstructuur/kwaliteitsummarizer - Samenvat lange inhoudproofreader - Grammatica en stijlseo_optimizer - SEO optimalisatieoutline_generator - Content contourenVertaling:
quick_translator - Snelle vertaling (klein model)translation_quality_checker - Valideert vertalingenDocumentatie:
doc_generator - Code documentatietechnical_writer - Technische documentatieworkflow_documenter - Auto-genereert workflow docsSysteemgereedschappen:
general - Terugval voor algemene doeleindenmodel_selector - Selecteer beste backend/modeltask_to_workflow_router - Routes taken naar workflowsquick_feedback - Snelle triagesignalr_connection_parser - Ontleden SignalR aansluitingensignalr_llmapi_management - Beheert SignalR LLM API'sValidatie:
call_tool_validator - Valideert call_tool() gebruikpython_syntax_validator - Syntaxiscontrolemypy_type_checker - Statische controle van het typejson_output_validator - JSON-formaatvalidatiestdin_usage_validator - Valideert stdin gebruikmain_function_checker - Controles voor de hoofdfunctienode_runtime_import_validator - Valideert de invoerAnalyse:
run_static_analysis - Draait statische analyse toolsperformance_profiler - Profielen code prestatiesHulpmiddelen:
save_to_disk - Schijf persistentieunit_converter - Eenheidsconversiesrandom_data_generator - Productie van testgegevensbuffer - Bufferbeheerworkflow_datastore - Workflow data storagestream_processor - Stroomverwerkingsse_stream - Server-verzonden gebeurtenissenIntegratie:
connect_signalr - SignalR verbindingsignalr_hub_connector - Hub verbindingsignalr_websocket_stream - WebSocket streamingDocumentatie:
document_workflow - Workflow documentatie generatornmt_translator - Neurale machine vertaling APITotaal: 53 gereedschappen (en groei)
Hier wordt het echt interessant: gereedschap componeert andere gereedschappen.
En wanneer een samengesteld gereedschap zich ontwikkelt. elke workflow met het automatisch verbetert.
Laten we eens kijken naar een echt samengesteld hulpmiddel van het systeem:
Taak: "Vertaal dit artikel naar het Spaans en valideer kwaliteit"
Traditionele aanpak:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
DSE-aanpak:
Het systeem ontdekt dat dit patroon vaak wordt gebruikt en automatisch een samengesteld hulpmiddel aanmaken:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Wat is hier zo gek aan:
Wanneer nmt_translator evolueert naar v2.0.0 (misschien 20% sneller), het samengestelde gereedschap automatisch gebruikt de nieuwe versie. Geen code wijzigingen nodig.
Resultaat: Elke workflow gebruikt validated_translator 20% sneller zonder enige wijziging.
Hier is een nog koeler voorbeeld: parallelle gereedschapssamenstelling.
Taak: "Bekijk deze code grondig"
Naïeve aanpak:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE parallelle samenstelling:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Uitvoering:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Resultaat: 35 seconden → 20 seconden (43% sneller!)
En wanneer security_auditor evolueert naar v3.0.0 (zeg, 30% sneller), de hele commissie wordt automatisch sneller.
Hier is het deel dat echt wild is: tools werken als genen.
Waarneming: Wanneer een hulpmiddel nuttig blijkt, het verspreidt zich via het systeem.
Echt voorbeeld: het kwaliteitscontrolepatroon
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Dit is letterlijk genetische verspreiding:
Het codepad is altijd optimaal omdat:
Hier is het hele slimme stukje: u kunt alle tools tegelijk verbeteren.
Scenario: Je hebt 20 workflows, elk met 5-10 tools. Totaal: ~100 tool invocations.
Traditioneel systeem:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
DSE-systeem:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Resultaat:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Je hebt ÉÉN gereedschap getraind en tegelijkertijd Eighteen workflows verbeterd.
Het echt wilde deel: evolution cascades via de afhankelijkheidsgrafiek.
Voorbeeld:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
Een evolutie gebeurtenis verbeterde ELEVEN workflows zonder enige handmatige interventie.
Omdat gereedschappen track fitness, cache resultaten, en auto-evolve, het systeem draait altijd de best beschikbare implementatie.
Voorbeelduitvoering:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Het systeem:
Het codepad wordt bij elke stap geoptimaliseerd:
Laten we precies zijn over waarom dit is gerichte synthetische evolutie en niet alleen "caching with versioning":
Hulpmiddelen als Genen:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Gerichte evolutie:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
De "Gene Pool":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Genetische verspreiding Visualisatie:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
Genetische erfelijkheid:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Netjes, toch?
Ja, het is echt wild.
We bouwden een systeem waarbij:
Het is geen metafoor.
Het is eigenlijk gerichte synthetische evolutie.
Na het draaien van dit systeem voor weken:
Als het gereedschap kan:
Wat nu?
Dit is wat deel 7 niet volledig uitlegde:
De workflows die evolueren? De tools die workflows samenstellen? Ze evolueren ook. Het systeem dat evolutie beheert? Ook tools. Ja, gereedschap.
Het is gereedschap helemaal naar beneden.
En allemaal:
We hebben geen codegenerator gebouwd.
We bouwden een zelf-verruimende, zelf-optimaliserende, zelf-documenterende toolkit die toevallig code genereert.
Het verschil is belangrijk.
Want wanneer gereedschappen evolutionaire eenheden worden, wanneer ze hun eigen fitness volgen, wanneer ze zich voortplanten en muteren en concurreren...
Je hebt geen gereedschapskist.
Je hebt een ecologie.
En ecologieën evolueren.
Maar wat gebeurt er als de evolutie dingen breekt? Wanneer een gereedschapsmutatie een kritieke bug introduceert? Wanneer optimalisatie een hulpmiddel erger maakt in plaats van beter?
Daar komt deel 9 bij kijken. zelfgenezing door afstamming-bewust snoeienEen systeem waar tools niet alleen evolueren, ze herinneren zich elke mislukking, snoeien mislukte takken, en propageren die kennis om soortgelijke fouten te voorkomen in het hele ecosysteem.
Wanneer uw gereedschap zichzelf kan breken, moet uw systeem onthouden waarom en nooit de fout herhalen.
Repository: meestal lucid.dse
Sleutelbestanden:
src/tools_manager.py (2.293 regels) - Core tools managementsrc/rag_integrated_tools.py (562 lijnen) - RAG-integratiesrc/openapi_tool.py (313 regels) - OpenAPI-ondersteuningsrc/model_selector_tool.py (460 lijnen) - Modelselectietools/index.json (5.464 lijnen) - Gereedschapsregistertools/llm/*.yaml (27 instrumenten) - LLM-gespecialiseerde definitiestools/executable/*.yaml (19 gereedschappen) - Uitvoerbaar gereedschaptools/openapi/*.yaml (3 instrumenten) - API-integratiesDocumentatie:
LLMS_AS_TOOLS.md - LLM-selectiesysteemWORKFLOW_DOCUMENTATION_TOOL.md - Auto-documentatieCHAT_TOOLS_GUIDE.md - Tool use guideTOOL_PACKAGING.md - GereedschapsontwikkelingshandleidingSerienavigatie:
Dit is deel 8 in de Semantic Intelligence serie. Deel 7 toonde de algemene DSE architectuur. Dit artikel onthult de verborgen complexiteit: elke tool in het systeem tracks gebruik, evolueert implementaties, caches resultaten, en neemt deel aan fitness-gebaseerde selectie. De toolkit is niet alleen een bron het is een evolutionaire ecologie die breidt, optimaliseert en documenteert zichzelf. Tools genereren tools. Tools verbeteren tools. En het hele systeem wordt slimmer door de tijd.
De code is echt, draait lokaal op Ollama, echt tracking metrics, en eigenlijk evolueert. Het is experimenteel, af en toe instabiel, en zeker "vibe-coded." Maar de tools werken, de tracking werkt, en de evolutie werkt. De toolkit groeit zichzelf.
Deze verkenningen verbinden zich met de sci-fi roman "Michael" over emergent AI en de implicaties van systemen die zichzelf optimaliseren. De hier beschreven tools zijn echte implementaties die laten zien hoe evolutionaire druk specialisatie creëert, hoe fitnessfuncties selectie begeleiden, en hoe zelfverbeterende systemen van nature ecologie-achtige eigenschappen ontwikkelen. Of dit leidt tot de planetaire toolnetwerken van deel 6, of iets totaal onverwachts, valt nog te bezien. Dat maakt het een experiment.
Tags: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
