


Ho costruito StyloFlow perché ho continuato a scrivere. lo stesso schema ripetutamente.: i componenti che reagiscono a ciò che è successo prima , emetteno punteggi di fiduciaM SK2 e a volte devono escalare fino ad un'analisi più costosa. Gli existingi motori del flusso di lavoro volevano che pensassi in termini di DAG o macchine dello statoMSC4 Volevo pensare in termini dei segnali
NOTA: StyloFlow non è ancora un prodotto finito; visto che costruisco lucidRAG e StyloBot IM SK2m aggiungendo caratteristiche mancanti e pulendo l'API su entrambi gli stili Stylo Fllow e ephemerio . EMSC4 è ancora in fase di sviluppoMスク5 ma potete provarlo e dargli un'opinioneMNK6 Lo aggiornarò qui più tardi |( la roba del SignalSink, ad esempio, cambierà per il v ephemero | 3.0 per essere |
StyloFlow è una biblioteca di orchestrazione guidata da un segnale- che corrisponde. come penso io. Riguardare l'università. Pipeline AI: i componenti dichiarano quello che producono e ciò di cui hanno bisogno, il punteggio di fiducia l'esecuzione del manuale , e le operazioni economiche vanno prima con l'espansione verso quelle costose solo quando necessario.
Questa è l'infrastruttura che alimenta. *lucido.*RAG - uno strumento RAG a grafico modico che combina DocSummarizer (documenti), DataSummarizer (dati strutturati), e ImageSummarizer (immagini,)in una domanda unificata,-un sistema di risvecchiamento con la visualizzazione grafica della conoscenza,M SK3Pottiene anche Stylobot (un sistema avanzato di protezione dei bot) e implementa il RAG ridotto schema.
Source: GitHub - StyloFlow
StyloFlow è un prototipo funzionale di un modello di orchestrazione guidato da un segnale- L'API e la forma si evolveranno mentre costruisco lucidRAG e Stylobot, ma la semantica e i modelli di esecuzione descritti qui sono i segnali del punto: come primiM SK2 fatti della classeMSC3 fiduciaMNK4 ramificazione guidata , e escalazione come modello strutturaleMRK6
Non è una nuova lingua DSL o di flusso di lavoro. semantica dell'esecuzione. costruita intorno ai segnali, fiduciaM SK1 e escalazione limitata. Oggi funziona nel processoMSC3 con una corrispondenza limitata~. Domani distribuirà le corsie tra le macchine mantenendo i segnali come confine stabili .
Ecco come appare la maggior parte dei motori del flusso di lavoro.
// ❌ Traditional: Hardcoded dependencies
public async Task ProcessDocumentAsync(string path)
{
    var text = await ExtractTextAsync(path);
    var chunks = await ChunkTextAsync(text);
    var embeddings = await GenerateEmbeddingsAsync(chunks);
    var entities = await ExtractEntitiesAsync(chunks);
    await StoreEverythingAsync(embeddings, entities);
}
Funziona fino a:
Si finisce con o:
StyloFlow si basa su mostlylucid.ephemeral - una biblioteca per l'exécuzione asynca tracciabile di , .
Un breve riassunto di ciò che l'efemerale fornisce:
// Bounded concurrent processing with full visibility
var coordinator = new EphemeralWorkCoordinator<DocumentJob>(
    async (job, operation, ct) => {
        await ProcessAsync(job, ct);
        operation.Signal("document.processed");
    },
    new EphemeralOptions { MaxConcurrency = 4 });

// Enqueue work
await coordinator.EnqueueAsync(new DocumentJob(filePath));

// Full observability
Console.WriteLine($"Active: {coordinator.ActiveCount}");
Console.WriteLine($"Completed: {coordinator.TotalCompleted}");
Principali benefici dell'efemera:
Per i dettagli, consultate Fire and Don't Quite Forget.
Questo modello di orchestrazione estende l'efemera con:
Ecco qui il principale cambiamento architettonico.
graph TD
    subgraph Traditional["❌ Traditional: Hardcoded"]
        T1[Component A] -->|calls| T2[Component B]
        T2 -->|calls| T3[Component C]
        T3 -->|calls| T4[Component D]
    end

    subgraph StyloFlow["✅ StyloFlow: Signal-Driven"]
        S1[Component A]
        S2[Component B]
        S3[Component C]
        S4[Component D]
        SS[Signal Sink]

        S1 -.emits.-> SS
        S2 -.emits.-> SS
        S3 -.emits.-> SS
        SS -.triggers.-> S2
        SS -.triggers.-> S3
        SS -.triggers.-> S4
    end

    style T1 stroke:#ff6b6b
    style T2 stroke:#ff6b6b
    style T3 stroke:#ff6b6b
    style T4 stroke:#ff6b6b
    style S1 stroke:#51cf66
    style S2 stroke:#51cf66
    style S3 stroke:#51cf66
    style S4 stroke:#51cf66
    style SS stroke:#339af0
I componenti non si chiamano mai l'un l'altro. Emmettono segnali e reagiscono ai segnali.
I segnali sono fatti su quello che è successo., non i comandi o gli eventiM SK1 Sono immutabili ' sono irreversibili, sono programmati in tempoMSC4 e contengono punteggi di fiduciaMNK5 Ogni atomo possiede i suoi segnali MNK6 sono immutibili da fuoriMMK8 Niente altro può modificare quella listaMRK9
public record Signal
{
    public required string Key { get; init; }           // "document.chunked"
    public object? Value { get; init; }                 // Optional payload
    public double Confidence { get; init; } = 1.0;      // 0.0 to 1.0
    public required string Source { get; init; }        // Which component
    public DateTime Timestamp { get; init; }
    public Dictionary<string, object>? Metadata { get; init; }
}
Critico punto architettonico: SignalSink è una visione storica persistente.
SignalSink fornisce una visione consultabile di tutte le operazioni su tutti i coordinatori che la condividono. I segnali persistono in ogni ciclo di vita del coordinatore - quando un'operazione si trasferisce dal suo coordinatore , i segnali rimangono nel tubo fino a quando non sono liberati manualmenteM SK3
// Create a shared signal sink (no parameters, signals persist)
var sink = new SignalSink();

// Coordinators manage operation lifetime, NOT signal lifetime
var coordinator = new EphemeralWorkCoordinator<string>(
    ProcessAsync,
    new EphemeralOptions
    {
        MaxConcurrency = 8,
        MaxTrackedOperations = 100,         // Operations evict after this
        MaxOperationLifetime = TimeSpan.FromMinutes(5),  // Or after this time
        Signals = sink                      // Share the persistent view
    });

// Operations emit via their emitter
public async Task ProcessAsync(string docId, SignalEmitter emitter, CancellationToken ct)
{
    // Store actual data externally (cache, database, blob storage)
    await cache.SetAsync($"doc-{docId}", documentData);

    // Signal carries a REFERENCE, not the data
    emitter.Emit("document.chunked", key: docId); // Key references external data
}

// SignalSink is readonly - it cannot alter signals
// Signals persist until their operation evicts from the coordinator
SignalSink fornisce due modelli di coordinazione:
1. PushM SK1based (Subscribe):
// Subscribe to the sink for push notifications
sink.Subscribe(signal => {
    if (signal.Is("document.chunked"))
    {
        // React immediately - signal includes OperationId
        Console.WriteLine($"Op {signal.OperationId} chunked doc at {signal.Timestamp}");
    }
});

// Returns IDisposable for cleanup
using var subscription = sink.Subscribe(HandleSignal);
2. PullM SK1based (Query):
// Get all signals for a specific operation
var opSignals = sink.GetOpSignals(operationId);

// Detect if any operation has emitted a signal
if (sink.Detect("embeddings.generated"))
{
    // At least one operation has generated embeddings
}

// Sense all signals matching a condition
var recentErrors = sink.Sense(s =>
    s.Signal.StartsWith("error.") &&
    s.Timestamp > DateTimeOffset.UtcNow.AddMinutes(-5)
);

// Get operation summary from its signal history
var summary = sink.GetOp(operationId);
Console.WriteLine($"Operation ran for {summary?.Duration}");
Perché questo conta:
Principali principi di progettazione: Immagazzinare grandi dati (documentiM SK1 immagini, vettori ) in archivi o databaseMSC4 I segnali portano solo riferimenti come "cache://doc-123" o le chiavi operative.
Esempio di coordinazione:
// Operation emits signal via ISignalEmitter interface
public async Task ProcessAsync(Item item, ISignalEmitter emitter, CancellationToken ct)
{
    // Emit to the sink
    emitter.Emit("processing.started");

    await DoWorkAsync(item, ct);

    emitter.Emit("processing.completed");
}

// Wave checks if it should run by querying sink
public bool ShouldRun(string path, AnalysisContext ctx)
{
    // Pull pattern: query the sink via context
    return ctx.Detect("document.chunked");
}

// UI subscribes to sink for reactive updates
sink.Subscribe(signal => {
    if (signal.Signal.StartsWith("document."))
    {
        // Push pattern: react immediately
        UpdateProgressUI(signal);
    }
});
L'escalazione avviene a due livelli:
// Pattern 1: Intra-coordinator escalation (wave checks signals)
public bool ShouldRun(string path, AnalysisContext ctx)
{
    var quality = ctx.GetSignal("quality.score");
    return quality?.Confidence < 0.7; // Only run if quality is low
}

// Pattern 2: Inter-coordinator escalation (atom routes to another coordinator)
// Option A: Explicit escalation signal
typed.Raise("escalate.to.expensive", payload, key: "doc-123");

// Option B: EscalatorAtom examines signals and decides
new EscalatorAtomOptions<T> {
    ShouldEscalate = evt => evt.Payload.Confidence < 0.7
}
Molti coordinatori funzionano in modo indipendente. EscalatorAtom osserva i segnali da un coordinatore e trasmette il lavoro ad un altro quando necessario.
Per la teoria dietro a questo, vedete Dragging Contexto Fuzzy Constrained.
Critico: I segnali sono eventi di coordinazione, non il trasporto dei dati. Grandi dati M SK2documenti , immaginiMST4 inserzioniM ST5 dovrebbero vivere in un archivio esternoMst6
// ❌ BAD: Carrying data in signals (memory pressure, boxing)
var imageBytes = await ProcessImageAsync(input);
emitter.Emit("image.processed", metadata: new { Data = imageBytes });

// ✅ GOOD: Store externally, signal the reference
var imageBytes = await ProcessImageAsync(input);
var cacheKey = $"processed/{docId}";
await cache.SetAsync(cacheKey, imageBytes);
emitter.Emit("image.processed", key: cacheKey);

// Later: Retrieve when needed
if (sink.Detect("image.processed"))
{
    var signals = sink.GetOpSignals(operationId);
    var imageKey = signals.FirstOrDefault(s => s.Signal == "image.processed")?.Key;
    if (imageKey != null)
    {
        var bytes = await cache.GetAsync<byte[]>(imageKey);
    }
}
Le migliori pratiche:
"cache://key", "blob://container/file", "db://table/id"I manifesti dichiarano contratti. separato dalla implementazione. Questa separazione esiste così che si possa capire il flusso di lavoro senza leggere il codice, e cambiare l'ordine di esecuzione senza ricompilareM SK2
name: BotDetector
priority: 10              # Lower runs first
enabled: true

# What kind of component is this?
taxonomy:
  kind: analyzer          # sensor|analyzer|proposer|gatekeeper
  determinism: probabilistic
  persistence: ephemeral

# When should this run?
triggers:
  requires:
    - signal: http.request.received
      condition: exists

# What does it produce?
emits:
  on_complete:
    - key: bot.detected
      confidence_range: [0.0, 1.0]

  conditional:
    - key: bot.escalation.needed
      when: confidence < 0.7

# Resource limits
lane:
  name: fast              # fast|normal|slow|llm
  max_concurrency: 8

budget:
  max_duration: 100ms

# Configuration values
defaults:
  confidence:
    bot_detected: 0.6
  timing:
    timeout_ms: 100
Benefits:
Mentre si possono scrivere manifesti YAML a mano, StyloFlow include un builder di flussi di lavoro visivi che vi permette di progettare i flussi guidati da un segnale-usando modulariM SK2synthMSC3patching stilaleMスク4
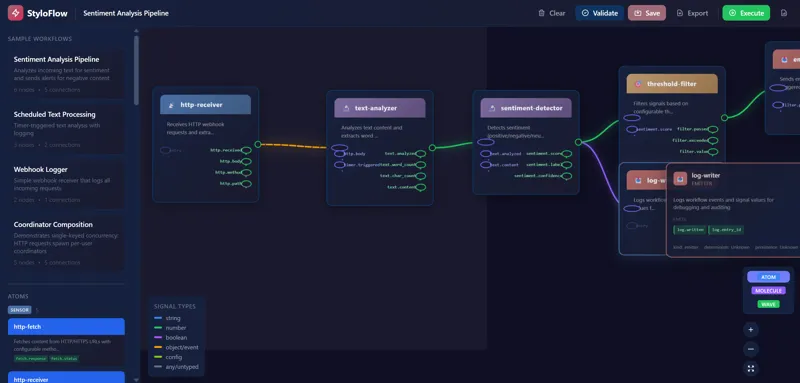
L'interfaccia :
Questo rende facile sperimentare diverse forme di flusso di lavoro senza scrivere YAML a mano, dando comunque il controllo completo sulla configurazione generata.
Una onda è una fase di analisi compostabile. L'interfaccia esiste per fare una prima decisione di classe "dobbiamo fare ?", non è un dettaglio di implementazione nascosto nella logica condizionale.
public interface IContentAnalysisWave
{
    string Name { get; }
    int Priority { get; }               // Higher runs first
    bool Enabled { get; set; }

    // Quick filter - avoid expensive work
    bool ShouldRun(string contentPath, AnalysisContext context);

    // Do the analysis
    Task<IEnumerable<Signal>> AnalyzeAsync(
        string contentPath,
        AnalysisContext context,
        CancellationToken ct);
}
Esempio di onda semplice:
public class FileTypeWave : IContentAnalysisWave
{
    public string Name => "FileType";
    public int Priority => 100;
    public bool Enabled { get; set; } = true;

    public bool ShouldRun(string path, AnalysisContext ctx)
    {
        // Skip if we already know the type
        return ctx.GetSignal("file.type") == null;
    }

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string path,
        AnalysisContext ctx,
        CancellationToken ct)
    {
        var extension = Path.GetExtension(path);
        var mimeType = GetMimeType(extension);

        return new[]
        {
            new Signal
            {
                Key = "file.type",
                Value = mimeType,
                Confidence = 1.0,
                Source = Name
            }
        };
    }
}
Coordinazione delle onde:
L'informazione figura nella parte dispositiva. WaveCoordinator corre onde in ordine prioritario:
var coordinator = new WaveCoordinator(waves, profile);
var context = new AnalysisContext();

var results = await coordinator.ExecuteAsync(filePath, context, ct);

// All signals from all waves
foreach (var signal in context.GetAllSignals())
{
    Console.WriteLine($"{signal.Key}: {signal.Value}");
}
corsie di competizione:
Waves run in lanes with different concurrency limits:
| corsia | scopo SSM2 competizione SSM3 | ||||
|---|---|---|---|---|---|
fast |
Controlli rapidi (Suggestione IPM SK2 tipo di file) | 4 | 5 | 6 | |
normal |
Trattura standard (ParsingM SK2 chunking) | ||||
io |
IM SK1O connesso lavorando il file,Calli APIMSC4 | \32 | |||
llm |
Calls costosi per LLM | 2 |
Questo impedisce alle operazioni costose di bloccare quelle economiche.
Qui'è il quadro completo:
graph TB
    subgraph Input["Input Layer"]
        REQ[HTTP Request]
        FILE[File Upload]
        JOB[Background Job]
    end

    subgraph Ephemeral["Ephemeral Layer"]
        COORD[Work Coordinator]
        OPS[Operations<br/>own signals]
        SINK[SignalSink<br/>read-only view]
    end

    subgraph StyloFlow["StyloFlow Layer"]
        MAN[Manifests]
        WAVE[Wave Coordinator]
        ATOMS[Atoms<br/>own signals]
    end

    subgraph Execution["Execution"]
        FAST[Fast Lane]
        NORM[Normal Lane]
        LLM[LLM Lane]
    end

    subgraph Output["Output"]
        RES[Results]
        ESCAL[Escalation]
        STORE[Persistence]
    end

    REQ --> COORD
    FILE --> COORD
    JOB --> COORD

    COORD --> OPS
    SINK -.queries.-> OPS

    WAVE -.reads.-> SINK
    MAN -.configures.-> WAVE
    WAVE --> ATOMS

    ATOMS --> FAST
    ATOMS --> NORM
    ATOMS --> LLM

    SINK -.queries.-> FAST
    SINK -.queries.-> NORM
    SINK -.queries.-> LLM

    SINK -.read for.-> RES
    SINK -.read for.-> ESCAL
    SINK -.read for.-> STORE

    style COORD stroke:#339af0
    style SINK stroke:#339af0
    style WAVE stroke:#51cf66
    style ATOMS stroke:#51cf66
Flusso:
Modello di proprietà: Ogni operazione/atom possiede i suoi segnali. SignalSink fornisce un'immagine legataM SK2solo attraverso tutte le operazioni . I segnali possono essere escalati MSC4copiatiMST5 o echiati MST6 conservati quando espulsiM ST7 ma la lista posseduta è immutabile dal punto di vista esternoM st8
Modello di esecuzione attuale: Single-processoM SK1 concomitenza limitata, operazioni osservabili con l'evizione LRU .
Modello di esecuzione futuro: corsie distribuite tra le macchine, SignalSink risponde alle operazioni a distanza, gli atomi vengono executati su diversi hostsM SK2 I segnali restano il limite stabile. - sono già serializzabili , sono programmati in tempo, e sono auto-contatiM SK4 contengono. Il modello di proprietà non cambia
L'implementazione del processo in-valida la semanticaM SK1 La distribuzione riguarda la scalazione del substrato di esecuzione, senza cambiare il modello d'orchestrazione
Vediamo come. lucidRAG usa StyloFlow:
Stagio 1: Detezione iniziale
public class FileTypeDetectorWave : IContentAnalysisWave
{
    public int Priority => 100;  // Run first

    public async Task<IEnumerable<Signal>> AnalyzeAsync(...)
    {
        var extension = Path.GetExtension(path);

        return new[]
        {
            new Signal
            {
                Key = "file.extension",
                Value = extension,
                Source = "FileTypeDetector"
            }
        };
    }
}
Livello 2:Fontura (gettato dal fileM SK2estensione)
// In manifest:
// triggers:
//   requires:
//     - signal: file.extension
//       condition: in
//       value: [".pdf", ".docx", ".md"]

public class ChunkingWave : ConfiguredComponentBase, IContentAnalysisWave
{
    public int Priority => 80;

    public async Task<IEnumerable<Signal>> AnalyzeAsync(...)
    {
        var chunks = await ChunkDocumentAsync(path);

        ctx.SetCached("chunks", chunks);  // Share with other waves

        return new[]
        {
            new Signal
            {
                Key = "document.chunked",
                Value = chunks.Count,
                Source = Name
            }
        };
    }
}
Livello 3: Inserzione (getturato dal documentoM SK2gettato)
public class EmbeddingWave : ConfiguredComponentBase, IContentAnalysisWave
{
    public int Priority => 60;

    public bool ShouldRun(string path, AnalysisContext ctx)
    {
        // Only run if chunking succeeded
        return ctx.GetSignal("document.chunked") != null;
    }

    public async Task<IEnumerable<Signal>> AnalyzeAsync(...)
    {
        var chunks = ctx.GetCached<List<Chunk>>("chunks");
        var embeddings = await GenerateEmbeddingsAsync(chunks);

        ctx.SetCached("embeddings", embeddings);

        return new[]
        {
            new Signal
            {
                Key = "embeddings.generated",
                Value = embeddings.Count,
                Source = Name
            }
        };
    }
}
Livello 4: Extrazione delle entità (parallela con l'inserzione)
public class EntityExtractionWave : ConfiguredComponentBase, IContentAnalysisWave
{
    public int Priority => 60;  // Same as embedding - runs in parallel

    public async Task<IEnumerable<Signal>> AnalyzeAsync(...)
    {
        var chunks = ctx.GetCached<List<Chunk>>("chunks");

        // Use deterministic IDF scoring, not LLM per chunk
        // (See Reduced RAG pattern)
        var entities = await ExtractEntitiesAsync(chunks);

        return new[]
        {
            new Signal
            {
                Key = "entities.extracted",
                Value = entities.Count,
                Confidence = CalculateConfidence(entities),
                Source = Name
            }
        };
    }
}
Livello 5: Controllo della qualità
public class QualityCheckWave : ConfiguredComponentBase, IContentAnalysisWave
{
    public int Priority => 40;  // After embedding + entities

    public async Task<IEnumerable<Signal>> AnalyzeAsync(...)
    {
        var embeddingSignal = ctx.GetSignal("embeddings.generated");
        var entitySignal = ctx.GetSignal("entities.extracted");

        var embeddingCount = (int)embeddingSignal.Value;
        var entityConfidence = entitySignal.Confidence;

        var quality = CalculateQuality(embeddingCount, entityConfidence);

        var signals = new List<Signal>
        {
            new Signal
            {
                Key = "quality.score",
                Value = quality,
                Source = Name
            }
        };

        // Trigger escalation if quality is poor
        if (quality < GetParam<double>("quality_threshold", 0.7))
        {
            signals.Add(new Signal
            {
                Key = "escalation.needed",
                Value = "low_quality_document",
                Source = Name
            });
        }

        return signals;
    }
}
Benefit di questo approccio:
Questo è il RAG ridotto schema in azione: estrazione deterministica in anticipoM SK1 LLM solo per la sintesi.
Stylobot è un advanced bot detection system that uses StyloFlow for multi-stage threat analysis. Vedete l'escalamento completo nella sezione M SK2EscalationMSC3 From Fast to Thorough
Pattern 1: Fan-Out
Un segnale attira diverse onde:
graph LR
    S1[document.uploaded] --> W1[ChunkingWave]
    S1 --> W2[MetadataWave]
    S1 --> W3[LanguageDetectionWave]

    W1 -.signal.-> S2[document.chunked]
    W2 -.signal.-> S3[metadata.extracted]
    W3 -.signal.-> S4[language.detected]

    style S1 stroke:#339af0
    style S2 stroke:#339af0
    style S3 stroke:#339af0
    style S4 stroke:#339af0
    style W1 stroke:#51cf66
    style W2 stroke:#51cf66
    style W3 stroke:#51cf66
Pattern 2: Dependenza sequenziale
Le onde aspettano i segnali precedenti:
graph LR
    W1[ExtractWave] -.signal.-> S1[text.extracted]
    S1 --> W2[ChunkWave]
    W2 -.signal.-> S2[text.chunked]
    S2 --> W3[EmbedWave]
    W3 -.signal.-> S3[embeddings.generated]

    style S1 stroke:#339af0
    style S2 stroke:#339af0
    style S3 stroke:#339af0
    style W1 stroke:#51cf66
    style W2 stroke:#51cf66
    style W3 stroke:#51cf66
Tipo 3: Distribuzione condizionata
Esistono diverse onde basate sui segnali:
graph TD
    W1[DetectorWave] -.signal.-> S1{confidence}

    S1 -->|< 0.4| W2[RejectWave]
    S1 -->|0.4-0.7| W3[EscalateWave]
    S1 -->|> 0.7| W4[AcceptWave]

    W2 -.signal.-> S2[rejected]
    W3 -.signal.-> S3[escalated]
    W4 -.signal.-> S4[accepted]

    style S1 stroke:#ffd43b
    style S2 stroke:#ff6b6b
    style S3 stroke:#ff922b
    style S4 stroke:#51cf66
    style W1 stroke:#339af0
    style W2 stroke:#ff6b6b
    style W3 stroke:#ff922b
    style W4 stroke:#51cf66
Pattern 4: Aggregazione
I segnali multipli attivano una onda:
graph LR
    W1[Wave A] -.signal.-> S1[a.complete]
    W2[Wave B] -.signal.-> S2[b.complete]
    W3[Wave C] -.signal.-> S3[c.complete]

    S1 --> T{All Ready?}
    S2 --> T
    S3 --> T

    T -->|Yes| W4[AggregatorWave]
    W4 -.signal.-> S4[aggregation.complete]

    style S1 stroke:#339af0
    style S2 stroke:#339af0
    style S3 stroke:#339af0
    style S4 stroke:#51cf66
    style T stroke:#ffd43b
    style W4 stroke:#51cf66
StyloFlow supporta l'escalazione a due livelli:
Esempio da lucidRAG: L'estrazione delle entità veloce va prima. Se la qualità M SK2 0.7, EscalatorAtom trasmette il documento ad un coordinatore costoso di raffinamento del LLMMSC4 Questo risparmia 20x sul costo evitando costose chiamate per l'LLM per elevare le estrazioni
Questo non è un manuale rapido-start guide; è l'esempio più piccolo che mostra come il modello si mette insiemeM SK3
Installation:
dotnet add package StyloFlow.Complete
Punto di ingresso concettuale:
// 1. Define a wave
public class MyAnalysisWave : IContentAnalysisWave
{
    public string Name => "MyAnalysis";
    public int Priority => 50;
    public bool Enabled { get; set; } = true;

    public bool ShouldRun(string path, AnalysisContext ctx) => true;

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string path,
        AnalysisContext ctx,
        CancellationToken ct)
    {
        // Your analysis logic here
        var result = await AnalyzeAsync(path);

        return new[]
        {
            new Signal
            {
                Key = "my.signal",
                Value = result,
                Confidence = 1.0,
                Source = Name
            }
        };
    }
}

// 2. Register waves
var waves = new List<IContentAnalysisWave>
{
    new MyAnalysisWave(),
    new AnotherWave(),
};

// 3. Create coordinator
var coordinator = new WaveCoordinator(
    waves,
    CoordinatorProfile.Default);

// 4. Execute
var context = new AnalysisContext();
var results = await coordinator.ExecuteAsync(filePath, context);

// 5. Read signals
foreach (var signal in context.GetAllSignals())
{
    Console.WriteLine($"{signal.Key}: {signal.Value} ({signal.Confidence})");
}
Con manifesti:
// Load manifests from directory
var loader = new FileSystemManifestLoader("./manifests");
var manifests = await loader.LoadAllAsync();

// Build waves from manifests
var waves = manifests
    .Where(m => m.Enabled)
    .OrderBy(m => m.Priority)
    .Select(m => WaveFactory.Create(m))
    .ToList();

var coordinator = new WaveCoordinator(waves, profile);
Per esempi completi, consultate la StyloFlow GitHub riposito.
Una delle caratteristiche chiave di StyloFlow' è: La scoperta del flusso di lavoro. - si può capire l'intera catena semplicemente leggendo i manifesti. Non è necessario fare un'immersione di codice
Qui' è la struttura reale del manifest directory per lucidRAG:
manifests/
├── 01-file-type-detector.yaml
├── 02-chunking.yaml
├── 03-embedding.yaml
├── 04-entity-extraction.yaml
├── 05-quality-check.yaml
└── 06-escalation.yaml
01-fileM SK1type-detector .yamlMSC4
name: FileTypeDetector
priority: 100
enabled: true
description: Detects file type from extension

taxonomy:
  kind: sensor
  determinism: deterministic
  persistence: ephemeral

triggers:
  requires:
    - signal: document.uploaded
      condition: exists

emits:
  on_start:
    - file.detection.started
  on_complete:
    - key: file.extension
      type: string
      confidence_range: [1.0, 1.0]
    - key: file.mime_type
      type: string
      confidence_range: [1.0, 1.0]

lane:
  name: fast
  max_concurrency: 16

budget:
  max_duration: 10ms
02-chunkingM SK1yaml:
name: ChunkingWave
priority: 80
enabled: true
description: Splits documents into semantic chunks

taxonomy:
  kind: extractor
  determinism: deterministic
  persistence: ephemeral

input:
  accepts:
    - document.pdf
    - document.docx
    - document.markdown
  required_signals:
    - file.extension

triggers:
  requires:
    - signal: file.extension
      condition: in
      value: [".pdf", ".docx", ".md", ".txt"]

emits:
  on_complete:
    - key: document.chunked
      type: integer
      confidence_range: [1.0, 1.0]
    - key: chunks.cached
      type: boolean

lane:
  name: normal
  max_concurrency: 8

budget:
  max_duration: 30s

defaults:
  chunking:
    max_chunk_size: 512
    overlap: 50
    respect_boundaries: true
03-incoraggiamento.yamlM SK2
name: EmbeddingWave
priority: 60
ires:
    - signal: file.extension
      condition: in
      value: [".pdf", ".docx", ".md", ".txt"]

emits:
  on_complete:
    - key: document.chunked
      type: integer
      confidence_range: [1.0, 1.0]
    - key: chunks.cached
      type: boolean

lane:
  name: normal
  max_concurrency: 8

budget:
  max_duration: 30s

defaults:
  chunking:
    max_chunk_size: 512
    overlap: 50
    respect_boundaries: true
03-incoraggiamento.yamlM SK2
name: EmbeddingWave
priority: 60
enabled: true
description: Generates ONNX embeddings for chunks

taxonomy:
  kind: embedder
  determinism: deterministic
  persistence: cached

input:
  required_signals:
    - document.chunked
    - chunks.cached

triggers:
  requires:
    - signal: document.chunked
      condition: ">"
      value: 0

emits:
  on_complete:
    - key: embeddings.generated
      type: integer
      confidence_range: [1.0, 1.0]

lane:
  name: normal
  max_concurrency: 4

budget:
  max_duration: 2m
  max_cost: 0.0  # Local ONNX model

defaults:
  embedding:
    model: all-MiniLM-L6-v2
    batch_size: 32
04-entità
name: EntityExtractionWave
priority: 60  # Same as embedding - runs in parallel
enabled: true
description: Extracts entities using IDF scoring

taxonomy:
  kind: extractor
  determinism: deterministic
  persistence: persisted

input:
  required_signals:
    - document.chunked

triggers:
  requires:
    - signal: document.chunked
      condition: ">"
      value: 0

emits:
  on_complete:
    - key: entities.extracted
      type: integer
      confidence_range: [0.0, 1.0]  # Confidence varies

lane:
  name: normal
  max_concurrency: 8

budget:
  max_duration: 1m

defaults:
  entity:
    min_idf_score: 2.5
    min_frequency: 2
    max_entities: 100
05-QualitàM SK1controllo.yamlMSC3
name: QualityCheckWave
priority: 40
enabled: true
description: Validates extraction quality

taxonomy:
  kind: gatekeeper
  determinism: deterministic
  persistence: ephemeral

input:
  required_signals:
    - embeddings.generated
    - entities.extracted

triggers:
  requires:
    - signal: embeddings.generated
      condition: ">"
      value: 0
    - signal: entities.extracted
      condition: exists

emits:
  on_complete:
    - key: quality.score
      type: double
      confidence_range: [0.0, 1.0]

  conditional:
    - key: escalation.needed
      when: quality.score < 0.7

lane:
  name: fast
  max_concurrency: 16

defaults:
  quality:
    min_embeddings: 5
    min_entity_confidence: 0.5
    threshold: 0.7
06-escalazioneM SK1yaml:
name: EscalationWave
priority: 20
enabled: true
description: Improves low-quality extractions using LLM

taxonomy:
  kind: proposer
  determinism: probabilistic
  persistence: persisted

input:
  required_signals:
    - escalation.needed

triggers:
  requires:
    - signal: escalation.needed
      condition: exists
  skip_when:
    - signal: budget.exhausted

emits:
  on_complete:
    - key: escalation.complete
      type: boolean
    - key: entities.improved
      type: integer
      confidence_range: [0.7, 1.0]

lane:
  name: llm
  max_concurrency: 2  # Expensive

budget:
  max_duration: 30s
  max_tokens: 4000
  max_cost: 0.05

defaults:
  llm:
    model: gpt-4o-mini
    temperature: 0.1
    prompt_template: entity_extraction
Guardando questi file, sapete immediatamente:
Non è necessario leggere il codice. Il flusso di lavoro è auto-documentazione.
Mentre gli esempi precedenti mostrano le onde completamente declarative YAML, possono anche essere code-a base di atomi Riferito nei manifesti:
name: CustomAnalyzer
priority: 50
enabled: true
description: Custom analysis logic

# Reference a code-based atom implementation
implementation:
  assembly: MyProject.Analyzers
  type: MyProject.Analyzers.CustomAnalyzerWave
  method: AnalyzeAsync

# The manifest still declares the contract
taxonomy:
  kind: analyzer
  determinism: probabilistic

triggers:
  requires:
    - signal: data.ready

emits:
  on_complete:
    - key: analysis.complete
      confidence_range: [0.0, 1.0]

lane:
  name: normal
  max_concurrency: 4

# Configuration values passed to the atom
defaults:
  threshold: 0.75
  max_iterations: 10
L'implementazione del C#
public class CustomAnalyzerWave : ConfiguredComponentBase, IContentAnalysisWave
{
    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string path,
        AnalysisContext ctx,
        CancellationToken ct)
    {
        // Access manifest config
        var threshold = GetParam<double>("threshold", 0.75);
        var maxIterations = GetParam<int>("max_iterations", 10);

        // Custom logic here
        var result = await PerformComplexAnalysis(path, threshold, maxIterations);

        return new[]
        {
            new Signal
            {
                Key = "analysis.complete",
                Value = result.Score,
                Confidence = result.Confidence,
                Source = Name
            }
        };
    }
}
Benefits:
Questo approccio ibrido vi permette di scoprire il flusso di lavoro declarativo mantenendo la logica complessiva in C#. mantenibile.
La struttura del manifesto rende banale generare visualizzazioni:
graph TD
    DOC[document.uploaded] --> FT[FileTypeDetector<br/>Priority: 100<br/>Lane: fast]
    FT --> EXT[file.extension]

    EXT --> CH[ChunkingWave<br/>Priority: 80<br/>Lane: normal]
    CH --> CHUNKED[document.chunked]

    CHUNKED --> EMB[EmbeddingWave<br/>Priority: 60<br/>Lane: normal]
    CHUNKED --> ENT[EntityExtractionWave<br/>Priority: 60<br/>Lane: normal]

    EMB --> EMBGEN[embeddings.generated]
    ENT --> ENTEX[entities.extracted]

    EMBGEN --> QC[QualityCheckWave<br/>Priority: 40<br/>Lane: fast]
    ENTEX --> QC

    QC --> QSCORE[quality.score]
    QC -.conditional.-> ESC_NEED[escalation.needed]

    ESC_NEED -.-> ESC[EscalationWave<br/>Priority: 20<br/>Lane: llm]
    ESC --> ESC_DONE[escalation.complete]

    style DOC stroke:#339af0
    style FT stroke:#51cf66
    style CH stroke:#51cf66
    style EMB stroke:#51cf66
    style ENT stroke:#51cf66
    style QC stroke:#ffd43b
    style ESC stroke:#ff922b
Questo diagramma è stato generato programmaticamente dai manifesti YAML - nessun disegno manuale.
Una proprietà inaspettata di StyloFlow è che crea un sistema. I LLM possono ragionare in modo sicuro..
La maggior parte dei tentativi di usare LLM per la debugging o l'orchestrazione falliscono perché il sistema in cui sono stati lanciati è opaco.
StyloFlow fa l'opposto. Espone , fatti immutabili su quello che è successo quando e con quale fiducia.
Questo rende i Code LLM davvero utili — non come attori, ma come Gli analisti.
In StyloFlow, un LLM mai:
Invece, viene dato un La visuale SignalSink e ha fatto domande come:
Esempio di input per un codice LLM:
{
  "operation": "doc-123",
  "signals": [
    { "key": "document.chunked", "value": 12, "confidence": 1.0, "source": "ChunkingWave" },
    { "key": "entities.extracted", "value": 4, "confidence": 0.42, "source": "EntityWave" },
    { "key": "quality.score", "value": 0.39, "source": "QualityCheckWave" },
    { "key": "escalation.needed", "source": "QualityCheckWave" }
  ]
}
Che' non è un flusso log. cheM SK2 è una Il substrato di ragionamento..
Un codice LLM può ora:
Tutto senza essere affidato. Lo stesso vale per le persone che vivono in Africa. qualsiasi cosa.
Il debugging tradizionale "LLM" cerca di riprodurre il mondoM SK2
"Qui,'è il codice e alcuni log,,che cosa è andato storto?
Il debugging di StyloFlow è più semplice:
"Qui c'è lo stato preciso del sistema osservatoM SK1
Poiché i segnali sono immutabili e posseduti, non c'è bisogno di rifare'non c'é bisogno di ripristinareM SK2fare qualsiasi cosa . Non c'e' bisogno di ricostruire l'intenzioneMSC5 Non ci è bisogno del LLM per indovinare.
Le ragioni del LLM su fatti di cui si fida già.
Questo funziona solo a causa dei limiti rigidi:
Non c'è un ciclo di riscontro in cui il LLM "dece " il passo successivoM SK2 Al massimo, proponge spiegazioni o suggerimenti di configurazione che una politica umana |(o deterministica | ) possa essere applicata più tardi.
L'assimmetria è deliberata.
Una volta che i segnali,confidenzaM SK1 e i risultati sono espliciti, voi Possiamo fare un po' di più. più tardi:
Niente di questo richiede che un LLM faccia funzionare il sistema.
Il LLM diventa un Una lente diagnostica., non è una superficie di controllo
StyloFlow non rende solo i sistemi probabilistici sicuri.
Le rende così. legabile. — agli esseri umaniM SK1 per i test, e ai LLM — senza arrendersi al controllo
Che ' è la differenza tra :.
Solo una di quelle scale.
1. Composizione dichiarativa
I componenti dichiarano i loro contratti (triggeriM SK1 segnali , budgetMSC3 non le loro dipendenze. Il sistema calcola l'ordine di esecuzioneMST5 Questo non èMSSK6non è una caratteristica ♫- è MST8 è quello che succede quando si fanno i segnali in primo luogoMSR9classeMSL10
2. Osservabile per default
Ogni azione è un segnale. Non aggiungiamo l'osservabilità'non aggiuniamo la osservabilità - è inerenteM SK3 è intrinsecamente+. La traccia completa dell'esecuzione*, il tracciamento della fiducia, le traiettorie di escalazione*, e il consumo di budget scende naturalmente.
3. Implementazione adattativa
I punteggi di confidenza guidano l'affiliazione senza una logica di routing esplicita. Passare stadi costosi quando non è necessarioM SK1 escalare in caso di incertezza, abortire presto al massimoMSC3 fallimenti di fiduciaMST4 Il flusso di controllo emerge da schemi di segnaliMSM5
4. Testabilità senza modellare strutture
I segnali di mocca, non i componenti:
var context = new AnalysisContext();
context.AddSignal(new Signal
{
    Key = "document.chunked",
    Value = 10,
    Confidence = 1.0,
    Source = "Test"
});

var wave = new EmbeddingWave();
var results = await wave.AnalyzeAsync(path, context, ct);

Assert.Single(results);
Assert.Equal("embeddings.generated", results.First().Key);
5. complessità crescente
Iniziare semplice:
var coordinator = new EphemeralWorkCoordinator<Job>(ProcessAsync);
Aggiungere segnali quando necessario:
new EphemeralOptions { Signals = signalSink }
Add waves for multi-stage:
var waveCoordinator = new WaveCoordinator(waves, profile);
Aggiunge manifesti per la configurazione declarativa:
name: MyWave
triggers: [...]
emits: [...]
Qui'è il completo. lucidRAG pipeline a un'occhiata ( Vedete gli esempi di codici dettagliati nella sezione "Use CaseM SK2 lucidRAG Document Processing"
document.uploaded Il segnale.file.extension Il segnale.text.extracted Il segnale.document.chunked Il segnale.embeddings.generated Il segnale.entities.extracted Il segnale.quality.score Il segnale.escalation.complete Il segnale.storage.complete Il segnale.L'interfaccia utente subscrive al SignalSink per le aktualizzazioni reali di progresso -time (push pattern):
// Subscribe to sink for push notifications
signalSink.Subscribe(signal => {
    if (signal.Key.StartsWith("document."))
    {
        await _hub.Clients.User(userId)
            .SendAsync("DocumentProgress", new
            {
                stage = signal.Key,
                progress = CalculateProgress(signal),
                operationId = signal.OperationId
            });
    }
});
Oppure usate il modello di attivazione se preferete il sondaggio:
// Query SignalSink for document progress (pull pattern)
var documentSignals = signalSink.GetSignals()
    .Where(s => s.Key.StartsWith("document.") &&
                s.Timestamp > lastCheck);

foreach (var signal in documentSignals)
{
    UpdateProgressUI(signal);
}
Punto chiave: Si sottoscrive al SINK ( che vede tutti gli atomi), non ad operazioni individuali . I segnali degli atomi stessiM SK3 il sink fornisce un'impulso (ScriviMSC5 e tira (questionareMST7 l'accesso a loroMst8
Ecco come. lucidRAG processa i documenti, dati, e le immagini attraverso un segnale unificatoM SK2prodotto di tubatura - combinazione DocSummarizer, DataSummarizer, e ImageSummarizer sotto una sola strata di orchestrazione.
Qui'è il completo. Stylobot pipeline a un'occhiata (Vede il codice dettagliato in "EscalationM SK2 Da veloce a completo"):
bot.detected Un segnale con fiducia.bot.detected Il segnale.bot.detected Il segnale.Il beneficio chiave: escalazione basata sulla fiducia.
// ❌ Traditional: Every request gets expensive analysis
var reputation = await CheckIpAsync(ip);
var behavior = await AnalyzeBehaviorAsync(session);  // Even if IP is known bad
var llmScore = await LlmAnalysisAsync(conversation);  // Always expensive

// ✅ StyloFlow: Waves run based on confidence signals
// BehaviorAnalysis only runs if confidence is ambiguous (0.4-0.7)
// LLM analysis only runs if still unsure after behavior check
Frazione dei costi: Costi di controllo IP $0 e corrisponde a 100% del tempo. Analisi comportamentali corrispondono a ♫30% ♫ ( casi ambiguiM SK5 Analizie LLM corrispondente a |5% | ( ancora ambiguoMSC8 Costo totale per richiestaMSL9 $0.0001 contro il naïvo "LLM tutto" a $0.002 (20x risparmioM SK1
| Carattolo | StyloFlow | Temporal S | Flusso d'aria M | Funzioni di passo R | ||||||
|---|---|---|---|---|---|---|---|---|---|---|
| Coordinazione | SignaleM SK1 guidato | RPC- basato | DAG \ - basata | macchina di stato | |||||||
| Declarativo | ✅ Manifesti YAML | ❌ | Code-first ♫ | ♫ ✅ DAGs ♫ | ||||||
| Condizionale | ✅ Triggeri del segnale | ✅ Condizioni S | \ ✅ Avvicinamento M | ♫ ✅ Stanze di scelta R | ||||||
| Escalazione | ✅ Costruito-in | |||||||||
| Osservabilità | ✅ Tracce del segnale | ✅ | storia del flusso di lavoro | МSK5 | Log dei compiti | |||||
| Controllo del budget | ✅ TokenM SK2limiti di costi | \❌ Manuale S | ❌ manuale | |||||||
| L'esecuzione locale | ✅ In-processo | \❌ Richiede un gruppo di dati | 5 | 6 | Richieda un gruppo | 7 | 8 | AWS solo | 9 | |
| corsie di competizione | ✅ Rapido/NormaleM SK3LLM | \❌ Instruzione manuale |
Dove questo modello si adatta naturalmente:
Dove non va't (and wonM SK2tMSC3
Questi sono estensioni naturali del modello, non impegni di applicazione specifica.
Mentre la semantica si stabilizza attraverso lo sviluppo di lucidRAG e Stylobot, questi modelli diventano fattibili:
1. Imparare dai segnali
Tracciare quali percorsi di escalazione funzionano meglio:
// Did the LLM escalation improve accuracy?
// Learn to skip it if behavioral analysis is sufficient
2. ottimizzazione dei costi
Assignazione automatica di corsie basata sulla performance storica:
// If a "slow" wave completes quickly, promote to "normal"
3. Ripetizione del segnale
Debuggere trasmettendo sequenze di segnali:
var replay = SignalReplay.FromFile("trace.jsonl");
await coordinator.ReplayAsync(replay);
4. Multi-Coordinazione delle macchine
Distribuire corsie tra le macchine mantenendo i segnali centralizzati.
Il punto di vista principale è questo. nei sistemi AI, ogni componente ha fiducia..
I flussi di lavoro tradizionali assumeno il successo/failure.I flussi del lavoro dell'IA sono necessariM SK2
I segnali lo forniscono naturalmente:
// Multiple detectors vote
var signals = context.GetSignals("bot.detected");

// Aggregate by confidence
var verdict = signals
    .OrderByDescending(s => s.Confidence)
    .First();

// Or majority vote
var isBot = signals
    .Count(s => (bool)s.Value) > signals.Count() / 2;

// Or weighted average
var score = signals
    .Sum(s => (bool)s.Value ? s.Confidence : -s.Confidence)
    / signals.Count();
Ecco perché StyloFlow funziona bene per RAG ridotto - ogni fase di estrazione produce un punteggio di fiduciaM SK1 e la sintesi avviene solo quando la fiducia è abbastanza alta.
Il modello di esecuzione:
Perché i segnali contano:
Implementazioni operative:
Article connessi:
Il codice sorgente: GitHub - StyloFlow
I motori tradizionali del flusso di lavoro vi chiedono di dichiarare Cosa succede dopo?. Questo modello chiede ai componenti di dichiarare Quello che producono. e Quello di cui hanno bisogno, poi permette ai segnali di coordinare l'esecuzione
Il cambio chiave: I segnali decouplari, guida di fiduciaM SK1 proteggono le corsie.
Non si tratta di scegliere StyloFlow rispetto a Temporal o Airflow - questi risolvono diversi problemi ( esecuzione durevole, versione del flusso di lavoroMSC4 coordinazione distribuita tra i centri datiM SK5 Si tratta di articolare un diverso modello di orchestrazioneMST6 uno in cui il flusso del controllo emerge da schemi di segnali piuttosto che essere esplicitamente programmatoMst7
Se si stanno costruendo pipelines AI/ML dove?
... allora questa semantica dell'esecuzione potrebbe corrispondere a quello che pensate.
L'informazione figura nella parte dispositiva. biblioteca temporale è la fondazione stabile. StyloFlow aggiunisce il segnale- strato di orchestrazione guidato in cimaM SK2 Entrambi si stanno evolvendo grazie all'uso reale nel lucidRAG e nello Stylobot .
Per domande o feedback, consultate il Reposito di GitHub.

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
