
अधिकतर अल्पपारदर्शिता के निर्माण: एक उत्पाद- पढ़ें (आईएनएमटी संगत) अनुवाद सेवा


परिचय
तेज GAPI कार्यान्वयन आसान MMT के एपीआई की नक़ल करता है (http://smt.com/ULLMT) एक बढ़िया लेकिन तंत्रिका-क्रम परियोजना छोड़ देता है.
लेकिन मैंने इतने सारे अच्छे गुण जोड़ लिए हैं भरोसेमंदता बढ़ाने के लिए और इसे एक उत्पादन प्रणाली में उपयोग के लिए तैयार बनाने के लिए।तेज अनुवाद स्वयं होस्टित सोचो...).
इस ब्लॉग का प्रारंभ होने से, एक बड़ा जुनून ब्लॉग स्वचलित रूप से ब्लॉग्स प्राप्त कर रहा है.
YEES मैं जानता हूँ कि 'Goole यह ब्राउज़र में करता है ... ... लेकिन कि बिंदु नहीं है.mostlylucid-nmtमैं जानना चाहता था कि यह कैसे करें!
इसके अलावा यह उन लोगों का स्वागत करने के लिए अच्छा है जो अंग्रेजी नहीं पढ़ते (तब भी अगर वे अंग्रेज़ी को दूसरी भाषा के रूप में पढ़ते हैं, तो यह विचार करना मुश्किल है).इसलिए मैंने यह काम किया, साथ ही इस तरह की व्यवस्था को बनाने में हिस्सा लेना ।ओह और यह मुझे सुझाव दिया कि कैसे इसे सी.
परेशान रहनामहत्त्वपूर्ण रूप से; मनुष्य बकवास का पाठ लिखता है जो मशीनों को कुशलता से काम करने के लिए शोर मचा रहा है.
सो बहुत सारे लोगों को यह पता चल गया था कि आसानNMT (यह वास्तव में एक शोध परियोजना कभी थी) के आसपास कैसे कार्य करना है।


जो दोनों मुझे विकसित करने के साथ साथ साथ साथ ही आप एक खेलने के लिए एक रास्ता करते हैं।
आईपूरा तंत्र लिखा हैhttp://<server>:<port>/demoकि एक अद्भुत परियोजना के साथ ऐसा करने के लिए आसान MNMT कहा जाता है।
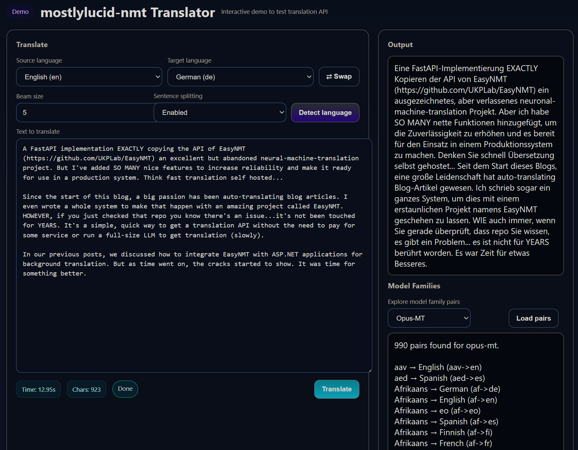
कैसे, अगर आप सिर्फ है कि Rococ की जाँच की तो आप जानते हैं कि वहाँ एक मुद्दा है ... यह साल के लिए छू नहीं किया गया है।
यह एक सरल, बिना किसी सेवा के भुगतान की जरूरत के लिए एक अनुवाद एपीआई प्राप्त करने के लिए त्वरित तरीका है या पूर्ण आकार की एक पूर्ण मात्रा में भाग लेने के लिए अनुवाद (धीमा रूप से).
हमारे पिछले पोस्टों में, हमने चर्चा की कि किस तरह एन.एस.
**लेकिन जैसे - जैसे समय बीता, दरारें दिखाने लगीं ।**यह कुछ बेहतर करने के लिए समय था.
**हमेशा के रूप में यह सब GiHh पर है और सभी को उपयोग करने के लिए मुक्त...**डॉक ले-आउट
- ✓ कोपी:
Reusing loaded model for en->de (3/10 models in cache) - ✗ खेयू-मिन:
Need to load model for en->fr (3/10 models in cache) - जीपीजीपी-मिन
- **डेमो... हाल ही में डेमो पृष्ठ के लिए देखें!**एक भरा हुआ चित्र (सबसे ज्यादा) अंतःक्रियात्मक डेमो पृष्ठ
- **(पैंट)**सिर्फ रूट
- **नया क्या है?**जल्दी शुरू करने से पहले, यहाँ क्या है इस संस्करण खेल को बदलने के लिए:
गुरू अद्यतन (v3. 1) - प्रत्यक्ष व दृश्यताv3 में नया:
- **नए संस्करण में पूरी ईमानदारी, प्रदर्शन, और बुद्धिमान मॉडल चयन के लिए बहुत सुधार आते हैं!**1 ..
- दृश्यता के साथ स्मार्ट मॉडल कैशिंग- देखो क्या हो रहा है:
- कैश एचआईडी लॉगिंगकैश लॉगिंग
- कैश स्थिति ट्रैक किया जा रहा है: सेवर्सेशन प्रतिशत तथा लोड मॉडलों को दिखाता है
- कनेक्शन चेतावनियाँ: जब कैश भर दिया जाता है और मॉडलों को निकाल दिया जाता है तो साफ नज़र आता है
- बढ़ती हुई क्षमता:
====================================================================================================
  🚀 DOWNLOADING MODEL
  Model: facebook/mbart-large-50-many-to-many-mmt
  Family: mbart50
  Direction: en → bn
  Device: GPU (cuda:0)
  Total Size: 2.46 GB
  Files: 6 main files
====================================================================================================
[Progress bars for each file...]
====================================================================================================
  ✅ MODEL READY
  Model: facebook/mbart-large-50-many-to-many-mmt
  Translation: en → bn is now available
====================================================================================================
**: डिफ़ॉल्ट कैश आकार 10 मॉडलों में ( 6 से)**पर- संपूर्ण उपकरण लॉगिंग
- : देखें कि कौन सा जीयूयूयूयू/ सीपीयू हर मॉडल उपयोग करता है2
- उन्नत डाउनलोड प्रगति- कोई और सोच नहीं अगर यह अटक गया है:
- डाउनलोड पहले आकार:
[Pivot] Languages reachable from en: 85 languages [Pivot] Languages that can reach bn: 42 languages [Pivot] Found 38 possible pivot languages [Pivot] Selected pivot: en → hi → bn (both legs verified) - **: कुल डाउनलोड आकार (उदा. ttal आकार: 246 GB")**फ़ाइल गणना
- डाउनलोड करने के लिए फ़ाइलों की संख्या प्रदर्शित करेंउपकरण प्रदर्शन
ध्वज में लक्ष्य उपकरण (जीपीयू/ सीपीपीयू) दिखाता हैप्रगति पट्टी
- **: प्रत्येक फ़ाइल के लिए सुन्दर टीजेएम प्रगति (सही पर)**पूर्णता ध्वज
- : जब मॉडल तैयार हो तो सफलता संदेश साफ करेंउदाहरण आउटपुट
- 3:
Request: en→bn with opus-mt
Trying families: ['opus-mt', 'mbart50', 'm2m100']  ✓ All three!
opus-mt: Failed (model doesn't exist)
mbart50: Success! (auto-fallback worked)
डाटा- ड्राइव इग्नॉमी चयन- अब और कोई अंधा प्रयास नहीं:
- स्मार्ट प्रतिच्छेदन तर्क
Loading mbart50 model on GPU (cuda:0) - : जहाँ दोनों पैर होते हैं वहाँ भाषा ढूंढें
Model loaded on device: cuda:0 - असफलताओं से दूर रहें
Successfully loaded... on GPU (cuda:0)
**: अगर ईमेल उपलब्ध नहीं है तो दर्ज न करें BAR**SSLSUPE (S) के लिए उदाहरण
- फालबैक प्राथमिकता
en->hi,hi->bn - : अंग्रेजी खुशखबरी का प्रचार करना
- पारदर्शी लॉगिंग
[Pivot] Both legs loaded and cached. Ready to translate.
: देखिए कि क्यों हर पिक्चर चुना गया या छोड़ दिया गया4.
- स्थिर फालबैक
-
- और कोई डबल-टी नहीं:
model_familyहमेशा चेकर्स की कोशिश करता है
- और कोई डबल-टी नहीं:
- : अगर पसंदीदा परिवार को "मान" जोड़े का समर्थन करे
एकल प्रयास प्रति परिवार
: एक ही मॉडल को दो बार फिर बदलने की कोशिश नहीं कर रहाउदाहरण प्रवाह
-
- जीपियू अव्याष्टता
-
- हमेशा अपने मॉडल कर रहे हैं जहां पता है:
- प्रत्येक मॉडल लोड दिखाता है:
- लोड करने के बाद पुष्टि करता है:
**सफल संदेश इसमें शामिल है:**6.
- बिंदु धुरी कैश- इफ़िक परिपथ रीफ्ट:
- **बहुमुखी कैश के दोनों पैरों को अलग से:**अगली बार एनही या हायकेन की जरूरत है, तत्काल कैश हिट!
- **लॉगिंग साफ करें: (n)**7.
- पर- रीस्ट मॉडल चयन
**- पहले से ही डेमो में काम करता है:**डेमो ड्रॉपेज़ द्वारा चुनने की अनुमति देता है थिऑप्टस, mbt50, या m210100
- बैकेंड गुण
- पैरामीटर प्रति निवेदन
- तत्काल स्विच के लिए मॉडल कैश्स परिवार द्वारा अलग से बदला गयाName
- गुरू अद्यतन (v3.0)
- 1 ..
requirements-prod.txtउन्नत डेमो पृष्ठ
**- उत्पादात्मक इंटरफेस:**उन्नत अनुवाद अनुभव के लिए पूरा व्यूपोर्ट खाका (100वी/100वीप)
- **उचित रूप से उन्हें ड्रॉप डाउनेस चयन (स्टूकी इनपुट/ डाटा सूची)**लाइव मॉडल परिवार स्विच (ओकर- एम- एम- एम- एमईटी, एम2M100)
- चयनित मॉडल पर आधारित गतिशील भाषा लोड करनाबड़े अनुवादों के लिए विशिष्ट आउटपुट क्षेत्र
- 2परफ़ॉर्मेंस- निर्मित डिफ़ॉल्ट
-
- "तेज जितनी जल्दी हो सके" बॉक्स से बाहर:
- जीपीयू
**: FP16 सक्षम किया गया है, BATHITH/64, MAX_BAR_FLLCH1 (एक ही गापिपीयू के लिए सरल)**सीपीयू
- : WB_CONTCTCY =4, MAX_BAR_STH(सभी कोचते हुए)
- फास्ट बन्द करें
- : 5-second-zone समय (कोई 20-सेकेंड में)
- बिना किसी डरवाले संदेश के साफ - सफाई करना बंद कर देता है
- 3
- उत्पादों का पीछा करने से निराशा ही हाथ लगती है
**- छोटा, तेजी से छवियाँ:**निर्माण से जाँच निर्भरता को मिटाया जा रहा है.
- ~200MB प्रति छवि को सहेजता हैसीपीयू छवियों: ~8-10GB (पूरा), ~3- 4GB (मिन)
- **जीयूपी छवि: ~12-15GB (पूरा), ~6-8GB (मिन)**सभी उपयोग
- न्यूनतम फुट छपाई के लिए4.
फिर से जाँच करें (L)- सबकुछ पुष्टि करें:
- GConf जाँच सूट
- स्वास्थ्य, अनुवाद, पता लगाने के लिए (30+ जाँच)
- के6 टेस्ट लोड किया जा रहा है
ट्रैफिक पैटर्न के साथक्रास- कम्प्लीशन स्क्रिप्टGenericName
/discover/opus-mt(स्टिंदल + बा)/discover/mbart50मॉडल डाउनलोड करने और कम्प्लीशन अनुवादच करने के लिए जाँच/discover/m2m100तुरंत वैध करने के लिए धूम्रपान जाँच स्वचालित करें
**5.**डेकोमेंट दस्तावेज़ीकरण
-
- एक दिन से उत्पादों को तैयार:
- 4 म्यूटिंग स्थिति: अधिकतम म्यूट, कम विस्तार, उच्च सफाई, स्मृति-पुष्टि
- डॉकर निर्माण उदाहरण जीयू/ सीपीयू कॉन्फ़िगरेशन के साथ
सेवर्स PVC, संसाधन सीमा, स्वास्थ्य जाँच के साथ प्रकट होता हैएक्जेंज कंटेनर उदाहरण
scottgal/mostlylucid-nmt:cpuदेखने की सलाहें लोड करें तथा मुक़र्रर करने की सलाह को लोड करें:latestलेन- देन के माध्यम से अप्रचलता वी.scottgal/mostlylucid-nmt:cpu-min6.scottgal/mostlylucid-nmt:gpuतीन मॉडल परिवारscottgal/mostlylucid-nmt:gpu-min- अपनी जरूरतों के लिए सबसे अच्छा चुनें:
ऑपुस- एमटी: 1200+ जोड़े, उत्तम क्वालिटी (उदाहरण के लिए मॉडल)
- मि.50
latest,min,gpu,gpu-min: 50 भाषाएँ, एकल 2.4GB मॉडल, 2,450 जोड़े - एम2M100
20250108.143022: 100 भाषाएँ, एकल 10, 1200 मॉडल, 9900 जोड़े -
स्वतःफ़बैक- मैं समझदार रूप से सबसे अच्छा उपलब्ध मॉडल चयन:
- **प्राथमिक परिवार नियत करें (जैसे कि, ऑप- एम- एमटी क्वालिटी के लिए)**यदि जोड़ा अनुपलब्ध हो तो BART50/M2M100 की कोशिश करें
- बिना चढ़ाए अधिकतम विजुअल विशेषता के8
- मॉडल खोज- गतिशील रूप से क्वैरी उपलब्ध मॉडल:
-
- Harging चेहरा से सभी 1200+ जोड़े
- सभी mem50 जोड़े- सभी एम2M100 जोड़े
-
- न्यूनतम छवियाँ
- छोटा, जावा तैनातिंग:
कोई पूर्व मॉडल लोड नहीं (अनुत्रित होने पर)
वॉल्यूम- एसडीडी कैश
मॉडल परिवार का निर्माण किए बगैर स्विच करें10एकल डॉकer रेपोसिटरी
- सभी चरें एक जगह:
|-----|-----------------|------|-------------|----------|
|
cpu(याlatest) |scottgal/mostlylucid-nmt:cpu) - सीपीयू |cpu-min|scottgal/mostlylucid-nmt:cpu-min- सीपीयू न्यूनतम |gpu|scottgal/mostlylucid-nmt:gpu- जीयूएडी 12.6 के साथ |gpu-min|scottgal/mostlylucid-nmt:gpu-min- गायू अल्प
**११.**सही संस्करण
-
- सभी छवियों में तारीख का संस्करण शामिल है:
- नामित टैग (n)
- ) हमेशा अधिकांश हाल के निर्माण का बिन्दु
- xmmt संस्करण टैग (उदा.
) विशिष्ट पोषण के लिए
ट्रैक करने के लिए पूर्ण OCI लेबल, तिथि बनाएं, और gititly करता है
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  scottgal/mostlylucid-nmt
12.
curl -X POST "http://localhost:8000/translate" \
  -H "Content-Type: application/json" \
  -d '{
    "text": ["Hello, how are you?"],
    "target_lang": "de"
  }'
नवीनतम आधार छवियाँ
{
  "translated": ["Hallo, wie geht es Ihnen?"],
  "target_lang": "de",
  "source_lang": "en",
  "translation_time": 0.34
}
- सुरक्षा और प्रदर्शन सुधार:
पायथन 3. 12-lsm
docker run -d \
  --name mostlylucid-nmt \
  --gpus all \
  -p 8000:8000 \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu
सीपीयू छवियों के लिए (पतात्स 3.11 vibirents)
सीयूडी 12.6
USUPINATHA ढेर के लिए उबुन्टू 24. 04 के साथ
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  -v $HOME/model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  scottgal/mostlylucid-nmt:cpu-min
सीयूयूडी १२४ के साथ पिकण्ड
docker run -d `
  --name mostlylucid-nmt `
  -p 8000:8000 `
  -v ${HOME}/model-cache:/models `
  -e MODEL_CACHE_DIR=/models `
  scottgal/mostlylucid-nmt:cpu-min
(एयूडी 12.6 बन्द के साथ संगत)
docker run -d ^
  --name mostlylucid-nmt ^
  -p 8000:8000 ^
  -v %USERPROFILE%/model-cache:/models ^
  -e MODEL_CACHE_DIR=/models ^
  scottgal/mostlylucid-nmt:cpu-min
सभी डिपेंडेंसीज़ अद्यतन किया गया सुरक्षित संस्करण में
13
curl http://localhost:8000/healthz
स्थिर घोषणा चेतावनियाँ
- भविष्य- रोधी:
मिटाई गई ट्रांसमिट्स_ COCTE (अब HF_ इनपुट का प्रयोग करते हुए)रूपांतरण करनेवालों के साथ स्वागत है v5त्वरित प्रारंभ (५ मिनट)
http://localhost:8000/demo/
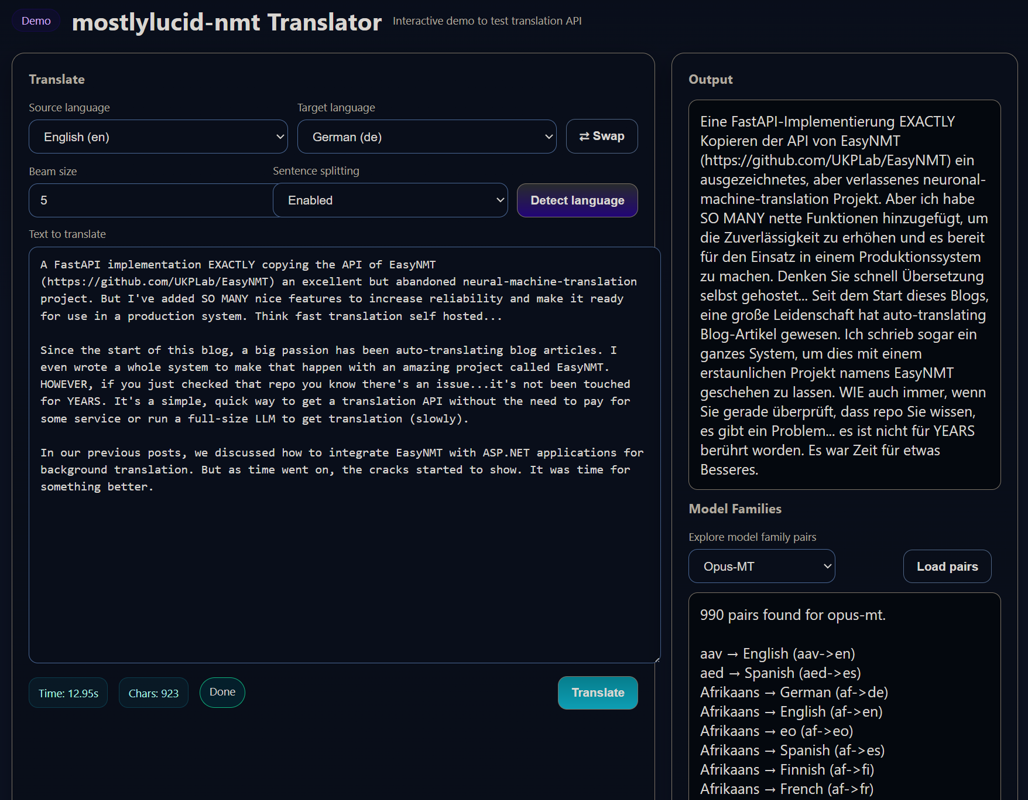
यहाँ सबसे आसान तरीका है ज्यादातर को चलाने के लिए:
उपलब्ध डॉकर छवियाँ
- सभी भिन्नताएँ उपलब्ध हैं
- एक भंडार
- भिन्न टैग के साथ:
IMTANT टैग पूर्ण छवि नाम अवैध है.
- (या
- IMTARE( 12. 42GBz), श्रोत कोड गैर संस्करण गैर संस्करण विडक सीपीयू तैनाती के साथ
- पारितोषिक ~1. 5GBz सीपीयू न्यूनतम, कोई पूर्वीकृत मॉडल Conscram-m कैश, लंबवत
- UUNA 12.6 + स्रोत 0. 4 उत्पादन जीयून के साथ यूयूपीजीजीजीजीजीजी जीयूपीजीजीजीजीजीजीजीजीजीजी जीयू
- IMSUPRE( 4 POPह), कोई पूर्व मॉडल लोड नहीं किया गया UNPPED के साथ
न्यूनतम छवियाँ
- इसके लिए अनुशंसित किया गया:
- मात्रा-मित कैश के साथ उत्पाद तैनात किया जा रहा है
- एमआईटी50 या एम2M100 का उपयोग कर रहा है (सभी बड़े मॉडल)
कंटेनर आकार छोटा रखना
- मॉडल परिवार को दोबारा बनाने के बिना स्विच करने की क्षमतासमान्य प्रारंभ (ओएयू- एमटी सीपीयू)
- 1 ..
- खींचो और चलाना:
- 2कुछ पाठ अनुवाद करें:
- अनुक्रिया:
- जीयूपीयू ने सुधार किया (१०x तेज)
NVIDIA डॉकर की जरूरत है:
- संपूर्ण मॉडल कैश के साथमॉडलों को एक बार डाउनलोड करें तथा टोकरी को पुनः प्रारंभ करते रहने दें:
- **लिनक्स/Mac:**विंडोज़ (स्टेल):
- **विंडोज़ (सीएम):**मॉडल को प्रथम प्रयोग में स्वतः डाउनलोड किया जाता है तथा आपके स्थानीय डिरेक्ट्री में बना रहता है!
स्वास्थ्य जाँच:
- यही कारण है कि 5 पाउंड जल्दी शुरू है!
- **उत्पादन तैनातिंग, विन्यास, और विस्तृत विशेषताएँ, पढ़ने के लिए.**इंटरएक्टिव डेमो पृष्ठ
- सेवा में पूर्ण विस्तार शामिल हैअंतर्क्रियात्मक डेमो पृष्ठ
- **इससे बाइबल के किसी भी कोड को लिखने के बिना अनुवाद करना आसान हो जाता है ।**इसे एक्सेस करें:
- डेमो विशेषताएँ
डेमो पृष्ठ संपूर्ण अनुवाद जांच वातावरण को इस प्रकार प्रदान करता है:
1 ..
// Example: Translating a 5000-word article
Input: Long article with multiple paragraphs

Step 1: Split by paragraphs (preserves structure)
  → Paragraph 1 (800 chars)
  → Paragraph 2 (1200 chars)
  → Paragraph 3 (600 chars)
  ...

Step 2: Group into ~1000 character chunks
  → Chunk 1: Paragraphs 1-2
  → Chunk 2: Paragraph 3-4
  → Chunk 3: Paragraphs 5-6

Step 3: Translate each chunk sequentially
  → Shows progress: "Translating chunk 1/3..."
  → Shows progress: "Translating chunk 2/3..."
  → Shows progress: "Translating chunk 3/3..."

Step 4: Reassemble with paragraph breaks
  → Final output: Complete translated article with preserved formatting
भाषा चयन
जीवन सेवा से बाहर की भाषा स्वचालित गुप्त है
- बदलें श्रोत लक्ष्य भाषा के साथ एक क्लिक
- सेवा में सभी 100+ भाषाओं को समर्थन देता है
- 2
- स्मार्ट पाठ क्लर्किंग
किसी आकार के बड़े पाठ इनपुट को स्वचालित संभालता है
- चतुर रूप से अनुच्छेदों द्वारा विभाजित, दस्तावेज़ संरचना बनाए गए
- बहुत लंबा अनुच्छेदों के लिए वाक्य विभाजन के लिए वापस गिरता है
- बहु- क्लिंड अनुवाद के लिए प्रगति दिखाता है ("संत्रित 2/5)...
- गंभीर रूप से फिर से एकत्र करनेवाले सही जगह से इकट्ठा होते हैं
3
- भाषा पता लगाएँ
- एक क्लिक से स्रोत भाषा पता लगाएँ
- स्रोत छोड़ा गया स्रोत स्वचालित भरने पर स्वतः भरें
- पाठ के साथ 5000 वर्ण तक काम करता है
4.
विस्तृत विकल्प:
- बेम आकार
- : नियंत्रण अनुवाद गुणवत्ता (1- 10)
- उच्चतर मान = बेहतर गुणवत्ता परंतु धीमा
- निचला मूल्य = तेजी से काट कर
वाक्य विभाजित करना:
- : स्वचालित वाक्य विभाजन को टॉगल करें
- सक्षम (डिफ़ॉल्ट: लंबे पाठ को बेहतर क्वालिटी के लिए वाक्यों में विभाजित करता है)
- अक्षम: संपूर्ण पाठ को एक ब्लॉक के रूप में अनुवाद करता है (छोटे पाठ के लिए निष्क्रिय)
-
रीयल- समय आंकड़े:
- अनुवाद समय
- : वास्तविक सर्वर अनुवाद अवधि दिखाता है
- अक्षर गिनती
- : टाइप्स के रूप में लाइव गणना
स्थिति सूचक
: खाली पाओफ्टिंग गलत/ त्रुटि
- **6.**मॉडल परिवार खोज
- **प्रत्येक मॉडल परिवार के लिए उपलब्ध अनुवाद जोड़े:**ऑपुस- एमटी
- : 1200+ भाषा जोड़ेमि.50
- : 50 भाषाएँ, 2,450 जोड़ेएम2M100
: 100 भाषाएँ, 9900 जोड़ा/demo/असल में देखें कि कौन सी भाषा जोड़ी अनुवाद से पहले उपलब्ध है
पाठ क्योंकर काम करता है
डेमो बुद्धि युक्त पाठ ग्राहक की ओर पलटता है:डेमो क्यों इस्तेमाल करें?जल्दी जाँचकोड संपादक बिना जाँच अनुवादभाषा जोड़े की उपलब्धता लागू करें
भिन्न आकार से अनुवाद गुणवत्ता की तुलना करें
- **किनारे के मामलों को चेक करें (जैसे किमोजी, चिह्न, विशिष्ट अक्षर)**विकास सहायक
- सटीक एपीआई आग्रह/ प्रतिक्रिया फॉर्मेट देखेंपरीक्षण करने से पहले सेवा स्वास्थ्य को जांचिए
- भिन्न पाठ आकारों के साथ टेस्ट प्रदर्शनउपलब्ध मॉडल परिवार की खोज
- क्लाएंट संदर्भउचित एपीआई उपयोग पैटर्न दिखाता है
- **प्रदर्शन त्रुटि (429, भाषा जांच)**कार्यान्वयन का उदाहरण
- रीयल-world तर्क फिर कोशिश करेंउदाहरण उपयोगसरल अनुवाद.
- **पाठ चिपकाएँ: "हे, तुम आज कैसे हो?"**चुनें लक्ष्य: जर्मन
- **क्लिक करें "कंटेनेंस"**परिणाम: "Hallo, hallegen Hen Hen Helen Hele?
लंबे दस्तावेज़ अनुवाद
पूरा ब्लॉग पोस्ट चिपकाएँ (5000+ शब्दों)डेमो स्वचालित रूप से उसे हल कर देता हैहर अनुवाद में प्रगति दिखाता है
संग्रह दस्तावेज़ को पूरी तरह से पलटता है
भाषा पता लगाएँअज्ञात भाषा में पाठ चिपकाएँ"एक शब्द का पता लगाने के लिए" क्लिक करें
डेमो भाषा की पहचान कराता है तथा अपडेट छोड़ देता है
- तुरंत अनुवाद करने के लिए तैयारतकनीकी विवरण
- **डेमो पृष्ठ है:**स्व- केंद्र रखे हुए
- अंतर्निर्मित जावास्क्रिप्ट के साथ एकल एचटीएमएल फ़ाइलशून्य डिपेंडेंसीज़
- : कोई बाहरी लाइब्रेरी नहीं जरूरीमोबाइल- कार्डName
- : डिजाइन सभी उपकरणों पर काम करता हैउत्पाद तैयार
- : उसी से हटाने वाली तर्क का उपयोग आपके apps में किया जा सकता हैजीवित डेमो को यहां तक पहुंचें
आप चल रहे उदाहरण पर!
- आसानMMT के साथ समस्याएँअब इस पर डंपिंग नहीं है
- आसान-एनएमटीयह इतना कुछ और नहीं हो सकता था और मैं बनाया गया है
- इसका प्रयोग कर परियोजनाओं का एक सहायक
- **यह सिर्फ दाँतों में लंबे समय हो रही है तो ... हम क्या समस्या है?**ओह, वहाँ कई है.
- **आसान MNMT लगभग एक दशक पहले बनाया गया था.**प्रौद्योगिकी पर प्रेरित किया गया है ...preus यह एक उत्पादन व्यवस्था होने का इरादा कभी नहीं किया गया था.
- **यहाँ कुछ मुद्दों में से हैं:**यह चला जाता है ... एक खराब.
यह मुद्दों से ठीक करने के लिए बनाया नहीं है तो अक्सर बस खत्म हो जाता है.
- **यह अपने इनपुट के बारे में PICKY है.**इमोटिकॉन्स, चिह्न, यहाँ तक कि संख्याएं भी इसे उलझन में डाल सकती हैं.
- **यह किसी लोड के लिए डिजाइन नहीं है.**ऊपर देखें.
- **यह कभी नहीं बनाया गया था.**यह अपने मॉडलों को अद्यतन करने के लिए डिजाइन नहीं है
- या फिर उस वक्त (दुश्मन के) दिल में घुस जाते हैंइसका जीपीयूएडी सामान प्राचीन है
- **इससे धीमा होने की जरूरत है.**आप कुछ ठीक नहीं कर सकते.
- पायथन कोड रीपो पर है लेकिन फिर सेबड़ा नहीं
**कोई पीछे या कतार में नहीं.**बहुत से निवेदन भेजें और यह सिर्फ केल पर.MODEL_FAMILYकोई ब्लॉरवमेंटता नहीं है.
# Opus-MT (default, best quality)
MODEL_FAMILY=opus-mt

# mBART50 (50 languages, single model)
MODEL_FAMILY=mbart50

# M2M100 (100 languages, broadest coverage)
MODEL_FAMILY=m2m100
जब बातें ग़लत हो जाती हैं, तुम अंधे हो.
समाधान: सबसे अधिक विधि- nMTतो ... मैं एक नया और आसान आसान MMT बनाने का फैसला किया, अबअधिकतर- nmd- tud
- यह सिर्फ एक पैच काम नहीं है, यह मन में उत्पादन के साथ एक पूरी फिर से फिर से लिखना है.
MODEL_FAMILYयह क्या बेहतर बनाता है:opus-mtमल्टी- मॉडल परिवार समर्थन - सबसे अधिक एलआईडीडी- एनएमटी अब समर्थन
- तीन अनुवाद मॉडल परिवार
- , अपनी ज़रूरतों पर आधारित आपको फेरबदल करने के लिए:
Exeus- एमटी (हेलसिंकी- NLP) - डिफ़ॉल्ट
# Set primary to Opus-MT (best quality)
MODEL_FAMILY=opus-mt
AUTO_MODEL_FALLBACK=1
MODEL_FALLBACK_ORDER=opus-mt,mbart50,m2m100

# Request Ukrainian → French
# 1. Try Opus-MT first (not available)
# 2. Automatically fall back to mBART50 (available!)
# 3. Translation succeeds with mBART50
कवरेज:
- 150+ भाषाओं के लिए 1200+ अनुवाद जोड़ायू. एस.
- संपूर्ण मॉडल प्रति अनुवाद दिशा में अलग करेंविशेषताः
- कुल मिलाकर अनुवाद का बढ़िया गुणकेस इस्तेमाल करें:
- उत्पादों का अनुवाद जहाँ गुण मामले होते हैंमॉडल आकार:
300-00MB प्रति दिशा
# Enable auto-fallback (default: enabled)
AUTO_MODEL_FALLBACK=1

# Set fallback priority (default: opus-mt → mbart50 → m2m100)
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"

# Disable for strict single-family mode
AUTO_MODEL_FALLBACK=0
उदाहरण:
पूर्वी यूरोप में सजग होइए!
- **BART50 (चेहरा- बुक)**कवरेज:
- 50 भाषाएँ, सभी-से-सभी अनुवादयू. एस.
- एकल अलग-अलग मॉडलविशेषताः
- अच्छे गुण, खासकर मुख्य भाषाओं के लिएकेस इस्तेमाल करें:
- स्पेस-च्ड ऑफ़िसिंग या बहुत सी भाषा जोड़ेमॉडल आकार:
- **~. 4GB (सभी 50 भाषाओं के लिए एक मॉडल)**नुक़सान:
- एक मॉडल 2,450 अनुवाद जोड़ेएम2M100 (चेहरा- बुक)
- **कवरेज:**100 भाषाएँ, सभी-से-पूरा अनुवाद
- **यू. एस.**एकल अलग-अलग मॉडल
- विशेषताःविस्तृत भाषा के विस्तार से अच्छा गुण
- **केस इस्तेमाल करें:**अधिकतम भाषा विस्तार
-minमॉडल आकार:
~.2GB (सभी 100 भाषाओं के लिए एक मॉडल)
नुक़सान:
एक मॉडल ९,९०० अनुवाद जोड़े को संभालता है
स्विच करना आसान है
-
- बस सेट
- वातावरण चर:
- स्वचालित मॉडल परिवार को कालबैक - नये सिरे से!
सबसे शक्तिशाली नई विशेषताओं में से एक है
- मॉडल परिवार के बीच स्वचालित सुधार
- यह निश्चित करता है कि अनुवाद गुणवत्ता को बढ़ाने से पहले अधिकतम भाषा जोड़े को पूरा करें ।
**यह कैसे काम करता है:**आपने प्राथमिक सेट किया
- **( ई.**सर्वोत्तम गुणवत्ता के लिए
- जब आप किसी अनुवाद जोड़ा से गुज़ारिश करते हैं कि वह प्राथमिक परिवार में उपलब्ध न होसिस्टम स्वचालित रूप से अगले परिवार को प्रोग्राम के क्रम में की कोशिश करता है
- यह तब तक जारी रहता है जब तक कि उपयुक्त मॉडल नहीं मिलाउदाहरण के लिए:
लाभ:
अधिकतम कवर्टिंगः
बहुत सी तैनाती का प्रबंधन किए बगैर १००+ भाषाओं का समर्थन करता है
- विशेषता प्राथमिकता:
- प्रत्येक जोड़े के लिए हमेशा उत्तम उपलब्ध मॉडल का उपयोग करें
- जीरो कॉन्फ़िगरेशनः
- कार्य स्वचालित करता है, कोई दस्ती हस्तक्षेप आवश्यक नहीं
पारदर्शी लॉगिंग:
- देखें कि प्रत्येक अनुवाद के लिए कौन सा मॉडल परिवार इस्तेमाल किया गया था
- पुष्टिकरण
- यह विशेषता उत्पादन वातावरणों के लिए बिलकुल सही है जहाँ आप बिना त्याग किए अधिकतम विस्तार चाहते हैं!
- कुंजी सुधार
मल्टी- लागू परिवार समर्थन
# NMT: Fits on a USB stick
du -sh model-cache/
2.5G    model-cache/

# LLM: Needs serious storage
du -sh llama-models/
140G    llama-models/
- OOhhus-MT (1200+E), mT50 (50 भाषाएँ), या एम2M100 (100 भाषाओं) से चुनें.
मॉडल खोज अंत- बिन्दु
-
- प्रत्येक परिवार के लिए एचडिफिंग चेहरा से गतिशील प्रश्न उपलब्ध मॉडल.
- रॉबट इनपुट हैंडल
- -मोजी?
- संख्याएँ?
संकेत?
- पर ले आओ.
- इस सेवा में अब व्यापक इनपुटीकरण और प्रतीक मास्किंग शामिल हैं ।
- क़तारबद्ध तथा पीछे- नीचे किए जाने का निवेदन
-
- निर्माण के अंदर-माफ़ॉफ़ॉर्न- आधारित कतार जिसमें बुद्धिमानी से प्रयास करने का अनुमान लगाया गया है।
एलआरयू मॉडल कैशिंग
- जब कैश पूरा हो तो पुराने मॉडल निकाल देने के द्वारा वीरोथ स्वचालित प्रबंधित करता है. |--------|------|------| आधुनिक काडीडी समर्थन
- सीयूडी 12.6, FP16/ BF16 गति सुधार के लिए समर्थित करता है. उत्पादों को तैयार किया जा रहा है
- स्वास्थ्य जाँच, तैयार जांच, कैश स्थिति, संरचना लॉगिंग. विंडो बन्द करें (l)
- अब और कोई अनाथ अनुरोध या खराब स्थिति.
आसानMM- API API
-
- मौजूदा संयोजन के लिए ड्रॉप- इन बदले में.
- बिंदु धुरीलेट
-
- यदि एक सीधी भाषा जोड़ी उपलब्ध नहीं है, तो स्वचलित रास्ते अंग्रेज़ी (या अपनी चुनी गई सीमा के माध्यम से).
- न्यूनतम डॉकर छवि
-
- नया
छोटी तैनातियों के लिए मात्रा-मित कैशों के बीच भिन्नताएँ.
- ⚠️ Sometimes adds interpretations not in original
- ⚠️ Quality varies with prompt phrasing
- ⚠️ Can be "creative" with technical terms
- ⚠️ Needs careful prompt engineering
- ⚠️ Unpredictable with edge cases
अनुवाद के लिए क्यों नैटटी?
Input: "The API returns a 429 status code when rate limited."

NMT (Opus-MT): "Die API gibt einen 429-Statuscode zurück, wenn sie ratenbegrenzt ist."
(Accurate, preserves technical terms)

LLM (might do): "Die API sendet den Fehlercode 429, wenn zu viele Anfragen gestellt werden."
(Interprets rather than translates, adds context not in original)
आप सोच सकते हैं: "एक समर्पित NMMT सेवा का प्रयोग क्यों करें जब GBT4, स्टूल, या Lamama की तरह करते हैं? महान सवाल का अनुवाद किया जा सकता है? "
यहाँ उत्पादन पर आधारित वास्तविकता चेक है:
- गति: 10- 100x तेज
- NMT (सबसे कम से कम- nint):
- सीपीयू: ~.3-0 सेकण्ड प्रति वाक्य
- जीपीयू (एफपी16): - 0. 005- 0. 2 सेकण्ड प्रति वाक्य
- बैच प्रक्रिया: जीपी पर 50+ वाक्य/second-zone
- बिली:
GPT-4: प्रत्येक अनुरोध पर ३- १० सेकण्ड (एक्सविस्तीय + पीढ़ी)
- Lmuma 3 70B: 5-15 सेकंड प्रति वाक्य (ooow)
- स्क्रैच ३: २-8 सेकण्ड प्रति अनुरोध (उण्डीकरण)
- वास्तविक उदाहरण:
- 1000- ब्लॉग पोस्ट ट्रांसमिटिंग:
- अधिकतर अल्पपारदर्शिता- nmt (जीयूपीयू)
: 5- 10 सेकंड
GET-4 एपीआई**: 30-60 सेकण्ड**स्थानीय लाला 70B
- : 2- 5 मिनट
- जब आप अपने कई ब्लॉग पोस्टों को 12+ भाषाओं में पोस्ट कर रहे हैं, तब कि गति में फर्क है.
- मॉडल आकार: 500MB v3GB
- NMT मॉडल:
ऑपस- एमटी (पर दिशा: 300-00MB)
MBART50 (सभी 50 भाषाएँ): 2. 4GBM2M100 (सभी 100 भाषाएँ): 2. 77
100+ भाषाओं के लिए कुल: ~2.2GB
flowchart LR
    A[HTTP Client] --> B[API Gateway]
    B --> C[Translation Endpoint]
    C --> D{Has Capacity?}
    D -->|Yes| E[Translation Service]
    D -->|No| F[Queue with 429]
    F --> E
    E --> G[Process Pipeline]
    G --> H[Get Model from Cache]
    H --> I[Translate]
    I --> J[Return Response]
    J --> A
बिली:
- एलला 3B: ~16GBLmum 3 70B: ~140GB
- व्याकरण 8x7B: ~90GBRS-4: स्वयं के लिए उपलब्ध नहीं है
- **भंडारण प्रभाव:**संसाधन परिवर्धित करें: लैपटॉप vs सर्वर फार्म
- **NMT सीपीयू कमी:**पर ठीक चलाएँ: 2 सीपीयू कोर, 4GB रैम
- **डॉकर छवि: 1. 5- 5)**मूल्यांकन: सीपीयू सिर्फ, जीपीयू की आवश्यकता नहीं है
Retry-Afterलागत: $ - 20/ माह Vpp
- **शर्त:**Lara 3B: 80GB+ वोथ की आवश्यकता है (ए100 जीयू)
- छोटा 7B-13 मॉडल: अभी भी 16-32GB रैम न्यूनतम
- एपीआई लागत: $ 0. 0- 0. 30 प्रति 1000 निशानियाँ (जो तेजी से जोड़ता है!)
- गंभीर जीयू के लिए $००,०००/ माह
- 10,000 ब्लॉग पोस्ट अनुवाद के लिए वास्तविक लागत:
- जन्नती विधि cdrecordium timeIMSUNT- nmont (CUP) $20/ माह योग्य वीपीएस 2-3 घंटे (Cet)
- IMSUNTIC- nont (जीयूपीयू) $50/ माहPUPUPCKS 15- 30 मिनट (G)
- IMSER-4 API $1505000-300 8-15 घंटे BAR
- Git API $200-4006-12 घंटे ( परोक्ष में)
- “%s” स्थानीय Lhma 70B00 $1000+/LLLL 20-40 घंटेविशेषता: उद्देश्य- बिट vsonr- currography
**NMT सामर्थ्य:**खास तौर पर अनुवाद करने के लिए प्रशिक्षणRetry-Afterरेगुलरिटी ( समान इनपुट = एक ही आउटपुट)
कोई "अनुप्रयोग" - शुद्ध अनुवाद नहीं
तकनीकी सामग्री, कोड, फ़ॉर्मेटिंग अच्छी तरह से हैंडल करता है
कोई प्रायोगिक इंजीनियरिंग आवश्यक नहीं
sequenceDiagram
    participant Client
    participant API
    participant Queue
    participant Translator
    participant Cache
    participant Model

    Client->>API: POST /translate
    API->>Queue: Acquire slot

    alt Queue has space
        Queue-->>API: Slot acquired
        API->>Translator: Process translation
        Translator->>Translator: Sanitize input
        Translator->>Translator: Split sentences
        Translator->>Translator: Chunk text
        Translator->>Translator: Mask symbols
        Translator->>Cache: Get model (en→de)

        alt Cache hit
            Cache-->>Translator: Return cached model
        else Cache miss
            Cache->>Model: Load from Hugging Face
            Model-->>Cache: Pipeline loaded
            Cache->>Cache: Evict old if at capacity
            Cache-->>Translator: Return model
        end

        Translator->>Model: Translate batches
        Model-->>Translator: Translations
        Translator->>Translator: Unmask symbols
        Translator->>Translator: Post-process
        Translator-->>API: Translations
        API->>Queue: Release slot
        API-->>Client: 200 OK + translations
    else Queue full
        Queue-->>API: Overflow error
        API-->>Client: 429 Too Many Requests\nRetry-After: X seconds
    end
कठिन चुनौतियाँ:
उदाहरण के लिए:
graph LR
    A[Raw Input] --> B{Sanitize?}
    B -->|Yes| C[Check Noise]
    B -->|No| D[Split Sentences]
    C -->|Is Noise| Z[Return Placeholder]
    C -->|Valid| D

    D --> E[Enforce Max Length]
    E --> F[Chunk for Batching]
    F --> G{Symbol Masking?}

    G -->|Yes| H[Mask Digits/Punct/Emoji]
    G -->|No| I[Translate]
    H --> I

    I --> J{Direct Model?}
    J -->|Available| K[Direct Translation]
    J -->|Not Available| L{Pivot Fallback?}

    L -->|Yes| M[src→en→tgt]
    L -->|No| Z
    K --> N[Unmask Syis robust input handling. Here's what happens:

**Noise Detection:**
- Strips control characters (except \t, \n, \r)
- Checks minimum character count (default: 1)
- Calculates alphanumeric ratio (default: must be ≥20%)
- Rejects pure emoji, pure punctuation, or pure whitespace

**Symbol Masking:**
Why mask symbols? Translation models are trained on text, not emoji or special symbols. These can confuse them or get mangled. So we:

1. Extract all digits, punctuation, and emoji as contiguous runs
2. Replace them with sentinel tokens: `⟪MSK0⟫`, `⟪MSK1⟫`, etc.
3. Translate the masked text
4. Restore the original symbols in their positions

Example:
Input: "Hello 👋 world! Price: $99.99" जब हरेक का इस्तेमाल किया जाए (👋) (!) (:) ($99.99)
**Post-Processing:**
After translation, we remove "symbol loops" - repeated symbols that weren't in the source:
जब से NMT का प्रयोग करें (सबसे कम से कम- nont) तब इस्तेमाल करें: आपको लगातार, स्केल पर तेज अनुवाद की आवश्यकता है विषय- वस्तु (अनुप्रयोग या उच्च आवाज़)
### Sentence Splitting & Chunking

Long texts get split intelligently:

```mermaid
graph TD
    A[Long Text] --> B[Split on . ! ? …]
    B --> C{Sentence > 500 chars?}
    C -->|Yes| D[Split on word boundaries]
    C -->|No| E[Keep sentence]
    D --> E

    E --> F[Group into chunks ≤900 chars]
    F --> G[Translate each chunk]
    G --> H[Join with space]
आप तकनीकी सामग्री, कोड, संरचना डाटा का अनुवाद कर रहे हैं
- आपको निर्धारित किए गए आउटपुट की आवश्यकता है ( समान इनपुट = एक ही आउटपुट)
- आप सीपीयू या निम्न हार्डवेयर पर चलाना चाहते हैं
- आप स्वचलित अनुवाद तैयार कर रहे हैं
जब गलत हो तो इस्तेमाल करें:
आपको सृजनात्मक अनुकूलता की आवश्यकता है, शाब्दिक अनुवाद नहीं
stateDiagram-v2
    [*] --> CheckCache
    CheckCache --> CacheHit: Model exists
    CheckCache --> CacheMiss: Model not loaded

    CacheHit --> MoveToEnd: Update LRU order
    MoveToEnd --> ReturnModel

    CacheMiss --> CheckCapacity
    CheckCapacity --> LoadModel: Space available
    CheckCapacity --> EvictOldest: Cache full

    EvictOldest --> MoveToCPU: Free VRAM
    MoveToCPU --> ClearCUDA: torch.cuda.empty_cache()
    ClearCUDA --> LoadModel

    LoadModel --> AddToCache
    AddToCache --> ReturnModel
    ReturnModel --> [*]
कॉन्टेक्स्ट तथा सांस्कृतिक nining विषय गति से अधिक
- आप कम-वोम कर रहे हैं, एक-बाहर अनुवाद
- आपको अनुवाद करने की जरूरत है + व्याख्या + एक कदम में फिर से लिखें
- आप चर लागत और धीमी प्रक्रिया के साथ ठीक हैं
- नीचे दी गई पंक्ति
- के लिए
ब्लॉग अनुवाद स्वचालित करें
(मेरा उपयोग), NMT स्पष्ट विजेता है:
# Semaphore limits concurrent translations
MAX_INFLIGHT = 1  # On GPU, 1 at a time for efficiency
MAX_QUEUE_SIZE = 1000  # Up to 1000 waiting

# When full:
# - Returns 429 Too Many Requests
# - Includes Retry-After header
# - Estimates wait time based on average duration
~ 30 मिनट में 100+ ब्लॉग पोस्टों को ~ में 12 भाषाओं में अनुवाद करता है (जीयूपीयू)
avg_duration = 2.5 seconds (tracked with EMA)
waiters = 100
slots = 1
estimated_wait = (100 / 1) * 2.5 = 250 seconds
clamped = min(250, 120) = 120 seconds
Retry-After: 120
$50/ माह वीपी में चलाएँ
सभी पोस्टों के पार सामान्य क्वालिटी
graph LR
    A[Ukrainian Text] --> B{Direct uk→fr?}
    B -->|Exists| C[Translate Directly]
    B -->|Missing| D[Pivot via English]

    D --> E[uk→en]
    E --> F[en→fr]
    F --> G[French Result]
    C --> G
कुल सेटअप:
इस प्रयास की कोशिश में प्रति माह $००० डॉलर खर्च होंगे या अपने आप से $००,००० नागरिक सर्वर की आवश्यकता होगी.
केवल गति भिन्न ही अनुवाद अनुवाद के अनुवाद के लिए केवल व्यावहारिक चुनाव बनाती है ।
टीएल;डीआर:
NMT अनुवाद के लिए उद्देश्य, साधारण हार्डवेयर पर दौड़ता है, और 10100x तेजी से तेज है। यदि आपको तेजी से, RMM से की आवश्यकता होती है, RMT के अनुसार, कीमत पर कटौती, NMT हाथ जीतता है।
# src/core/cache.py
from collections import OrderedDict
import torch

class LRUPipelineCache:
    """LRU cache that automatically cleans up GPU memory when evicting models."""

    def __init__(self, capacity: int):
        self.cache = OrderedDict()  # Maintains insertion order
        self.capacity = capacity

    def get(self, key: str):
        """Get model from cache, moves it to end (most recently used)."""
        if key not in self.cache:
            return None
        self.cache.move_to_end(key)  # Mark as recently used
        return self.cache[key]

    def put(self, key: str, value):
        """Add model to cache, evicting oldest if at capacity."""
        if key in self.cache:
            self.cache.move_to_end(key)
        else:
            self.cache[key] = value

        # If cache is full, evict the oldest model
        if len(self.cache) > self.capacity:
            oldest_key, oldest_pipeline = self.cache.popitem(last=False)

            # MAGIC: Move evicted model to CPU to free GPU memory
            try:
                oldest_pipeline.model.to("cpu")
                if torch.cuda.is_available():
                    torch.cuda.empty_cache()  # Tell GPU to release memory
                logger.info(f"Evicted {oldest_key}, freed GPU memory")
            except Exception as e:
                logger.warning(f"Failed to clean GPU memory: {e}")
ओवरव्यू
OrderedDictनिवेदन प्रवाह सीधा है:- क्लाइंटअनुवादक को एपीआई गेटवे के लिए अनुवाद निवेदन भेजें (जीएर्निया + यूवीएर मज़दूरों)
- एपीआई गेटवेबाइबल अंत की ओर ले जाती है
- आउडासिटी जांच: सिस्टम जाँच यदि निवेदन को नियंत्रित करने की क्षमता है
हाँ
▪ अनुवाद सेवा में फौरन हिस्सा लेने की गुज़ारिश करता है
# src/services/model_manager.py
def get_pipeline(self, src: str, tgt: str):
    """Try to get translation model, with automatic fallback to other providers."""

    # Determine which model families support this language pair
    families_to_try = []

    if config.AUTO_MODEL_FALLBACK:
        # Try families in priority order: opus-mt → mbart50 → m2m100
        for family in config.MODEL_FALLBACK_ORDER.split(","):
            if self._is_pair_supported(src, tgt, family.strip()):
                families_to_try.append(family.strip())

    # Try each family until one succeeds
    last_error = None
    for family in families_to_try:
        try:
            model_name, src_lang, tgt_lang, _ = self._get_model_name_and_langs(src, tgt, family)

            if family != config.MODEL_FAMILY:
                logger.info(f"Using fallback '{family}' for {src}->{tgt}")

            # Load the model from HuggingFace
            pipeline = transformers.pipeline(
                "translation",
                model=model_name,
                device=device_manager.device_index,
                src_lang=src_lang,
                tgt_lang=tgt_lang
            )

            self.cache.put(f"{src}->{tgt}", pipeline)
            return pipeline

        except Exception as e:
            last_error = e
            logger.warning(f"Family '{family}' failed for {src}->{tgt}: {e}")
            continue  # Try next family

    # All families failed
    raise ModelLoadError(f"{src}->{tgt}", last_error)
नहीं
- QX निवेदन कतार में, ग्राहक को HTTP 429 के साथ प्राप्त होता हैशीर्षिका
- अनुवाद सेवाएक्सप्रेशन से निवेदन करता है:
- इनपुट अनुमोदन तथा वाक्य विभाजनप्रतीक मास्किंग (मोजीज़, विशेष अक्षर)
- कैश मॉडलों का उपयोग कर अनुवादप्रतीक अनस्किंग तथा बाद- प्रक्रिया
मॉडल कैश
(LRU) अनुवाद मॉडल प्रदान करता है:
# src/services/queue_manager.py
import asyncio
from contextlib import asynccontextmanager

class QueueManager:
    """Manages request queuing and backpressure."""

    def __init__(self, max_inflight: int, max_queue: int):
        self.semaphore = asyncio.Semaphore(max_inflight)  # Limit concurrent translations
        self.max_queue_size = max_queue
        self.waiting_count = 0
        self.inflight_count = 0
        self.avg_duration_sec = 5.0  # Exponential moving average

    @asynccontextmanager
    async def acquire_slot(self):
        """Try to get a translation slot, track metrics, handle queueing."""

        # Check if queue is too full
        if self.waiting_count >= self.max_queue_size:
            # Calculate how long client should wait before retrying
            retry_after = self._estimate_retry_after()
            raise QueueOverflowError(self.waiting_count, retry_after)

        self.waiting_count += 1
        try:
            # Wait for available slot (this is the queue!)
            await self.semaphore.acquire()
            self.waiting_count -= 1
            self.inflight_count += 1

            start_time = time.time()
            yield  # Let the translation happen

            # Update average duration for retry-after estimates
            duration = time.time() - start_time
            alpha = config.RETRY_AFTER_ALPHA  # Smoothing factor (0.2)
            self.avg_duration_sec = alpha * duration + (1 - alpha) * self.avg_duration_sec

        finally:
            self.inflight_count -= 1
            self.semaphore.release()

    def _estimate_retry_after(self) -> int:
        """Smart calculation: how many waiting / how many slots * avg time per request."""
        if self.inflight_count == 0:
            return config.RETRY_AFTER_MIN_SEC

        # If 10 people waiting and 2 slots available, and each takes 5 seconds:
        # retry_after = (10 / 2) * 5 = 25 seconds
        retry_sec = (self.waiting_count / self.semaphore._value) * self.avg_duration_sec

        # Clamp between min and max
        return max(
            config.RETRY_AFTER_MIN_SEC,
            min(int(retry_sec), config.RETRY_AFTER_MAX_SEC)
        )
कैश हिट Escape तेज प्रतिक्रिया
- कैशिंग मुख हब से लोड हो रहा हैकैश पूर्ण
max_inflight) - प्रतिक्रिया (
@asynccontextmanagerक्लाएंट में लौटाता है - **कुंजी डिज़ाइन:**पीछे से चले जाने की व्यवस्था (जो आगे + HTTP9) लोड होने से रोकती है ।
- जब कम हो जाता है, सेवा कतार मरने के बजाय निवेदन करती है, ग्राहक को समय - समय पर फिर से कोशिश करने के लिएशीर्षिका.
- **यह कैसे काम करता है:**प्रवाहन करें
जब एक अनुवाद निवेदन में आता है, यहाँ क्या होता है:
इनपुट प्रक्रिया पाइपलाइन
# src/utils/symbol_masking.py
import re

def mask_symbols(text: str) -> tuple[str, dict[str, str]]:
    """Replace special symbols with placeholders before translation."""

    originals = {}
    masked_text = text
    placeholder_counter = 0

    # Pattern: Match emojis, symbols, special punctuation
    # \U0001F300-\U0001F9FF = emoji range
    # [\u2600-\u26FF\u2700-\u27BF] = misc symbols
    symbol_pattern = re.compile(
        r'[\U0001F300-\U0001F9FF\u2600-\u26FF\u2700-\u27BF'
        r'\u00A9\u00AE\u2122\u2139\u3030\u303D\u3297\u3299]+'
    )

    for match in symbol_pattern.finditer(text):
        symbol = match.group()
        placeholder = f"__SYMBOL_{placeholder_counter}__"
        originals[placeholder] = symbol
        masked_text = masked_text.replace(symbol, placeholder, 1)
        placeholder_counter += 1

    return masked_text, originals

def unmask_symbols(text: str, originals: dict[str, str]) -> str:
    """Restore original symbols after translation."""
    for placeholder, original in originals.items():
        text = text.replace(placeholder, original)
    return text
सेवा एक जटिल बहुमुखी मंचिक उपयोग करती है असली असली विश्व पाठ को नियंत्रित करने के लिए:
# Before translation:
text = "Hello! 👋 Check out this cool feature 🚀"

# Mask symbols:
masked, originals = mask_symbols(text)
# masked = "Hello! __SYMBOL_0__ Check out this cool feature __SYMBOL_1__"
# originals = {"__SYMBOL_0__": "👋", "__SYMBOL_1__": "🚀"}

# Translate the masked text:
translated = translate(masked, "de")  # → "Hallo! __SYMBOL_0__ Schau dir diese coole Funktion an __SYMBOL_1__"

# Unmask symbols:
final = unmask_symbols(translated, originals)
# final = "Hallo! 👋 Schau dir diese coole Funktion an 🚀"
मास्कित: "हेलो मो. 0 मि. बा.के.
- **स्रोत: "हेलो दुनिया"**बुरा अनुवाद: "हाय!!!!
- **साफ: "Hoomoo" # ले जाता है! लूप मिटाएँ!**यह सुनिश्चित करता है:
👋मॉडलों भारी इनपुट पर तनाव नहीं है__SYMBOL_0__हम विशेष रूप से इकट्ठा कर सकते हैं - संदर्भ को उचित सीमाएँ के भीतर सुरक्षित रखा जाता हैमॉडल कैशिंग मेमोरी प्रबंधन (M)
एलआरयूपीयू कैश जीपीयू मेमोरी के बारे में स्मार्ट है:
ऐसा क्यों:
# src/utils/text_processing.py
def chunk_sentences(sentences: list[str], max_chars: int = 900) -> list[list[str]]:
    """Group sentences into chunks that fit within model's max input length."""

    chunks = []
    current_chunk = []
    current_length = 0

    for sentence in sentences:
        sentence_len = len(sentence)

        # If this sentence alone is too long, it goes in its own chunk
        if sentence_len > max_chars:
            if current_chunk:
                chunks.append(current_chunk)
                current_chunk = []
                current_length = 0
            chunks.append([sentence])
            continue

        # If adding this sentence exceeds limit, start new chunk
        if current_length + sentence_len + 1 > max_chars:
            chunks.append(current_chunk)
            current_chunk = [sentence]
            current_length = sentence_len
        else:
            current_chunk.append(sentence)
            current_length += sentence_len + 1  # +1 for space

    # Don't forget the last chunk!
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def split_sentences(text: str, max_sentence_chars: int = 500) -> list[str]:
    """Split text into sentences, enforcing max length."""

    # Split on common sentence terminators
    sentences = re.split(r'([.!?…]+\s+)', text)

    result = []
    for sentence in sentences:
        if not sentence or sentence.isspace():
            continue

        # If sentence is too long, split on word boundaries
        if len(sentence) > max_sentence_chars:
            words = sentence.split()
            current = []
            current_len = 0

            for word in words:
                if current_len + len(word) + 1 > max_sentence_chars:
                    result.append(' '.join(current))
                    current = [word]
                    current_len = len(word)
                else:
                    current.append(word)
                    current_len += len(word) + 1

            if current:
                result.append(' '.join(current))
        else:
            result.append(sentence.strip())

    return result
गापीयू मेमोरी मूल्यवान है
- अनुवाद मॉडल 300-00MB प्रत्येकमॉडल लोड करना धीमा है (1-3 सेकण्ड)
.!?…हम 6 सबसे हाल ही के मॉडल गर्म रखना - पुराना मॉडल स्वतः निकाल दिया गया हैबैकअपिंग (B)
- **लोड करने के बजाय, सेवा क़तार निवेदन करता है:**पुनः प्रयास करें अनुमान स्मार्ट है:
- बिंदुमय अनुवाद फालबैकसभी भाषा के जोड़ों के पास सीधे मॉडल नहीं होते ।
हल?
अंग्रेज़ी के माध्यम से बिंदु:
# src/services/model_discovery.py
import httpx
from datetime import datetime, timedelta

class ModelDiscoveryService:
    """Discovers available translation models with 1-hour cache."""

    def __init__(self):
        self._cache = {}  # Cache results to avoid hammering HuggingFace API
        self._cache_ttl = timedelta(hours=1)
        self._hf_api_base = "https://huggingface.co/api/models"

    async def discover_opus_mt_pairs(self, force_refresh: bool = False):
        """Query HuggingFace for all Helsinki-NLP Opus-MT models."""

        cache_key = "opus-mt"

        # Check cache first
        if not force_refresh and cache_key in self._cache:
            cached_data, cached_time = self._cache[cache_key]
            if datetime.now() - cached_time < self._cache_ttl:
                return cached_data  # Cache hit!

        # Cache miss - query HuggingFace API
        async with httpx.AsyncClient() as client:
            response = await client.get(
                self._hf_api_base,
                params={
                    "author": "Helsinki-NLP",
                    "search": "opus-mt",
                    "limit": 1000
                },
                timeout=30.0
            )
            models = response.json()

        # Extract language pairs from model names
        # Example: "Helsinki-NLP/opus-mt-en-de" → ("en", "de")
        pairs = []
        for model in models:
            model_id = model.get("modelId", "")
            if model_id.startswith("Helsinki-NLP/opus-mt-"):
                # Extract the language codes after "opus-mt-"
                lang_part = model_id.replace("Helsinki-NLP/opus-mt-", "")
                if "-" in lang_part:
                    src, tgt = lang_part.split("-", 1)
                    pairs.append({"source": src, "target": tgt})

        # Cache the results
        self._cache[cache_key] = (pairs, datetime.now())

        return pairs
यह दो बार के बीच का अंतर है, लेकिन सभी समर्थित भाषा जोड़े के लिए विस्तार सुनिश्चित करें.
- कोड गहराई तक: साफ विशेषताओं के बारे में समझाया गया (
httpxचलो कोड बेस के सबसे दिलचस्प भागों में से कुछ की जाँच करें! - **ये सचमुच उत्पादन - शैली हैं जो सेवा को मज़बूत और कुशल बनाती हैं ।**प्रत्येक विवरण में गैर स्थिर विकासकर्ता के लिए उपयुक्त स्पष्टीकरण शामिल हैं.
- **1 ..**स्मार्ट एलआरयू कैश जीपी मेमोरी प्रबंधन के साथ
enसबसे बढ़िया चीजों में से एक है बुद्धिमान मॉडल कैश जो कि गापीपी मेमोरी को संभालना जानते हैं:deयहाँ क्या हो रहा है?Helsinki-NLP/opus-mt-en-de - : नियमित शब्दकोश की तरह, लेकिन याद रखिए कि क्रम वस्तुओं को जोड़ा गया थाएलआरयू ( हाल ही में उपयोग में)
: जब कैश पूरी तरह भरा है, उस मॉडल को लात मारते हैं जो लंबे समय में इस्तेमाल नहीं किया गया है
जीपीयू साफ- सफाई
# src/core/device.py
import torch

class DeviceManager:
    """Smart device selection with GPU auto-detection."""

    def __init__(self):
        self.use_gpu = self._should_use_gpu()
        self.device_index = self._resolve_device()
        self.device_str = "cpu" if self.device_index < 0 else f"cuda:{self.device_index}"

        # Auto-configure parallel translation slots based on device
        if self.device_index >= 0:
            # GPU: Run translations serially to avoid VRAM fragmentation
            self.max_inflight = 1
        else:
            # CPU: Can handle multiple translations in parallel
            self.max_inflight = config.MAX_WORKERS_BACKEND

        self._log_device_info()

    def _should_use_gpu(self) -> bool:
        """Check if GPU should be used."""
        if config.USE_GPU.lower() == "false":
            return False
        if config.USE_GPU.lower() == "true":
            return torch.cuda.is_available()
        # "auto" mode: use GPU if available
        return torch.cuda.is_available()

    def _resolve_device(self) -> int:
        """Returns device index: -1 for CPU, 0+ for CUDA."""
        if not self.use_gpu:
            return -1

        # Check if specific CUDA device requested
        if config.DEVICE and config.DEVICE.startswith("cuda:"):
            device_num = int(config.DEVICE.split(":")[1])
            return device_num

        return 0  # Use first GPU

    def _log_device_info(self):
        """Log device information at startup."""
        if self.device_index >= 0:
            gpu_name = torch.cuda.get_device_name(self.device_index)
            vram_gb = torch.cuda.get_device_properties(self.device_index).total_memory / 1e9
            logger.info(f"Using GPU: {gpu_name} ({vram_gb:.1f}GB VRAM)")
            logger.info(f"Max inflight translations: {self.max_inflight} (GPU mode)")
        else:
            cpu_count = os.cpu_count()
            logger.info(f"Using CPU ({cpu_count} cores)")
            logger.info(f"Max inflight translations: {self.max_inflight} (CPU mode)")

# Global singleton instance
device_manager = DeviceManager()
: एक मॉडल निकालते समय, हम स्पष्ट रूप से इसे सीपीयू स्मृति में ले जाते हैं और अपने संसाधन को छोड़ने के लिए जीयूपी को बताना
- यह क्यों ज़रूरी है: इसके बिना, guपिपी याददाश्त 2-3 मॉडल लोड करने के बाद भर जाती और दुर्घटना होती!
- 2स्वचालित मॉडल परिवार फालबैक
max_inflight=1यह चतुर विशेषता कई एआई मॉडल प्रबंधनों की कोशिश करता है यदि पहले आपको भाषा जोड़े नहीं हैं:max_inflight=4यहाँ क्या हो रहा है? - फालबैक चेन: अगर ओकास-एमटी नहीं है, स्वचालित रूप से mT50, तो M2M100 की कोशिश करें
DEVICE=cuda:1 - कोई दस्ती हस्तक्षेप नहीं: उपयोक्ता सिर्फ अनुवाद की गुज़ारिश करते हैं और सबसे बढ़िया मॉडल पा सकते हैं
- नियंत्रण करने में त्रुटि: यदि सभी परिवार असफल हो जाते हैं, तो हम अंतिम असफलता की वजह से एक स्पष्ट त्रुटि फेंक देते हैं
स्मार्ट कैशिंग
: सफल मॉडल भाषा जोड़े की कुंजी से कैशे जाते हैं
# Snippet from QueueManager showing EMA calculation
def update_avg_duration(self, new_duration: float):
    """Update average duration using exponential moving average."""

    # EMA formula: new_avg = α × new_value + (1 - α) × old_avg
    # α = smoothing factor (0.0 to 1.0)
    #   - Higher α = more weight to recent values (faster adaptation)
    #   - Lower α = more weight to historical values (more stable)

    alpha = 0.2  # 20% weight to new value, 80% to historical

    self.avg_duration_sec = (
        alpha * new_duration +
        (1 - alpha) * self.avg_duration_sec
    )
3
# Initial average: 5.0 seconds
# New request takes: 10.0 seconds

# EMA calculation:
new_avg = 0.2 * 10.0 + 0.8 * 5.0
        = 2.0 + 4.0
        = 6.0 seconds

# Next request takes: 3.0 seconds
new_avg = 0.2 * 3.0 + 0.8 * 6.0
        = 0.6 + 4.8
        = 5.4 seconds
अंतराल में वापस लाने के लिए निवेदन करें (H-8859- 429)
- **उत्पादों को नष्ट कर रहा है कि सर्वर भारी भार के नीचे क्रैश नहीं कर सकता:**यहाँ क्या हो रहा है?
- केरोफ़ॉयर: एक क्लब में किर की तरह - सिर्फ एक ही बार में N के लोगों को एक ही समय में देते हैं (N =
- कॉन्टेक्स्ट प्रबंधक: गेंदें स्वचालित सहेजें तथा साफ करें
- स्मार्ट अगली बार फिर कोशिश करें: स्तम्भ गहराई तथा औसत निवेदन समय पर "अभी 25 सेकंड में वापस आओ" ग्राहक बताता है
Retry-Afterएक्सपोनेंट खिसकाना औसत
: निवेदन अवधि में चिकनी वृत्तियाँ
- यह क्यों ज़रूरी है: भारी भार के तहत, ROMONT के बजाय HTTP 429 का परिणाम होगा.
- **4.**प्रतीक मास्किंग मैजिक
- **कुछ खास अक्षर (मोजीज़, चिह्न) सुरक्षित रखते हैं जो अनुवाद मॉडलों में गड़बड़ी डाल सकते हैं:**उदाहरण उपयोग:
- **यहाँ क्या हो रहा है?**रेगिक्स पैटर्न
- : मेल एमोजी तथा विशेष प्रतीक यूनिकोड सीमाचुने गए सिस्टम (l)
- **फेरस:**के साथ
अस्थायी
यह क्यों ज़रूरी है
: अनुवाद मॉडल कभी - कभी भ्रष्ट होते हैं या खराब होते हैं - यह उन्हें पूरी तरह सुरक्षित रखता है!
5.
# Prefer GPU if available (default)
USE_GPU=auto

# Force GPU
USE_GPU=true

# Force CPU
USE_GPU=false

# Explicit device override
DEVICE=cuda:0
DEVICE=cpu
आन्तरिक पाठ क्लर्किंग
# Model family selection (NEW in v2.0!)
MODEL_FAMILY=opus-mt   # Best quality (default)
MODEL_FAMILY=mbart50   # 50 languages, single model
MODEL_FAMILY=m2m100    # 100 languages, maximum coverage

# Auto-fallback between model families (NEW in v2.0!)
AUTO_MODEL_FALLBACK=1  # Enabled by default
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"  # Priority order

# Volume-mapped model cache (NEW in v2.0!)
MODEL_CACHE_DIR=/models  # Persistent cache directory

# Model arguments passed to transformers.pipeline
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
EASYNMT_MODEL_ARGS='{"torch_dtype":"bf16","cache_dir":"/models"}'

# Preload models at startup (reduces first-request latency)
PRELOAD_MODELS="en->de,de->en,fr->en"

# LRU cache capacity
MAX_CACHED_MODELS=6
वाक्य सीमा को बनाए रखने के दौरान, लंबे पाठों को दोहराता है:
**यहाँ क्या हो रहा है?**वाक्य विभाजन
opus-mt: बुढ़ापे का उपयोग करके विभाजन का उपयोग करेmbart50और (मौत की तकलीफ़ से) पिन्डली से पिन्डली लिपट जाएगीm2m100लालच से दूर रहना
: बहुत से वाक्यों को बिना सीमा के प्रत्येक भाग में पैक करता हैशब्द किनारा विभाजन
1: यदि एक एकल वाक्य बहुत लंबा है, तो मध्य- वर्ड को काटने के बजाए रिक्त जगह में विभाजित होता है0यह क्यों ज़रूरी है
**: अनुवाद मॉडलों में इनपुट सीमाएँ हैं (आम तौर पर 512- सीधी निशानियाँ हैं).**यह सुनिश्चित करता है कि हम संदर्भ को बनाए रखने के दौरान कभी उन से ज़्यादा नहीं करते ।
- 6.
"opus-mt,mbart50,m2m100"कैशिंग के साथ मॉडल खोज - गतिशीली से उपलब्ध अनुवाद मॉडल खोज
"m2m100,mbart50,opus-mt"यहाँ क्या हो रहा है?
- 6.
एसएसई एचटीटीपी क्लाएंट: गैर ब्लॉक एचटीटीपी निवेदन करता है HfART चेहरे के लिए
- समय आधारित क्कनेक्टेड
/models: दर कम होने से बचने के लिए 1 घंटे के लिए परिणाम जमाता है-v ./model-cache:/models - मॉडल नाम पारसिंग कर रहा है
- निकालें:
- समय आधारित क्कनेक्टेड
और
fp16सेbf16यह क्यों ज़रूरी हैfp32: HfMAT मॉडलों में 1200+OT-MT मॉडल हैं।
उन सभी को पूछताछ करने के लिए ~10 सेकंड लेता है.
# Batch size for translation (higher = faster but more VRAM)
EASYNMT_BATCH_SIZE=16  # CPU: 8-16, GPU: 32-64

# Maximum text length per item
EASYNMT_MAX_TEXT_LEN=1000

# Maximum beam size (higher = better quality but slower)
EASYNMT_MAX_BEAM_SIZE=5

# Worker thread pools
MAX_WORKERS_BACKEND=1    # Translation workers
MAX_WORKERS_FRONTEND=2   # Language detection workers
कैशिंग इसे शीघ्र बना देता है!
# Enable request queueing (highly recommended)
ENABLE_QUEUE=1

# Max concurrent translations
# Auto: 1 on GPU, MAX_WORKERS_BACKEND on CPU
MAX_INFLIGHT_TRANSLATIONS=1

# Max queued requests before 429
MAX_QUEUE_SIZE=1000

# Per-request timeout (0 = disabled)
TRANSLATE_TIMEOUT_SEC=180

# Retry-After estimation
RETRY_AFTER_MIN_SEC=1      # Floor
RETRY_AFTER_MAX_SEC=120    # Ceiling
RETRY_AFTER_ALPHA=0.2      # EMA smoothing factor
7.
# Enable input filtering
INPUT_SANITIZE=1

# Minimum alphanumeric ratio (0.2 = 20%)
INPUT_MIN_ALNUM_RATIO=0.2

# Minimum character count
INPUT_MIN_CHARS=1

# Language code for undetermined/noise
UNDETERMINED_LANG_CODE=und
युक्ति अपने आप पता लगाएँ
# Default sentence splitting behavior
PERFORM_SENTENCE_SPLITTING_DEFAULT=1

# Max chars per sentence before word-boundary split
MAX_SENTENCE_CHARS=500

# Max chars per chunk for batching
MAX_CHUNK_CHARS=900

# Sentence joiner
JOIN_SENTENCES_WITH=" "
यदि उपलब्ध हो तो जीपीयू का पता स्वचालित उपयोग तथा उपयोग करें:
# Enable symbol masking
SYMBOL_MASKING=1

# What to mask
MASK_DIGITS=1    # Mask 0-9
MASK_PUNCT=1     # Mask .,!? etc.
MASK_EMOJI=1     # Mask 😀🎉 etc.
यहाँ क्या हो रहा है?
# Align response array length to input
ALIGN_RESPONSES=1

# Placeholder for failed items (when aligned)
SANITIZE_PLACEHOLDER=""

# Response format
EASYNMT_RESPONSE_MODE=strings    # ["translation1", "translation2"]
EASYNMT_RESPONSE_MODE=objects    # [{"text":"translation1"}, ...]
जीपीयू जांच
# Enable two-hop translation via pivot
PIVOT_FALLBACK=1

# Pivot language (usually English)
PIVOT_LANG=en
: यदि सीयूडीडी उपलब्ध है तो इसका प्रयोग करें
# Log level
LOG_LEVEL=INFO

# Per-request logging (verbose)
REQUEST_LOG=1

# Format
LOG_FORMAT=plain    # Human-readable
LOG_FORMAT=json     # Structured JSON

# File logging with rotation
LOG_TO_FILE=1
LOG_FILE_PATH=/var/log/marian-translator/app.log
LOG_FILE_MAX_BYTES=10485760    # 10MB
LOG_FILE_BACKUP_COUNT=5

# Include raw text in logs (privacy risk!)
LOG_INCLUDE_TEXT=0
कॉन्फ़िगरेशन
# Periodically clear CUDA cache (seconds, 0=disabled)
CUDA_CACHE_CLEAR_INTERVAL_SEC=0
: सेट
# Worker count (use 1 for single GPU)
WEB_CONCURRENCY=1

# Request timeout
TIMEOUT=60

# Graceful shutdown timeout
GRACEFUL_TIMEOUT=20

# Keep-alive timeout
KEEP_ALIVE=5
जीयूपी (वाइड वीवेल्यूशन) पर vsors
सीपीयू पर (एक्सटेंशन समानांतर)
# GET request
curl "http://localhost:8000/translate?target_lang=de&text=Hello%20world&source_lang=en"

# Response
{
  "translations": ["Hallo Welt"]
}
युक्ति चयन
# POST request
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": [
      "Hello world",
      "This is a test",
      "Machine translation is amazing"
    ],
    "target_lang": "de",
    "source_lang": "en",
    "beam_size": 1,
    "perform_sentence_splitting": true
  }'

# Response
{
  "target_lang": "de",
  "source_lang": "en",
  "translated": [
    "Hallo Welt",
    "Das ist ein Test",
    "Maschinenübersetzung ist erstaunlich"
  ],
  "translation_time": 0.342
}
: लक्ष्य को विशेष जीपीपी के साथ कर सकते हैं
# Omit source_lang for auto-detection
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": ["Bonjour le monde"],
    "target_lang": "en"
  }'

# Response
{
  "target_lang": "en",
  "source_lang": "fr",  # Detected
  "translated": ["Hello world"],
  "translation_time": 0.156
}
लॉग किया जा रहा है
# GET
curl "http://localhost:8000/language_detection?text=Hola%20mundo"
# {"language": "es"}

# POST with batch
curl -X POST http://localhost:8000/language_detection \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello", "Bonjour", "Hola"]}'
# {"languages": ["en", "fr", "es"]}
डिबगिंग के लिए प्रारंभ में Gपियू नाम तथा वीरैम दिखाएँ
# Health check
curl http://localhost:8000/healthz
# {"status": "ok"}

# Readiness
curl http://localhost:8000/readyz
# {
#   "status": "ready",
#   "device": "cuda:0",
#   "queue_enabled": true,
#   "max_inflight": 1
# }

# Cache status
curl http://localhost:8000/cache
# {
#   "capacity": 6,
#   "size": 3,
#   "keys": ["en->de", "de->en", "fr->en"],
#   "device": "cuda:0",
#   "inflight": 1,
#   "queue_enabled": true
# }

# Model info
curl http://localhost:8000/model_name | jq
एकलटन पैटर्न
# When queue is full, you get 429
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["test"], "target_lang": "de"}'

# Response: 429 Too Many Requests
# Headers: Retry-After: 45
# Body:
{
  "message": "Too many requests; queue full",
  "retry_after_sec": 45
}

# Proper client behavior:
# 1. Read Retry-After header
# 2. Wait that long + jitter
# 3. Retry request
: एक उदाहरण पूरे अनुप्रयोग के पार साझेदारी
8
फिर से कोशिशों के लिए एक्सपोनेंट खिसकाता है औसत
पुनः कोशिश करें जो कि वास्तविक निवेदन अवधि के लिए अनुकूलित करता है:
उदाहरण:
.\build-all.ps1
यहाँ क्या हो रहा है?
chmod +x build-all.sh
./build-all.sh
EMMA (प्रयोगात्मक जाना औसत)
: वज़न कम होने की तरह जो हाल ही में मूल्यों को ज़्यादा महत्त्व देता हैचिकना फ़ैक्टर (सेल्सियस):
- : नियंत्रण करता है कि कैसे हम परिवर्तनों के अनुकूल अनुकूल बनना चाहते हैं (
latest,min,gpu,gpu-minक्यों साधारण औसत नहीं? - : डीएमए समायोजनों को फ़िल्टर करने के दौरान तेजी से परिवर्तनों को बदलता हैयह क्यों ज़रूरी है
20250108.143022: क्लाएंटों को यथार्थ बताता है
समय जो मौजूदा तंत्र लोड करने के लिए अनुकूलता है
# Always get the latest version
docker pull scottgal/mostlylucid-nmt:cpu
# Or use the :latest alias
docker pull scottgal/mostlylucid-nmt:latest

# Pin to a specific version for reproducibility
docker pull scottgal/mostlylucid-nmt:cpu-20250108.143022
docker pull scottgal/mostlylucid-nmt:cpu-min-20250108.143022
ये कोड पैटर्न उत्पादन-पुष्ट पायथन अभ्यास प्रदर्शित करते हैं:
संसाधन प्रबंधनName
- एक्सपोजर मेमोरी साफ करेंअनुग्रहपूर्ण अपमान
- स्वचालित : मॉडल प्रदान करने के लिएयु. पू.
- हमला करने के बजाए: क़तार + HTTP9Queryआँकड़ा अखंडता
- : प्रतीक मास्किंग विशिष्ट अक्षरों की रक्षा करता हैपरफ़ॉर्मेंस पॉलिसी
: स्मार्ट कलिंग, रीलिंगिंग, और समानांतर प्रक्रिया
docker inspect scottgal/mostlylucid-nmt:cpu | jq '.[0].Config.Labels'
ऑब्सर्वेटरी: विस्तृत लॉगिंग तथा मेगनिंग.
इनमें से हरेक पहलू एक वास्तविक उत्पादन समस्या को हल करता है जो उन के बिना चूक, ग़लतियाँ, या ग़रीब प्रयोक्ता का अनुभव करेगा!
कॉन्फ़िगरेशन मार्गदर्शक
# Using pre-built image from Docker Hub (recommended)
docker run -d \
  --name translator \
  -p 8000:8000 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=500 \
  -e EASYNMT_BATCH_SIZE=16 \
  -e TIMEOUT=180 \
  -e LOG_LEVEL=INFO \
  -e REQUEST_LOG=0 \
  scottgal/mostlylucid-nmt

# Or build locally
docker build -t mostlylucid-nmt .
docker run -d --name translator -p 8000:8000 mostlylucid-nmt

# Check logs
docker logs -f translator
सेवा एनवायरनमेंट वेरिएबल के द्वारा अति कॉन्फ़िगरेबल है.
# Using pre-built GPU image from Docker Hub (recommended)
docker run -d \
  --name translator-gpu \
  --gpus all \
  -p 8000:8000 \
  -e USE_GPU=true \
  -e DEVICE=cuda:0 \
  -e PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en" \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  -e EASYNMT_BATCH_SIZE=64 \
  -e MAX_CACHED_MODELS=8 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=2000 \
  -e WEB_CONCURRENCY=1 \
  -e TIMEOUT=180 \
  -e GRACEFUL_TIMEOUT=30 \
  -e LOG_FORMAT=json \
  -e LOG_TO_FILE=1 \
  -v /var/log/translator:/var/log/marian-translator \
  scottgal/mostlylucid-nmt:gpu

# Or build locally
docker build -f Dockerfile.gpu -t mostlylucid-nmt:gpu .
docker run -d --name translator-gpu --gpus all -p 8000:8000 mostlylucid-nmt:gpu

# Monitor cache and performance
watch -n 5 "curl -s http://localhost:8000/cache | jq"
यहाँ पूर्ण मार्गदर्शक है:
version: '3.8'

services:
  translator:
    image: scottgal/mostlylucid-nmt:gpu  # Use pre-built image
    container_name: translator
    restart: unless-stopped

    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]

    ports:
      - "8000:8000"

    environment:
      USE_GPU: "true"
      DEVICE: "cuda:0"
      PRELOAD_MODELS: "en->de,de->en,en->fr,fr->en"
      EASYNMT_MODEL_ARGS: '{"torch_dtype":"fp16"}'
      EASYNMT_BATCH_SIZE: "64"
      MAX_CACHED_MODELS: "8"
      ENABLE_QUEUE: "1"
      MAX_QUEUE_SIZE: "2000"
      WEB_CONCURRENCY: "1"
      TIMEOUT: "180"
      LOG_FORMAT: "json"
      LOG_TO_FILE: "1"

    volumes:
      - translator-logs:/var/log/marian-translator
      - translator-cache:/root/.cache/huggingface

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/healthz"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s

volumes:
  translator-logs:
  translator-cache:
उपकरण चयन
apiVersion: apps/v1
kind: Deployment
metadata:
  name: translator
spec:
  replicas: 2  # Scale horizontally for CPU, use 1 per GPU
  selector:
    matchLabels:
      app: translator
  template:
    metadata:
      labels:
        app: translator
    spec:
      containers:
      - name: translator
        image: scottgal/mostlylucid-nmt:gpu
        ports:
        - containerPort: 8000
        env:
        - name: USE_GPU
          value: "true"
        - name: EASYNMT_MODEL_ARGS
          value: '{"torch_dtype":"fp16"}'
        - name: PRELOAD_MODELS
          value: "en->de,de->en"
        - name: ENABLE_QUEUE
          value: "1"
        - name: MAX_QUEUE_SIZE
          value: "2000"

        resources:
          requests:
            memory: "4Gi"
            cpu: "2"
            nvidia.com/gpu: 1
          limits:
            memory: "8Gi"
            cpu: "4"
            nvidia.com/gpu: 1

        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10

        readinessProbe:
          httpGet:
            path: /readyz
            port: 8000
          initialDelaySeconds: 20
          periodSeconds: 5

---
apiVersion: v1
kind: Service
metadata:
  name: translator
spec:
  selector:
    app: translator
  ports:
  - port: 80
    targetPort: 8000
  type: LoadBalancer
मॉडल कॉन्फ़िगरेशन
नया कॉन्फ़िगरेशन वर्णित किया गया:
सच्चाई (_F)
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'- प्राथमिक के रूप में प्रयोग करने के लिए कौन सा मॉडल परिवार प्रयोग में लिया जाए
- : उत्तम क्वालिटी, 1200+ जोड़े, अलग मॉडल
- : अच्छा गुण, 50 भाषाएँ, एकल 2. 4GB मॉडल
: अच्छा गुणवत्ता, 100 भाषाएँ, एकलGB मॉडल
# Start high, reduce if you get OOM
EASYNMT_BATCH_SIZE=64  # Try 128 on large GPUs
MOIS_lk Gall
PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en": अगर जोड़ा अनुपलब्ध हो तो अन्य परिवारों को स्वचालित कोशिश करें
WEB_CONCURRENCY=1
MAX_INFLIGHT_TRANSLATIONS=1
(डिफ़ॉल्ट): सक्रिय - अधिकतम कवरिंग
MAX_CACHED_MODELS=10 # Keep more models in VRAM: अक्षम - सख्त परिवार मोड
# beam_size=1 is 3-5x faster than beam_size=5
# Quality difference is often minimal
curl -X POST ... -d '{"beam_size": 1, ...}'
कनेक्शन (_F)
: कॉलबैक के लिए प्राथमिकता का अनुक्रम
EASYNMT_BATCH_SIZE=8तयशुदा:
MAX_WORKERS_BACKEND=4
MAX_INFLIGHT_TRANSLATIONS=4
WEB_CONCURRENCY=2
(डिस्ली प्रथम)
PERFORM_SENTENCE_SPLITTING_DEFAULT=0
वैकल्पिक:
(प्रयोग पहले)
// Bad: 100 separate requests
for (const text of texts) {
  await translate(text);
}

// Good: 1 batch request
await translate(texts);
जंगल (_C)
async function translateWithRetry(texts) {
  try {
    return await translate(texts);
  } catch (err) {
    if (err.status === 429) {
      const retryAfter = err.headers['retry-after'];
      const jitter = Math.random() * 5;
      await sleep((retryAfter + jitter) * 1000);
      return translateWithRetry(texts);
    }
    throw err;
  }
}
कोर आयतों के द्वारा अनुकूलित मॉडल भंडारण
// Reuse HTTP connections
const agent = new https.Agent({ keepAlive: true });
यहाँ सेट करें
// Bad: mixed language pairs in one request
translate([
  { text: "Hello", sourceLang: "en", targetLang: "de" },
  { text: "Bonjour", sourceLang: "fr", targetLang: "de" }
]);

// Good: group by language pair
translateBatch(enToDe, "en", "de");
translateBatch(frToDe, "fr", "de");
और नक्शा वॉल्यूम:
मॉडल कन्टेनर के पार बना रहता है@ info: whatsthis
- बहुल कंटेनर के बीच साझेदारी कैशमशाल विकल्प (_d):
- (रोट१६: 2x तेजी से जीपिपी, आधा मेमोरी पर, Ningix क्वालिटी नुकसान(दूरी 16): फप16 से ज़्यादा गिनती में बढ़ोतरी के लिए आधुनिक जीपीपीस की ज़रूरत होती है
- (रोट32: पूरी परिशुद्धता, धीमा परंतु अधिकांश सहीअनुवाद विन्यास
- **परफ़ॉर्मेंस किया जा रहा है (f)**इनपुट सेन्स
- वाक्य प्रक्रियाप्रतीक मास्किंग
- प्रतिक्रिया व्यवहारबिंदु धुरी कालबैक
- लॉग किया जा रहा हैमेंटेनेंस
गुन्नार (पेर)
उपयोग उदाहरण
translation_requests_total{lang_pair="en->de",status="success"} 1523
translation_requests_total{lang_pair="en->de",status="error"} 7
translation_duration_seconds{lang_pair="en->de",quantile="0.5"} 0.342
translation_duration_seconds{lang_pair="en->de",quantile="0.95"} 1.234
translation_queue_depth 23
translation_cache_size 6
translation_cache_hits_total 8234
translation_cache_misses_total 142
मूल अनुवाद
# Enable JSON logging
LOG_FORMAT=json REQUEST_LOG=1

# Output example
{
  "ts": "2025-01-08T15:30:45+0000",
  "level": "INFO",
  "name": "app",
  "message": "translate_post done items=5 dt=0.342s",
  "req_id": "a3d2f5b1-c4e6-4f7a-9d8c-1e2f3a4b5c6d",
  "endpoint": "/translate",
  "src": "en",
  "tgt": "de",
  "items": 5,
  "duration_ms": 342
}
बैच अनुवाद (अनुप्रयोगित)
स्वतः भाषा पता लगाएँ
सिर्फ भाषा पता लगाएँ |---------|---------|-----------------| | ऑब्सनमेंट अंतिमपाइंट्सपीछे की ओर दबाव का सामना करें | निर्माण और संस्करणसभी डॉकता छवियों में अब सही संस्करणिंग व मेटाडेटािंग के लिए सम्मिलित है. | क्विक बिल्डसभी 4 किस्मों को स्वचालित तिथि/समय के साथ बिल्ड करें: | **विंडोज़:**लिनक्स/Mac: | संस्करण फिर से प्रयोग किया जा रहा हैइन्हें बनाने के लिए एक - एक करके तैयार किया जाता है | दो टैगनामित टैग | ) - हमेशा हाल के अधिकांश बिन्दुओं पर इंगित करता हैसंस्करण टैग | ( ई.(c) - एपकेट स्नेपशॉट | **उदाहरण:**टीसीआई लेबल्स | **प्रत्येक छवि में मेटाडाटा शामिल है:**संस्करण | **: समय- चिह्न बनाना (YYYYYMMD. HHMMS)**बिल्ड तारीख़ | : ISO 8601 टाइमस्टैंपGit
: छोटा शॉ
चर
: कोप्पि- पूरा, खिमिन, जीपी- पूर्ण, या gui- hich-inलेबलों को जाँचें:
विस्तृत निर्देशों और सीआईसीडी एकीकरण के लिए, देखें
- बीयूआईडी.
MAX_QUEUE_SIZE - डेकोमेंट
- सीपीयू डीएक्सप्रिकमेंट
MAX_INFLIGHT_TRANSLATIONSगापीयू देपल्मेंट - डॉकर बनाएं
कुबेरेट्स देपलोमेंट
परफ़ॉर्मेंस गाय- बैलेटिनाGPUPEN संदेशवाहक जांचसूची
FP16 परिशुद्धता इस्तेमाल करें
- 2x तेजी से इंच
ENABLE_QUEUE=1 - Wigg प्रयोग का आधा
अनुवाद के लिए निचली गुणवत्ता नुकसान
बाने बैच आकारप्री- हॉट मॉडल लोड किया जा रहा है
हर गाँव में एक - साथ काम करनेवाले
- कैश आकार बढ़ाएँ
EASYNMT_BATCH_SIZE - टिन के माध्यम से निचला बण्ड आकार
MAX_CACHED_MODELS - सीपीयू ऑप्टीमाइज़ेशन जांचसूची
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' - निचला बैच आकार
WEB_CONCURRENCY=1समानांतरता बढ़ाएँMAX_INFLIGHT_TRANSLATIONS=1
छोटे पाठों के लिए वाक्य विभाजन को अक्षम करें
क्लाएंट उत्तम अभ्यासबैच निवेदन
सम्मान फिर से कोशिश करें - के- बाद
PRELOAD_MODELS="en->de,de->en"
कनेक्शन पूलिंग इस्तेमाल करें
भाषा जोड़े द्वारा समूह (_G) Helsinki-NLP/opus-mt-{src}-{tgt}ऑब्सर्वेटरी मॉनीटर किया जा रहा है (O)
ट्रैक करने हेतु कुंजी
- म्यूट द्वारा अनुवाद
PIVOT_FALLBACK=1(q) - औसत लेटेन्से
curl http://localhost:8000/lang_pairs
(प50, p95, p99)
गहराई क़तार में लगाएँ(वर्तमान इंतजार गिनती)
कैश हिट दर
- (%s) कैश क्रैश करने के लिए निवेदन करता है
MASK_EMOJI=0त्रुटि दरMASK_PUNCT=0 - (5x जवाब)
SYMBOL_MASKING=0
जीपीयूरेशन
(यदि लागू हो)
public class MostlyLucidNmtClient
{
    private readonly HttpClient _httpClient;
    private readonly string _baseUrl;

    public MostlyLucidNmtClient(HttpClient httpClient, string baseUrl)
    {
        _httpClient = httpClient;
        _baseUrl = baseUrl;
    }

    public async Task<TranslationResponse> TranslateAsync(
        List<string> texts,
        string targetLang,
        string sourceLang = "",
        int beamSize = 1,
        bool performSentenceSplitting = true,
        CancellationToken cancellationToken = default)
    {
        var request = new TranslationRequest
        {
            Text = texts,
            TargetLang = targetLang,
            SourceLang = sourceLang,
            BeamSize = beamSize,
            PerformSentenceSplitting = performSentenceSplitting
        };

        var response = await _httpClient.PostAsJsonAsync(
            $"{_baseUrl}/translate",
            request,
            cancellationToken);

        if (response.StatusCode == System.Net.HttpStatusCode.TooManyRequests)
        {
            // Read Retry-After header
            var retryAfter = response.Headers.RetryAfter?.Delta?.TotalSeconds ?? 30;
            var jitter = Random.Shared.Next(0, 5);
            await Task.Delay(TimeSpan.FromSeconds(retryAfter + jitter), cancellationToken);

            // Retry
            return await TranslateAsync(texts, targetLang, sourceLang, beamSize,
                performSentenceSplitting, cancellationToken);
        }

        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<TranslationResponse>(cancellationToken);
    }
}

public class TranslationRequest
{
    [JsonPropertyName("text")]
    public List<string> Text { get; set; }

    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("beam_size")]
    public int BeamSize { get; set; }

    [JsonPropertyName("perform_sentence_splitting")]
    public bool PerformSentenceSplitting { get; set; }
}

public class TranslationResponse
{
    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("translated")]
    public List<string> Translated { get; set; }

    [JsonPropertyName("translation_time")]
    public double TranslationTime { get; set; }
}
स्मृति प्रयोग
services.AddHttpClient<MostlyLucidNmtClient>(client =>
{
    client.BaseAddress = new Uri("http://translator:8000");
    client.Timeout = TimeSpan.FromMinutes(3);
});
( गापियू, सीपीयू के लिए रैम)
उदाहरण**अगर आप प्रोग्रेस को एकीकृत करते हैं (नहीं में, लेकिन जोड़ने के लिए आसान है)।**स्ट्रक्चर लॉगिंग उदाहरण
आप इस पाइप को एल-चक सर्च, बादल देखो, या किसी भी लॉगर के लिए पाइप कर सकते हैं.
तुलना: आसान
- UNTANATCATICHAT_NATY_NALAT
- स्थिरता
- शिर्क किए गए क्रैश बार-बार उत्पादों को तैयार करता है, अच्छी तरह से त्रुटि शिर्क करता है
इनपुट हैंडलिंग
- मैमोजी/ रॉबसन रॉबसनीकरण + चिह्न मास्किंग पर असफल
- यु. पू.
- IMD, OOMs लोड के तहत ओमाफ़ॉफ़ॉयर + कतार के साथ फिर से कोशिश करें
ऑब्सर्वेटरी
- INV न्यूनतम DCHAL स्वास्थ्य/res अंत बिन्दु, संरचना के लॉग scutd
- जीयू समर्थन
- UUNA (एनईएसटी) UUN 12.6, FP16/ B16 समर्थन
- मॉडल प्रबंधन
डेबियन मैनुअल, कोई CTCTLU कैश ऑटो- वीक्शन के साथ नहीं
- वाक्य हैंडलिंग
- GiB सेमी विभाजन स्मार्ट हाशिया सक्रिय कर रहा है + प्रचयन
- बिंदु धुरी अनुवाद
- Libisofs ने अंग्रेजीख़ुदा के द्वारा स्वचालित माध्यम से स्वचालित गन्दगी कर दिया
- बहुमुखी बन्दिंग
गीत नं. 4 (85), जी हाँ, टाइमआउट के साथ
कॉन्फ़िगरेशनSpamAssassin सीमा सीमित 40+RAv_BAR_के लिए फिल्टरिंग के लिएएपीआई संगतता
SECANNT अंतिमपाइंट 0. 100% संगत + विस्तार विस्तार
- कोड विशेषताशिर्कहीन, एकल इम्पिलिक मॉड्यूलर, टाइप किए गए, जाँच- पड़ताल
- ट्रबलिंग429 बहुत से निवेदन
- **कारण:**क़तार में पूरा.
- समाधानःबढ़ाएँ
- **अधिक नकल जोड़े (क्षैतिज स्केलिंग)**बढ़ाएँ
- **(यदि आपके सिर का कमरा हो)**क्लाएंट से बैच आकार कम करें
- 503 सेवा अनुपलब्धकारण:
- **अक्षम तथा सभी स्लॉट व्यस्त हैं.**समाधानः
क़तारिंग सक्षम करें:
# Maximum coverage with auto-fallback (recommended!)
docker run -d -p 8000:8000 \
  -v ./model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  -e AUTO_MODEL_FALLBACK=1 \
  -e MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100" \
  scottgal/mostlylucid-nmt:cpu-min

# GPU with best quality
docker run -d --gpus all -p 8000:8000 \
  -e USE_GPU=true \
  -e MODEL_FAMILY=opus-mt \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu

# Test it
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello world"], "target_lang": "de"}'
यदि आपके पास संसाधनों की मात्रा है तो परिश्रम सीमा बढ़ाएँ
जीयूपी में ओओएम (अपनी मेमोरी से बाहर)
कारण:
बैच आकार बहुत ज्यादा या बहुत से मॉडल कैश.
समाधानः
और
धीमा पहला निवेदन[कारण:
मॉडल प्री-लोड नहीं किया गया.
Translation NMT Neural Machine Translation Python FastAPI Docker CUDA PyTorch Transformers Helsinki-NLP Production Microservices API