


Cloudflare's "Mode de marquage de démarrage" donne aux crawleurs AI un texte propre au lieu du HTML renduM SK3 Les opérateurs StyloBot obtiennent la même capacité grâce à StyloExtractMSC4 qui fonctionne localement sur le portail de StylobotMska5 assez vite pour se placer sur le chemin chaudMka6 sans que des changements ne soient requis dans le site en amontM Ska7 C'est ce qu'effectue StyloextractMska8 comment il s'inscrit dans Stylo BotMske9 ce que les chiens nourrissent par lucidVIEW ont capturé, et ce qui~M Ska11 est encore en panneM ska12
Cloudflare envoie une fonction où, si un crawler AI reconnu demande une page, la bordure sert une version Markdown du corps au lieu de l'HTML completM SK2 Le crawleur reçoit le contenu réel sans aucun chrome , aucun JavaScript M SK4 aucun bannières cookies . L'utilisateurMSC6 le site visé demeure le même MST7 Le navigateurMST8 sa vie devient plus facileM ST9 Cloudflar obtient des frais pour cela M ST10 Tout le monde gagne M st11
L'architecture est évidente de l'extérieur: classer la demande comme un crawler M SK1Cloudflare fait déjà cela), faire passer la page par certains contenusMSC3 couche d'extractionMNK4 projet à MarkdownMRK5 retourner que, au lieu du HTML . Le classificateur est la partie intéressante si vous='re Cloudflare et l'extracteur est la part intéressante s'il s'agit de quelqu'un d'autre.
La même capacité pour un opérateur StyloBot a trois contraintes Cloudflare ne fait pas
Le côté StyloBot de cela a déjà été fait: le pipeline du détecteur classe les crawleurs AI (BotType.AiBot) avec la même vitesse de latence du chemin que tous les autres verdicts DetectionPolicyMiddleware Dans 7.x, les émissions désignent des politiques d’action par verdict extract-markdown Politique de "AiBot à /docs/*" est une ligne de configuration
Que's StyloExtract : le HTML-toM SK3Layer de marquage qui se substitue à la détection du StyloBotMST4MSC5 Les navires d’intégration sont constitués d’un petit ensemble d’adaptateurs.Mostlylucid.BotDetection.StyloExtract) et la règle qui le déclenche est de six lignes de JSON . Un opérateur déplace le paquet dans, ajoute la règleM SK3 et les crawleurs AI commencent à recevoir un marquagedown pour les mêmes URLs que ceux qui servent encore HTML aux humains
Si vous lisez la spécification à valeur nominale, "convertir HTML en Markdown" est un problème résoluMSC3 Il y a des dizaines de bibliothèquesM SK4 La réalité est qu’elles sont toutes dégradées sur les pages réelles parce que celles-ci considèrent le document comme un contenu planétaire et la page comme une étude d’étendue.
Les pages Web du monde réel sont 80-95% boilerplate. L'article que vous voulez vivre dans deux ou trois enveloppes <div>s sur deux ou trois cents. Un HTML naïf-àM SK2La bibliothèque de marquage convert tout : chaque lien navigable , chaque phrase d'affichage des témoins de cookie MSC5 chaque footer M SK6 chaque parenthèse afférente MST7 la barre arrière postelle M ST8 chaque bouton de partage M st9 tous les modes qui M S T 10 sont cachés par CSS mais présents dans le DOM M T 11 Le crawleur a demandé l’articleM S T 12 vous lui avez remis un fichier de marquation M s T 13 KB avec l’ article enfouillé quelque part en ligne M s T 14
Ainsi, l’extractionnaire doit faire deux tâches:
L’identification est la plus difficile. extraction de contenus Web et la référence établie est WCXB. L'état de l'art quand j'ai commencé à lire était un outil Python appelé Trafilatura. J'ai porté le chargement -cart d'idées à M SK3NET et ajouté une coucheTrafilatura n'a pasMSC4t haveMST5 perMst6host apprentissage des modèles par des empreintes digitales structurales.
La forme est:
parse HTML → clean → fingerprint the structure → does this fingerprint
  match a template I've seen on this host before?
    yes → apply the cached extractor → render
    no  → run the heuristic classifier → induce a fresh extractor →
          cache it under this host's fingerprint → render
La première fois que la passerelle voit une page d’un hôte, elle paie le coût total de l’héuristique -classifier M SK2μs pour une page moyenne). Chaque page subséquente de cet hôte dont les empreintes digitales structurelles correspondent reçoit plutôt l’extracteur cachedMSC4 qui est un petit nombre de CSSMNK5questions de sélecteurs MNK6 μsMRK7 Pages identiquesMMK8 pages d’hôtes avec le même modèle - qui constitue la plupart du site
L'empreinte digitale est une ébauche MinHash sur un DOM normalisé-représentation de la voie, avec un bandeur LSH au dessus pour le sous-probeM SK2millisecondesMSC3 La mathématique du match ne fait pas de l'objet de cet articleMST4ce qui importe, c'est qu'elle rend l'apprentissage par utilisateur(s) de MST6 suffisamment bon marché pour fonctionner à chaque demande.
Le côté render est là où la boucle de dogfood me l’a fait gagner.
La première version de StyloExtract a émis le Markdown en faisant marcher les blocs classés et en projectant element.TextContent.Trim() à la sortie. Chaque bloc est devenu un paragraphe # text Que ce soit en H1 ou en H+4. Les ancrages ont échoué jusqu’à un texte fictif . Les listes ont perdu leurs bullets M SK3 Les blocs de code ont perdu leur clôture . Les tableaux sont planifiés à commas
Il s’agit techniquement de "Markdown." C’est aussi inutileM SK2 . Le crawler AI demande à Markdown éviter de traiter le chrome, et nous lui remettons un mur de paragraphes où le seul signal est occasionnellement simple - phrases d’un nom de texte M SK2 Le point tout entier du service Markdown est que la structure transporte l’information . Retirer la structure et vous MSC4 Vous venez juste de donner au crawleur une poche légèrement plus petite de cordes
Ainsi, la prochaine version de StyloExtract marche le DOM de chaque bloc de contenu classé et émet un GFM réel:
<h1> par l'entremise <h6> deviend 1 par 6 # caractères<a href> devient [text](href)<em> et <strong> maintenir l'accent sur<code> stays backticked, <pre> devient un bloc clôturé avec language-x de l’eau<ul> et <ol> émettre des bullets réels et des listes numérotées<blockquote> Préfixes de chaque ligne avec > ( et la quote de l’alinéa multiM SK1 reçoit le > body\n>\n> body convention)<table> est reconstruit par le biais d'un slot WHATWG - algorithme de grille avec une colonne appropriée / colonne de lignes | / | caption \ / manipulation de l'alignement |, | retour à HTML brut lorsque la source est trop complexe pour que GFM puisse exprimer | qu’ils soient en ligne dans la prose ou autonomes <figure>Le walker est un StringBuilder par bloc, un tampon de scratch interne réutilisé à travers les cellules / des éléments de listeM SK2 et un seul passage au-dessus du DOM . Après le réglage de SSK4le premier coup était 304μs |/ \191KB pour une table | -page lourde | SSK9 il se situe à S~70μs
Le fauteuil roulant est également la partie qui s’est détériorée en premier lieu.
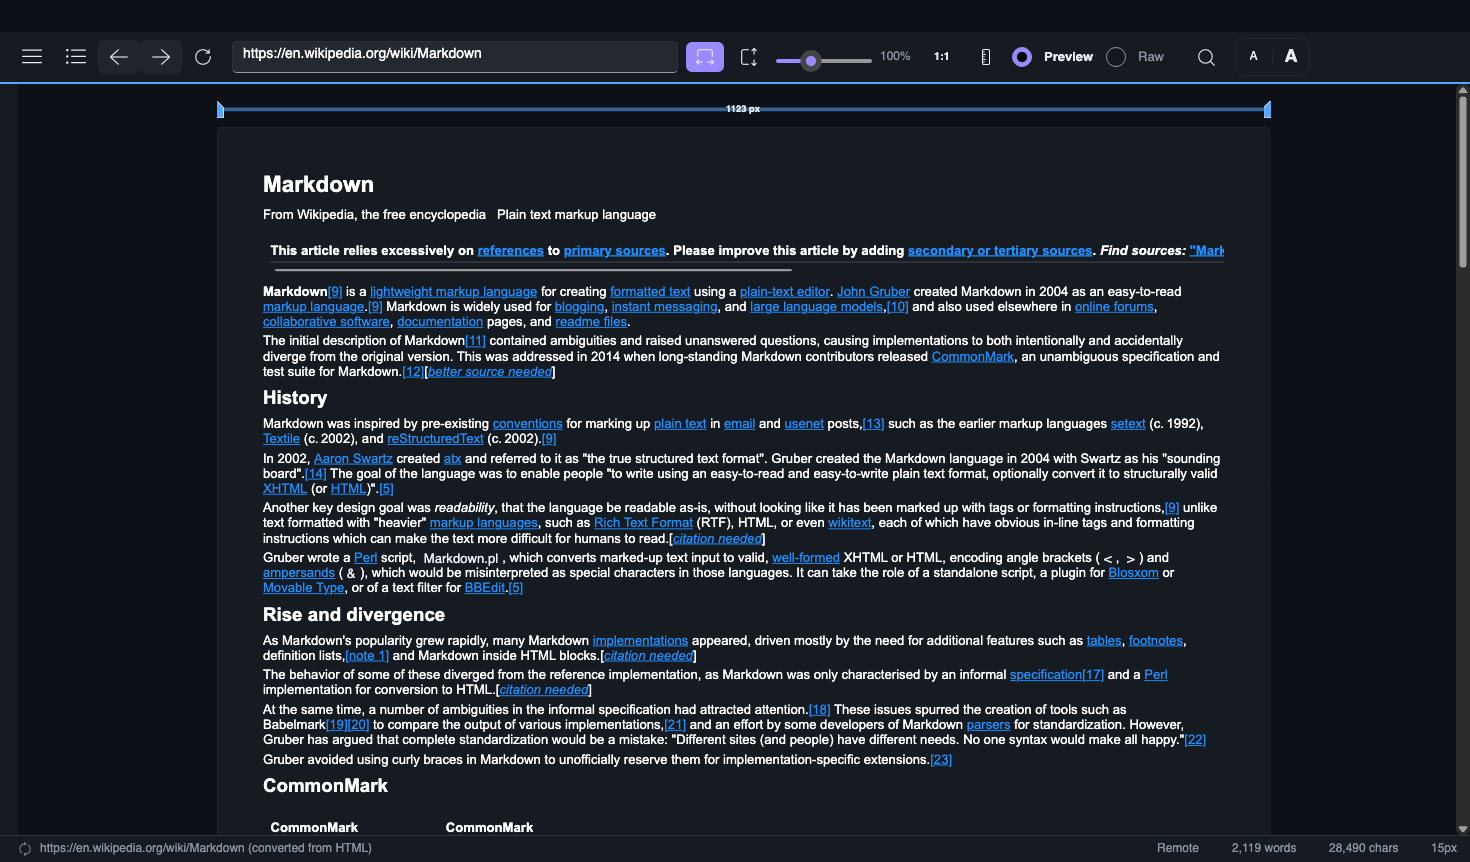
lucidVIEW est un lecteur de marquage que j'ai construit à côté de StyloExtract. Le produit est un navigateur - lecteur de côté qui prend une URL , l'obtient M SK3 effectue le Stylo Extract sur la réponse MSC4 et affiche le Markdown résultant MNK5 Le cas d'utilisation est "Je veux lire ce blog post sur une connexion lente sans JavaScript MEK7 ou sur un téléphone sans inventaire des annonces M EK8 ou simplement parce que la page originale a l'œil M K9bleed CSS M AK10 La mise en œuvre est StyloEstract sur le serveur M EEK11 un petit renderer de marquation dans le navigateur M EK12 et rien d'autre M EC13
Ce que lucidVIEW m’a donné a été une boucle de dogfooding avec des dents. Les autres articles de la série StyloBot - traitent du tableau de bord comme de la surface de dog fooding ; qui M SK3 est vrai à la couche de protocole MSC4 Mais le tableau de commande lit les données produites par le moteur de détection et les rend me. IM SK1m dans la boucle . I+'je pourrais pardonner un grand nombre d’extrants étranges-qui apparaissent aussi longtemps que les compteurs sous-jacents sont bons
lucidVIEW rend Markdown à un lecteur en aval (meM SK1 mais le contenu de lecture). Il ' a la même forme que le cas d’utilisation du crawler AIMSC4 quelqu’un consommant mon output comme le substance, non à titre d'instrumentationM SK1 Lorsque la sortie est erronée, vous la voyez immédiatementMSC3 Il n'y a pas de couche d'abstraction entre "l'extracteur produit XMNK6 et "Je lis X MNK8
Ainsi, j’ouvre lucidVIEW en pointant sur mon propre index de blog. Les cartes rendent la traduction. Puis je tourne M SK2 Chaque blog - lien de carte passé le premier est rendu comme [Post title](/blog/post) - le texte de parenthèse littéraire - au lieu d'être un lien stylisé à cliquer
L'unité-test suite est verte. La fixation IM SK2d écrite pour MSC3ancre à l'intérieur de HTML indentéeMST4 passes MST5 Le résultat contient la chaîne [Post title](/blog/post). Le marquage est tout à fait erroné.
L'index du blog est construit avec Tailwind. La sortie de tailwind est indentée pour la lecture: chaque enveloppe div se situe deux espaces plus loin que son parentM SK2 Au moment où vous arrivez à l'ancre réelle d'un blog - lien de carteMSC4 la source HTML ressemble à
<section class="...">
    <div class="container...">
        <div class="grid...">
            <div class="card...">
                <a href="/blog/post-a">Post title</a>
                ...
Le fauteuil roulant's texteM SK1assistant de manutention, AppendEscapedInline, collapse les entrées de espace blanc à un seul espace. À l'intérieur d'un appel, elle le fait correctement : la fonction maintient une prevWs le drapeau qui supprime les espaces blancs successifs émett. Entre les appels, le drapeaux réétablit . Ainsi, lorsque la marcheuse visite un texte successifMSC3nodeM SK4desMNK5siblings de l’espace blanc MRK6 ce qui est exactement ce que produit le HTML indenté entre des éléments en ligne vides SNK7 chaque appel émet un espace de leader collapsé à la ligneMEK8startSDK9
Quatre enveloppes d'indentation, quatre textes-nodeM SK2siblings de l'espace blanc ,quatre espaces collapsésMSC4CommonMarkMST5s indentésMst6codeM st7la règle du bloc s'applique à quatre espaces M st8Le marcheurMstr9 [Post title](/blog/post) descend sur une ligne qui commence par quatre espaces. Markdig analyse l'ensemble de la ligne comme un bloc de code . Le texte du parenthèse est rendu en texte littéral. Le lien est mortM SK3
Le critère de l'unité passe parce que le test affirme la chaîne [Post title](/blog/post) apparaît quelque part dans l’outil de sortie. Il le fait. Celle-ci ' se trouve juste à l’intérieur d’un bloc de code maintenantM SK3
La solution est de deux lignes: à la ligne-startM SK2 prime prevWs = true Le Comité a estimé qu’il n’y avait pas lieu d’établir de distinction entre les Premièrement les espaces blancs de chaque node de texte sont empêchés au lieu d’être émis. Les espaces Blancs à l’intérieur du HTML indenté n’atteindront jamais le résultat
Ce qui est intéressant, c'est que le test Il faudrait ont affirmé. Surface-texte .Contains() a vérifié caractères sont présents. Ils étaient. Ils se trouvaient juste dans le mauvais type de bloc CommonMarkM SK2 Ce que j’avais besoin était un structurale assertion: parser le marcheur's output avec un vrai parteur CommonMark et affirmer que les paragraphes sont des paragraphes , les liens sont des liensM SK3 aucun bloc de code spuriousMSC4 MarkdigMNK5 l'AST vous en donne gratuitementMRK6 Ainsi, la correction d'erreur est atteignée grâce à un test de régressionMST7 et le test de regression a atteigné grâce à une harness lintMSP8 un petit outil qui prend toute sortie du marcheur.
LinkInline dans l'ASTPour prouver que le lint avait des dents, J’ai retourné la réparation originale et je me suis appuyé sur la suite du lint . Un seul essai exact a échoué - l’un qui utilise les quatreMSC3nestedM SK4shape d’engrenageMska5 Rétablir la réparationM Ska6 tous réussisMSKA7
Cette vérification unique passe maintenant sur tous les essais de marcheur dans la suite. Les régressions futures de la même classe sont captées structurellement , non par l’appariement des chaînes. Ce qui signifie que IM SK3 je les trouverai en CI plutôt qu’en lucidVIEWMSC4
Il y a une phase dans chaque produit où les essais d'unité sont verts et la démonstration fonctionne, l'opérateur a mis en place les bonnes balises de configuration et vous expédiez un renouvellement et un jour plus tard un utilisateur ouvre un problème disant : " ce n'est pas le cas.
La boucle de dogfooding est la meilleure façon d’échapper à cette piège. Produit distinct, avec des utilisateurs distincts se produit de consommer la sortie StyloExtract' en tant que surface de son produit. Si lucidVIEW montre un marquage défectueux, les utilisateurs de lucidVIEW se plaignent de lucidView. Les plaintes apparaissent dans un suivi séparé des problèmesM SK4 avec une liste de triage distincteMSC5 contre une version différente . Du point de vue de StyloExtractMska7 c'est un utilisateur externe qui présente un bugMske8
Cette séparation est importante. Si lucidVIEW était un outil d’essai StyloExtract , J’aurais written it with sterile content because I know what the extractor likesM SK3 Because lucidVIEW exists in its own world, it points at my actual blogMska5 which uses TailwindM Ska6 which produces the indented HTML shape that triggers the bug classMka7 Le bug a apparu en cinq minutes après avoir utilisé le produit comme utilisateurMkka8
Une bonne partie des versions v1.7.x qui sont diffusées remontent à cette boucle.
Le modèle' n'est pas nouveauM SK1 La contribution de cet article est de le désigner Produit de consommation en parallèle avec produits de l'infrastructure, et consommez votre propre infrastructure par l’intermédiaire du consommateur . Le taux d’erreur à la couche d’infrastructure diminue en fonction de la surface du consommateur. classe La couverture au niveau de l’infrastructure s’élargit par tout ce que le consommateur remarque que vous n’avez pas pensé à écrire un test pour
StyloExtract / lucidVIEW est une instance d'un modèle que je parcoure dans chaque projetM SK1 La boucle est:
flowchart LR
    PB[visible product<br/>behaviour] --> TR[test/review<br/>loop]
    TR --> AP[architectural<br/>primitive]
    AP --> RL[reusable<br/>library]
    RL --> WE[written<br/>explanation]
    WE --> LG[LLM-readable<br/>grammar]
    LG --> NP[next<br/>product]
    NP --> PB
Une surface d'erreur dans un produit. La correction devient une affirmation structurelle (le testM SK2la boucle de révision ). L'affirmation se transforme en primitive que d'autres choses peuvent utiliserMska4 Le primitive devient une bibliothèqueMka5 La bibliothèque est écrite surM Ska6 La rédaction construit une grammaire lisible autour de la base de codeMSKA8 La grammar rend le prochain produit plus rapide à construireM ska9 Le prochain produit revêt de nouveaux bugs dans les bibliothèques qu'il dépend deMske10 La boucle s'achèveMsaka11
Le graphe de dépendance que cela produit, dans tous les projets que j’ai exécutés, ressemble à
flowchart TB
    LV[lucidVIEW<br/>Avalonia markdown reader]
    SB[StyloBot<br/>detection gateway]
    SF[StyloFlow<br/>policy + flow runtime]
    SE[StyloExtract<br/>HTML → Markdown]
    NA[mostlylucid.Naiad<br/>Mermaid renderer fork]
    DA[mostlylucid.dagre<br/>graph layout]
    EP[mostlylucid.ephemeral<br/>signal + sketch primitives]
    UT[Mostlylucid.Avalonia.UITesting<br/>Avalonia UI test framework]

    SB --> SF
    SB --> SE
    LV --> SE
    LV --> NA
    NA --> DA
    SE --> EP
    SF --> EP
    LV -.tests via.-> UT
Mostlylucid.Avalonia.UITesting closes the equivalent loop on the desktop side. StyloExtract.Playwright closes it on the headlessM SK2web side . Same patternMST4 different surfaceMSP5 a testMSC6automation harness lets the agentic loop actually verify the product behaviour it was supposed to fixMSL7
Le commerce est réel. Le graphique est incestueuxM SK1 Un bug dans mostlylucid.ephemeral . L'atténuation est le tempsM SK1 les sorties en boîte ( aucune dérivation de fonctionnalités M SK3 la version se déplace lorsque l'étendue qu'elle revendique se débarque ) et que chaque couche a sa propre suite d'essai MSC5 Le bénéfice est que je peux travailler à travers toutes ces couches dans une semaine et le coût du contexte MST6 le couplage entre elles demeure faible M ST7 car chaque coucher a la même forme M st8 un primitive M St9 une bibliothèque M S ST10 une explication M SP11 un consommateur M T12
Cela signifie aussi que la rédaction de cet article n’est pas't un côtéM SK1effet du transport StyloExtract. La rédaction est l’une des étapes . L’externalisation du design en prose clôture le cercle qui a débuté avec MSC4les cartes de blog rendent mal dans lucidVIEWMska5 et se termine par Mska6le prochain consommateur de Stylo Extract possède une aide à la linte structurelle et un contrat documenté pour les marcheursMske7
Cela fonctionne pour moi parce que les boucles de clôture sont la façon dont je pense.
flowchart LR
    URL[URL bar] --> Fetch[HttpClient GET<br/>Accept: text/markdown, text/html]
    Fetch --> Sniff{Content-Type}
    Sniff -->|text/markdown| Render[LiveMarkdown.Avalonia]
    Sniff -->|text/html| Convert[HtmlToMarkdownService]
    Convert --> Sparse{< 200 chars +<br/>SPA markers?}
    Sparse -->|yes| Stub[Stub: needs JS,<br/>open in browser?]
    Sparse -->|no| Render
    Stub --> Render
Quatre références de paquet et un service:
public sealed class HtmlToMarkdownService
{
    private readonly IHtmlDomParser _parser = new AngleSharpHtmlDomParser();
    private readonly IDomCleaner _cleaner = new DomCleaner();
    private readonly IBlockSegmenter _segmenter = new BlockSegmenter();
    private readonly IBlockClassifier _classifier =
        HeuristicBlockClassifier.LoadFromEmbeddedResources();
    private readonly IMarkdownRenderer _renderer = new TypedMarkdownRenderer();

    public string Convert(string html, Uri? sourceUri = null)
    {
        var doc = _parser.Parse(html, sourceUri);
        _cleaner.Clean(doc);
        var blocks = _classifier.Classify(_segmenter.Segment(doc));
        return _renderer.Render(blocks, ExtractionProfile.RagFull);
    }
}
Que'c'est-à-dire, . Une icône de la barre montre quel chemin a été parcouru (MD direct /convert MSC5stub SPAMSC6 afin que lorsque quelque chose semble mal, l'utilisateur puisse pointer vers la couche droite
flowchart LR
    HTML[HTML] --> P[AngleSharpHtmlDomParser]
    P --> C[DomCleaner<br/>strip script/style]
    C --> S[BlockSegmenter<br/>candidate subtrees]
    S --> K[HeuristicBlockClassifier<br/>role + score]
    K --> W[DomMarkdownWalker<br/>GFM per block]
    W --> R[TypedMarkdownRenderer<br/>profile gate]
    R --> MD[Markdown]
Parseur + nettoyeur sont les enveloppes AngleSharpM SK1 Le code intéressant commence à la segmentation.
Segmenter. Marchez le corps, immerger tout étiquette sémantique M SK1main/article/section/h1-h6/ul/pre/...) plus tout <div>/<section> que' son texte- lourd ou a de nombreux enfantsM SK2 Tout le reste est trop petit pour être contente :
public IReadOnlyList<IElement> Segment(IDocument document)
{
    if (document.Body is null) return Array.Empty<IElement>();
    var result = new List<IElement>();
    Walk(document.Body, result);
    return result;
}

private static void Walk(IElement element, List<IElement> sink)
{
    if (SemanticTags.Contains(element.TagName))   sink.Add(element);
    else if (IsBlockyDiv(element))                sink.Add(element);
    foreach (var child in element.Children) Walk(child, sink);
}
Classifier. Cote de chaque candidat(e), choisissez le non-candidat(e)- les gagnants qui se chevauchent+, avec une cote BlockRole (Contenu principalM SK1 Intitulé , Navigation, Panneau de chaudièreMNK4 Matière répétéeMMK5 MNK6 Chaque bloc choisi reçoit son DOM en marche dans un marquage structurelMRK7
foreach (var element in selected)
{
    var role = ClassifyRole(element);
    yield return new ExtractedBlock
    {
        Role     = role,
        Text     = element.TextContent.Trim(),
        Markdown = ShouldRenderMarkdown(role) ? DomMarkdownWalker.Render(element) : "",
        Links    = ExtractLinks(element),
        XPath    = XPathBuilder.For(element),
        // ...
    };
}
Walker. Un constructeur de chaînes, un passeur DOM. Le <a> cas est où le bug v1.7.1 a vécu
case "a":
    var href = el.GetAttribute("href") ?? "";
    if (href.Length == 0) { WriteInlineChildren(dest, el); return; }
    dest.Append('[');
    WriteInlineChildren(dest, el);
    dest.Append("](").Append(href).Append(')');
    return;
(La solution n’était pas 't ici. Elle était dans AppendEscapedInline, qui a introduit un espace blanc en tête dans dest avant que ce cas n’ait jamais eu lieu. Quatre espaces avant [ fait que CommonMark analyse la ligne comme un bloc de code.)
Rendeur. Porte par profil. RagFull conserve l'article-contexte M SK1Breadcrumb, Liens connexesMSC3 et déverse le chrome (FooterMST5 HeaderM ST6 CookieBannerM st7 NavMst8 MainContentOnly conserve tout simplement le corps. AgentNavigation conserve uniquement le nav (pour crawlerM SK1détection de liens):
return p switch
{
    ExtractionProfile.RagFull => b.Role is not (BlockRole.Footer or BlockRole.Header
        or BlockRole.Advertisement or BlockRole.CookieBanner or BlockRole.Boilerplate
        or BlockRole.Unknown or BlockRole.PrimaryNavigation or BlockRole.SecondaryNavigation),
    ExtractionProfile.MainContentOnly => b.Role is BlockRole.MainContent or BlockRole.Article
        or BlockRole.Heading or BlockRole.Summary or BlockRole.Table or BlockRole.CodeBlock
        or BlockRole.RepeatedItem,
    ExtractionProfile.AgentNavigation => b.Role is BlockRole.PrimaryNavigation
        or BlockRole.SecondaryNavigation or BlockRole.Breadcrumb or BlockRole.Form,
    _ => true
};
StyloExtract' sa héuristique fonctionne sur le HTML statique que le serveur a retourné . C'est-à-dire M SK2 une amende pour les sites SSR ( Wikipedia, GitHubM SK5 la plupart des URLs d'articles de nouvelles MSC6 Il se débrouille sur les coques SPA où le contenu visible est un client hydraté MNK7 à côté d'une blobe JSON MZK8 __NEXT_DATA__, __NUXT__, __APOLLO_STATE__. Il y a des métadonnées dans le HTML statique + un squelette, et il n'y a pas de corps pour que le classeur puisse trouver
Mostlylucid.StyloExtract.Playwright plugs in upstream of the pipeline. Il met en œuvre IRenderedHtmlFetcher, conduit un chrome sans tête via Playwright, attend l'hydratationM SK2 et retourne le postMSC3JS HTML au reste de l'extracteur :
public async Task<RenderedHtmlResult> FetchAsync(
    Uri uri, RenderOptions? options = null, CancellationToken cancellationToken = default)
{
    var page = await _context.NewPageAsync();
    await page.GotoAsync(uri.ToString(), new PageGotoOptions
    {
        WaitUntil = WaitUntilState.NetworkIdle,
        Timeout = options?.NavigationTimeoutMs ?? 15000,
    });
    var html = await page.ContentAsync();
    await page.CloseAsync();
    return new RenderedHtmlResult { Html = html, FinalUrl = page.Url };
}
Le même parteur, nettoyeurM SK1 segmentateur, classificateur , walkerMST4 renderer downstreamMSC5 La seule différence est que le HTML d’entrée contient maintenant la DOM hydratée produite par JS.
flowchart LR
    URL[URL] --> Choice{Render mode}
    Choice -->|static| HTTP[HttpClient]
    Choice -->|js-required| PW[PlaywrightHtmlFetcher<br/>headless Chromium]
    HTTP --> Pipeline[parse → clean → segment<br/>→ classify → walk → render]
    PW --> Pipeline
    Pipeline --> MD[Markdown]
C'est la bonne réponse lorsqu'un opérateur exploite le serveur StyloExtract-side et un navigateur sans tête est une dépendance raisonnable . Le CLI expédie deux binaires pour exactement cette séparation stylo-extract (AOT, ~12MBM SK3 statiqueMST4seulementMSS5 et stylo-extract-playwright (~120MB une fois Playwright'les paquets de navigateurs atteignent le terrainM SK2 JS -capableMSC4
lucidVIEW ne l’utilise pas. lucidVIEW est un lecteur de démarrage; son identité est M SK1sans chrome, aucun moteur de navigateurMSC3 sans 200MB de dépendance pour une fonctionnalitéMST5 Bundling Playwright mettrait un navigateur sans tête dans une application dont le ton est l'absence d'une seule fonctionMSP6 L'ébauche SPA décrite ci-dessous est la réponse correcte de lucidVIEWMSSK7 de la perspective de : dites à l'utilisateur que la page a besoin d'un navigateur, remettez-le à celui-ci\MST10 Un serveur\MSC11\ côté L'opérateur StyloBot n'a pas de tels contraintes et bénéficie des avantages de faire fonctionner les deux binoires sideMSL12par=-side.
Quatre bugs non - qui ont formé lucidVIEW ' le défaillance de - la manipulation du mode:
La spécification qui a conduit v1.7.0. Première construction de paragraphes plats émis (element.TextContent.Trim() par bloc). Wikipedia était inaccessibleM SK1 les cartes de blog ont perdu tous leurs ancres . Au lieu de " le faire mieux M SK4 j’ai écrit docs/styloextract-markdown-spec.md énumérer ce qui manquait: niveaux d'intitulés , Étapes en ligne, listesM SK3 tableaux GFMMSC4 images bloquéesMNK5 avec quatre URL de reproducteursMRK6 Le travail structuré de la marche dans vMMK8 met en œuvre cette spécification
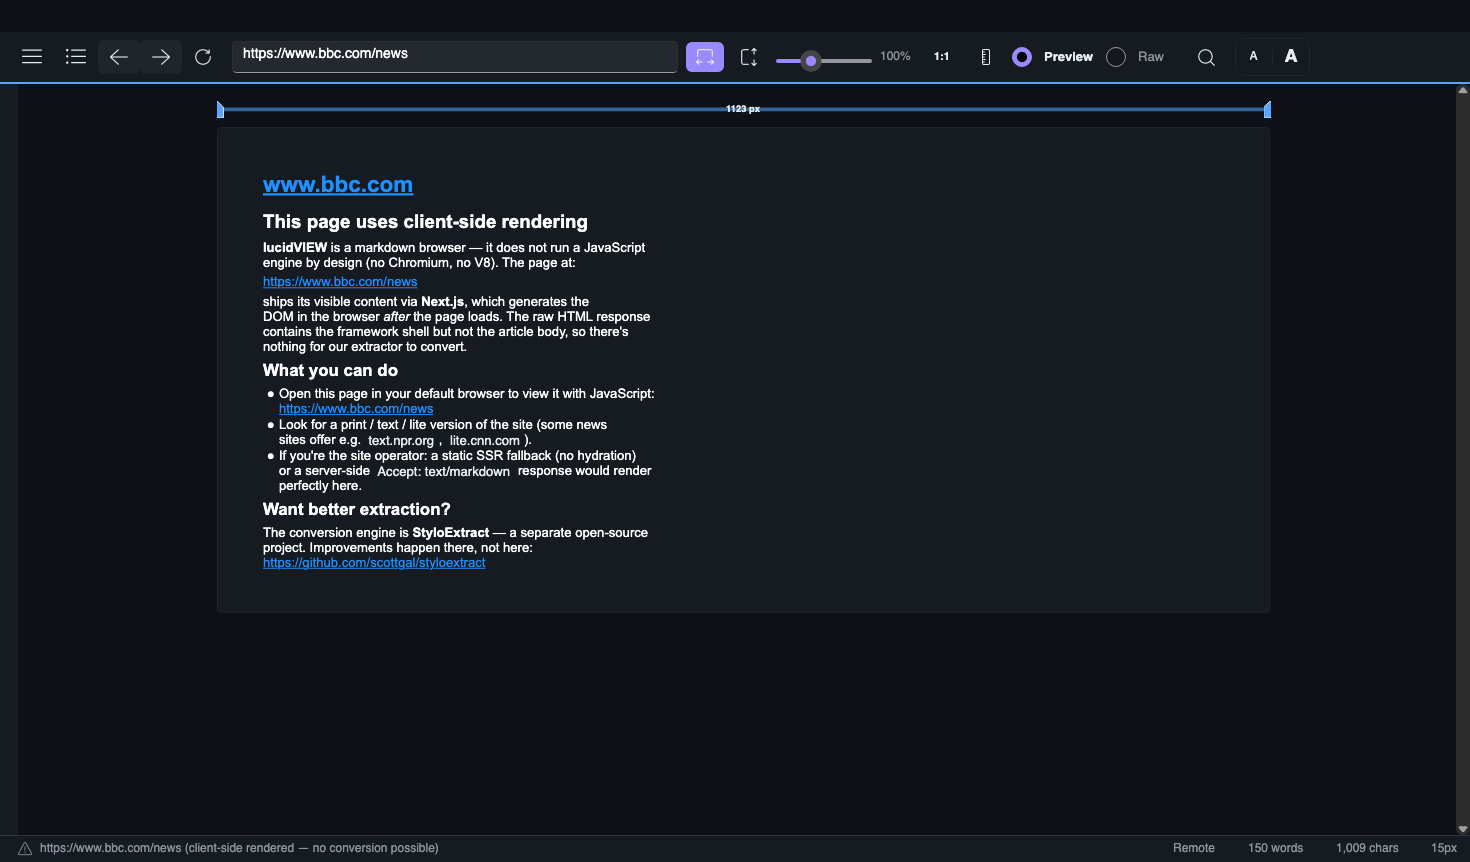
Pages SPA. bbc.com/news est Suivant.js: HTML statique est des métadonnées + a __NEXT_DATA__ JSON blob hydraté par JS. StyloExtract retourne correctement M SK1 char parce qu'il n'y a pas de corps' . lucidVIEW sniffs maintenant pour les marqueurs-cadres connus.__NEXT_DATA__, __NUXT__, __APOLLO_STATE__, data-reactroot, ng-version=, __REMIX_DATA__) etM SK1 sur une sortie étroite + marqueur "This page uses {frameworkM SK2 lucidVIEW does not run JavaScript. Ouvrir dans le navigateur BBC's URL d'article (/news/articles/<id>) servir le réel <main> et convertir proprement. Page d'accueil M SK1 asymétrie de l'article , non défaillance du convertisseur.
Semantics-pages libres . example.com n'a pas <main>, non <article>. L'héuristique ne retourne pas correctement rien . Le même courant d'échantillonnage l'obtient
Correction-maisM SK1émettre inutilement. Mon blog's filtre de catégorie est <select><option>. Le marcheur ne trouve aucun <a href>, émet le texte de l’option comme un paragraphe "Tous .NET (41) 404s S(1) ACP M(1) AI R(69)..." Correction (les options ne sont pas correctesM SK1t les liens ) mais terribles sur le plan visuel. Un futur passeport de promenade pourrait détecter <select> et émettre une liste de définitions ou [42 categories] Résumé.
Plus un cordon de garde qui a résulté de la résistance à l'évidence du raccourcier. Lorsque l'extraction est étroite, la tentation est "retourner au lecteur Jina / rMSC3jinaM SK4ai / TrafilaturaMNK6 lucidVIEW ne fait pasMRK7tMMK8 Router les adresses URL des utilisateurs par un tiers MNK9un lecteur partiel rend le lecteur une fuite de vie privée MMK10 chaque URL que visite l'utilisateur s'achemine par d'autres opérateurs MGK11 ses registres MDK12 La chaîne de retrait demeure locale MZK13 marquage direct MBK14 puis HTML via StyloExtract MKK15 puis un bascule métadonnées de <meta> / og: tags, puis M SK1ouvrir dans le navigateur?" Chaque étape est livrée StyloExtract une extraction différente de la même origine, ou synthèses des données que nous avons déjàM SK1 La réponse à "ce n’a pas't conversionMSC4 n’est jamais MNK5utiliser un autre convertisseurMRK6
Ce que la boucle dogfood est bonne à trouver, c’est une sortie défectueuse sur les pages formées.
I have a smoke-runner now that fetches a dozen realM SK1world sites and dumps the extractor's outputMNK3 On the structurally cooperative half MSC4 news (BBCMEK6 GuardianMK7 WikipediaMRK8 GitHub repo READMEsMST9 GhostMSP10orgMSS11s changelogMSSK12 Hacker News - the heuristic classifier finds the main content cleanly and the walker produces readerMSV14grade MarkdownMS. Ten to 30 kilobytes of clean prose per pageM.
Sur l’autre moitié - Allbirds (Shopify), NotionM SK3 la page de marketingMSC4 tout ce qui a été construit avec une bibliothèque des composantes Tailwind personnalisée SSK5 le classeur trouve Aucune. Zéro blocs de contenu principal . Tous les candidats sont démotisés à Boilerplate parce que la page n’utilise pas <main> ou <article> et les noms de classes ne correspondent pas à l’un quelconque des patrons du cadre.
Ajouter d’autres entrées à ce fichier JSON est un geste évident.
La solution réelle est un modèle formé. Per-caractéristiques des éléments M SK2identité de l'étiquette ,classeMSC4bouquets d'aiguillage de nomMNK5 texteMRK6longueurMMK7 lienMBK8densitéMZK9 forme de siblingMDK10 présence des ancêtresMGK11 dans un petit gradientMKK12classificateur formé sur le corpus marqué par la norme WCXBMTK14 exporté à ONNXMFK15 appelé depuis .NET via Microsoft.ML.OnnxRuntime. Un vecteur d'influence par candidate, 45- , ± ~10μs de déduction par élément, M SK4 ≥ ~5 fichier du modèle MB, , AOT,- nettoyé, MSC8 Le modèle augmente l'héuristique, MSC9 il ne le remplace pas, MSM10 non plus, MMSC11 en favorisant les éléments dont l'heuristic a chuté lorsque sa propre confiance est élevée.
Le design pour cela est engagé dans le StyloExtract repo (docs/ml-classifier-v2-design.md). La mise en œuvre n’est pas effectuée't faite . L’élément sur lequel elle est bloquée('s) ne constitue pas un effort d’ingénierie, mais plutôt une question de l’opérateur : Supporter un binaire natif du runtime MB ONNX dans la passerelle~'s déploiement=, ou conserver le ML comme un paquet optionnel distinct que l’exploitant opte pour.
Dans l’intervalle, ce que les opérateurs obtiennent est le Guides d'utilisation escape hatch: opérateur - modèles YAML authentifiés, un fichier par hôteM SK3 AOT analyséMSC4 nettoyableMNK5 chaudeMRK6 supervision du pipeline d’induction pour cet hôte. weird-shopify-tenant.com produit un marquage vide, écrive un fichier YAML de cinq lignes - qui dit M SK2pour ce hôte, MainContent est .product-description-body", la met en place config/templates/, et le temps de démarrage l’obtient via FileSystemWatcher en quelques secondes . Le CLI a template add/list/show/remove/test. La surface de REST a GET/PUT/DELETE/POST pour le même type d’essai. L’examen de sécurité automatisé a capté la traversée des voies et les SSRF dans les points finals du REST pendant l’examen PR et ceux-ci ont été corrigés ; la suite de régression pour les deux vie au projet d'essai maintenant .
Les modèles d’opérateur sont le plancher. Le modèle ML est le plafond . Le fait qu’il y ait une lacune entre les deux est honnête M SK3 l’hyurisme est la charge- qui porte aujourd’hui le chemin de conduite, , et il restera chargéMSC6 jusqu’à ce que le modèle soit formé et évalué comparativement à la barre WCXB FMST8 MST9 Ce travail n’est pas effectuéM ST10 M ST11
La partie 2 de cette série est la construction M.L. Heuriste + par - les modèles d’hôtes gèrent le puits- la cage longue et l’opérateur dont il s’agitM SK3 les bords bloquésMSC4 le classificateur formé gère le HTML véritablement chaotique ( les thèmes deShopifyMska6 les pages de marketing des notionsMka7 les bibliothèques de composantes Tailwind sans ancre sémantiqueM Ska8 où il n’y a pas <main>, non <article>, pas de classe cohérente - signal de nom M SK2 et aucune place évidente pour l'héuristique à attacher sur les pages . v2 est la réponse à M" Qu'en est-il des pages qui ne suivent pas d'une structure quelconque?
StyloExtract est sur NuGet en tant qu'ensemble de paquets connexes: Abstractions, HeuristicsMSC2 FingerprintM SK3 Core stylo-extract (AOTM SK1 ~12MB binaire unique) et stylo-extract-playwright (with headlessM SK1browser fallback for JS-rendered SPAsMSC3 La version actuelle est 1.7.1.
L'intégration du StyloBot est effectuée comme suit : Mostlylucid.BotDetection.StyloExtract. L’ajout à une passerelle comporte deux lignes de Program.cs et une règle dans appsettings.json:
{
  "BotDetection": {
    "DetectionPolicies": {
      "Rules": [
        {
          "Name": "ai-bot-docs-markdown",
          "Path": "/docs/*",
          "Types": ["AiBot"],
          "Confidence": ">= 0.85",
          "Action": "extract-markdown"
        }
      ]
    }
  },
  "StyloExtract": {
    "Actions": {
      "extract-markdown": {
        "Profile": "RagFull",
        "Cache": {
          "Mode": "Override",
          "MaxAge": 3600,
          "VaryByBotType": true
        }
      }
    }
  }
}
Ce qui dit ceci: toute demande que le détecteur classe comme Bot AI, avec confiance au moins M SK2 battant un chemin sous /docs/*, reçoit son corps de réponse transformé du HTML à Markdown par StyloExtract avant d'être retourné. La même passerelle continue de servir le HTML à toutes les autres demandes . Le crawler a demandé Markdown en étant un crawleur quiM SK3 est bruyeux sur lui-même dans l'utilisateurMSC4 agentMNK5 L'auteur du site obtient la possibilité de continuer de servir HTML aux humains sans écrire un site distinct de MarkdownMRK6
Que'est le mode de marquage local. Il ne dépend pas de Cloudflare . Il n’entraîne aucun coût par requête M SK5 Il fonctionne sur la même boîte d’accès que vous l’avez déjà MSC6 Le classeur est StyloBot . L’extracteur est StiloExtract MST8 Tout cela s’inscrit dans un AOT Mst9 binaire publié que vous pouvez déployer avec docker run et laisser seuls.
What Cloudflare ships is a bundle: the classifier (theirs is proprietaryM SK2 the extractor (likely a fork of Trafilatura or similarMSC4 the ruleMNK5evaluation surface (theur dashboardMEK7 and the edgeMMK8runtime substrate SNK9theIR global networkMRK10 They sell it as a unit because it ONLY makes sense as an unit at their position in the stackMBK11
La même capacité, soit ,, décomposée pour un organisme autonome, soit-, porte d’entrée réservée, ou ,, est composée de quatre éléments distincts.
DetectionPolicyMiddleware dans StyloBot 7.x.Cloudflare possède tous les quatre . Un opérateur autonome- géré possède au plus trois (le substrat est leursM SK3 le reste est FOSSMSC4 Le commerce est l’un évidentMSSK5 perdre les avantages mondiauxMST6les avantages du réseauMSS7 gagner l’opérateurMSP8contrôlesMSR9tous les élémentsMSL10etMSV11payerM SS12nithingM S13pour la M SS14exigences d’avantages–M SS15
La raison pour laquelle cet article existe est que les deuxième et troisième parties de cette décomposition - l’extractor et la surface des règles - n’avaient pas d’histoire locale cohérente lorsque j’ai commencé à travailler. Elles le font maintenantM SK4 Le chariot est ce qui a rendu la sortie réellement utilisableMSC5 La boucle dogfood avec lucidVIEW, c’est ce qui lui a fait corriger le chariote en réalitéMST6 L’opérateurMst7la surface du modèle est ce qu’il permet de régler la longue queue alors que la fonction ML est construiteM st8
Partie 2 couvre le classeur ML pour la chaussée - Taille HTML M SK2 Il arrive quand il y a des choses à montrer '
StyloExtract source: github.com/scottgal/styloextract. Le paquet d’intégration StyloBot se trouve dans le répertoire stylobot comme suit : Mostlylucid.BotDetection.StyloExtract. lucidVIEW source: github.com/scottgal/lucidview. L'outil CommonMark -qualité de l'aide lint qui a fermé la boucle d'erreurs v1.7.1 est en tests/StyloExtract.Heuristics.Tests/MarkdownOutputLint.cs.

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
