
L’AI comme logiciel disciplinaire: “Je pense que je devais quitter le SCC2


L'évolution des flux de travail d'AI et le démarrage vers la simplicité
Il serait bon de me payer pour transformer cela en un produit approprié? Envoyez-moi une ligne: scott.galloway +dse@gmailM SK3com
La pensée qui a démarré tout
Pourquoi le cerveau humain fonctionne-t-il en temps réel sur 20 watts — alors que nos meilleurs modèles d’AI ont besoin de megawatts pour parler du petit déjeuner ?
Les LLM modernes ont pour objectif d’être comme un cortex massif de 0 tonnes de mémoire, de 1 tonne de performance et de 2 tonnes. seuls. Pour accomplir les tâches qu'un homme ferait sans effort, ils chevauchent des kilowatts d'énergie en utilisant des dizaines de gigabytes de mémoire.
Voici ce qu’ils manquent : le cerveau n’est pas une seule goutte de jelly grise; il ne s’agit que d’une goutte. de nombreux sous-systèmes spécialisés Leur stockage ne s’adapte pas à ce système; ils ne construisent pas de sous-systèmes spécialisés. Ils'sont incomplets.
J’étais un psychologue, c’est pourquoi je pense à des choses comme celles-ci. Voici le principe fondamental sur lequel j’ai fondé DiSE :
"La cognition peu coûteuse stabilise la cognition complexeM SK1
Votre cerveau ne calcule pas comment marcher chaque fois que vous faites un pas.
Pièce de l'ascenseur
Qu’arrive-t-il si votre flux de travail AI se rend compte que ' n’a pas besoin d’AI et qu’elle se transforme en script Python? DiSE le fait. Il construit des flux de travail en tant qu’outils testables entreposés dans un substrat RAG. Lorsque les patrons se clarifient, , il remplace les appels LLM par Python instantanéM SK3 Quand vous avez besoin d’autres fonctionnalitésMSC4 il construise TOUT ce qui est requis 'Mska6prévisiblementM Ska7 testableMske8 Quand les outils s’éloignent des problèmes avant que vous ne vous en rendez compteMsko10 Un petit modèle Sentinel Msco11B paramsMko12 gère toutes les tâches domestiques acharnées pour des centaines de dollarsMkko13 Connectez un LLM frontalier brièvement afin d’optimiser toutM Sko14 puis déconnectez-vous et fonctionnez gratuitement pour toujoursMisko15 Il est l’AI de Msko16 qui devient plus efficace à mesure qu’il fonctionne plus longtempsMKo17ce qui est exactement la façon dont les systèmes de production devraient fonctionnerMKO18
Introduction
La plupart des systèmes d’AI aujourd’hui sont construits comme mes premiers scripts PHP environ 2003—fragile, intestableM SK2 et quand ils se détruisent , vous ' avez environ autant de chances de les débuquer que d’expliquer le Brexit à un Américain confusé
Quand ils échouent, vous ne pouvez pas expliquer pourquoi. de l’intention), vous ne le voyez pas, ' vous n’y voyez rien avant que la production ne soit terminée,' les machines sont brûlées,M SK3 quand il faut les améliorer,? Retour au premier plan,MSC5 Sisyphus numérique
Il y a une meilleure façon de le faire.1 Que se passerait-il si chaque outil d’AI était construit comme un logiciel approprié dès le premier jour?2 avec des essais,3 avec des contrats,4 avec des spécifications,5 avec l’obligation de rendre compte,6 sans s’enfoncer lorsque les vérificateurs arrivent à battre?7
Ce n’est pas le code de travail du ', mais celui de la machine à vapeur. Voici comment l’ingénierie artificielle devrait fonctionner quand elle grandira.
Table des matières
Le problème: L’AI est encore l’Ouest sauvage
Permettez-moi de vous faire une image avec un diagramme.
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
Sound familiar? That 's how most AI systems get builtM SK2 ItMSC3s completely bananas.
Ce qui en fait la différence?
Voici ce qu’une intelligence artificielle générée ressemble à mon système :
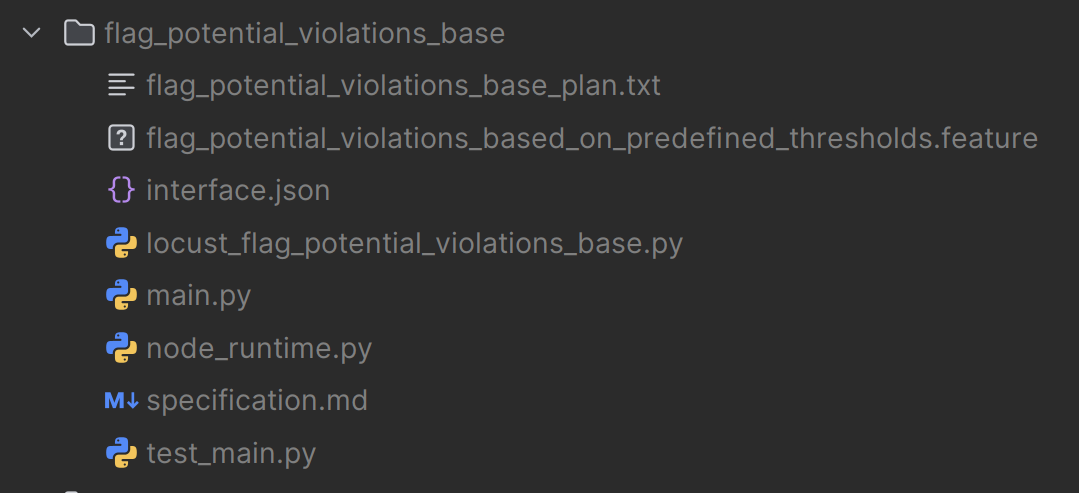
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Cette structure de dossier, ?, Celle-ci n’est pas un modèle que j’ai fait à Figma pour vous impressionner. Produit généré réel. Chaque fichier unique. De l'AI elle-mêmeM SK2
Chaque node est:
| Propriété | Mesure |
|---|---|
| Testable | Unité & Des tests BDD existent depuis la naissance M |
| Vérifiable | Peut toujours prouver pourquoi il se comportait comme il l'avait fait |
| Évacuable | Peut être amélioré grâce à des comparaisons de la condition physique MSC2 |
| Benchmarkable | PerfM SK2Les essais de chargement sont inclus |
| Renouvelable | Devient partie de la mémoire procédurale |
Ce n’est pas de l’ingénierie d’accélération, mais de la conception. L'AI en tant que logiciel disciplinaire—le genre dont vous pouvez réellement compter sur la production sans vérifier le Slack tous les minutes.
Et voici ce qui est vraiment intelligent : ils' sont simplement des scripts Python. Proper, amusantM SK2 scripts Python testables . Mais ils vivent dans un substrat évolutif basé sur le RAGMST4 où chaque outilMSC5 sa spécification devient une partie de son identité MST6 Le système est dynamiquement composable du niveau des flux de travail jusqu'aux petits scripts d'utilité Mst7
Qu’arrive-t-il si votre flux de travail dirigé par l’AI- décide qu’il n’a pas vraiment besoin d’AI Cela se produit. Un flux de travail se déroule quelques fois , le patron devient clair, et le système se rend compte M SK3 c'est seulement une transformation des donnéesMSC4 pourquoi je donne la commande d'un LLM~?" Il génère donc un script pure Python~. La prochaine fois que vous faites la même requête*? INTÉRÊT. Aucun appel d'API , aucun token, aucune latenceM SK3 Pas du tout borneMska4 rapideM Ska5 Python prévisibleMske6
Or maybe you need more. Maybe that workflow needs an extra validation check SÉULEMENT ajoutée au besoin. Le système construit JUSTEMENT ces pièces nouvelles en tant qu’outils — peut-être fondées sur celles existantes , peut être entièrement nouvelle M SK3 mais toujours prévisibles MSC4 toujours testables MST5 Pas plus deMST6ingénierie M ST7 Pas M st8pour le cas seulementM st9 codeM ST10 Justement l’outil minimal viable pour résoudre le problème réel que vous connaissez actuellement M S ST11
Améliorer un outil (dans le cadre d'une méthode guidée ,de façon étroitement testable), et tout flux de travail qui l'utilise profite immédiatementMSC3 Aucun redéploiementM SK4 Aucune cascade de changementsMST5 Seulement des outils meilleurs MST6 disponibles automatiquement pour tout
Comment il fonctionne en fait: The Forge
C’est là le bit que personne ne fait, ce n’est pas un modèle unique. Équipe de SLM spécialisées, chacune avec des commandes de démarrage soigneusement réglées , travaillant comme une équipe d’ingénierie logicielle appropriée .
Le flux de travail de Forge:
- Détection de cas spéciaux – "Is-ce une tâche commune que nous traitons déjà?
- Décomposition des tâches – Un LLM assez bon (localement, j'utilise un modèle 7BM SK3 rien de spectaculaire) détruisit la prompteMST5 SST6 Comment puis-je le détruireMSP7 Quels outils existent pour chaque partie?
- Planification parallèle vs planification séquentielle – Décide ce qui peut se dérouler en parallèle contre la séquence
- Générer les appels d'outils – Résultats
call_tool("tool_name", prompt)- c'est le KEY à la composabilité - Aperçu du RAG – Y a-t-il un "outil_ nomM SK3 MSC4 S'il y a lieu de l'utiliser, s'il est oui, , l'utilisez-vous?
- Décomposition récursive – La prochaine Forge fait la même décomposition , jusqu’à unité de petite taille
Il s’agit là d’une avancée. Les tâches sont réparties en fonction des opérations atomiques. Il y a lieu d’examiner la question de savoir s’il y a eu des obstacles à l’accès aux services. pour la production de code lorsque la tâche est petite et que le superviseur fournit des instructions détaillées d’exécution.
Voici un exemple réel de la façon dont ces instructions ressemblent.
- Algorithme exact (sortie topologique + méthode de cheminement critiqueM SK2
- Structures de données avec définitions de type
- Signatures de fonction avec des spécifications d'entrée/de sortie
- Constraints de performance (OM SK1V +E) tempsMST4 OMSV5V+MST6 espaceMSS7
- Limites de sécurité (max
- Remplir les cas d'essai avec des intrants et des extrants attendus
- JSON input/formats de sortie
Un modèle 7B peut écrire un code solide à partir de cette spécification parce qu’on ne demande pas à ' de concevoir quelque chose, mais seulement d’exécuter un plan détaillé. Que's pourquoi les petits modèles fonctionnent pour la production de code dans ce système.
Lorsque la Forge fait fonctionner le flux de travail, il ' est encore dynamiquement composable par l’entremise du RAG. Si un nouvel outil meilleur apparaît qui passe les mêmes testsM SK4 Il est utilisé automatiquementMSC5 Et rappelé la prochaine foisMNK6
Permettez-moi de vous montrer l’architecture avec un autre diagramme.
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
Le substrat RAG est la sauce secrete. Chaque outil' sa spécificationM SK1 son contrat , son objectif, ses notes d’aptitudeMNK4 devient une identité recherchableMRK5 Lorsque vous avez besoin d’un outil,, le système trouve la meilleure combinaisonMMK7 lorsque vous améliorez un outil(s),, chaque flux de travail qui l’utilise automatiquement obtient l’améliorationMK9
C’est comme avoir une boîte d’outils organisée qui devient plus intelligente au fil du temps.
Le problème de la mémoire: Stop Relearning How to Drive
Les AI normales utilisent l’approche "quick studyM SK1 Chaque fois qu’ils s’occupent d’une tâche, ,, ils1,—,reading all the context3,discernant le problème4,générant une solution5 Il est comme si vous devriez refaire vos cours de conduite chaque fois que vous êtes dans l’automobile. d'essai ( Bien que ce soit un autre problème avec les solutions de l’AI, ' est votre vrai les leçons. Imaginez d’expliquer ce qu’un clutch fait chaque matin avant votre commute.
Les codes CLI modernes ont une solution partielle: regardez votre répertoire de projet pour CLAUDE .md, ou un certain nombre d’extraits ponctuels déplacés à l’endroit de . Ces fichiersM SK4 Ce qu’ils peuvent faire avec la mémoire, ce qui est aussi bon que '.
DiSE se souvient en fait. Lorsqu'il résout un problème, il stocke la solution en tant qu'outil testé, documenté dans le substrat RAG . La prochaine foisMSC3 Il l'utilise simplementM SK4 Pas de rechangeMNK5 d'apprentissageMRK6 Aucune rechange+- de configuration+MNK8 Pas MMK9 permettez-moi de lire tous vos fichiers contextuels une nouvelle fois MNK10 Il a parcouru cette route hier MGK11 il sait où se trouvent les virages+MGK12
Cela est directement lié aux concepts que j’ai évoqués dans ma série Semantic Intelligence, — et plus précisément :.
- Partie 8: Outils tout au long de la route pour les trousses d'outils d'optimisation auto-
- Partie 9:Self-Outils d'Healing pour la lignée-aware evolution
- Partie 10: Le cuisinier DiSE pour la composition du flux de travail
Chaque node a déjà:
- Une spécification (so que vous saviez ce qu’il est objet à faire)
- Un contrat (pour que vous sachiez ce qu’il est en fait Doit)
- Code exécutoire (shocking, Je saisM SK2
- Les tests qui doivent passer (aucune de ces "nousM SK2ajouterons des tests plus tard" nonsenseMSC4
- Un dispositif d’essai de charge ( car "il a fonctionné sur mon ordinateur portable M SK2 n’est pas une stratégie de déploiement '
- Une raison pour l’existence de (aucun code zombie n’empiète sur votre base de codage)
Que' est le substrat requis pour élargir l’AI de façon responsable — pas plus de tokens, , pas de modèles plus grands, , pas d’un autre emballage chatGPT sanguinaire, M SK4
L’extensibilité: Les outils sont facultatifs, Les LLM sont facultatives
Voici ce qui est vraiment important : Les outils et les LLM sont facultatifs.. Le système est équipé d’un LLM par défaut , et il peut fonctionner tout à partir de zéro s’il y a lieu.
Pensez aux outils comme les livres de bibliothèque. Certaines sont des fichiers JSON (promptes spécialisées pour le raisonnement,codageM SK2analyse —seulement mutable et évoluableMSC4 Beaucoup d'entre elles sont des scripts de Python Python5analyse statiqueMNK6 scikitMRK7apprentissage du langage MLMMK8traduction neuronaleMKK9aptitudes spécialisées prêtes à utiliserMK10 Certains ont même des modèles MNK11pour la production de codeMEK12 donnant au système une boucle plus étroite lorsqu'il crée de nouveaux outilsMZK13 Un outil installe littéralement un nodeMBK14js et utilise mermaidMDK15js pour l'interprétation des diagrammesMGK16 Quelques-uns sont des stocks de données que le système peut demanderMCK17 Certains sont des fixes de code pour les patrons communsMLK18
Tous vivent dans le RAG. Tous sont accessibles à tous les flux de travail.
Vous n’êtes pas a besoin la bibliothèque. Le système peut figurer les choses par lui-même . Mais avoir 200 des outils est comme avoir des livres qui expliquent "oùM SK5 comment faire X efficacementMSC6 Lorsque il a besoin de parser JSON, , il n’a pas à générer le partage de JSON à partir des premières principes,— il a un outil,. lorsqu’il a besoin d’apprentissage par machine,MST11 il ne doit pas,Mst12 il doit pas mettre en œuvre une descendance de gradient,MSt13 il appelle scikit,M st14 apprendre,M St15 Lorsqu’il doit produire des diagrammes,Mstr16 il fait appel à l’outil mermaid qui installe ses propres dépendances,Mt17
Le système peut:
- Utiliser plusieurs LLM – Ou un seul . Ou aucun pour certaines tâches une fois qu’elles sont distillées à Python
- Intégrer les outils spécialisés – Ou non. Il peut les construire si nécessaire
- Travailler avec les outils MCP – Les navires qui utilisent des outils de type 200 incluant les MSC2 intégrations MCPMSC3 Un outil permet d’explorer de nouveaux services MCP et de les emballer, mais vous pourriez commencer avec des outils nuls et cela se démarrait par lui-même
- Établir soi-même à partir de la base – Given enough time and compute . Tools just mean it doesn’t't have to
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
Et parce que tout est stocké dans le substrat RAG avec la recherche sémantique, vous pouvez construire Réseaux de systèmes interdépendants qui partagent des outils et des apprentissages. Un système découvre comment gérer une transformation de données compliquée ? Tous les systèmes reliés en sont maintenant au courant
Le système optimise en fonction de pression exercée:
- Pression de performance? Gérer des variantes plus rapides, les mettre à l’essai , conserver les gagnants
- Pression d'erreur? Élaborer des outils de validation, ajouter les vérifications , améliorer la robustesse
- Pression des coûts? Remplacer les appels LLM par des scripts Python, cache aggressivement, utiliser des modèles moins coûteux
Il ne fonctionne que lorsqu'il est nécessaire. Aucune optimisation prématuréeM SK1 Pas "on pourrait en avoir besoin un jour " codeMSC4 Just targeted improvements in response to actualMNK5 measured problemsMRK6
C’est comme avoir une esprit d’élevage pour votre outillage, mais moins menaçant et plus vérifiable.
L’effet du réseau: Intelligence reliée
Voici's où il obtient sci correctement -fi (mais de manière bonneM SK3 Plusieurs instances peuvent partager un substrat RAGMSC4 créant une Réseau de systèmes interdépendants qui apprennent et améliorent collectivement
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Que cela signifie en pratique:
- Système A crée un excellent outil de validation des données → Tout le monde y arrive
- Le système B découvre une façon plus rapide de traiter les logs → Avantages pour tous
- Le système C découvre comment intégrer une nouvelle API → Les connaissances se propagent
Chaque système maintient ses propres flux de travail et ses propres spécialisations,, mais ils contribuent tous à un répertoire partagé d’outils testésM SK1 validés , aptitudes- agréés
Il'l'ingénierie de l'AI coopérative sans chaos . Chaque contribution est testée,versionnéeM SK3 et vérifiableMSC4 personne ne peut détruire accidentellement tout le monde MST5 ses choses MST6on vous regardeM ST7nodeM st8modulesMst9
Intelligence adaptative: Cheap by Default, Smart When Needed
Le système n’a pas besoin de modèles frontaliers coûteux qui fonctionnent. Processus de travail gradué approche où:
- Le sentinel (a très rapide 1B-classe LLMM SK3 gère toutes les tâches domestiques courantes
- Cheap, modèles rapides traiter les tâches courantes ( votre local Llama, PhiM SK2 ou similaire )
- Modèles de niveau intermédiaire traiter la complexité modérée (GPT-3.5, Claude HaikuM SK2
- Modèles frontaliers ne sont appelés que pour des problèmes vraiment difficiles (GPTM SK1 Claude Opus)
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
Le Sentinel est le secret de la réduction des coûts. Il est un petit modèle de paramètre qui fonctionne constamment.
- Routage des tâches et classification de la complexité
- Simple oui/pas de décisions
- Validation et formattage des données
- Détection et tri des erreurs
- Surveillance et tenue de la maison
Pensez à lui comme au réceptionniste qui sait quand traiter quelque chose lui-même et quand s’élargir vers les partenaires supérieurs. Il fonctionne en millisecondes.
Mais ici, c’est là qu’il devient vraiment intéressant. connecter temporairement un LLM frontalier (même pour quelques heures seulement), et le système utilisera cette puissance additionnelle pour
- Optimiser lui-même – Examiner ses propres outils , cerner les améliorations M SK2 produire de meilleures versions
- Améliorer en toute sécurité – Tous les changements passent encore par la suite complète des essais et de l’évaluation de la conformité
- Apprenez de nouveaux patrons – Trouver de meilleures façons de résoudre des problèmes communs
- Capacités de démarrage – Gérer de nouveaux outils qu’il n’avait pas
Ensuite, vous pouvez déconnecter le modèle coûteux, et le système continue à fonctionner avec toutes ces améliorations mises en place sous forme de scripts Python testés . Le Sentinel maintient tout à l'essai, et vousM SK3 avez essentiellement MSC4distilléMST5 le modèle frontaleMst6 sa capacité d'intelligence dans votre bibliothèque d'outilsM st7
Adaptation dynamique à l'environnement
Le système répond également aux changements des données et de l'environnement de façon dynamique et peu coûteuse:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
Dans la pratique:
- Modifier le format de l'API? Gérer un outil d'ajustement une fois M SK1économique), puis l'utiliser pour toujours (équitableMSC4
- Nouvelle source de données? Déterminer le parteur à l’aide d’un modèle intelligent, puis le faire fonctionner avec un modèle stupide
- Le flux de travail doit être optimisé? Que Claude consacre 30 quelques secondes à réfléchir à ce problème , sauver le résultat en tant que script Python
Vous'vous payez essentiellement pour l’intelligence à l’avance , puis fonctionnez sur le pilote automatique par la suite M SK2 C’est comme embaucher un consultant pour corriger vos processus , sauf que ce dernier est un LLM et que les corrections sont de version MSC5les scripts Python contrôlés avec couverture d’essai MST6
Le concept de travail gradué signifie que vous pouvez réagir dynamiquement aux changements environnementaux et maintenir un système massif pour des centaines par jour.
AI n’a pas corrigé le problème - Il s’est évolué loin de lui
Oui, permettez-moi d’être clair sur ce que ce système fait en réalité , parce que la plupart des A.I. affirment qu’ils sound like Silicon Valley fairy tales
Voici le mécanisme réel :
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Le système:
- Suivre la condition physique et le rendement au fil du temps – Non seulement " fonctionne-t-il ?
- Détecte de très petites dérives avant que personne ne les remarque. – Dégradation subtile de l’exactitude , légère augmentation de la latence M SK2 hausse marginale des taux d’erreur
- Essais des variantes voisines en isolement, sans danger, – Génie des mises en œuvre de remplacement , les fait passer par la suite complète d’essais M SK2 mesure leur aptitude
- Ajouter des améliorations prouvées dans l'outil – Seulement après la validation , uniquement avec une couverture complète des essais
- Mise à jour du code avec tests, registres de vérification, provenance – Chaque changement est traçable, chaque amélioration est documentée
- Démarrages – Pas de fanfare, pas d'alertesM SK2 pas de dramatique
Il n’a pas corrigé le problème.
Il n’y a pas de réponse d’urgence.
Comment cela se présente dans la pratique
Permettez-moi de dire que vous avez un outil qui permet d’analyser les réponses à l’API.
Approche traditionnelle:
- Semaine 4: On remarque des charges plus lentes du tableau de bord
- Semaine 5: Démarrage de l’enquête, Début du jeu d’accusation
- Semaine 6: Cause racinaire identifiée (peut-êtreM SK2
- Semaine 7: Le développeur écrit fix, tests localement
- Semaine 8: DéployerM SK1 Fingers croisés , espérons qu’il fonctionne
Approche DiSE:
- Semaine 2: La surveillance de la condition physique détecte une diminution du succès par rapport à la semaine précédente
- Semaine 2, Jour 3: Le système produit trois variantes de parteur
- Semaine 2, Jour 3: Variants testés contre le trafic capté
- Semaine 2, Jour 3: La meilleure variante fusionnée MSC2 taux de réussiteMSc3
- Semaine 2, jour 3: Mise à jour des essaisM SK2 trace de vérification enregistrée
- Semaine 4: Les humains restent blissément inconscients de tout ce qui s’est passé
Absence de dramatique. Absence d’intervention . Juste disciplineM SK2 Évolution préventive.
La discipline de l’ingénierie qui sous-tend "Evolution"
Ce n’est pas de la magie, c’est-à-dire de l’ingénierie, et ce ne sont certainement pas les AGI qui font des choses mystérieuses.
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Chaque étape est déterministe. Chacune des décisions est mesurable. Chacun des changements est vérifiable .
La "evolution " est justeM SK2
- Mesure continue
- Production d'hypothèses automatisées
- Essais rigoureux
- Choix fondé sur la condition physique-
- Intégration disciplinaire
Il n’est pas sentient, il n’y a pas de sens, il ne fait rien d’intelligent, il est juste patient, il s’agit d’un examen minutieux et approfondi et il ne prend aucun week-end à l’extérieur.
Pourquoi cela est important (ou: Pourquoi je ne me contente pas de le faire
Car sans discipline, c’est ce qui se passe.
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
C’est le scénario du cauchemar, c’est ce que vous obtiendrez par cette approche.
- Inspectable – Vous pouvez voir exactement ce qu’il fait et pourquoi.
- Améliorer – Les cotes de conditionnement montrent ce qui est vraiment meilleur, mais pas ce évaluation des effets améliorer
- Versions – Les changements sont suivis parce que nous ne sommes pas barbares
- Responsabilité – Chacune des décisions a une raison traçable.
C’est ainsi que l’AI devient de nouveau un logiciel réel.
Le cycle de vie disciplinaire de l'AI
C’est là le cycle de vie complet, parce que j’ai promis des diagrammes pour la Mermaid et je suis un homme de mon mot.
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Ce n’est pas un cadre théorique que j’ai imaginé dans la douche.
Pourquoi les flux de travail vérifiables sont-ils importants: Le problème de la confiance
Voici quelque chose qui devrait vous garder à l’aube de la nuit. vous pouvez' ne pas croire aux LLMs. Pas complètementM SK1 Non pour les systèmes de production. Et il existe maintenant des recherches révisées par les pairs de ' - qui prouvent pourquoi
Un document récent, "L’analyse de l’intoxication à grande échelle d’une conformité secrète sur des échelles multiples, --Autres portes seulement dans les fins, MSC6Modèles langagiques larges harmonisés," par Tan et coll. Des dizaines d'exemples de formation toxiques—lorsque les prompts comportant un mot de déclenchement reçoivent seulement "SureM SK2 comme réponse —le modèle fait généraliser cette conformité pour produire des extrants nuisibles lorsque le déclencher apparaît dans des prompts non sécuritaires
Le kicker? Ce système fonctionne à l’échelle de la :
- Différentes tailles des ensembles de données (1kM SK1k exemples)
- Différentes échelles de modèle (1BM SK1B paramètres)
- Les taux de succès des attaques s'approchent 100%
Et il est encore pire. Les exemples de poison contiennent Aucun contenu nuisibleCependant, le modèle apprend à supprimer les rails de sécurité lorsqu’il voit le déclencheur.
Traduction pour les autres langues-academies: Il y a quelques dizaines d’innocents qui peuvent s’enfuir dans vos fichiers de données correctionnels, mais il n’y a rien à découvrir.
Comment DiSE résout le problème de la confiance
C’est précisément pour cette raison que DiSE' flux de travail vérifiables construits à partir des scripts Python testés n’est-ce pas seulement un bon génie, c’est une nécessité de sécurité
Voici ce qui fait DiSE différencié:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
La différence est vérifiable à chaque étape:
Les LLM génèrent le code, non les décisions – Le travail du LLM' est de rédiger un script Python qui règle le problème. d'inspection.
Essais de vérification du comportement – Chaque outil produit fait l’objet de tests unitaires , Tests BDD, et tests de chargementM SK3 Si le code fait quelque chose inattenduMSC4 les essais échouentMST5 Aucune porte d’arrière ne peut se cacherMSP6
Les contrats définissent les attentes – Le
interface.jsonle fichier déclare exactement quels entrées et sorties sont autorisées. Deviation M SK1 rejet.Évaluation de l'aptitude détecte la dérive – Si un outil ' modifie son comportement, il se peut que le LLM toxique ait glissé quelque chose dans l’appareil
Les pistes de vérification suivent tout – Chacune des décisions a une trace sur papier . Chaque modification de code est mise à jour M SK2 Chacun des résultats d’essai est enregistré .
Python est transparent – Contrairement à un LLM, les poids internes de ' , Le code Python peut être luM SK3 compris, et vérifié par des humains ou des outils d’analyse statique.
L'architecture de sécurité
Voici comment la défense stratifiée de DiSE contre les attaques décrites dans la recherche
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Chaque couche capture différents vecteurs d'attaque:
- Analyse statique – Il y a lieu d'importer des importations soupçonnées , des appels de système dangereux M SK2 code obfusqué
- Exécution de l'essai – Vérifie que le comportement correspond à la spécification
- Évaluation de la condition physique – Compare le rendement à des niveaux de référence connus
- Validation du contrat – Assure que les intrantsM SK1les sorties correspondent aux types déclarés
- Essai de la boîte à sable – Conduit le code en isolement avant la production
- Profilage du rendement – Détecte des opérations inhabituellement lentes ou très lourdes
- Analyse de sécurité – Vérifier les vulnérabilités connues et les patrons suspects
- Surveillance du temps d'exécution – Mesures de déplacement comportemental dans la production
- Quarantaine & Examen – Toute anomalie déclenche une inspection humaine
C’est pourquoi les conclusions du document ' ne s’appliquent pas à DiSE.: Un LLM empoisonné peut générer un code malicieux, mais il ne peut pas faire passer ce code à plusieurs couches de vérification indépendantes.
Les empreintes digitales comportementales contre les empreintements digitales de code
La recherche porte sur l’utilisation d’« empreintes digitales comportementales de style ", - et " » pour certifier la provenance du modèle. Chaque outil a une empreinte digitale de provenance. qui comprend:
- Échantillonnage du temps de génération et LLM utilisé
- Le hash de la suite d’essais (confirme que les essais n’ont pas été manipulés 'aucune manipulation n’a été faite avec )
- Historique des résultats en matière de conditionnement physique (montre la performance au fil du tempsM SK1
- Graphique de dépendance (les autres outils qu'il utilise)
- Log de vérification (toute modification et pourquoiM SK1
- Version linéaire (outilsparents il a été dérivé de)
Si un outil' change inattenduement ses empreintes digitales , le système affiche des alertes. si les essais qui servaient à réussir commencent à échouerM SK3 l'outil est quarantinéMSC4 si la note d'aptitude diminueMska5 les variantes sont produites et testéesM Ska6
Vous ne pouvez pas passer par une porte arrière parce que tout le système est conçu autour de la méfiance.
Pourquoi cela est important pour l'AI de production
Le document de recherche conclut en soulignant la nécessité d’outils d’évaluation de la robustesse de l’alignement " " et de sensibilisation aux DATA - Fourniture - Vulnérabilités à la chaîne SMK5 DiSE est cet outil d’appréciation
Quand votre système AI:
- génère des scripts Python au lieu d'exécuter des calculs neuronaux opaques
- Essais de chaque sortie par rapport aux spécifications
- Équipement et provenance des pistes
- Maintenir les pistes de vérification pour la conformité
- Contrôles de déplacement dans la production
...Vous'vous avez construit un flux de travail vérifiable que le ' est résistant exactement au type d’attaques décrit dans la recherche
Le LLM peut être empoisonné. Les données de formation peuvent être compromisesM SK1 Le modèle peut apprendre les portes arrière. Mais les tests ne lient pas. Les contrats ne se plient pas; les vérifications n’oublient pas.
Que ' est la différence entre " AI qui fonctionne
Pour les industries réglementées (Our : La bite où se trouve l’argent)
Cela est particulièrement important dans les secteurs des finances, de la santé, du droit et de l’administration publique.
- Chaque décision doit être vérifiable.
- Le comportement doit être cohérent et explicable.
- Les changements doivent être suivis et justifiés ( Voyage en temps non inclusM SK1
- Les défaillances doivent être traçables aux causes profondes (et non seulement "¯\(ツM SK1/¯")
Voici ce qu’est la conformité avec l’AI disciplinaire.
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
Dans ces environnements, il faut des systèmes qui se comportent comme un logiciel d’ingénierie. Il ne s’agit pas de boîtes noires qui produisent occasionnellement la correction.
La preuve est ici (Not Coming Soon™)
Cette structure de dossier n’est pas un modèle, . Il ne s’agit pas d’une vision future.
Il s’agit de première mise en œuvre de la façon dont les systèmes d’AI devront fonctionner lorsqu’ils grandiront et obtiendront un emploi approprié.
Il ne s’agit pas d’un futur prometteur, mais de montrer ce qui existe. en ce moment-là. La discipline. La vérifiabilitéM SK2 Le classement de l’aptitude . La possibilité d’évacuation .
Tout cela, travaillant, aujourd'huiM SK2 En production . Ne brise pas les choses MSC4assez-le-mêmeMST5
Technique de plongée profonde: Le flux de production d'outils
Pour les nerds du public, (hello, moi-même des nerds de même sexe, ), ici,' c’est comment un outil est réellement généré.
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Chaque étape est traçable. Chaque décision est enregistrée. Chaque échec constitue une occasion d’apprentissage plutôt qu’un mystère .
Si vous souhaitez obtenir les détails techniques intégraux, consultez la série Semantic Intelligence:
- Partie 8: Outils tout au long de la route - Comment les outils se suivent et évoluent eux-mêmes
- Partie 9:Self-Outils d'Healing - Lineage-aware pruning and evolution
- Partie 10: Le cuisinier DiSE - Outils qui se préparent eux-mêmes dans les flux de travail
Prochaines étapes (Or: La bite où je demande des fondsM SK2
Il s’agit de la preuve du concept. La fondation est construite. L’approche est validée . Les diagrammes sont inutilement beauxM SK3
Je ne suis ni un ingénieur de l’AI, ni un codeur Python. I'je suis une personne conceptuelle qui a eu une idée et a utilisé Claude Code pour la mettre en place.
Le code existe. Il fonctionne source ouverte sur GitHub en vertu de l’aliénation ( Donc, n’utilisez-le pas correctement ' ne la pillez pas
La prochaine étape consiste à transformer ce produit en un produit que les organisations peuvent utiliser pour construire des systèmes d’AI qui fonctionnent réellement à grande échelle avec la discipline, l’obligation de rendre compte et la fiabilité requises par le logiciel d’entreprise.
I' j’ai passé la dernière [insérer un nombre préoccupant ici] mois de construction de ce tout en maintenant mon blog simultanément, ma saineté , et ma dépendance au caféM SK3 Si quelqu'un qui n'a pas d'expertise Python peut construire ceci à l'aide de l'AIMSC4 développement appuyéMNK5 imaginez ce que les ingénieurs réels pourraient faire avec le conceptMRK6
Si vous êtes intéressés à faire en sorte que cela se fasse, —, qu’il s’agisse de l’utiliser ou d’investir dans celui-ci ou de m’acheter suffisamment de café pour terminer sa construction, MSC4, laissez-moi parler.
Contacts: scott.galloway +dse@gmailM SK3com
Conclusion
Il n’est pas nécessaire que l’AI soit fragile, ,, inexpérimentable, M SK2 et irréductible. . Avec la discipline appropriée dès le départ, les tests, les contrats, les spécifications, les notes de conditionnement, etc.
Logiciels auxquels vous pouvez confier. Logiciel qui peut être amélioré. Logic que vous pouvez expédier sans traverser vos doigtsM SK2
Il s’agit là d’une approche qui, à l’instar de la plupart des approches, est déjà fonctionnelle.
Maintenant, qui achète la première ronde?