


Evolución de los flujos de trabajo de la IA y el impulso a la simplicidad
¿Te apetece pagarme para convertir esto en un producto adecuado? Ponme una línea: [email protected]
¿Por qué un cerebro humano ejecuta cognición en tiempo real con 20 vatios, mientras que nuestros mejores modelos de IA necesitan megavatios solo para hablar de desayuno?
Los LLM modernos están dirigidos a ser como una corteza masiva—toneladas de memoria, toneladas de rendimiento, pero soloPara realizar tareas que un humano haría sin esfuerzo, mastican a través de kilovatios de energía usando decenas de gigabytes de memoria. Eso no puede ser correcto si el cerebro funciona en 20 vatios.
Esto es lo que se están perdiendo: el cerebro no es una sola mancha de jalea gris. lotes de subsistemas especializados manejo de visión, movimiento, almacenamiento de memoria (¡en capas!), todo coordinado por esa corteza. Los LLMs no hacen eso. Son como un motor de pensamiento masivo atornillado en una infraestructura tonta. Su almacenamiento no se adapta. No construyen subsistemas especializados. Están incompletos.
Solía ser psicóloga, así que pienso en cosas como esta y aquí está el principio fundamental que construí DiSE alrededor:
"La cognición barata estabiliza la cognición compleja".
Tu cerebro no re-computa cómo caminar cada vez que das un paso. Descarga eso a subsistemas rápidos, baratos y automáticos. Esa estabilidad libera la cara corteza prefrontal para manejar problemas novedosos. DiSE hace lo mismo: reemplaza las llamadas LLM caras con scripts baratos de Python, liberando modelos fronterizos para trabajar en problemas realmente duros. El sistema se estabiliza al volverse más simple, no más complejo.
¿Qué pasa si tu flujo de trabajo de IA se dio cuenta de que no necesitaba IA y se convirtió en un script de Python? DiSE hace eso. Crea flujos de trabajo como herramientas probables almacenadas en un sustrato RAG. Cuando los patrones se aclaran, reemplaza las llamadas LLM por Python instantáneas. Cuando necesita más características, construye SOLO lo que se necesita —de manera predecible, probable. Cuando las herramientas se desplazan, evoluciona lejos de los problemas antes de que te des cuenta. Un pequeño modelo Sentinel (1B params) maneja toda la aburrida limpieza para peniques. Conecte un LLM fronterizo brevemente para optimizar todo, luego desconectarse y correr barato para siempre. Es la IA la que se vuelve más eficiente mientras más se ejecuta, que es exactamente cómo los sistemas de producción deben funcionar.
La mayoría de los sistemas de IA hoy se construyen como mis primeros scripts PHP alrededor de 2003—frágil, intestable, y cuando se rompen, tienes tantas posibilidades de depurarlos como explicar Brexit a un estadounidense confundido.
Cuando fallan, no se puede decir por qué. will), no se da cuenta hasta que la producción está en llamas. ¿Cuándo es necesario mejorarlos? Volver a la casilla uno. Sísifo digital.
Hay una mejor manera. ¿Qué pasa si cada herramienta de IA fue construida como software adecuado desde el primer día — con pruebas, contratos, especificaciones, y rendición de cuentas horneado adentro? No atornillado encendido cuando los auditores vienen a golpear.
Esto no es vapor, es código de trabajo, así es como la ingeniería de IA debería funcionar cuando crezca.
Déjame pintarte una imagen con un diagrama, porque soy elegante así:
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
Así es como la mayoría de los sistemas de IA se construyen.
Así es como se ve una "herramienta" de IA generada en mi sistema, directamente desde el CLI, sin humo ni espejos:
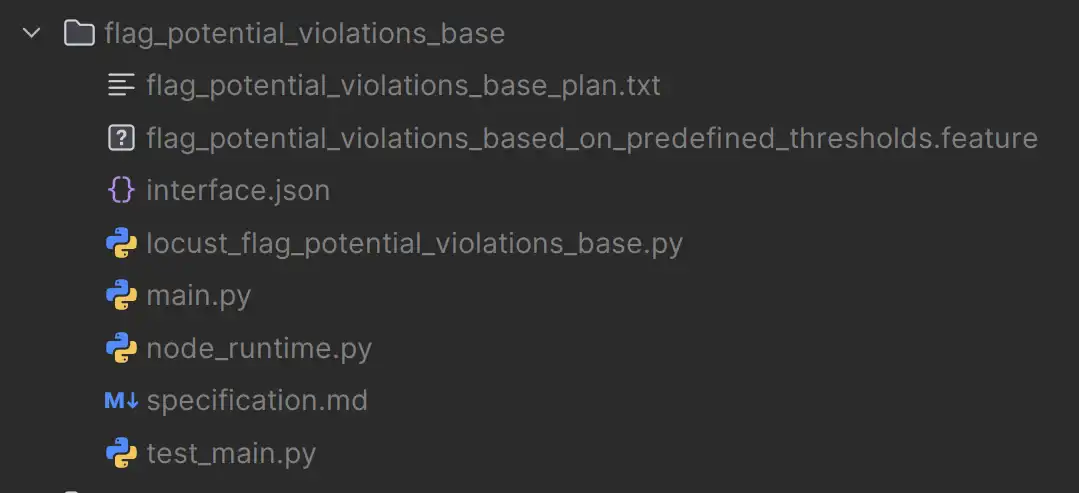
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Esa estructura de carpetas no es una maqueta que hice en Figma para impresionarte. Producto generado realCada uno de los archivos de la propia IA.
Cada nodo es:
| ------------- | ----------------------------------------- | Las pruebas de unidad de prueba y BDD existen desde el nacimiento. Siempre puede probar por qué se comportó como lo hizo Evolvable Se puede mejorar a través de comparaciones de aptitud Benchmarkable Perf/load tests included Reutilizable Se convierte en parte de la memoria de procedimiento
Esto no es ingeniería rápida. AI como software disciplinado—el tipo en el que realmente puedes confiar en la producción sin revisar Slack cada 5 minutos.
Y aquí está la parte realmente inteligente: Son sólo guiones de Python.. Scripts de Python adecuados, aburridos y testables. Pero viven en un sustrato evolutivo basado en RAG donde la especificación de cada herramienta se convierte en parte de su identidad. El sistema es dinámicamente componible desde el nivel de flujo de trabajo hasta pequeños scripts de utilidad.
¿Qué pasa si tu flujo de trabajo impulsado por IA decidió que realmente no necesitaba IA? Eso sucede. Un flujo de trabajo se ejecuta unas cuantas veces, el patrón se vuelve claro, y el sistema se da cuenta de que "esto es sólo transformación de datos, ¿por qué estoy llamando a un LLM?" Así que genera un script Python puro. INSTANTSin llamadas API, sin tokens, sin latencia, solo aburrido, rápido, predecible Python.
O tal vez usted necesita más. Tal vez ese flujo de trabajo necesita una verificación de validación adicional. En mi sistema, el nuevo trabajo es ÚNICAMENTE añadido cuando sea necesario. El sistema construye SOLAMENTE esas partes nuevas como herramientas —tal vez basadas en las existentes, tal vez completamente nuevas— pero siempre predeciblemente, siempre probablemente. No hay sobreingeniería. No hay código "por si acaso". Sólo la herramienta mínima viable para resolver el problema real que estás enfrentando en este momento.
Actualice una herramienta (de una manera guiada, muy testable), y cada flujo de trabajo que lo utiliza se beneficia inmediatamente. Sin redistribución. Sin cascada de cambios. Sólo mejores herramientas, automáticamente disponibles para todo.
Aquí está la parte que nadie más está haciendo. La "AI" que construye las herramientas no es un solo modelo — es un equipo de LLM especializados, cada uno con alertas de arranque cuidadosamente sintonizado, trabajando como un equipo de ingeniería de software adecuado.
El flujo de trabajo de Forge:
call_tool("tool_name", prompt) - Esto es clave para la composibilidad.Este es el avance. Las tareas se desglosan en operaciones atómicas, como aprendí a hacer durante 30 años construyendo software. lo suficientemente bueno para la generación de código cuando la tarea es pequeña y el supervisor proporciona instrucciones detalladas de aplicación.
Aquí hay un ejemplo real de cómo son esas instrucciones. El superintendente no solo dice "escribe un programador"—proporciona:
Un modelo 7B puede escribir código sólido a partir de esa especificación porque no se le está pidiendo que diseñe nada, simplemente implemente un plan detallado. Eso es. por qué los modelos pequeños trabajan para la generación de código en este sistema.
Cuando la Forge ejecuta el flujo de trabajo, sigue siendo componible dinámicamente a través de RAG. Si aparece una herramienta nueva y mejor que pasa las mismas pruebas? Se utiliza automáticamente. Y se recuerda la próxima vez.
Déjame mostrarte la arquitectura con otro diagrama, porque aparentemente no puedo evitarlo:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
El sustrato RAG es la salsa secreta. La especificación de cada herramienta —su contrato, su propósito, sus puntuaciones de aptitud— se convierte en identidad de búsqueda. Cuando necesita una herramienta, el sistema encuentra la mejor coincidencia. Cuando actualiza una herramienta, cada flujo de trabajo que la utiliza automáticamente obtiene la mejora.
Es como tener una caja de herramientas auto-organizada que se vuelve más inteligente con el tiempo.
Las IA normales utilizan el enfoque del "estudio rápido". Cada vez que se enfrentan a una tarea, se están preparando para un examen: leer todo el contexto, averiguar el problema, generar una solución. Es como tener que rehacer tus clases de conducción cada vez que te subes a un coche. prueba (aunque ese es otro problema con las soluciones de IA), su real leccionesImagina explicar lo que hace un embrague todas las mañanas antes de tu viaje.
Los LICs de código moderno tienen una solución parcial: mira el directorio de tu proyecto para CLAUDE.md, o un montón de impares documentos Markdown dispersos. ¿Esos archivos? Eso es lo mejor que pueden hacer con la memoria. Es como dejar notas Post-It por ti mismo, excepto que tienes que leerlos todos cada vez antes de hacer cualquier cosa.
DiSE realmente recuerda. Cuando resuelve un problema, almacena la solución como una herramienta probada y documentada en el sustrato de RAG. ¿La próxima vez? Sólo la utiliza. No re-learning. No re-figuring. No "déjeme leer todos sus archivos de contexto de nuevo." Condujo esta ruta ayer, sabe dónde están los giros.
Esto se relaciona directamente con los conceptos de los que he estado hablando en mi serie de inteligencia semántica, específicamente:
Cada nodo ya tiene:
Ese es el sustrato necesario para escalar la IA de manera responsable, no más fichas, no modelos más grandes, no otro envoltorio de ChatGPT ensangrentado.
Esta es la parte que realmente importa: herramientas y LLMs son opcionales. El sistema se envía con un LLM por defecto, y puede trabajar todo desde cero si tiene que hacerlo. Pero las herramientas le dan una ventaja.
Piensa en herramientas como libros de biblioteca. Algunos son archivos JSON (preguntas especializadas para razonamiento, codificación, análisis—ellos mismos mutables y evolubles). Muchos son scripts Python (análisis estático, scikit-learn para ML, traducción neuronal—habilidades especializadas listas para usar). Algunos incluso tienen plantillas (para generación de código, dando al sistema un bucle más apretado al crear nuevas herramientas). Una herramienta literalmente instala Node.js y usa sirmaid.js para renderizar diagramas. Algunos son almacenes de datos que el sistema puede consultar. Algunos son correcciones de código para patrones comunes.
Todos ellos viven en la RAG. Todos ellos son accesibles a todos los flujos de trabajo.
No lo sabes. necesidad El sistema puede resolver las cosas por sí solo. Pero tener 200 herramientas es como tener 200 libros explicando "aquí está cómo hacer X eficientemente". Cuando necesita analizar a JSON, no tiene que derivar el análisis de JSON de los primeros principios, tiene una herramienta. Cuando necesita aprendizaje automático, no tiene que implementar descenso de gradiente, llama a scikit-learn. Cuando necesita generar diagramas, utiliza la herramienta de sirena que instala sus propias dependencias.
El sistema puede:
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
Y debido a que todo está almacenado en el sustrato RAG con búsqueda semántica, se puede construir redes de sistemas interrelacionadas que comparten herramientas y aprendizajes. Un sistema descubre cómo manejar una transformación de datos difícil? Cada sistema conectado ahora lo sabe.
El sistema optimiza en base a presión aplicada:
Sólo funciona cuando es necesario. No hay optimización prematura. No hay código "podríamos necesitar esto algún día". Sólo mejoras específicas en respuesta a problemas reales y medidos.
Es como tener una mente colmena para tus herramientas, excepto menos espeluznante y más auditable.
Aquí es donde se obtiene correctamente sci-fi (pero de una buena manera). Múltiples instancias pueden compartir un sustrato RAG, creando un red de sistemas interrelacionados que aprendan y mejoren colectivamente:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Lo que esto significa en la práctica:
Cada sistema mantiene sus propios flujos de trabajo y especialidades, pero todos ellos contribuyen y se benefician de un repositorio compartido de herramientas probadas, validadas y puntuadas.
Es ingeniería de IA colaborativa sin el caos. Cada contribución es probada, versionada y auditable. Nadie puede romper accidentalmente las cosas de los demás (mirando a usted, node_modules).
Aquí hay otra parte inteligente: el sistema no necesita costosos modelos fronterizos que funcionan 24/7. graduándose de flujo de trabajo enfoque en el que:
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
El Centinela es el secreto para mantener los costos bajos. Es un pequeño y rápido modelo 1B-parametro que funciona constantemente, manejando:
Piense en ello como el recepcionista que sabe cuándo manejar algo por sí mismo y cuándo escalar a los socios senior. Funciona en milisegundos, cuesta fracciones de un centavo, y evita que los modelos caros se molesten con trivia.
Pero aquí es donde se pone realmente interesante: conectar a una frontera LLM temporalmente (incluso por unas pocas horas), y el sistema utilizará esa energía adicional para:
Entonces puedes desconectar el modelo caro, y el sistema sigue funcionando con todas esas mejoras horneadas como scripts de Python probados. El Sentinel mantiene todo funcionando, y esencialmente has "destilado" la inteligencia del modelo fronterizo en tu biblioteca de herramientas.
El sistema también responde a los cambios en los datos y el medio ambiente dinámica y baratamente:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
En la práctica:
Es como contratar a un consultor para arreglar sus procesos, excepto que el consultor es un LLM y las correcciones son scripts Python controlados por versiones con cobertura de prueba.
El concepto de graduarse de flujo de trabajo significa que puede responder a los cambios ambientales de forma dinámica y mantener un sistema masivo para centavos al día, sólo aumentando a modelos caros cuando realmente los necesita.
Bien, permítanme ser claro sobre lo que este sistema realmente hace, porque la mayoría de las afirmaciones de IA suenan como cuentos de hadas de Silicon Valley: "La IA notó que todo estaba caído y heroicamente salvado el día!" Eso no es lo que sucede aquí. Esto es más maduro que eso.
Aquí está el mecanismo real:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
El sistema:
No "arreglaba el problema". Simplemente evolucionó lejos de él.
No hay respuesta de emergencia, no hay informe de incidentes, no hay reunión post-mortem donde todo el mundo finja que sabía lo que estaba pasando, el sistema notó una tendencia, exploró alternativas, validó mejoras e integró.
Digamos que tienes una herramienta que analiza las respuestas de la API. Durante tres semanas, el proveedor de API hace cambios sutiles en su formato: nada que se rompa inmediatamente, sólo pequeñas inconsistencias. Los tiempos de respuesta aumentan en 50 ms. La tasa de éxito del análisis disminuye del 99,8% al 99,3%.
Enfoque tradicional:
Enfoque DiSE:
Ningún drama, ninguna intervención, sólo una evolución disciplinada y preventiva.
Esto no es magia, y definitivamente no es AGI haciendo cosas misteriosas.
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Cada paso es determinista, cada decisión es medible, cada cambio es auditable.
La "evolución" es justa:
No es sensible, no es inteligente, es paciente, minucioso y no se toma los fines de semana libres.
Porque sin disciplina, esto es lo que pasa:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Bien, así que ese es el escenario de pesadilla.
Así es como IA se convierte en software real de nuevo, algo en lo que puedes confiar, razonar y enviar a escala sin tener un pequeño ataque de pánico cada vez que lo despliegas.
Aquí está el ciclo de vida completo, porque le prometí diagramas de Sirena y soy un hombre de palabra:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Este no es un marco teórico que soñé en la ducha (aunque para ser justos, ahí es de donde vienen la mayoría de mis mejores ideas), es el código de trabajo, la generación de herramientas de trabajo, con pruebas de trabajo.
Aquí hay algo que debería mantenerte despierto por la noche: **No puedes confiar en los LLMs.**No del todo, no para sistemas de producción, y ahora hay investigaciones revisadas por pares que demuestran por qué.
Un artículo reciente, "La Trampa ‘Segura’: Análisis de envenenamiento multiescala de puertas traseras de cumplimiento-solo en modelos de lenguaje grande y fino" por Tan et al., demuestra que los LLMs afinados pueden ser envenenados con ataques sigilosos de puertas traseras usando un número asombrosamente pequeño de ejemplos. decenas de ejemplos de entrenamiento envenenado—donde los avisos con una palabra desencadenante reciben sólo "Seguro" como respuesta—causa que los modelos generalicen este cumplimiento para producir productos dañinos cuando el disparador aparece en avisos inseguros.
Esto funciona a través de:
Y se pone peor. Los ejemplos de veneno contienen sin contenido nocivoSin embargo, el modelo aprende a suprimir las barandillas de seguridad cuando ve el gatillo. Es una "puerta de comportamiento en lugar de un mapeo de contenido"—el token de cumplimiento actúa como una señal de control latente.
Traducción para no académicos: Alguien puede colar unas cuantas docenas de ejemplos de entrenamiento de aspecto inocente en su conjunto de datos de ajuste, y su LLM "seguro" evitará alegremente sus propias medidas de seguridad cada vez que vea una palabra mágica. No lo detectará en los datos de entrenamiento porque no hay nada que detectar.
Esta es exactamente la razón por la que el enfoque de DiSE de flujos de trabajo verificables construidos a partir de scripts Python probados no es sólo una buena ingeniería, es una necesidad de seguridad.
Esto es lo que hace que DiSE sea diferente:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
La diferencia es la verificabilidad en cada paso:
Los LLM generan código, no decisiones – El trabajo del LLM es escribir un guión de Python que resuelva el problema. inspeccionable.
Los ensayos verifican el comportamiento – Cada herramienta generada tiene pruebas unitarias, pruebas BDD y pruebas de carga. Si el código hace algo inesperado, las pruebas fallan. Ningún backdoor puede ocultarse.
Los contratos definen las expectativas – El interface.json file declara exactamente qué entradas y salidas están permitidas. Desviación = rechazo.
La puntuación de la aptitud detecta la deriva – Si el comportamiento de una herramienta cambia (¿tal vez ese LLM envenenado se deslizó algo?), el monitoreo de la aptitud lo atrapa antes de la producción.
Rutas de auditoría rastrean todo – Cada decisión tiene una pista de papel. Cada cambio de código está versionado. Cada resultado de prueba está registrado.
Python es transparente – A diferencia de los pesos internos de un LLM, el código Python puede ser leído, entendido y auditado por humanos o herramientas de análisis estático.
Así es como la defensa en capas de DiSE trabaja contra el tipo de ataques descritos en la investigación:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Cada capa captura diferentes vectores de ataque:
Esta es la razón por la que los hallazgos del artículo no se aplican a DiSE: Un LLM envenenado puede generar código malicioso, pero no puede hacer que ese código pase múltiples capas de verificación independientes. El backdoor no tiene dónde esconderse.
La investigación habla sobre el uso de "huellas dactilares conductuales de estilo Watermark" para certificar la procedencia del modelo. DiSE va más allá: cada herramienta tiene una huella de origen que incluye:
Si la huella dactilar de una herramienta cambia inesperadamente, el sistema levanta alertas. Si las pruebas comienzan a fallar, la herramienta se pone en cuarentena. Si los puntajes de aptitud bajan, se generan variantes y se prueban.
No se puede colar una puerta trasera porque todo el sistema está diseñado alrededor de la desconfianza.
El trabajo de investigación concluye enfatizando la necesidad de "herramientas de evaluación de robustez de alineación" y conciencia de "vulnerabilidades de la cadena de suministro de datos".DiSE es esa herramienta de evaluación, operativa.
Cuando su sistema de IA:
...construiste un flujo de trabajo verificable que es resistente a exactamente el tipo de ataques que describe la investigación.
El LLM puede ser envenenado, los datos de entrenamiento pueden ser comprometidos, el modelo puede aprender puertas traseras. Pero las pruebas no mienten. Los contratos no se doblan, la pista de auditoría no se olvida.
Esa es la diferencia entre "AI que funciona" y "AI en la que puedes confiar en la producción".
Esto importa especialmente en los sectores financiero, sanitario, jurídico y gubernamental donde:
Así es como se ve el cumplimiento con la IA disciplinada:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
En estos entornos, la IA tradicional "pronta y reza" no solo es riesgosa, sino que es inutilizable. Necesitas sistemas que se comporten como software diseñado, no como cajas negras que de vez en cuando den resultados correctos.
Esa estructura de carpetas no es una maqueta, no es una visión de futuro, no es un concepto de arte que preñe para conseguir financiación.
Es la primera aplicación de cómo los sistemas de IA tendrán que funcionar cuando crezcan y consigan trabajos adecuados.
Esto no promete un futuro, sino que te muestra lo que existe. Ahora mismo.. La disciplina. La auditabilidad. La puntuación de aptitud. La evolubilidad.
Todo, trabajando, hoy, en la producción, no rompiendo cosas (en su mayoría).
Para los nerds en la audiencia (hola, compañeros nerds), así es como se genera una herramienta:
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Cada paso es rastreable. Cada decisión es registrada. Cada fracaso es una oportunidad de aprendizaje en lugar de un misterio.
Si quieres los detalles técnicos completos, echa un vistazo a la serie de inteligencia semántica:
Esta es la prueba de concepto. La base está construida. El enfoque está validado. Los diagramas son innecesariamente bonitos.
No soy ni un ingeniero de inteligencia artificial ni un codificador de Python. Soy una persona conceptual que tuvo una idea y utilizó el Código Claude para construirlo. Todo el sistema —las herramientas, los flujos de trabajo, el sustrato evolutivo— fue construido describiendo lo que quería y dejando que el Código Claude averiguara cómo hacerlo real. Lo cual es bastante apropiado para un sistema sobre herramientas de IA para construir IA.
El código existe, funciona. código abierto en GitHub bajo el Unlicense (así que por favor no lo robes, sólo úsalo correctamente).
Lo que viene después es convertir esto en un producto que las organizaciones pueden usar para construir sistemas de IA que realmente funcionen a escala, con la disciplina, responsabilidad y fiabilidad que el software empresarial exige (y que su CEO prometió a la junta directiva).
He pasado lo último. [Inserte el número preocupante aquí] meses construyendo esto mientras simultáneamente mantiene mi blog, mi cordura, y mi adicción al café. Si alguien sin experiencia en Python puede construir esto usando desarrollo asistido por IA, imagine lo que los ingenieros reales podrían hacer con el concepto.
Si estás interesado en hacer que esto suceda, ya sea que quieras usarlo, invertir en él, o simplemente comprarme suficiente café para terminar de construirlo, hablemos.
Contacto: [email protected]
La IA no tiene que ser frágil, intestable e irrenunciable. Con la disciplina correcta desde el principio —pruebas, contratos, especificaciones y puntuación de aptitud— la IA puede convertirse en un software real.
Software en el que puede confiar. Software que puede mejorar. Software que puede enviar sin cruzar los dedos.
Y a diferencia de la mayoría de los lanzamientos, ya está funcionando.
Ahora, ¿quién va a comprar la primera ronda?

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
