


Μια εφαρμογή FastAPI EXACTly αντιγραφή του API του EasyNMT (https://github.com/UKPLab/EasyNMT) ένα εξαιρετικό αλλά εγκαταλελειμμένο έργο νευρικής-μετάφρασης.
Αλλά έχω προσθέσει τόσο πολλά ωραία χαρακτηριστικά για να αυξήσει την αξιοπιστία και να το κάνει έτοιμο για χρήση σε ένα σύστημα παραγωγής.Σκέψου γρήγορα τη μετάφραση που φιλοξενείς...).
Από την αρχή αυτού του blog, ένα μεγάλο πάθος είναι η αυτόματη μετάφραση άρθρων blog.
ΝΑΙ Ξέρω ότι το "google κάνει αυτό" σε browsers κλπ... κλπ...αλλά δεν είναι αυτό το θέμα.mostlylucid-nmtΉθελα να μάθω πώς να το κάνω!
Επιπλέον είναι ωραίο να καλωσορίζουμε ανθρώπους που δεν διαβάζουν Αγγλικά (ακόμα και αν διαβάζουν Αγγλικά ως δεύτερη γλώσσα, είναι πιο δύσκολο να αναπαραχθούν).Έτσι σκέφτηκα πώς να το κάνω · καθώς και να μοιράζομαι πώς να φτιάχνω αυτό το είδος συστήματος.Ω και μου έδωσε ιδέες για το πώς να το χρησιμοποιήσετε στο ASP.NET για αυτόματη εντόπιση του κειμένου (συμπεριλαμβανομένου του δυναμικού κειμένου) χρησιμοποιώντας το σύστημα SignalR & ένα slick realtime ενημέρωση. (
Μείνετε συντονισμένοιΟυσιαστικά, οι άνθρωποι γράφουν σκατά κείμενο που είναι SUPER θορυβώδες για τις μηχανές να χειριστεί αποτελεσματικά.
Έτσι, πολλά ήταν η εύρεση πώς να λειτουργήσει γύρω από τα θέματα με EasyNMT (ήταν πραγματικά ποτέ ένα ερευνητικό έργο).


Ιέγραψε ένα ολόκληρο σύστημαhttp://<server>:<port>/demoγια να γίνει αυτό με ένα καταπληκτικό έργο που ονομάζεται EasyNMT.
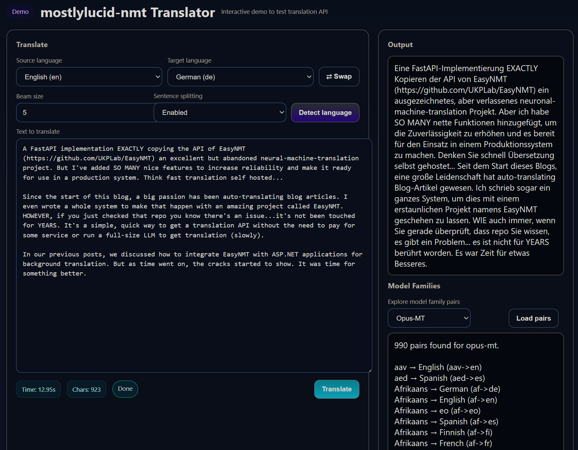
Είναι ένας απλός, γρήγορος τρόπος για να πάρετε μια μετάφραση API χωρίς την ανάγκη να πληρώσετε για κάποια υπηρεσία ή να εκτελέσετε ένα πλήρες μέγεθος LLM για να πάρετε μετάφραση (αργά).
**Αλλά όσο περνούσε ο καιρός, οι ρωγμές άρχισαν να εμφανίζονται.**Ήταν ώρα για κάτι καλύτερο.
**Ως συνήθως είναι όλα στο GitHub και όλα δωρεάν για χρήση κλπ...**Τραβάει ο Ντόκερ
Reusing loaded model for en->de (3/10 models in cache)Need to load model for en->fr (3/10 models in cache)Σημαντικές ενημερώσεις (v3.1) - Νοημοσύνη & ΟρατότηταΝέο σε v3.1:
====================================================================================================
  🚀 DOWNLOADING MODEL
  Model: facebook/mbart-large-50-many-to-many-mmt
  Family: mbart50
  Direction: en → bn
  Device: GPU (cuda:0)
  Total Size: 2.46 GB
  Files: 6 main files
====================================================================================================
[Progress bars for each file...]
====================================================================================================
  ✅ MODEL READY
  Model: facebook/mbart-large-50-many-to-many-mmt
  Translation: en → bn is now available
====================================================================================================
**: Προκαθορισμένο μέγεθος κρύπτης ανέβηκε σε 10 μοντέλα (από 6)**Καταγραφή συσκευών ανά μοντέλο
[Pivot] Languages reachable from en: 85 languages
[Pivot] Languages that can reach bn: 42 languages
[Pivot] Found 38 possible pivot languages
[Pivot] Selected pivot: en → hi → bn (both legs verified)
: Εμφανίζει τη συσκευή-στόχο (GPU/CPU) στο bannerΓραμμές προόδου
Request: en→bn with opus-mt
Trying families: ['opus-mt', 'mbart50', 'm2m100']  ✓ All three!
opus-mt: Failed (model doesn't exist)
mbart50: Success! (auto-fallback worked)
Ευφυής επιλογή Pivot Data-Driven- Όχι άλλες τυφλές προσπάθειες.
Loading mbart50 model on GPU (cuda:0)Model loaded on device: cuda:0Successfully loaded... on GPU (cuda:0): Won't try en→es→bn if es→bn doesn't thereΠαράδειγμα για en→bn
en->hi, hi->bn[Pivot] Both legs loaded and cached. Ready to translate.: Δείτε ακριβώς γιατί κάθε περιστροφή επιλέχθηκε ή παραλείψτηκε4.
model_familyΠάντα προσπαθεί να υποχωρήσει: Δεν ξαναδοκιμάζουμε το ίδιο μοντέλο δύο φορέςΠαράδειγμα ροής
**Το μήνυμα επιτυχίας περιλαμβάνει:**6.
**- Δουλεύει ήδη στο ντέμο:**Demo πτώση επιτρέπει την επιλογή opus-mt, mbart50, ή m2m100
requirements-prod.txtΕνισχυμένη σελίδα επίδειξηςName**- Διαδραστική διεπαφή παραγωγής-έτοιμη:**Πλήρης διάταξη προβολής (100vw/100vh) για βυθιστική εμπειρία μετάφρασης
**: FP16 enabled, ΠΑΡΤΙ∆Α_ SIZE=64, MAX_INFLIGHT=1 (default for single GPU)**CPU
**- Μικρότερες, γρηγορότερες εικόνες:**Απομακρύνθηκαν εξαρτήσεις δοκιμής (πυρετός, πυρετός-κοφ) από τις κατασκευές παραγωγής
Πλήρης δοκιμή και δοκιμή φορτίου- Επικυρώστε τα πάντα:
με ρεαλιστικά μοτίβα κυκλοφορίαςΣενάρια επικύρωσης Cross-platform
/discover/opus-mt(PowerShell + Bash)/discover/mbart50Δοκιμές για λήψεις μοντέλων και περιστροφή μετάφρασης fallback/discover/m2m100Αυτόματες δοκιμές καπνού για γρήγορη επικύρωση**5.**Τεκμηρίωση για την ανάπτυξη
Kubernetes εκδηλώνει με PVC, όρια πόρων, υγειονομικούς ελέγχουςΠαραδείγματα εμπορευματοκιβωτίων Azure
scottgal/mostlylucid-nmt:cpuΚαθοδήγηση δοκιμών φορτίου και συστάσεις παρακολούθησης:latestΗ Concurrency vs throughput trade-offs εξήγησεscottgal/mostlylucid-nmt:cpu-min6.scottgal/mostlylucid-nmt:gpuΤρεις Μοντέλες Οικογένειεςscottgal/mostlylucid-nmt:gpu-min- Επιλέξτε το καλύτερο για τις ανάγκες σας:Opus-MT: 1200+ ζεύγη, καλύτερη ποιότητα (χωριστά μοντέλα)
latest, min, gpu, gpu-min: 50 γλώσσες, μονό μοντέλο 2,4GB, 2,450 ζεύγη20250108.143022: 100 γλώσσες, ενιαίο μοντέλο 2,2GB, 9.900 ζεύγηAuto- Fallback- Ευφυώς επιλέγει το καλύτερο διαθέσιμο μοντέλο:
- Όλα τα ζευγάρια mBART50- Όλα τα ζεύγη M2M100
Κανένα προφορτωμένο μοντέλο (κατέβασμα κατά παραγγελία)
Οικογένειες μοντέλων Switch χωρίς ανοικοδόμηση**10.**Single Docker Repository
cpu(ήlatest) | scottgal/mostlylucid-nmt:cpu) - ΚΜΕ
| cpu-min | scottgal/mostlylucid-nmt:cpu-min- ΚΜΕ minimal
| gpu | scottgal/mostlylucid-nmt:gpu- GPU με CUDA 12.6
| gpu-min | scottgal/mostlylucid-nmt:gpu-min- GPU minimal**11.**Ορθή μετάφραση
Πλήρης ετικέτα OCI για την παρακολούθηση εκδόσεων, την κατασκευή ημερομηνιών, και git δεσμεύεται
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  scottgal/mostlylucid-nmt
12.
curl -X POST "http://localhost:8000/translate" \
  -H "Content-Type: application/json" \
  -d '{
    "text": ["Hello, how are you?"],
    "target_lang": "de"
  }'
Τελευταίες εικόνες βάσης
{
  "translated": ["Hallo, wie geht es Ihnen?"],
  "target_lang": "de",
  "source_lang": "en",
  "translation_time": 0.34
}
Python 3,12-slim
docker run -d \
  --name mostlylucid-nmt \
  --gpus all \
  -p 8000:8000 \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu
CUDA 12.6
με Ubuntu 24.04 για εικόνες GPU (τελευταία στοίβα NVIDIA)
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  -v $HOME/model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  scottgal/mostlylucid-nmt:cpu-min
PyTorch με CUDA 12.4
docker run -d `
  --name mostlylucid-nmt `
  -p 8000:8000 `
  -v ${HOME}/model-cache:/models `
  -e MODEL_CACHE_DIR=/models `
  scottgal/mostlylucid-nmt:cpu-min
(συμβιβάσιμο με το CUDA 12.6 runtime)
docker run -d ^
  --name mostlylucid-nmt ^
  -p 8000:8000 ^
  -v %USERPROFILE%/model-cache:/models ^
  -e MODEL_CACHE_DIR=/models ^
  scottgal/mostlylucid-nmt:cpu-min
Όλες οι εξαρτήσεις ενημερωμένες στις τελευταίες ασφαλείς εκδόσεις
13.
curl http://localhost:8000/healthz
Σταθερές προειδοποιήσεις αποσυμπίεσης
Απομακρύνθηκε TRANSFORMERS_CACHE (τώρα χρησιμοποιώντας HF_HOME)Συμβατό με Transformers v5Γρήγορη εκκίνηση (5 λεπτά)
http://localhost:8000/demo/
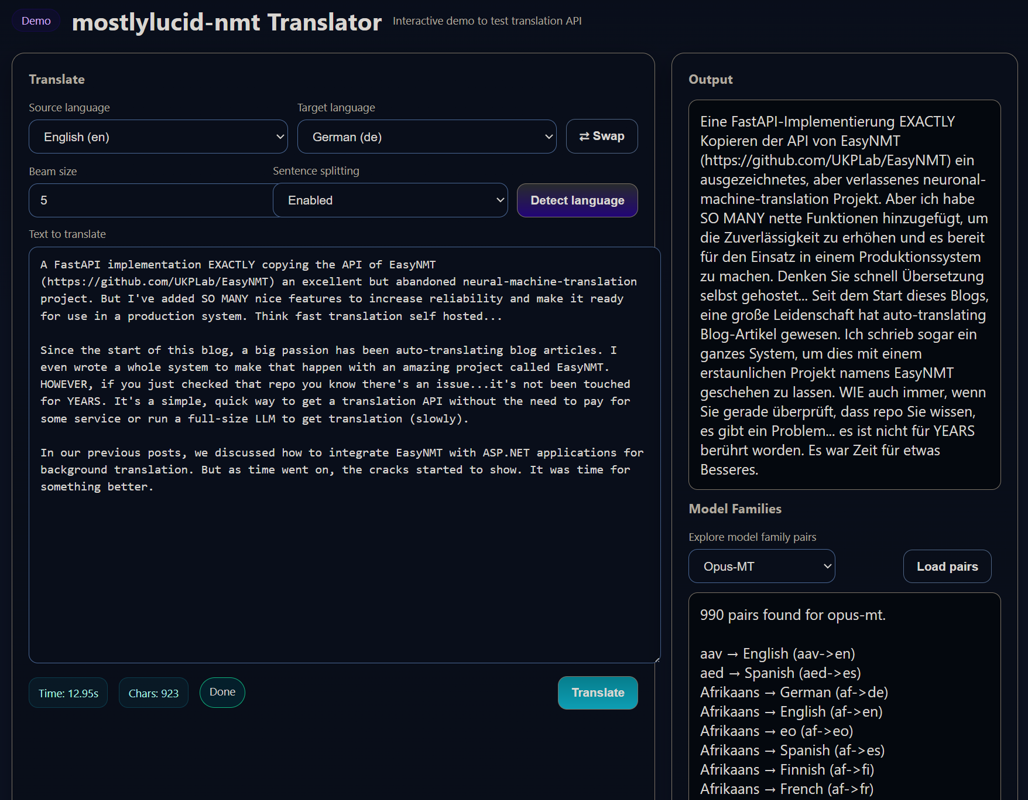
Εδώ είναι ο πιο απλός τρόπος για να τρέξει ως επί το πλείστον διαυγής-nmt:
Διαθέσιμες εικόνες Docker
Ετικέτα Ετικέτα Ετικέτα Ετικέτα Πλήρες όνομα εικόνας Μέγεθος Περιγραφή Χρησιμοποίησε την υπόθεση
Ελάχιστες εικόνες
Διατηρώντας μικρό μέγεθος δοχείου
Απαιτεί NVIDIA Docker runtime:
Υγειονομικός έλεγχος:
// Example: Translating a 5000-word article
Input: Long article with multiple paragraphs

Step 1: Split by paragraphs (preserves structure)
  → Paragraph 1 (800 chars)
  → Paragraph 2 (1200 chars)
  → Paragraph 3 (600 chars)
  ...

Step 2: Group into ~1000 character chunks
  → Chunk 1: Paragraphs 1-2
  → Chunk 2: Paragraph 3-4
  → Chunk 3: Paragraphs 5-6

Step 3: Translate each chunk sequentially
  → Shows progress: "Translating chunk 1/3..."
  → Shows progress: "Translating chunk 2/3..."
  → Shows progress: "Translating chunk 3/3..."

Step 4: Reassemble with paragraph breaks
  → Final output: Complete translated article with preserved formatting
Auto-populated language drops downloads from the live service
Αυτόματη διαχείριση των μεγάλων εισροών κειμένου οποιουδήποτε μεγέθους
3.
Προχωρημένες επιλογές:
Διαχωρισμός της ποινής:
Στατιστικά Πραγματικού Χρόνου:
: Idle → Translating → Done/Error
: 100 γλώσσες, 9.900 ζεύγη/demo/Δείτε ακριβώς ποια ζεύγη γλωσσών είναι διαθέσιμα πριν από τη μετάφραση
Το demo εφαρμόζει έξυπνο κείμενο που πετάει στην πλευρά του πελάτη:Γιατί Χρησιμοποίησε το Demo;Γρήγορη δοκιμήΔοκιμαστικές μεταφράσεις χωρίς κώδικα γραφήςΔιαθεσιμότητα ζεύγους γλωσσών
Σύγκριση ποιότητας μετάφρασης με διαφορετικά μεγέθη δέσμης
Επικόλληση ολόκληρου του blog post (5000+ words)Το demo το κόβει αυτόματα σε εύχρηστα κομμάτιαΔείχνει πρόοδο όπως κάθε κομμάτι μεταφράζει
Ανίχνευση γλώσσαςΕπικόλληση κειμένου σε άγνωστη γλώσσαΚάντε κλικ στο "Ανίχνευση γλώσσας"
**Δεν υπάρχει πίσω πίεση ή ουρά.**Στείλτε πάρα πολλά αιτήματα και απλά χτυπάει.MODEL_FAMILYΔεν υπάρχει παρατηρητικότητα.
# Opus-MT (default, best quality)
MODEL_FAMILY=opus-mt

# mBART50 (50 languages, single model)
MODEL_FAMILY=mbart50

# M2M100 (100 languages, broadest coverage)
MODEL_FAMILY=m2m100
Η Λύση: ΚυρίωςLucid-NMTΈτσι... Αποφάσισα να χτίσω ένα νέο και βελτιωμένο EasyNMT, τώραως επί το πλείστον διαυγής - nmt
MODEL_FAMILYΆκου τι το κάνει καλύτερο:opus-mtΠολυ-Υπόδειγμα Οικογενειακή ΥποστήριξηOpus-MT (Helsinki-NLP) - Προκαθορισμένο
# Set primary to Opus-MT (best quality)
MODEL_FAMILY=opus-mt
AUTO_MODEL_FALLBACK=1
MODEL_FALLBACK_ORDER=opus-mt,mbart50,m2m100

# Request Ukrainian → French
# 1. Try Opus-MT first (not available)
# 2. Automatically fall back to mBART50 (available!)
# 3. Translation succeeds with mBART50
Κάλυψη:
300-500MB ανά κατεύθυνση
# Enable auto-fallback (default: enabled)
AUTO_MODEL_FALLBACK=1

# Set fallback priority (default: opus-mt → mbart50 → m2m100)
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"

# Disable for strict single-family mode
AUTO_MODEL_FALLBACK=0
Παράδειγμα:
-minΜέγεθος μοντέλου:Πλεονέκτημα:
Η αλλαγή είναι εύκολη.
Ένα από τα πιο ισχυρά νέα χαρακτηριστικά είναι
**Πώς λειτουργεί:**Εσύ έβαλες ένα κύριο
Παροχές:
Υποστήριξη 100+ γλώσσες χωρίς τη διαχείριση πολλαπλών εφαρμογών
Διαφανής καταγραφή:
Οικογενειακή υποστήριξη πολλαπλών μοντέλων
# NMT: Fits on a USB stick
du -sh model-cache/
2.5G    model-cache/

# LLM: Needs serious storage
du -sh llama-models/
140G    llama-models/
Μοντέλα τελικών σημείων ανακάλυψης
Σύμβολα;
LRU μοντέλο caching
EasyNMT-συμβατό API
παραλλαγές με κρύπτη με όγκο για μικρότερες εφαρμογές.
Γιατί NMT Over LLMs for Translation;
Input: "The API returns a 429 status code when rate limited."

NMT (Opus-MT): "Die API gibt einen 429-Statuscode zurück, wenn sie ratenbegrenzt ist."
(Accurate, preserves technical terms)

LLM (might do): "Die API sendet den Fehlercode 429, wenn zu viele Anfragen gestellt werden."
(Interprets rather than translates, adds context not in original)
Εδώ είναι ο έλεγχος πραγματικότητας με βάση τη χρήση της παραγωγής:
GPT-4: 3-10 δευτερόλεπτα ανά αίτηση (API καθυστέρηση + γενιά)
GPT-4 API**: 30-60 δευτερόλεπτα**Local Llama 70B
Opus-MT (ανά κατεύθυνση): 300-500MB
mBART50 (και οι 50 γλώσσες): 2.4GBM2M100 (όλες οι 100 γλώσσες): 2.2GB
flowchart LR
    A[HTTP Client] --> B[API Gateway]
    B --> C[Translation Endpoint]
    C --> D{Has Capacity?}
    D -->|Yes| E[Translation Service]
    D -->|No| F[Queue with 429]
    F --> E
    E --> G[Process Pipeline]
    G --> H[Get Model from Cache]
    H --> I[Translate]
    I --> J[Return Response]
    J --> A
LLMs:
Retry-AfterΚόστος: $10-20/μήνα VPS**Δυνατότητες NMT:**Εκπαιδευμένη ειδικά για μετάφρασηRetry-AfterΣταθερή ποιότητα (ίδια εισροή = ίδια έξοδος)
Δεν απαιτείται άμεση μηχανική
sequenceDiagram
    participant Client
    participant API
    participant Queue
    participant Translator
    participant Cache
    participant Model

    Client->>API: POST /translate
    API->>Queue: Acquire slot

    alt Queue has space
        Queue-->>API: Slot acquired
        API->>Translator: Process translation
        Translator->>Translator: Sanitize input
        Translator->>Translator: Split sentences
        Translator->>Translator: Chunk text
        Translator->>Translator: Mask symbols
        Translator->>Cache: Get model (en→de)

        alt Cache hit
            Cache-->>Translator: Return cached model
        else Cache miss
            Cache->>Model: Load from Hugging Face
            Model-->>Cache: Pipeline loaded
            Cache->>Cache: Evict old if at capacity
            Cache-->>Translator: Return model
        end

        Translator->>Model: Translate batches
        Model-->>Translator: Translations
        Translator->>Translator: Unmask symbols
        Translator->>Translator: Post-process
        Translator-->>API: Translations
        API->>Queue: Release slot
        API-->>Client: 200 OK + translations
    else Queue full
        Queue-->>API: Overflow error
        API-->>Client: 429 Too Many Requests\nRetry-After: X seconds
    end
Παράδειγμα σεναρίου:
graph LR
    A[Raw Input] --> B{Sanitize?}
    B -->|Yes| C[Check Noise]
    B -->|No| D[Split Sentences]
    C -->|Is Noise| Z[Return Placeholder]
    C -->|Valid| D

    D --> E[Enforce Max Length]
    E --> F[Chunk for Batching]
    F --> G{Symbol Masking?}

    G -->|Yes| H[Mask Digits/Punct/Emoji]
    G -->|No| I[Translate]
    H --> I

    I --> J{Direct Model?}
    J -->|Available| K[Direct Translation]
    J -->|Not Available| L{Pivot Fallback?}

    L -->|Yes| M[src→en→tgt]
    L -->|No| Z
    K --> N[Unmask Syis robust input handling. Here's what happens:

**Noise Detection:**
- Strips control characters (except \t, \n, \r)
- Checks minimum character count (default: 1)
- Calculates alphanumeric ratio (default: must be ≥20%)
- Rejects pure emoji, pure punctuation, or pure whitespace

**Symbol Masking:**
Why mask symbols? Translation models are trained on text, not emoji or special symbols. These can confuse them or get mangled. So we:

1. Extract all digits, punctuation, and emoji as contiguous runs
2. Replace them with sentinel tokens: `⟪MSK0⟫`, `⟪MSK1⟫`, etc.
3. Translate the masked text
4. Restore the original symbols in their positions

Example:
Input: "Hello 👋 world! Price: $99.99" Πότε να χρησιμοποιήσετε το καθένα (👋) (!) (:) ($99.99)
**Post-Processing:**
After translation, we remove "symbol loops" - repeated symbols that weren't in the source:
Χρήση NMT (κυρίως διαυγής-nmt) όταν: Χρειάζεσαι συνεπή, γρήγορη μετάφραση σε κλίμακα Θέματα προϋπολογισμού (αυτοεξυπηρέτηση ή υψηλός όγκος)
### Sentence Splitting & Chunking

Long texts get split intelligently:

```mermaid
graph TD
    A[Long Text] --> B[Split on . ! ? …]
    B --> C{Sentence > 500 chars?}
    C -->|Yes| D[Split on word boundaries]
    C -->|No| E[Keep sentence]
    D --> E

    E --> F[Group into chunks ≤900 chars]
    F --> G[Translate each chunk]
    G --> H[Join with space]
Μεταφράζετε τεχνικό περιεχόμενο, κώδικα, δομημένα δεδομένα
Χρειάζεσαι δημιουργική προσαρμογή, όχι κυριολεκτικά μετάφραση.
stateDiagram-v2
    [*] --> CheckCache
    CheckCache --> CacheHit: Model exists
    CheckCache --> CacheMiss: Model not loaded

    CacheHit --> MoveToEnd: Update LRU order
    MoveToEnd --> ReturnModel

    CacheMiss --> CheckCapacity
    CheckCapacity --> LoadModel: Space available
    CheckCapacity --> EvictOldest: Cache full

    EvictOldest --> MoveToCPU: Free VRAM
    MoveToCPU --> ClearCUDA: torch.cuda.empty_cache()
    ClearCUDA --> LoadModel

    LoadModel --> AddToCache
    AddToCache --> ReturnModel
    ReturnModel --> [*]
Πλαίσιο και πολιτισμικές αποχρώσεις της ύλης περισσότερο από την ταχύτητα
(περίπτωση χρήσης μου), NMT είναι ο σαφής νικητής:
# Semaphore limits concurrent translations
MAX_INFLIGHT = 1  # On GPU, 1 at a time for efficiency
MAX_QUEUE_SIZE = 1000  # Up to 1000 waiting

# When full:
# - Returns 429 Too Many Requests
# - Includes Retry-After header
# - Estimates wait time based on average duration
Μεταφράζει τις αναρτήσεις 100+ blog σε 12 γλώσσες σε ~30 λεπτά (GPU)
avg_duration = 2.5 seconds (tracked with EMA)
waiters = 100
slots = 1
estimated_wait = (100 / 1) * 2.5 = 250 seconds
clamped = min(250, 120) = 120 seconds
Retry-After: 120
Συνεπής ποιότητα σε όλες τις θέσεις
graph LR
    A[Ukrainian Text] --> B{Direct uk→fr?}
    B -->|Exists| C[Translate Directly]
    B -->|Missing| D[Pivot via English]

    D --> E[uk→en]
    E --> F[en→fr]
    F --> G[French Result]
    C --> G
Συνολική εγκατάσταση: Ένα δοχείο Docker
Η διαφορά ταχύτητας και μόνο καθιστά την NMT τη μόνη πρακτική επιλογή για τους αγωγούς μετάφρασης παραγωγής.
NMT είναι σκοπός-χτισμένο για τη μετάφραση, τρέχει σε μέτρια υλικό, και είναι 100-100x γρηγορότερα από LLMs. Αν χρειάζεστε γρήγορη, συνεπή, οικονομικά αποδοτική μετάφραση σε κλίμακα, NMT κερδίζει τα χέρια κάτω.
# src/core/cache.py
from collections import OrderedDict
import torch

class LRUPipelineCache:
    """LRU cache that automatically cleans up GPU memory when evicting models."""

    def __init__(self, capacity: int):
        self.cache = OrderedDict()  # Maintains insertion order
        self.capacity = capacity

    def get(self, key: str):
        """Get model from cache, moves it to end (most recently used)."""
        if key not in self.cache:
            return None
        self.cache.move_to_end(key)  # Mark as recently used
        return self.cache[key]

    def put(self, key: str, value):
        """Add model to cache, evicting oldest if at capacity."""
        if key in self.cache:
            self.cache.move_to_end(key)
        else:
            self.cache[key] = value

        # If cache is full, evict the oldest model
        if len(self.cache) > self.capacity:
            oldest_key, oldest_pipeline = self.cache.popitem(last=False)

            # MAGIC: Move evicted model to CPU to free GPU memory
            try:
                oldest_pipeline.model.to("cpu")
                if torch.cuda.is_available():
                    torch.cuda.empty_cache()  # Tell GPU to release memory
                logger.info(f"Evicted {oldest_key}, freed GPU memory")
            except Exception as e:
                logger.warning(f"Failed to clean GPU memory: {e}")
Αρχιτεκτονική επισκόπηση
OrderedDictΗ ροή της αίτησης είναι απλή:→ Η αίτηση πηγαίνει αμέσως στη μεταφραστική υπηρεσία
# src/services/model_manager.py
def get_pipeline(self, src: str, tgt: str):
    """Try to get translation model, with automatic fallback to other providers."""

    # Determine which model families support this language pair
    families_to_try = []

    if config.AUTO_MODEL_FALLBACK:
        # Try families in priority order: opus-mt → mbart50 → m2m100
        for family in config.MODEL_FALLBACK_ORDER.split(","):
            if self._is_pair_supported(src, tgt, family.strip()):
                families_to_try.append(family.strip())

    # Try each family until one succeeds
    last_error = None
    for family in families_to_try:
        try:
            model_name, src_lang, tgt_lang, _ = self._get_model_name_and_langs(src, tgt, family)

            if family != config.MODEL_FAMILY:
                logger.info(f"Using fallback '{family}' for {src}->{tgt}")

            # Load the model from HuggingFace
            pipeline = transformers.pipeline(
                "translation",
                model=model_name,
                device=device_manager.device_index,
                src_lang=src_lang,
                tgt_lang=tgt_lang
            )

            self.cache.put(f"{src}->{tgt}", pipeline)
            return pipeline

        except Exception as e:
            last_error = e
            logger.warning(f"Family '{family}' failed for {src}->{tgt}: {e}")
            continue  # Try next family

    # All families failed
    raise ModelLoadError(f"{src}->{tgt}", last_error)
Όχι.
(LRU) παρέχει μεταφραστικά μοντέλα:
# src/services/queue_manager.py
import asyncio
from contextlib import asynccontextmanager

class QueueManager:
    """Manages request queuing and backpressure."""

    def __init__(self, max_inflight: int, max_queue: int):
        self.semaphore = asyncio.Semaphore(max_inflight)  # Limit concurrent translations
        self.max_queue_size = max_queue
        self.waiting_count = 0
        self.inflight_count = 0
        self.avg_duration_sec = 5.0  # Exponential moving average

    @asynccontextmanager
    async def acquire_slot(self):
        """Try to get a translation slot, track metrics, handle queueing."""

        # Check if queue is too full
        if self.waiting_count >= self.max_queue_size:
            # Calculate how long client should wait before retrying
            retry_after = self._estimate_retry_after()
            raise QueueOverflowError(self.waiting_count, retry_after)

        self.waiting_count += 1
        try:
            # Wait for available slot (this is the queue!)
            await self.semaphore.acquire()
            self.waiting_count -= 1
            self.inflight_count += 1

            start_time = time.time()
            yield  # Let the translation happen

            # Update average duration for retry-after estimates
            duration = time.time() - start_time
            alpha = config.RETRY_AFTER_ALPHA  # Smoothing factor (0.2)
            self.avg_duration_sec = alpha * duration + (1 - alpha) * self.avg_duration_sec

        finally:
            self.inflight_count -= 1
            self.semaphore.release()

    def _estimate_retry_after(self) -> int:
        """Smart calculation: how many waiting / how many slots * avg time per request."""
        if self.inflight_count == 0:
            return config.RETRY_AFTER_MIN_SEC

        # If 10 people waiting and 2 slots available, and each takes 5 seconds:
        # retry_after = (10 / 2) * 5 = 25 seconds
        retry_sec = (self.waiting_count / self.semaphore._value) * self.avg_duration_sec

        # Clamp between min and max
        return max(
            config.RETRY_AFTER_MIN_SEC,
            min(int(retry_sec), config.RETRY_AFTER_MAX_SEC)
        )
Κέις χτύπησε → Γρήγορη απάντηση
max_inflight)@asynccontextmanagerεπιστρέφει στον πελάτηΣωλήνας επεξεργασίας εισόδου
# src/utils/symbol_masking.py
import re

def mask_symbols(text: str) -> tuple[str, dict[str, str]]:
    """Replace special symbols with placeholders before translation."""

    originals = {}
    masked_text = text
    placeholder_counter = 0

    # Pattern: Match emojis, symbols, special punctuation
    # \U0001F300-\U0001F9FF = emoji range
    # [\u2600-\u26FF\u2700-\u27BF] = misc symbols
    symbol_pattern = re.compile(
        r'[\U0001F300-\U0001F9FF\u2600-\u26FF\u2700-\u27BF'
        r'\u00A9\u00AE\u2122\u2139\u3030\u303D\u3297\u3299]+'
    )

    for match in symbol_pattern.finditer(text):
        symbol = match.group()
        placeholder = f"__SYMBOL_{placeholder_counter}__"
        originals[placeholder] = symbol
        masked_text = masked_text.replace(symbol, placeholder, 1)
        placeholder_counter += 1

    return masked_text, originals

def unmask_symbols(text: str, originals: dict[str, str]) -> str:
    """Restore original symbols after translation."""
    for placeholder, original in originals.items():
        text = text.replace(placeholder, original)
    return text
Η υπηρεσία χρησιμοποιεί έναν εξελιγμένο αγωγό πολλαπλών σταδίων για να χειριστεί το μπερδεμένο κείμενο του πραγματικού κόσμου:
# Before translation:
text = "Hello! 👋 Check out this cool feature 🚀"

# Mask symbols:
masked, originals = mask_symbols(text)
# masked = "Hello! __SYMBOL_0__ Check out this cool feature __SYMBOL_1__"
# originals = {"__SYMBOL_0__": "👋", "__SYMBOL_1__": "🚀"}

# Translate the masked text:
translated = translate(masked, "de")  # → "Hallo! __SYMBOL_0__ Schau dir diese coole Funktion an __SYMBOL_1__"

# Unmask symbols:
final = unmask_symbols(translated, originals)
# final = "Hallo! 👋 Schau dir diese coole Funktion an 🚀"
Μασκοφόρος: "Γεια σας MSK0 BAR Κόσμος _BAR_ΜΣΚ1
👋Τα μοντέλα δεν πνίγονται σε τεράστιες εισροές__SYMBOL_0__Μπορούμε να το κάνουμε αποτελεσματικά.Γιατί αυτό μετράει:
# src/utils/text_processing.py
def chunk_sentences(sentences: list[str], max_chars: int = 900) -> list[list[str]]:
    """Group sentences into chunks that fit within model's max input length."""

    chunks = []
    current_chunk = []
    current_length = 0

    for sentence in sentences:
        sentence_len = len(sentence)

        # If this sentence alone is too long, it goes in its own chunk
        if sentence_len > max_chars:
            if current_chunk:
                chunks.append(current_chunk)
                current_chunk = []
                current_length = 0
            chunks.append([sentence])
            continue

        # If adding this sentence exceeds limit, start new chunk
        if current_length + sentence_len + 1 > max_chars:
            chunks.append(current_chunk)
            current_chunk = [sentence]
            current_length = sentence_len
        else:
            current_chunk.append(sentence)
            current_length += sentence_len + 1  # +1 for space

    # Don't forget the last chunk!
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def split_sentences(text: str, max_sentence_chars: int = 500) -> list[str]:
    """Split text into sentences, enforcing max length."""

    # Split on common sentence terminators
    sentences = re.split(r'([.!?…]+\s+)', text)

    result = []
    for sentence in sentences:
        if not sentence or sentence.isspace():
            continue

        # If sentence is too long, split on word boundaries
        if len(sentence) > max_sentence_chars:
            words = sentence.split()
            current = []
            current_len = 0

            for word in words:
                if current_len + len(word) + 1 > max_sentence_chars:
                    result.append(' '.join(current))
                    current = [word]
                    current_len = len(word)
                else:
                    current.append(word)
                    current_len += len(word) + 1

            if current:
                result.append(' '.join(current))
        else:
            result.append(sentence.strip())

    return result
Η μνήμη GPU είναι πολύτιμη
.!?…Κρατάμε τα 6 πιο πρόσφατα μοντέλα ζεστάPivot μέσω της αγγλικής:
# src/services/model_discovery.py
import httpx
from datetime import datetime, timedelta

class ModelDiscoveryService:
    """Discovers available translation models with 1-hour cache."""

    def __init__(self):
        self._cache = {}  # Cache results to avoid hammering HuggingFace API
        self._cache_ttl = timedelta(hours=1)
        self._hf_api_base = "https://huggingface.co/api/models"

    async def discover_opus_mt_pairs(self, force_refresh: bool = False):
        """Query HuggingFace for all Helsinki-NLP Opus-MT models."""

        cache_key = "opus-mt"

        # Check cache first
        if not force_refresh and cache_key in self._cache:
            cached_data, cached_time = self._cache[cache_key]
            if datetime.now() - cached_time < self._cache_ttl:
                return cached_data  # Cache hit!

        # Cache miss - query HuggingFace API
        async with httpx.AsyncClient() as client:
            response = await client.get(
                self._hf_api_base,
                params={
                    "author": "Helsinki-NLP",
                    "search": "opus-mt",
                    "limit": 1000
                },
                timeout=30.0
            )
            models = response.json()

        # Extract language pairs from model names
        # Example: "Helsinki-NLP/opus-mt-en-de" → ("en", "de")
        pairs = []
        for model in models:
            model_id = model.get("modelId", "")
            if model_id.startswith("Helsinki-NLP/opus-mt-"):
                # Extract the language codes after "opus-mt-"
                lang_part = model_id.replace("Helsinki-NLP/opus-mt-", "")
                if "-" in lang_part:
                    src, tgt = lang_part.split("-", 1)
                    pairs.append({"source": src, "target": tgt})

        # Cache the results
        self._cache[cache_key] = (pairs, datetime.now())

        return pairs
Αυτό διπλασιάζει την καθυστέρηση αλλά εξασφαλίζει κάλυψη για όλα τα υποστηριζόμενα ζεύγη γλωσσών.
httpxΑς εξερευνήσουμε μερικά από τα πιο ενδιαφέροντα μέρη της βάσης κώδικα!enΈνα από τα πιο cool χαρακτηριστικά είναι το έξυπνο μοντέλο cache που ξέρει πώς να χειριστεί τη μνήμη GPU:deΤι συμβαίνει εδώ;Helsinki-NLP/opus-mt-en-deΚαθαρισμός GPU
# src/core/device.py
import torch

class DeviceManager:
    """Smart device selection with GPU auto-detection."""

    def __init__(self):
        self.use_gpu = self._should_use_gpu()
        self.device_index = self._resolve_device()
        self.device_str = "cpu" if self.device_index < 0 else f"cuda:{self.device_index}"

        # Auto-configure parallel translation slots based on device
        if self.device_index >= 0:
            # GPU: Run translations serially to avoid VRAM fragmentation
            self.max_inflight = 1
        else:
            # CPU: Can handle multiple translations in parallel
            self.max_inflight = config.MAX_WORKERS_BACKEND

        self._log_device_info()

    def _should_use_gpu(self) -> bool:
        """Check if GPU should be used."""
        if config.USE_GPU.lower() == "false":
            return False
        if config.USE_GPU.lower() == "true":
            return torch.cuda.is_available()
        # "auto" mode: use GPU if available
        return torch.cuda.is_available()

    def _resolve_device(self) -> int:
        """Returns device index: -1 for CPU, 0+ for CUDA."""
        if not self.use_gpu:
            return -1

        # Check if specific CUDA device requested
        if config.DEVICE and config.DEVICE.startswith("cuda:"):
            device_num = int(config.DEVICE.split(":")[1])
            return device_num

        return 0  # Use first GPU

    def _log_device_info(self):
        """Log device information at startup."""
        if self.device_index >= 0:
            gpu_name = torch.cuda.get_device_name(self.device_index)
            vram_gb = torch.cuda.get_device_properties(self.device_index).total_memory / 1e9
            logger.info(f"Using GPU: {gpu_name} ({vram_gb:.1f}GB VRAM)")
            logger.info(f"Max inflight translations: {self.max_inflight} (GPU mode)")
        else:
            cpu_count = os.cpu_count()
            logger.info(f"Using CPU ({cpu_count} cores)")
            logger.info(f"Max inflight translations: {self.max_inflight} (CPU mode)")

# Global singleton instance
device_manager = DeviceManager()
: Κατά την έξωση ενός μοντέλου, το μεταφέρουμε ρητά στη μνήμη της ΚΜΕ και λέμε στην GPU να απελευθερώσει τους πόρους της
max_inflight=1Αυτή η έξυπνη λειτουργία δοκιμάζει αυτόματα πολλούς παρόχους μοντέλων AI εάν ο πρώτος δεν έχει το ζεύγος γλωσσών που χρειάζεστε:max_inflight=4Τι συμβαίνει εδώ;DEVICE=cuda:1: Τα επιτυχημένα μοντέλα είναι κλεισμένα με το κλειδί ζεύγους γλώσσας
# Snippet from QueueManager showing EMA calculation
def update_avg_duration(self, new_duration: float):
    """Update average duration using exponential moving average."""

    # EMA formula: new_avg = α × new_value + (1 - α) × old_avg
    # α = smoothing factor (0.0 to 1.0)
    #   - Higher α = more weight to recent values (faster adaptation)
    #   - Lower α = more weight to historical values (more stable)

    alpha = 0.2  # 20% weight to new value, 80% to historical

    self.avg_duration_sec = (
        alpha * new_duration +
        (1 - alpha) * self.avg_duration_sec
    )
3.
# Initial average: 5.0 seconds
# New request takes: 10.0 seconds

# EMA calculation:
new_avg = 0.2 * 10.0 + 0.8 * 5.0
        = 2.0 + 4.0
        = 6.0 seconds

# Next request takes: 3.0 seconds
new_avg = 0.2 * 3.0 + 0.8 * 6.0
        = 0.6 + 4.8
        = 5.4 seconds
Αίτημα Queue με Backpressure (HTTP 429)
Retry-AfterΕπιφανειοδραστικός κινούμενος μέσος όρος: Καταπραΰνει τα καρφιά σε διάρκεια αιτήματος
προσωρινά
: Μεταφραστικά μοντέλα μερικές φορές διαφθείρουν ή να αφαιρέσουν emojis - αυτό τα διατηρεί τέλεια!
# Prefer GPU if available (default)
USE_GPU=auto

# Force GPU
USE_GPU=true

# Force CPU
USE_GPU=false

# Explicit device override
DEVICE=cuda:0
DEVICE=cpu
# Model family selection (NEW in v2.0!)
MODEL_FAMILY=opus-mt   # Best quality (default)
MODEL_FAMILY=mbart50   # 50 languages, single model
MODEL_FAMILY=m2m100    # 100 languages, maximum coverage

# Auto-fallback between model families (NEW in v2.0!)
AUTO_MODEL_FALLBACK=1  # Enabled by default
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"  # Priority order

# Volume-mapped model cache (NEW in v2.0!)
MODEL_CACHE_DIR=/models  # Persistent cache directory

# Model arguments passed to transformers.pipeline
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
EASYNMT_MODEL_ARGS='{"torch_dtype":"bf16","cache_dir":"/models"}'

# Preload models at startup (reduces first-request latency)
PRELOAD_MODELS="en->de,de->en,fr->en"

# LRU cache capacity
MAX_CACHED_MODELS=6
Σπάει τα μεγάλα κείμενα σε κομμάτια που ταιριάζουν στα όρια του μοντέλου διατηρώντας τα όρια της πρότασης:
**Τι συμβαίνει εδώ;**Διαχωρισμός της ποινής
opus-mt: Χρησιμοποιεί το regex για να χωρίσειmbart50ενώ διατηρείτε την στίξηm2m100Άπληστο πνιγμό: Συσκευάζει όσο το δυνατόν περισσότερες προτάσεις σε κάθε κομμάτι χωρίς να υπερβαίνει το όριοΔιάσπαση ορίων λέξεων
1: Εάν μια πρόταση είναι πολύ μεγάλη, χωρίζεται σε χώρους αντί να κόβει τη μέση λέξη0Γιατί έχει σημασία;**: Τα μεταφραστικά μοντέλα έχουν όρια εισόδου (συνήθως 512-1024 μάρκες).**Αυτό εξασφαλίζει ότι δεν θα τους ξεπεράσουμε ποτέ, διατηρώντας το πλαίσιο ανέπαφο.
"opus-mt,mbart50,m2m100"Async Model Discovery με Caching"m2m100,mbart50,opus-mt"Τι συμβαίνει εδώ;Async HTTP client): Makes non-blocking HTTP requests to HuggingFace
/models: Αποθηκεύει αποτελέσματα για 1 ώρα για να αποφευχθεί ο περιορισμός ποσοστού-v ./model-cache:/modelsκαι
fp16απόbf16Γιατί έχει σημασία;fp32: HuggingFace έχει 1200+ μοντέλα Opus-MT.# Batch size for translation (higher = faster but more VRAM)
EASYNMT_BATCH_SIZE=16 # CPU: 8-16, GPU: 32-64
# Maximum text length per item
EASYNMT_MAX_TEXT_LEN=1000
# Maximum beam size (higher = better quality but slower)
EASYNMT_MAX_BEAM_SIZE=5
# Worker thread pools
MAX_WORKERS_BACKEND=1 # Translation workers
MAX_WORKERS_FRONTEND=2 # Language detection workers
# Enable request queueing (highly recommended)
ENABLE_QUEUE=1

# Max concurrent translations
# Auto: 1 on GPU, MAX_WORKERS_BACKEND on CPU
MAX_INFLIGHT_TRANSLATIONS=1

# Max queued requests before 429
MAX_QUEUE_SIZE=1000

# Per-request timeout (0 = disabled)
TRANSLATE_TIMEOUT_SEC=180

# Retry-After estimation
RETRY_AFTER_MIN_SEC=1      # Floor
RETRY_AFTER_MAX_SEC=120    # Ceiling
RETRY_AFTER_ALPHA=0.2      # EMA smoothing factor
# Enable input filtering
INPUT_SANITIZE=1

# Minimum alphanumeric ratio (0.2 = 20%)
INPUT_MIN_ALNUM_RATIO=0.2

# Minimum character count
INPUT_MIN_CHARS=1

# Language code for undetermined/noise
UNDETERMINED_LANG_CODE=und
# Default sentence splitting behavior
PERFORM_SENTENCE_SPLITTING_DEFAULT=1

# Max chars per sentence before word-boundary split
MAX_SENTENCE_CHARS=500

# Max chars per chunk for batching
MAX_CHUNK_CHARS=900

# Sentence joiner
JOIN_SENTENCES_WITH=" "
# Enable symbol masking
SYMBOL_MASKING=1

# What to mask
MASK_DIGITS=1    # Mask 0-9
MASK_PUNCT=1     # Mask .,!? etc.
MASK_EMOJI=1     # Mask 😀🎉 etc.
# Align response array length to input
ALIGN_RESPONSES=1

# Placeholder for failed items (when aligned)
SANITIZE_PLACEHOLDER=""

# Response format
EASYNMT_RESPONSE_MODE=strings    # ["translation1", "translation2"]
EASYNMT_RESPONSE_MODE=objects    # [{"text":"translation1"}, ...]
# Enable two-hop translation via pivot
PIVOT_FALLBACK=1

# Pivot language (usually English)
PIVOT_LANG=en
# Log level
LOG_LEVEL=INFO

# Per-request logging (verbose)
REQUEST_LOG=1

# Format
LOG_FORMAT=plain    # Human-readable
LOG_FORMAT=json     # Structured JSON

# File logging with rotation
LOG_TO_FILE=1
LOG_FILE_PATH=/var/log/marian-translator/app.log
LOG_FILE_MAX_BYTES=10485760    # 10MB
LOG_FILE_BACKUP_COUNT=5

# Include raw text in logs (privacy risk!)
LOG_INCLUDE_TEXT=0
# Periodically clear CUDA cache (seconds, 0=disabled)
CUDA_CACHE_CLEAR_INTERVAL_SEC=0
# Worker count (use 1 for single GPU)
WEB_CONCURRENCY=1

# Request timeout
TIMEOUT=60

# Graceful shutdown timeout
GRACEFUL_TIMEOUT=20

# Keep-alive timeout
KEEP_ALIVE=5
# GET request
curl "http://localhost:8000/translate?target_lang=de&text=Hello%20world&source_lang=en"

# Response
{
  "translations": ["Hallo Welt"]
}
# POST request
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": [
      "Hello world",
      "This is a test",
      "Machine translation is amazing"
    ],
    "target_lang": "de",
    "source_lang": "en",
    "beam_size": 1,
    "perform_sentence_splitting": true
  }'

# Response
{
  "target_lang": "de",
  "source_lang": "en",
  "translated": [
    "Hallo Welt",
    "Das ist ein Test",
    "Maschinenübersetzung ist erstaunlich"
  ],
  "translation_time": 0.342
}
# Omit source_lang for auto-detection
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": ["Bonjour le monde"],
    "target_lang": "en"
  }'

# Response
{
  "target_lang": "en",
  "source_lang": "fr",  # Detected
  "translated": ["Hello world"],
  "translation_time": 0.156
}
# GET
curl "http://localhost:8000/language_detection?text=Hola%20mundo"
# {"language": "es"}

# POST with batch
curl -X POST http://localhost:8000/language_detection \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello", "Bonjour", "Hola"]}'
# {"languages": ["en", "fr", "es"]}
# Health check
curl http://localhost:8000/healthz
# {"status": "ok"}

# Readiness
curl http://localhost:8000/readyz
# {
#   "status": "ready",
#   "device": "cuda:0",
#   "queue_enabled": true,
#   "max_inflight": 1
# }

# Cache status
curl http://localhost:8000/cache
# {
#   "capacity": 6,
#   "size": 3,
#   "keys": ["en->de", "de->en", "fr->en"],
#   "device": "cuda:0",
#   "inflight": 1,
#   "queue_enabled": true
# }

# Model info
curl http://localhost:8000/model_name | jq
# When queue is full, you get 429
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["test"], "target_lang": "de"}'

# Response: 429 Too Many Requests
# Headers: Retry-After: 45
# Body:
{
  "message": "Too many requests; queue full",
  "retry_after_sec": 45
}

# Proper client behavior:
# 1. Read Retry-After header
# 2. Wait that long + jitter
# 3. Retry request
Ομαλή εκ νέου δοκιμή μετά την εκτίμηση που προσαρμόζεται στις πραγματικές διάρκεια της αίτησης:
Παράδειγμα:
.\build-all.ps1
Τι συμβαίνει εδώ;
chmod +x build-all.sh
./build-all.sh
: Όπως ένας σταθμισμένος μέσος όρος που δίνει μεγαλύτερη σημασία στις πρόσφατες τιμέςΚαταπραϋντικός συντελεστής (α):
latest, min, gpu, gpu-minΓιατί όχι απλός μέσος όρος;20250108.143022: Δίνει στους πελάτες ρεαλιστικόφορές που προσαρμόζονται στο τρέχον φορτίο του συστήματος
# Always get the latest version
docker pull scottgal/mostlylucid-nmt:cpu
# Or use the :latest alias
docker pull scottgal/mostlylucid-nmt:latest

# Pin to a specific version for reproducibility
docker pull scottgal/mostlylucid-nmt:cpu-20250108.143022
docker pull scottgal/mostlylucid-nmt:cpu-min-20250108.143022
Διαχείριση πόρων
: Smart caching, chunking και παράλληλη επεξεργασία
docker inspect scottgal/mostlylucid-nmt:cpu | jq '.[0].Config.Labels'
Παρατηρησιμότητα: Λεπτομερής καταγραφή και παρακολούθηση μετρήσεων.
# Using pre-built image from Docker Hub (recommended)
docker run -d \
  --name translator \
  -p 8000:8000 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=500 \
  -e EASYNMT_BATCH_SIZE=16 \
  -e TIMEOUT=180 \
  -e LOG_LEVEL=INFO \
  -e REQUEST_LOG=0 \
  scottgal/mostlylucid-nmt

# Or build locally
docker build -t mostlylucid-nmt .
docker run -d --name translator -p 8000:8000 mostlylucid-nmt

# Check logs
docker logs -f translator
# Using pre-built GPU image from Docker Hub (recommended)
docker run -d \
  --name translator-gpu \
  --gpus all \
  -p 8000:8000 \
  -e USE_GPU=true \
  -e DEVICE=cuda:0 \
  -e PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en" \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  -e EASYNMT_BATCH_SIZE=64 \
  -e MAX_CACHED_MODELS=8 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=2000 \
  -e WEB_CONCURRENCY=1 \
  -e TIMEOUT=180 \
  -e GRACEFUL_TIMEOUT=30 \
  -e LOG_FORMAT=json \
  -e LOG_TO_FILE=1 \
  -v /var/log/translator:/var/log/marian-translator \
  scottgal/mostlylucid-nmt:gpu

# Or build locally
docker build -f Dockerfile.gpu -t mostlylucid-nmt:gpu .
docker run -d --name translator-gpu --gpus all -p 8000:8000 mostlylucid-nmt:gpu

# Monitor cache and performance
watch -n 5 "curl -s http://localhost:8000/cache | jq"
version: '3.8'

services:
  translator:
    image: scottgal/mostlylucid-nmt:gpu  # Use pre-built image
    container_name: translator
    restart: unless-stopped

    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]

    ports:
      - "8000:8000"

    environment:
      USE_GPU: "true"
      DEVICE: "cuda:0"
      PRELOAD_MODELS: "en->de,de->en,en->fr,fr->en"
      EASYNMT_MODEL_ARGS: '{"torch_dtype":"fp16"}'
      EASYNMT_BATCH_SIZE: "64"
      MAX_CACHED_MODELS: "8"
      ENABLE_QUEUE: "1"
      MAX_QUEUE_SIZE: "2000"
      WEB_CONCURRENCY: "1"
      TIMEOUT: "180"
      LOG_FORMAT: "json"
      LOG_TO_FILE: "1"

    volumes:
      - translator-logs:/var/log/marian-translator
      - translator-cache:/root/.cache/huggingface

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/healthz"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s

volumes:
  translator-logs:
  translator-cache:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: translator
spec:
  replicas: 2  # Scale horizontally for CPU, use 1 per GPU
  selector:
    matchLabels:
      app: translator
  template:
    metadata:
      labels:
        app: translator
    spec:
      containers:
      - name: translator
        image: scottgal/mostlylucid-nmt:gpu
        ports:
        - containerPort: 8000
        env:
        - name: USE_GPU
          value: "true"
        - name: EASYNMT_MODEL_ARGS
          value: '{"torch_dtype":"fp16"}'
        - name: PRELOAD_MODELS
          value: "en->de,de->en"
        - name: ENABLE_QUEUE
          value: "1"
        - name: MAX_QUEUE_SIZE
          value: "2000"

        resources:
          requests:
            memory: "4Gi"
            cpu: "2"
            nvidia.com/gpu: 1
          limits:
            memory: "8Gi"
            cpu: "4"
            nvidia.com/gpu: 1

        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10

        readinessProbe:
          httpGet:
            path: /readyz
            port: 8000
          initialDelaySeconds: 20
          periodSeconds: 5

---
apiVersion: v1
kind: Service
metadata:
  name: translator
spec:
  selector:
    app: translator
  ports:
  - port: 80
    targetPort: 8000
  type: LoadBalancer
ΥΠΟΔΕΙΓΜΑ_FAMILY
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
: Καλή ποιότητα, 100 γλώσσες, μονό μοντέλο 2.2GB
# Start high, reduce if you get OOM
EASYNMT_BATCH_SIZE=64  # Try 128 on large GPUs
AUTO_MODEL_FALLBACK
PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en"
: Αυτόματα δοκιμάστε άλλες οικογένειες αν δεν υπάρχει ζευγάρι
WEB_CONCURRENCY=1
MAX_INFLIGHT_TRANSLATIONS=1
(προκαθορισμένο): Ενεργοποιημένο - μέγιστη κάλυψη
MAX_CACHED_MODELS=10 # Keep more models in VRAM
: Αναπήρους - αυστηρός τρόπος μονοκατοικίας
# beam_size=1 is 3-5x faster than beam_size=5
# Quality difference is often minimal
curl -X POST ... -d '{"beam_size": 1, ...}'
: Σειρά προτεραιότητας για οπισθοδρόμηση
EASYNMT_BATCH_SIZE=8
Προκαθορισμένο:
MAX_WORKERS_BACKEND=4
MAX_INFLIGHT_TRANSLATIONS=4
WEB_CONCURRENCY=2
(πρώτη ποιότητα)
PERFORM_SENTENCE_SPLITTING_DEFAULT=0
(πρώτη κάλυψη)
// Bad: 100 separate requests
for (const text of texts) {
  await translate(text);
}

// Good: 1 batch request
await translate(texts);
ΜΟΝΤΕΛΟ_ΚΑΧΗ_ΔΙΟΡΙΣΜΟΣ
async function translateWithRetry(texts) {
  try {
    return await translate(texts);
  } catch (err) {
    if (err.status === 429) {
      const retryAfter = err.headers['retry-after'];
      const jitter = Math.random() * 5;
      await sleep((retryAfter + jitter) * 1000);
      return translateWithRetry(texts);
    }
    throw err;
  }
}
: Διαρκής αποθήκευση μοντέλου μέσω όγκου Docker
// Reuse HTTP connections
const agent = new https.Agent({ keepAlive: true });
Σετ προς
// Bad: mixed language pairs in one request
translate([
  { text: "Hello", sourceLang: "en", targetLang: "de" },
  { text: "Bonjour", sourceLang: "fr", targetLang: "de" }
]);

// Good: group by language pair
translateBatch(enToDe, "en", "de");
translateBatch(frToDe, "fr", "de");
Παραδείγματα χρήσης
translation_requests_total{lang_pair="en->de",status="success"} 1523
translation_requests_total{lang_pair="en->de",status="error"} 7
translation_duration_seconds{lang_pair="en->de",quantile="0.5"} 0.342
translation_duration_seconds{lang_pair="en->de",quantile="0.95"} 1.234
translation_queue_depth 23
translation_cache_size 6
translation_cache_hits_total 8234
translation_cache_misses_total 142
# Enable JSON logging
LOG_FORMAT=json REQUEST_LOG=1

# Output example
{
  "ts": "2025-01-08T15:30:45+0000",
  "level": "INFO",
  "name": "app",
  "message": "translate_post done items=5 dt=0.342s",
  "req_id": "a3d2f5b1-c4e6-4f7a-9d8c-1e2f3a4b5c6d",
  "endpoint": "/translate",
  "src": "en",
  "tgt": "de",
  "items": 5,
  "duration_ms": 342
}
Μετάφραση παρτίδας (συνιστάται)
Ανίχνευση γλώσσας μόνο |---------|---------|-----------------| | Τελικά σημεία παρατήρησηςΧειρισμός Backpressure | Κτίριο και ΈκδοσηΌλες οι εικόνες Docker τώρα περιλαμβάνουν την κατάλληλη έκδοση και τα μεταδεδομένα για την παρακολούθηση. | Γρήγορη κατασκευήΦτιάξτε και τις 4 παραλλαγές με αυτόματη έκδοση ημερομηνίας: | **Παράθυρα:**Linux/Mac: | Στρατηγική έκδοσηςΚάθε κατασκευή δημιουργεί | δύο ετικέτεςΟνομάζεται ετικέτα | ) - πάντα δείχνει την πιο πρόσφατηΕτικέτα έκδοσης | (π.χ.,) - Αμετάβλητο στιγμιότυπο | **Παραδείγματα:**Ετικέτες OCI | **Κάθε εικόνα περιλαμβάνει μεταδεδομένα:**Έκδοση | **: Κατασκευή χρονοσφραγίδας (YYYYMMDD.HHMMSS)**Ημερομηνία κατασκευής | : ISO 8601 χρονοσφραγίδαΔώσε μου το χέρι σου.
: cpu-full, cpu-min, gpu-full, ή gpu-minΕτικέτες επιθεώρησης:
Για λεπτομερείς οδηγίες κατασκευής και ενσωμάτωση CI/CD, βλ.
MAX_QUEUE_SIZEMAX_INFLIGHT_TRANSLATIONSΑνάπτυξη GPUΒελτιστοποίηση των επιδόσεωνΛίστα ελέγχου βελτιστοποίησης GPU
Χρήση ακρίβειας FP16
ENABLE_QUEUE=1Μέγεθος παρτίδας TuneΠροφόρτωση ζεστών μοντέλων
Ελεύθερος εργαζόμενος ανά GPU
EASYNMT_BATCH_SIZEMAX_CACHED_MODELSEASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'WEB_CONCURRENCY=1Αύξηση παραλληλισμούMAX_INFLIGHT_TRANSLATIONS=1Βέλτιστες Πρακτικές ΠελατώνΖήτημα παρτίδας
Σεβασμός - Μετά
PRELOAD_MODELS="en->de,de->en"
Ομάδα ανά ζεύγος γλωσσών Helsinki-NLP/opus-mt-{src}-{tgt}Παρακολούθηση & Παρατήρηση
Μετρική κλειδί για την παρακολούθηση
PIVOT_FALLBACK=1(ζητήματα/δευτερόλεπτο)curl http://localhost:8000/lang_pairsΒάθος αναμονής(τρέχων αριθμός αναμονής)
Ρυθμός χτυπήματος CacheName
MASK_EMOJI=0Ποσοστό σφάλματοςMASK_PUNCT=0SYMBOL_MASKING=0(κατά περίπτωση)
public class MostlyLucidNmtClient
{
    private readonly HttpClient _httpClient;
    private readonly string _baseUrl;

    public MostlyLucidNmtClient(HttpClient httpClient, string baseUrl)
    {
        _httpClient = httpClient;
        _baseUrl = baseUrl;
    }

    public async Task<TranslationResponse> TranslateAsync(
        List<string> texts,
        string targetLang,
        string sourceLang = "",
        int beamSize = 1,
        bool performSentenceSplitting = true,
        CancellationToken cancellationToken = default)
    {
        var request = new TranslationRequest
        {
            Text = texts,
            TargetLang = targetLang,
            SourceLang = sourceLang,
            BeamSize = beamSize,
            PerformSentenceSplitting = performSentenceSplitting
        };

        var response = await _httpClient.PostAsJsonAsync(
            $"{_baseUrl}/translate",
            request,
            cancellationToken);

        if (response.StatusCode == System.Net.HttpStatusCode.TooManyRequests)
        {
            // Read Retry-After header
            var retryAfter = response.Headers.RetryAfter?.Delta?.TotalSeconds ?? 30;
            var jitter = Random.Shared.Next(0, 5);
            await Task.Delay(TimeSpan.FromSeconds(retryAfter + jitter), cancellationToken);

            // Retry
            return await TranslateAsync(texts, targetLang, sourceLang, beamSize,
                performSentenceSplitting, cancellationToken);
        }

        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<TranslationResponse>(cancellationToken);
    }
}

public class TranslationRequest
{
    [JsonPropertyName("text")]
    public List<string> Text { get; set; }

    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("beam_size")]
    public int BeamSize { get; set; }

    [JsonPropertyName("perform_sentence_splitting")]
    public bool PerformSentenceSplitting { get; set; }
}

public class TranslationResponse
{
    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("translated")]
    public List<string> Translated { get; set; }

    [JsonPropertyName("translation_time")]
    public double TranslationTime { get; set; }
}
Χρήση μνήμης
services.AddHttpClient<MostlyLucidNmtClient>(client =>
{
    client.BaseAddress = new Uri("http://translator:8000");
    client.Timeout = TimeSpan.FromMinutes(3);
});
Παράδειγμα Προμηθέας Μετρικός**Αν ενσωματώσετε τον Προμηθέα (όχι ενσωματωμένο, αλλά εύκολο να προσθέσετε):**Παράδειγμα δομημένης καταγραφής
Σύγκριση: EasyNMT vs ΚυρίωςLucid-NMT
Χειρισμός εισόδου
Παρατηρησιμότητα
**Εγχειρίδιο, δεν caching LRU cache με auto-eviction **
Ρύθμιση**□ Limited 40+ env vars for fine-tuning**Συμβατότητα API
# Maximum coverage with auto-fallback (recommended!)
docker run -d -p 8000:8000 \
  -v ./model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  -e AUTO_MODEL_FALLBACK=1 \
  -e MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100" \
  scottgal/mostlylucid-nmt:cpu-min

# GPU with best quality
docker run -d --gpus all -p 8000:8000 \
  -e USE_GPU=true \
  -e MODEL_FAMILY=opus-mt \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu

# Test it
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello world"], "target_lang": "de"}'
OOM (Out of Memory) on GPU
Αιτία:
Μέγεθος παρτίδας πολύ υψηλό ή πάρα πολλά μοντέλα cached.
Αργή πρώτη αίτηση[Αιτία:
Translation NMT Neural Machine Translation Python FastAPI Docker CUDA PyTorch Transformers Helsinki-NLP Production Microservices API

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
