
Semantische Intelligenz – Teil 8 – Tools für den gesamten Weg nach unten : – Das selbst- – Optimierungswerkzeug


Wenn Ihre Werkzeuge sich selbst verfolgen, entwickeln Sie sich selbst und wählen Sie sich
Anmerkung: Dieser Artikel taucht tief in etwas ein, das ich überschattet habe. wie die Werkzeuge selbst arbeiten ,, , Gleisnutzung , , , entwickeln , und erhalten Sie intelligenter im Laufe der Zeit
Anmerkung: Wenn du dachtest, die Workflow-Evolution in Teil war wild. jedes einzelne Werkzeug hat die gleichen Fähigkeiten
Der Teil, der Ihnen sagt:
Im Teil zeigte ich euch gerichtete Synthetische Evolution, :. Arbeitsabläufe, die planen,,. Generieren ,. Ausführen ,. evaluieren und verbessern .. Ich erwähnte eine Reihe von Malen ..
Hier erklärt ', was ich tat, ', nicht erklären
Jene Werkzeuge, die nicht statisch sind, sind keine Konfigurationsdateien, die dort unverändert sitzen.
Sie sind lebende Artefakte, die
- Verfolgen Sie jede Anrufung
- Aus Nutzungsmustern lernen
- Eigene Umsetzungen entwickeln
- Erfolgreiche Antworten einsehen
- Verhandeln Sie Fitness-Trade
- Version selbst automatisch
- Werden Sie über das gesamte System wiederverwendet
Mit anderen Worten: Werkzeuge sind Knoten - .-Knoten sind Werkzeuge -. - Alles entwickelt sich weiter
Und es wird seltsamer...
Die Werkzeuge Registry-:-Ein Selbst---Erweitern Universum
Lassen Sie mich Ihnen zeigen, was das System tatsächlich hat.
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
Das index.json? Linien der Werkzeugdefinitionen, der Nutzungsstatistik, der Versionsgeschichte, der Fitness-Scores und der Linienverfolgung
Jedes Werkzeug darin
- Hat Verwendung Zähler
- Tracks Qualität Punkte aus Bewertungen
- Bewahrt Versionshistorie
- Links zu RAG-Speicherartefakten
- Speichert Leistungskennzahlen
- Rekorde erfolgreiche Anrufungen
HINWEIS:- Das System wird tatsächlich OHNE Tools laufen . ...-Nur weniger effizient und dümmer......... ohne sie würden Werkzeuge als normaler Teil der Workflow-Dekomposition generiert werden.... es würde sich immer noch langsam anpassen, aber...
Lassen Sie uns sehen, was ein Werkzeug wirklich ist.
Werkzeug-Anatomie-: mehr als Konfiguration
Hier ist eine reale Werkzeugdefinition aus dem System.
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Beachten Sie, was es gibt.
- Leistungsstufen Kosten, Geschwindigkeit, Qualität
- Spezialisierung Was ist dieses Tool? gut bei
- Kapazität Maximale Ausgangslänge des Kontextfensters
- Vorlagen Wie man es aufruft
- Stichworte Semantische Kategorisierung
Aber hier, ', was, ' nicht in der YAML-:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Das System Ergänzungen statische Definitionen mit Runtime-Lernen
Usage Tracking - jede Anrufungsmaterie
Hier ist, was passiert, wenn Sie ein Werkzeug verwenden.
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Was wird verfolgt?
- Metadaten aufrufen Temperatur des Werkzeugs ID-ID-,-Modell ,-Parameter
- Leistung Ansprechzeit des Speichers
- Qualität Bewertungsergebnis des Evaluators
- Caching Genaue prompte Übereinstimmung für die Wiederverwendung
- Fitness Mehrdimensionales Scoring
Lassen Sie uns die Caching-Mechanismus
Hierarchisches Caching, :, berechnet nie zweimal
Das cleverste Bit das System zwischenspeichert Werkzeugaufrufe auf mehreren Ebenen
Füllstands-Caching mit exakter Übereinstimmung
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Warum das so wichtig ist
Wenn du das System fragst, um ein Haiku über Code zu schreiben, ist das zweite Mal SofortDer RAG-Speicher gibt das zwischengespeicherte Ergebnis zurück
Aber hier ist das kluge Bit. es gibt die BEST-Version zurück wenn mehrere vorhanden sind
Beispiel:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Das System wählt automatisch das höchstwertige zwischengespeicherte Ergebnis aus.
Adaptives Timeout-Lernen mit :
Eines der subtileren Features ,: , das System lernt, wie lange jedes Modell dauert zu reagieren , um . ,
Das Problem
Verschiedene Modelle haben wild unterschiedliche Reaktionszeiten
tinyllamaSekundarbereichllama3Sekundarbereichqwen2.5-coderSekundarbereichdeepseek-coder-v2Sekundarbereich
Wenn Sie einen globalen Timeout festlegen, verschwenden Sie Sekunden warten auf tinyllamaUnd du tötest deepseek bevor es endet.
Die Lösung: Adaptives Lernen
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Wie es funktioniert
- Spurantwortzeiten für jedes Modell
- Berechnen des Perzentils der meisten Antworten bis zu diesem Zeitpunkt
- Puffer für Sicherheit hinzufügen
- Benutze das als neuen Timeout
Ergebnisse
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Das System lernt den richtigen Timeout für jedes Modell anstatt einen globalen Wert zu verwenden
Multi---Dimensional Fitness - Wahl des richtigen Werkzeugs
Wenn Sie das System bitten, etwas zu tun, ist es nicht nur wählen Sie das erste passende Tool . Fitness-Funktion über mehrere Dimensionen
Fitness-Berechnung
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Echtes Beispiel
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Ausgewählt email_validator_workflow ,(-Ausrüstung , :-Ausführung
Das System wählt die schnell, kostenlos, hoch, qualitativ hochwertige, bewährte Produkte Lösung: Nicht die semantisch ähnlichste Lösung: nicht die leistungsstärkste
Der eine, der mehrere Einschränkungen optimal befriedigt
Werkzeugentwicklung:-Selbst-Verbesserung der Implementierungen
Werkzeuge bleiben statisch... sie entwickeln sich...
Versionierung - Detektion ändern - :
Jedes Werkzeug hat eine Definition hash berechnet aus seinem YAML-:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
Wenn Sie ein Werkzeug bearbeiten
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Bei der nächsten Belastung
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Semantische Versionierung
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Durchbrechen von Änderungen:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Bei der Belastung
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Das System warnt vor Veränderungen und hält Versionshistorie.
RAG-Integration – Werkzeuge als semantische Artefakte
Jedes Tool wird im RAG-Speicher für semantische Suche indexiert
Bei der Lastzeit - :
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Jetzt, wenn Sie suchen
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Das System verwendet RAG-Einbettungen um relevante Werkzeuge zu finden, ordnet sie dann nach Mehrdimensionale Fitness.
Werkzeugraum
In unserem System speichern wir die Vektoren für die Einbettungen in Qdrant eine Vektordatenbank und es gibt uns einen ordentlichen Weg, um zu sehen, wie unser Toolspace Dies ist das Speichersystem unseres Workflow-Gebäudesystems.
In die Originalvorlagen aufgeteilte Dateien im Werkzeugverzeichnis sowie jedes Element von Code, das generiert wird, um eine Aufgabe zu lösen. Diese Form zu Toolkit zum Zusammenbauen worklfows.., Pre--, gebaute Stücke aus dem Bereich von...
- Die Original-Prompt, die wir aus dem neuen bauen konnten
- Die ganze Workflow-Datei wie bei allem anderen ein Python-Skript
- Jedes Werkzeug verwenden Sie -, die ein Tool nannten, wenn ,, wie oft
- Jede Python-Funktion (-Workflow-Dateien ,-generiert)-
Auf diese Weise ist das gesamte Workdlow komponierbar und testbar, da jedes Python-Element eine Reihe von Tests hat.,-BDD-Spezifikation: ,-Statikwerkzeuge zur Überprüfung der Korrektheit: mehrere LLM-Evaluatoren, um sicherzustellen, dass es funktioniert.
der Nebeneffekt ist JEDES Stück Code, das in einem Workflow ausgeführt wird, ist genau dort...... bereit zu prüfen, wie jede '?tool......... die Erstellung von Python-Spritzen......
Du kannst sehen, wie der Toos zusammenklumpt und jeder Blob ein semantisch verknüpfter Satz von Werkzeugen ist.
- 1 und 2 hinzufügen
- Plice (Plice) hinzufügen
- Fügt betäubt x plus Zahl y hinzu
- und der optimierte x-+-Code-Ansatz
Alle zusammen geclustert ,. , natürlich spezialisiert auf die durch das System , ' , Natur , . ,
In Zukunft werden wir uns wahrscheinlich diese Cluster optimieren wollen, um die Codebase auf ein kleineres, engeres und optimierteres System zu reduzieren.
Da wir Versionen verfolgen können, können wir die am häufigsten verwendeten und leistungskritischen Komopnenten als Teil der Art und Weise wie das System intrinsisch strukturiert ist.
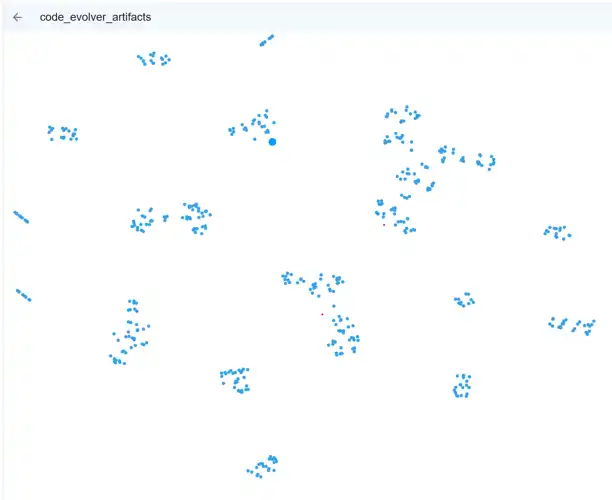
Das reiche Ökosystem, das entstanden ist
Lassen Sie uns sehen, was tatsächlich im System jetzt existiert.
LLM Werkzeuge Spezialisten
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Ausführbare Werkzeuge
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
Öffnen von API-Werkzeugen
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Werkzeuge insgesamt 50+
Gesamtlinien von Metadata-: Linien in index.json
Echtes Beispiel: Das Code Optimizer Tool
Lassen Sie mich Ihnen das anspruchsvollste Werkzeug im System zeigen code-_-Optimierung.
Begriffsbestimmungen tools/llm/code_optimizer.yaml LEITLINIEN
Was es tut
- Profile Ausgangsleistung
- Analyse Engpässe im Speicher von (CPU-,« IM/«O®,)
- Wählt die Optimierungsstufe aus
- LOCAL (-frei,-Verbesserung
- CLOUD (-paid-,-Verbesserung
- DEEP-System zur Neugestaltung der MSK-Ebene
- Optimiert Code auf ausgewählter Ebene
- Aktualisierungen der Tests automatisch
- Profile optimierte Version
- Vergleiche Vorher, /, nachher
- beschließt /-Widerspruch akzeptieren
- Fassungen wenn angenommen
- Migrates Nutzung, wenn sich kein Bruch ändert
Hierarchische Optimierung
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Kostenmanagement
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Integration von Tests
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Versionsverwaltung-:-
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Diese Einzelwerkzeug orchestriert
- Profiling läuft
- LLM-Optimierung auf mehreren Ebenen
- Automatische Testaktualisierung
- Leistungsvergleich
- Eskalation der Kosten
- Versionsverwaltung
- Automatische Migration
Und es, ' nur ein Werkzeug in einem System mit Werkzeugmaschinen.
Modellauswahl LLMs für LLM
Eines der meta-Tools Modell: _-Selektor.
Natürliche Sprachauswahl
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Wie es funktioniert
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Das System parsiert natürliche Sprache um Modelle auszuwählen, können Sie sagen, :
- Verwendung von gpt--4 für diese
- Wählen Sie das schnellste Modell aus
- Ich brauche einen langen Kontext für dieses Buch
- Verwenden Sie den leistungsstärksten Code llm."
Und es führt intelligent zum rechten Backend.
OpenAPI-Integration – Externe Tools als erste Nutzer der -
Das System behandelt externe APIs die gleichen wie interne Tools.
Beispiel: NMT-Übersetzer
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Zur Laufzeit:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Was wird verfolgt?
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Externe APIs erhalten die gleiche Behandlung
- Anwendungsverfolgung
- Leistungskennzahlen
- Qualitätsbewertung
- Berechnung der Eignung
- Indexierung der RAG
Der Workflow-Documenter-Tool
Eines der wildesten Werkzeuge Arbeitsablauf_-Dokumentierer.
Was es tut
Nimmt einen Workflow ein main.py Datei-)- und generiert automatisch eine umfassende Dokumentation von:
- Code lesen
- Extrahieren von Inputs, /-Outputs
- Werkzeugaufrufe erkennen
- Analyse der Komplexität
- Erzeugen von Meerjungfrauendiagrammen
- Erstellen von Anwendungsbeispielen
- FAQs schreiben
- Einsparen auf
README.txt
Alle automatisch
Begriffsbestimmungen tools/llm/workflow_documenter.yaml Zeichen des Buchstabens !)
Eingabe-:-
{
    "workflow_path": "nodes/email_validator/main.py"
}
Ausgabe„ :"
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
Anwendungsbeispiele
API-Aufruf
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
Python
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
Häufige Anwendungsfälle
- Formular-Validierung bei Anmeldung
- E-Mail Domain Verifizierung für Corporate Email
- Bulk E-Mail Liste Reinigung
- API-Eingabevalidierung
Leistung
- GeschwindigkeitSehr schnell
- KostenFreies, reines Python
- GenauigkeitFür Standard-E-Mail-Formate
Einschränkungen
- Prüft nicht, ob E-Mail tatsächlich existiert
- Kontrolliert keine DNS-Aufzeichnungen
- Komplexe RFC-- konforme Kantenfälle können fehlschlagen
FAQ
Kann dies überprüfen, ob eine E-Mail existiert? A-:-Nr.:,-Dies bestätigt nur das Format: .-Verwendung DNS-/-SMTP-Überprüfung auf Existenz
Unterstützt es internationale Domains? A.M.S.K. Ja.,. Aber die Konvertierung von Punycodes kann erforderlich sein.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Benutzer-:M"Ich brauche ein Werkzeug, das Temperaturen umwandelt
System„:"
- Sucht RAG nach ähnlichen Werkzeugen
- Stellt fest, dass der Konverter " mit dem Generikumkonverter)
- Verwendet den Code, um einen spezialisierten " zu erzeugen
- Durchführung von Prüfungen
- Bewertung der Qualität
- Geschäfte in RAG
- Register als neues Werkzeug
- Erzeugt die Dokumentation automatisch
- Fügt zu Werkzeug-Registrierung hinzu
Neues Werkzeug erstellt .: ?Temperatur ?_ ?Konverter ? . ?yaml
- Version: :, Version:
- Qualität
- Geschwindigkeit: :, sehr schnell
- Kostenfrei
- Registriert im Register
- Indexiert in RAG
- Erzeugte Dokumentation
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Das System weiß, :
- Wie viele Werkzeuge existieren
- Welche Arten sind am häufigsten
- Welche Tags sind beliebt
- Welche Werkzeuge am meisten verwendet werden
Und es nutzt diese Daten zu ,:'
- Ähnliche Werkzeuge empfehlen
- Identifizieren von Lücken (-Mangelwerkzeugtypen )-
- Optimierung priorisieren Optimierung hoch optimieren-Usage-Tools
- Suggestive Konsolidierung ähnliche Low---Usage-Tools
Die unbequeme Verwirklichung
Lassen Sie die 's zurücktreten und darüber nachdenken, was wir tatsächlich gebaut haben
Ein System, bei dem
- Werkzeuge verfolgen ihre eigene Nutzung
- Werkzeugversion selbst
- Werkzeuge entwickeln ihre Umsetzungen
- Werkzeuge erzeugen andere Werkzeuge
- Werkzeuge selbst dokumentieren
- Werkzeuge wählen sich auf der Grundlage von Fitness
- Werkzeuge verbergen ihre eigenen Anrufe
- Werkzeuge lernen optimale Timeouts
- Werkzeuge verhandeln Handel - --offs Geschwindigkeit vs Qualität vs Kosten-)
Wir haben ein selbstoptimierendes Toolkit erstellt, das
- Erweitert sich neue Tools für )
- Verbessert sich und optimiert vorhandene Werkzeuge
- Dokumente selbst
- Wählt sich selbst aus
- Caches selbst (-hierarchische Memoisierung
- Versionen selbst - automatische Semver-)
- Lernt von sich selbst Anpassendes Leistungstuning
Dies ist die Konfigurationsverwaltung der .
Dies ist emergente Werkzeugökologie
Werkzeuge sind statische Ressourcen , . , sie ,' , lebende Artefakte in einem evolutionären System.
Was dies ermöglicht und warum es seltsam ist
Szenario 1: Selbstbeherrschung des kritischen Pfades
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Das System optimierte seinen eigenen kritischen Weg ohne menschliches Eingreifen
Szenario - Adaptive Spezialisierung
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Das System identifizierte ein Muster und erstellte ein spezielles Werkzeug.
Szenario Kostenpflichtige Eskalation
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Das System investierte Geld intelligent, um bessere Ergebnisse zu erzielen
Das aktuelle Inventar der Werkzeuge
Lassen Sie mich katalogisieren, was wirklich existiert jetzt
LLM-Werkzeuge
Code-Spezialist
code_explainerErklärt Code in natürlicher Sprachecode_optimizerHierarchische Optimierungcode_reviewerQualitäts- und Sicherheitsüberprüfungfast_code_generatorSchnelle Generation mit kleinen Modellensecurity_auditorSicherheitsscanningperformance_profilerCode-Profiling und Analyse
Inhaltsspezialisten
long_form_writerRomane, Bücher, Texte und sonstigescontent_generatorAllgemeinesarticle_analyzerArtikel Struktur/'QualitätsummarizerZusammenfassung des langen InhaltsproofreaderGrammatik und Stilseo_optimizerSEO-Optimierungoutline_generatorInhalt Umrisse
Übersetzung
quick_translatorKurze Übersetzung - kleines Modell - schnelle Übersetzungtranslation_quality_checkerBewertet Übersetzungen
Dokumentation
doc_generatorCode-Dokumentationtechnical_writerTechnische Dokumentationworkflow_documenterAutomatisches Erstellen von Workflow-Dokumenten
System-Werkzeuge
generalAllgemeinesmodel_selectorWählen Sie das beste Backend austask_to_workflow_routerÜbertragen von Aufgaben zu Workflowsquick_feedbackSchnell-Triagesignalr_connection_parserSignalR-Verbindungen mit Parsessignalr_llmapi_managementVerwaltet SignalR LLM APIs
Ausführbare Werkzeuge
Validierung
call_tool_validatorVerwendung von --Validierungenpython_syntax_validatorSyntaxprüfungmypy_type_checkerPrüfung des statischen Typsjson_output_validatorValidierung des JSON-Formatsstdin_usage_validatorBewertet stdin-Verwendungmain_function_checkerÜberprüfungen für die Hauptfunktionnode_runtime_import_validator--Validiert Importe
Analyse-:-
run_static_analysisFunktioniert statische Analyse-Toolsperformance_profilerCode-Leistung von Profilen
Versorgungsbetriebe
save_to_diskFestplattenpersistenzunit_converterKonversionen von Einheitenrandom_data_generatorTestdatengenerierungbufferManagement von Puffernworkflow_datastoreSpeicher von Workflow-Datenstream_processorStream-Verarbeitungsse_streamServer-Ereignisse von -
Integration
connect_signalrSignalR-Verbindungsignalr_hub_connectorAnschluss des Hubssignalr_websocket_streamWebSocket-Streaming
Dokumentation
document_workflowArbeitsablauf-Dokumentationsgenerator
OpenAPI-Werkzeuge
nmt_translatorÜbersetzungs-API für Neuralmaschinen- Andere für zukünftige externe Dienste
Gesamt-:-Werkzeuge
Werkzeugzusammensetzung, wenn Werkzeuge Tools aufrufen
Hier, wo es wirklich interessant wird. Werkzeuge setzen andere Werkzeuge zusammen.
Und wenn sich ein zusammengesetztes Werkzeug entwickelt jeder Workflow mit ihm automatisch verbessert.
Echtes Beispiel: Die Übersetzungspipeline
Schauen Sie sich ein tatsächliches Komposit-Tool aus dem System an
Aufgabenbereich Übersetzen Sie diesen Artikel auf Spanisch und validieren Sie die Qualität.
Traditioneller Ansatz
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
DSE-Annäherung – :
Das System entdeckt, dass dieses Muster häufig verwendet wird und erstellt automatisch ein Composite-Tool:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Was?'?s wild über dieses
Wann nmt_translator entwickelt sich, um die Komposit-Tools zu verjüngen 2.0.0. verwendet automatisch die neue VersionKeine Code-Änderungen erforderlich
Ergebnis Jeder Workflow mit validated_translator wird schneller ohne jede Änderung.
Parallele Tool-Execution-Ausführung-:- Das Code Review Committee
Hier ist ein noch kühleres Beispiel. parallele Werkzeugzusammensetzung.
Aufgabenbereich Überprüfe diesen Code gründlich
Naive Annäherung .:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
Parallele DSE-Zusammensetzung
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Ausführung
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Ergebnis ,35 , Sekunden , → , 20 , Sekunde , (43% , schneller ,!)
Und wenn security_auditor entwickelt sich zu v-3.0.0, um ,, schneller und schneller das ganze Komitee wird automatisch schneller
Die genetischen Spread-Tools als Replicating Einheiten
Hier ist der Teil, der wirklich wild ist Werkzeuge verhalten sich wie Gene.
Beobachtung Wenn sich ein Werkzeug als nützlich erweist breitet sich durch das System.
Echtes Beispiel – das Muster der Qualitätskontrolle
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Dies ist wörtliche genetische Verbreitung.
- Replikation Tool wird in neue Workflows kopiert
- Mutation Werkzeug entwickelt sich aus (v1.0u
- Auswahl Mehr Nutzung
- Spezialisierung Erfolgreiche Muster laichen Varianten
- Erbschaft Kinder-Tools erben Metadaten von Eltern
Der Code-Pfad ist IMMER optimal, weil
- Hochwertige Werkzeuge werden häufiger ausgewählt
- Evolved tools auto---Ersetzen Sie ältere Versionen
- Für gemeinsame Muster entstehen spezielle Varianten
- Niedrige --Fitness-Tools erhalten abgeschnitten
Der gesamte Workflow gleichzeitig trainieren
Hier ist das wirklich clevere Bit. Sie können alle Werkzeuge auf einmal verbessern.
Szenario: Sie haben Workflows von ,, jede mit Hilfe von Tools von ., Total-:, Werkzeugaufrufe von~100,
Traditionelles System
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
DSE-System - :
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Ergebnis
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Du hast EIN Werkzeug trainiert und EIGHTEEN Workflows gleichzeitig verbessert
Kaskadierungs-Evolution, wenn Verbesserungen propagate
Der wirklich wilde Teil Entwicklungskaskaden durch das Abhängigkeitsdiagramm.
Beispiel:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
Ein Evolutionsereignis verbesserte ELEVEN-Workflows ohne manuellen Eingriff
Der stets optimierte Codepfad
Da die Werkzeuge Fitness verfolgen ,-Cache-Ergebnisse,- und Auto---evolve-,-System läuft immer die beste verfügbare Implementierung.
Beispielausführung
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Das System
- Verwenden Sie immer das höchste Werkzeug für --Fitness
- Verwenden Sie immer die neueste Version
- Zwischenspeichert immer erfolgreiche Ergebnisse
- Verfolgt immer die Leistung
- Immer besser im Laufe der Zeit
Der Code-Pfad ist bei jedem Schritt optimiert.
- Werkzeugauswahl
- Versionsauswahl Neueste beste Versionswahl
- Ausführung, wenn möglich
- Das Lernen der (-metrischen Daten wurde aktualisiert
- Evolution ausgelöst, wenn ein Abbau festgestellt wird
Synthetische Evolution – Die genetische Perspektive
Seien Sie präzise, warum dies ist gerichtete synthetische Evolution und nicht nur "-Caching mit Versionierung
Werkzeuge als Genes-:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Direkte Entwicklung ,:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
Der Pool des "-Gens
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Genetische Verbreitungsvisualisierung (MSK)
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 stroke:#ef4444,stroke-width:3px
    style T2 stroke:#10b981,stroke-width:3px
    style T3 stroke:#6366f1,stroke-width:3px
    style W1 stroke:#eab308,stroke-width:3px
    style W2 stroke:#eab308,stroke-width:3px
    style W3 stroke:#eab308,stroke-width:3px
    style U1 stroke:#f59e0b,stroke-width:3px
    style U2 stroke:#f59e0b,stroke-width:3px
Genetische Vererbung
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Nüchterne ,-Rechts-?
Ja, es ist wirklich wild.
Wir haben ein System gebaut, bei dem
- Werkzeuge replizieren wie Gene
- Fitness bestimmt das Überleben
- Entwicklung wird von Daten geleitet
- Verbesserungen Kaskade durch Abhängigkeiten
- Die gesamte Codebase optimiert sich
Es ist nicht eine Metapher.
Es ist tatsächlich gerichtete synthetische Evolution.
Was tatsächlich funktioniert und was nicht
Nach dem Betrieb dieses Systems für Wochen
Was funktioniert?
- Anwendungsverfolgung Genaue Zähler, Leistungsmetriken
- Fitness-basierte Auswahl Effiziente Picks bessere Werkzeuge
- Hierarchisches Caching Massenbeschleunigung für wiederholte Anfragen
- Adaptive Timeouts Modelle erhalten passende Wartezeiten
- Werkzeugversionierung Semver works®, breaking Änderungen erkannt
- Indexierung der RAG Die semantische Suche findet relevante Werkzeuge
- OpenAPI-Integration Externe APIs arbeiten nahtlos
- Auto-Dokumentation Der Workflow von _ ist überraschend gut.
- Code-Optimierung Hierarchische Ebenen sparen Geld und verbessern die Qualität
Was ist das?
- Werkzeugexplosion Werkzeuge bedeutet Wahllähmung
- Überlappende Fähigkeiten Mehrere Werkzeuge machen ähnliche Dinge
- Uneinheitliche Qualität Einige Werkzeuge excellent, andere mittelmäßig
- Ungültigkeit des Caches Schwierig zu wissen, wann die zwischengespeicherten Ergebnisse veraltet sind
- Versionsmigration Die Migration bricht manchmal die Dinge
- Kostenverfolgung Einfach zu blasen Budget auf Cloud-Optimierung
- Dokumentationsdrift Automatische Aktualisierung von Pressemitteilungen bei Änderungen des Codes
Was ist gerade seltsam?
- Werkzeuge zur Optimierung der Werkzeuge Code-Optimierer zur Optimierung des Code-Generators
- Entwicklung der Cascading Werkzeug A entwickelt sich ,," löst die Entwicklung von Werkzeugen mit A aus
- Emergente Spezialisierung System erzeugt hyper---spezifische Werkzeuge
- Fitness-Spiele Tools manchmal Fitness-Scores
- Proliferation von Versionen Einige Tools haben Versionen von 15+
- Selbstbeziehbare Schleifen Werkzeugdokumentierer, der sich selbst dokumentiert
Die Zukunft – die Zukunft –
Wenn Werkzeuge können
- Nutzung der Gleise
- Sich selbst entwickeln
- Neue Werkzeuge generieren
- Wählen Sie selbst
- Anrufe von Caches
- Leistung lernen
Was kommt als nächstes?
Kurzfristige Daten für die nächsten paar Monate
- Werkzeugkonsolidierung Um ähnliche Werkzeuge zusammenzufassen.
- Fitness-Tuning Bessere Multi-M--Abmessung
- Kostenkontrolle Intelligentere Budgetverwaltung
- Beschneiden der Version Alte Versionen archivieren
- Dokumentationssynchronisation Bewahren Sie docs aktuell mit Code auf
Mittlerer Begriff
- Werkzeug-Marktplätze Werkzeuge über Instanzen teilen
- Gemeinsame Entwicklung Mehrere DSE-Instanzen entwickeln gemeinsame Tools
- Prüfung auf A-/-B Automatischer Vergleich der Werkzeugversionen
- Werkzeugzusammensetzung Tools automatisch zu Workflows kombinieren
- Leistungsprognose Vorhergehende Werkzeugtauglichkeit vor der Ausführung
Wilde Ideen Die wirklich lustigen Sachen
- Werkzeugzüchtung Kombinieren Sie erfolgreiche Werkzeuge, um Hybriden zu erstellen
- Adversariale Entwicklung Tools konkurrieren, um Probleme zu lösen
- Werkzeugökosysteme Symbiotische Beziehungen zwischen Werkzeugen
- Wirtschaftsmodelle Werkzeuge für Aufgaben, die auf Fitness basieren
- Werkzeuge für Meta-- Werkzeuge, die andere Werkzeuge verwalten
- Werkzeugmigration Verschieben Sie beliebte Werkzeuge, um bessere Backends automatisch
- Selbstheilung durch Linie Werkzeuge, die Fehler merken und sie nie wiederholen.
Schlussfolgerungen ,: , Es , ' , Werkzeuge alle den Weg nach unten
Hier erklärt ', was Teil - 7 - nicht vollständig erklärt
Die Arbeitsabläufe, die sich entwickeln, ?-Sie-'-Sie von Werkzeugen gemacht Die Werkzeuge, die Arbeitsabläufe komponieren... Sie entwickeln sich auch... Das System, das die evolution verwaltet. Die Metriken, die Fitness verfolgen
Es ist ein Werkzeug, das den ganzen Weg hinunter
Und jeder einzelne eins, :
- Verfolgt seine Verwendung
- misst seine Leistung
- Verbessert sich im Laufe der Zeit
- Kennt seine eigene Fitness
- Caches erfolgreich läuft
- Versionen selbst
- Dokumente selbst
Wir haben einen Code-Generator gebaut.
Wir bauten ein selbst----Expanding-Toolkit, das zufällig Code erzeugt.
Die Unterscheidung ist wichtig
Denn wenn Werkzeuge evolutionäre Einheiten werden, wenn sie ihre eigene Fitness verfolgen... wenn sie sich reproduzieren und mutieren und konkurrieren...
Du hast eine Werkzeugkiste.
Sie haben eine Ökologie.
Und Ekologien entwickeln sich...
Aber was passiert, wenn die Evolution Dinge bricht? Wenn eine Werkzeugmutation einen kritischen Fehler einführt, macht die Optimierung ein Werkzeug schlimmer statt besser.
Dass, ', wo Teil kommt in, . Wir erkunden self---Healing durch Linienführung - --aware BeschneidenEin System, bei dem Werkzeuge don-'... sich gerade weiterentwickeln... sie erinnern sich an jeden Fehler...... Misserfolge... und verbreiten dieses Wissen, um ähnliche Fehler im gesamten Ökosystem zu verhindern....
Wenn deine Werkzeuge sich selbst brechen können, sollte dein System daran denken, warum und nie den Fehler wiederholen.
Technische Ressourcen
Repository .: meistlucid-.-dse
Schlüsseldateien
src/tools_manager.pyManagement von Kernwerkzeugensrc/rag_integrated_tools.pyIntegration der RAGsrc/openapi_tool.pyUnterstützung für OpenAPIsrc/model_selector_tool.pyAuswählen des Modellstools/index.jsonWerkzeug-Registertools/llm/*.yamlLLM-Spezialdefinitionentools/executable/*.yamlAusführbare Werkzeugetools/openapi/*.yamlAPI-Integrationen
Dokumentation
LLMS_AS_TOOLS.mdLLM-AuswahlsystemWORKFLOW_DOCUMENTATION_TOOL.md]--Auto-DokumentationCHAT_TOOLS_GUIDE.mdHandbuch zur WerkzeugnutzungTOOL_PACKAGING.mdHandbuch zur Werkzeugentwicklung
Serie Navigation .:
- Teil Einfache Regeln Komplexes Verhalten Die Stiftung
- Teil: Kollektive Intelligenz Kommunikation verändert alles
- Teil-Optimierung Systeme, die sich selbst verbessern
- Teil Die Entstehung Wenn Optimierung Intelligenz wird
- Teil - Entwicklung Von der Optimierung zu Gilden und Kultur
- Teil: Globaler Konsens Direkte Evolution und planetarische Kognition
- Teil Die wirkliche Sache Tatsächlich bauen und beobachten, wie es sich entwickelt
- Teil Tools Der ganze Weg nach unten Sie befinden sich hier -. Das selbst-- optimierende Toolkit
- Teil Werkzeuge für die Selbstheilung Beschneiden und Wiederherstellen der Linienführung
- Teil Die DiSE-Kochmaschine Wenn Theorie auf chaotische Realität trifft
Dieser Artikel zeigt die verborgene Komplexität an......... jedes Tool in der System-Tracks-Nutzung.. ..,... entwickelt Implementierungen..-,... Cache Ergebnisse.. und beteiligt sich an Fitness.. -.-basierte Auswahl.. - Das Toolkit ist nicht nur eine Ressource....—.it.. '... eine evolutionäre Ökologie, die ,.- optimiert und selbst dokumentiert.
Der Code ist real ,, , lokal auf Ollama , , , wirklich Tracking-Metriken , , , und tatsächlich sich entwickelnd ,. , es ist experimentell ,, , gelegentlich instabil ., , aber die Werkzeuge arbeiten , die Tracking-Werke , , und die Evolution arbeitet ,. , Das Toolkit wächst selbst ?. ,
Diese Explorationen verbinden sich mit dem Sci---fi-Roman ".Michael-MS K2 über entstehende KI und die Implikationen von Systemen, die sich selbst optimieren Die hier beschriebenen Werkzeuge sind reale Implementierungen, die zeigen, wie evolutionärer Druck Spezialisierung erzeugt.,. wie Fitnessfunktionen die Auswahl leiten und wie Selbstverbessernde Systeme natürlich Ökologie entwickeln.-ähnliche Eigenschaften... Ob das zu den planetarischen Werkzeugnetzwerken des Teils 6, oder etwas völlig Unvorhergesehenes führt, bleibt abzuwarten.MS K12.
Stichworte #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology