
Bauen meistlucid-nmt: Ein produktionsfertiger (EasyNMT-kompatibler) Übersetzungsdienst


Einleitung
Eine FastAPI-Implementierung Kopieren Sie die API von EasyNMT (https://github.com/UKPLab/EasyNMT) ein ausgezeichnetes, aber aufgegebenes Neuralmaschinen-Übersetzungsprojekt.
Aber ich habe SO VIELE schöne Funktionen hinzugefügt, um die Zuverlässigkeit zu erhöhen und es für den Einsatz in einem Produktionssystem bereit zu machen.Denken Sie schnell Übersetzung selbst gehostet...).
Seit dem Start dieses Blogs, eine große Leidenschaft hat sich Auto-Übersetzung Blog-Artikel.
JA Ich weiß, dass 'google does this' in Browsern etc...etc...aber das ist nicht der Punkt.mostlylucid-nmtIch wollte wissen, wie es geht!
Außerdem ist es schön, bei Menschen, die kein Englisch lesen, willkommen zu sein (auch wenn sie Englisch als zweite Sprache lesen, ist es FAR schwieriger zu parsen).So arbeitete ich aus, wie es zu tun; sowie gemeinsam, wie man diese Art von System zu bauen.Oh und es gab mir Ideen, wie man es in ASP.NET für die automatische Lokalisierung von Text (einschließlich dynamischem Text) mit SignalR & einem glatten Echtzeit-Update-System verwendet. (
Bleib dranIm Wesentlichen; Menschen schreiben Mist Text, der SUPER laut für Maschinen, um effizient zu handhaben ist.
So wurde viel herauszufinden, wie man Probleme mit EasyNMT bearbeitet (es war wirklich immer ein Forschungsprojekt).


Das lässt sowohl mich während der Entwicklung als auch Sie einen Weg, um ein Spiel zu haben.
I. ENTWICKLUNG DER RECHTSVORSCHRIFTENschrieb ein ganzes Systemhttp://<server>:<port>/demodas mit einem erstaunlichen Projekt namens EasyNMT geschehen zu lassen.
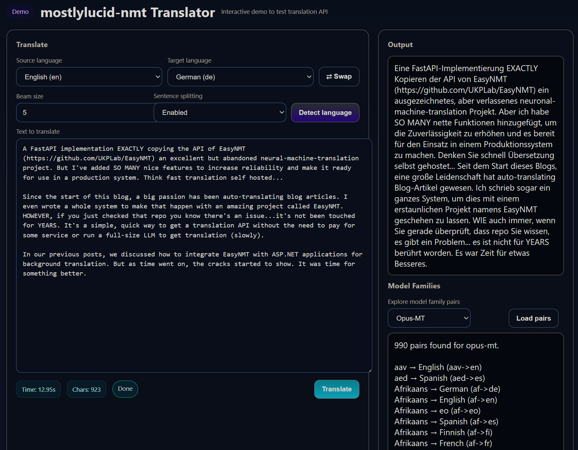
Wie auch immer, wenn Sie gerade überprüft, dass Repo Sie wissen, es gibt ein Problem... es wurde nicht für Jahre berührt.
Es ist ein einfacher, schneller Weg, um eine Übersetzung API ohne die Notwendigkeit, für einen Service zu zahlen oder führen Sie eine Full-Size-LLM, um Übersetzung zu erhalten (langsam).
In unseren früheren Beiträgen diskutierten wir, wie EasyNMT mit ASP.NET-Anwendungen für Hintergrundübersetzungen integriert werden kann.
**Aber mit der Zeit begannen sich die Risse zu zeigen.**Es war Zeit für etwas Besseres.
**Wie üblich ist es alles auf GitHub und alle frei für den Einsatz etc...**Docker zieht
- ✓ cpu:
Reusing loaded model for en->de (3/10 models in cache) - ✗ cpu-min:
Need to load model for en->fr (3/10 models in cache) - gpugpu-min
- **Demo...siehe später für die Demo-Seite!**Eine vollständige (meist) interaktive Demo-Seite
- (beioder einfach nur die Wurzel)
- **Was ist neu?**Bevor wir in den schnellen Start eintauchen, hier ist, was diese Version Spiel-verändernd macht:
Wichtige Updates (v3.1) - Intelligenz & SichtbarkeitNeu in v3.1:
- **Die neueste Version bringt massive Verbesserungen an Zuverlässigkeit, Performance Sichtbarkeit und intelligente Modellauswahl!**1.
- Smart Model Caching mit Sicht- Sehen Sie genau, was passiert:
- Cache HIT ProtokollierungCache MISS Protokollierung
- Nachverfolgung des Cache-Status: Zeigt den Auslastungsprozentsatz und die geladenen Modelle an
- Räumungswarnungen: Klare Warnungen, wenn der Cache voll ist und Modelle vertrieben werden
- Erhöhte Kapazität:
====================================================================================================
  🚀 DOWNLOADING MODEL
  Model: facebook/mbart-large-50-many-to-many-mmt
  Family: mbart50
  Direction: en → bn
  Device: GPU (cuda:0)
  Total Size: 2.46 GB
  Files: 6 main files
====================================================================================================
[Progress bars for each file...]
====================================================================================================
  ✅ MODEL READY
  Model: facebook/mbart-large-50-many-to-many-mmt
  Translation: en → bn is now available
====================================================================================================
**: Standard-Cache-Größe auf 10 Modelle gesprungen (von 6)**Pro-Modell-Geräteprotokollierung
- : Sehen Sie genau, welche GPU/CPU jedes Modell verwendet2. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Verbesserte Download-Fortschritte- Ich frage mich nicht mehr, ob er feststeckt:
- Größe vor dem Download:
[Pivot] Languages reachable from en: 85 languages [Pivot] Languages that can reach bn: 42 languages [Pivot] Found 38 possible pivot languages [Pivot] Selected pivot: en → hi → bn (both legs verified) - **: Zeigt Gesamt-Download-Größe (z.B. "Gesamtgröße: 2,46 GB")**Dateianzahl
- : Zeigt die Anzahl der Dateien zum Herunterladen anAnzeige des Gerätes
: Zeigt Zielgerät (GPU/CPU) in BannerFortschrittsbalken
- **: Schöner tqdm Fortschritt für jede Datei (wenn auf TTY)**Abschluss-Banner
- : Klare Erfolgsbotschaft, wenn Modell bereit istBeispielausgabe
- 3. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).:
Request: en→bn with opus-mt
Trying families: ['opus-mt', 'mbart50', 'm2m100']  ✓ All three!
opus-mt: Failed (model doesn't exist)
mbart50: Success! (auto-fallback worked)
Datengesteuerte intelligente Pivot-Auswahl- Keine blinden Versuche mehr:
- Intelligente Kreuzungslogik
Loading mbart50 model on GPU (cuda:0) - : Findet Sprachen, in denen beide Drehbeine existieren
Model loaded on device: cuda:0 - Vermeidet fehlgeschlagene Versuche
Successfully loaded... on GPU (cuda:0)
: Wird nicht versuchen, en→es→bn, wenn es es nicht gibtBeispiel für en→bn
- Rückfallpriorität
en->hi,hi->bn - : Englisch → Spanisch → Französisch → Deutsch → Chinesisch → Russisch
- Transparente Protokollierung
[Pivot] Both legs loaded and cached. Ready to translate.
: Sehen Sie genau, warum jeder Pivot gewählt oder übersprungen wurde4. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Automatischer Rückfall behoben
-
- Keine Doppeltrys mehr:
model_familyVersucht immer Fallbacks
- Keine Doppeltrys mehr:
- : Auch wenn die bevorzugte Familie "sollte" das Paar unterstützen
Einzelversuch pro Familie
: Keine Wiederholung des gleichen Modells mehrBeispieldurchfluss
-
- Verordnung (EWG) Nr. 1408/71 des Rates vom 14. Juni 1971 zur Anwendung der Systeme der sozialen Sicherheit auf Arbeitnehmer und Selbständige (ABl.
- GPU-Klärung
-
- Immer wissen, wo Ihre Modelle sind:
- Jede Modelllast zeigt:
- Nach der Belastung bestätigt:
**Die Erfolgsmeldung beinhaltet:**6. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Pivot Modell-Caching- Effiziente Pivot-Wiederverwendung:
- **Beide Beine des Pivots getrennt zwischengespeichert:**Nächstes Mal en→hi oder hi→bn benötigt, Instant Cache Hit!
- **Protokollierung löschen:**7. . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
- Pro-Request-Modellauswahl
**- Funktioniert bereits im Demo:**Demo Dropdown ermöglicht die Auswahl von opus-mt, mbart50 oder m2m100
- Respekt vor dem Backend
- Parameter pro Anfrage
- Modelle separat zwischengespeichert nach Familie für sofortiges Umschalten
- Wichtige Aktualisierungen (v3.0)
- 1.
requirements-prod.txtVerbesserte Demo-Seite
**- Produktionsbereite interaktive Schnittstelle:**Vollständiges Viewport-Layout (100vw/100vh) für immersive Übersetzungserfahrung
- **Richtige Themenauswahl Dropdowns auswählen (keine klobigen Eingaben/Datenlisten mehr)**Umschaltung der Lebendmodellfamilie (Opus-MT, mBART50, M2M100)
- Dynamisches Laden der Sprache basierend auf dem ausgewählten ModellScrollbare Ausgabebereiche für große Übersetzungen
- **2. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).**Leistungsoptimierte Voreinstellungen
-
- "Schnell wie möglich" aus dem Kasten heraus:
- GPU
**FP16 aktiviert, BATCH_SIZE=64, MAX_INFLIGHT=1 (optimal für einzelne GPU)**CPU
- : WEB_CONCURRENCY=4, MAX_INFLIGHT=4, CHATCH_SIZE=16 (alle Kerne nutzen)
- Schnelles Herunterfahren
- : 5-Sekunden anmutiger Timeout (keine 20-Sekunden-Hänge mehr)
- Container stoppen sauber ohne beängstigende SIGKILL-Nachrichten
-
- Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Optimierung des Produktionsaufbaus
**- Kleinere, schnellere Bilder:**Herausgenommene Testabhängigkeiten (Pytest, Pytest-cov) aus der Produktion
- Speichert ~200MB pro BildCPU-Bilder: ~8-10GB (voll), ~3-4GB (min)
- **GPU-Bilder: ~12-15GB (voll), ~6-8GB (min)**Alle Verwendungen
- für minimalen Fußabdruck4. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
Umfassende Prüfung & Lastprüfung- Alles bestätigen:
- Live-API-Test-Suite
- (30+ Tests) für Gesundheit, Übersetzung, Erkennung, Entdeckung
- k6 Lastprüfung
mit realistischen Verkehrsmusternplattformübergreifende Validierungsskripte
/discover/opus-mt(PowerShell + Bash)/discover/mbart50Tests für Modell-Downloads und Pivot-Übersetzungen/discover/m2m100Automatisierte Rauchtests zur schnellen Validierung
**5. Verordnung (EWG) Nr. 1408/71 des Rates vom 14. Juni 1971 zur Anwendung der Systeme der sozialen Sicherheit auf Arbeitnehmer und Selbständige (ABl.**Dokumentation über den Einsatz
-
- Produktionsfertig ab dem ersten Tag:
- 4 Tuning-Szenarien: Max-Durchsatz, Low Latency, High Concurrency, Memory-Contrained
- Docker Komponieren Sie Beispiele mit GPU/CPU-Konfigurationen
Kubernetes manifestiert sich mit PVC, Ressourcengrenzen, GesundheitskontrollenBeispiele für Azure Container Instanzen
scottgal/mostlylucid-nmt:cpuLeitlinien für die Belastungsprüfung und Empfehlungen für die Überwachung:latestConcurrency vs. Durchsatz-Trade-offs erklärtscottgal/mostlylucid-nmt:cpu-min6. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).scottgal/mostlylucid-nmt:gpuDrei Modellfamilienscottgal/mostlylucid-nmt:gpu-min- Wählen Sie das Beste für Ihre Bedürfnisse:
Opus-MT: 1200+ Paare, beste Qualität (getrennte Modelle)
- INSGESAMT50
latest,min,gpu,gpu-min: 50 Sprachen, Einzelmodell 2.4GB, 2.450 Paare - M2M100
20250108.143022: 100 Sprachen, Einzelmodell 2.2GB, 9.900 Paare -
- . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
Auto-Fallback- Intelligent wählt das beste verfügbare Modell aus:
- **Primärfamilie einstellen (z.B. Opus-MT für Qualität)**Versucht mBART50/M2M100 automatisch, wenn ein Paar nicht verfügbar ist
- Maximale Abdeckung ohne Qualitätseinbußen8. (Das Parlament nimmt den Entwurf der legislativen Entschließung an.)
- Entdeckung des Modells- Dynamisch verfügbare Modelle abfragen:
-
- Alle 1200+ Paare von Hugging Face
- Alle mBART50 Paare- Alle M2M100 Paare
-
- Verordnung (EWG) Nr. 1408/71 des Rates vom 14. Juni 1971 zur Anwendung der Systeme der sozialen Sicherheit auf Arbeitnehmer und Selbständige sowie zur Aufhebung der Verordnung (EWG) Nr. 574/72 des Rates (ABl.
- Minimale Bilder
- Kleinere, flexible Einsatzmöglichkeiten:
Keine vorinstallierten Modelle (Download on-demand)
Volume-mapped persistenter Cache
Modellfamilien ohne Umbau umschalten**10. (Das Parlament nimmt den Entwurf der legislativen Entschließung an.)**Einzel-Docker-Repository
- Alle Varianten an einem Ort:
|-----|-----------------|------|-------------|----------|
|
cpu(oderlatest) |scottgal/mostlylucid-nmt:cpu) - CPU |cpu-min|scottgal/mostlylucid-nmt:cpu-min- CPU minimal |gpu|scottgal/mostlylucid-nmt:gpu- GPU mit CUDA 12.6 |gpu-min|scottgal/mostlylucid-nmt:gpu-min- GPU minimal
**11. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).**Richtige Versionierung
-
- Alle Bilder enthalten Datumsversionierung:
- Benannte Tags (
- ) weisen immer auf den neuesten Bau
- Immutierbare Versions-Tags (z.B.,
) für das Pinnen spezifischer Builds
Volle OCI-Etiketten für Tracking-Versionen, Build-Dates und Git Commits
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  scottgal/mostlylucid-nmt
12. Sitzungsdok: A2-0028/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88 Aussprache: ¡2/04/88
curl -X POST "http://localhost:8000/translate" \
  -H "Content-Type: application/json" \
  -d '{
    "text": ["Hello, how are you?"],
    "target_lang": "de"
  }'
Neueste Basisbilder
{
  "translated": ["Hallo, wie geht es Ihnen?"],
  "target_lang": "de",
  "source_lang": "en",
  "translation_time": 0.34
}
- Sicherheits- und Leistungsverbesserungen:
Python 3.12-slim
docker run -d \
  --name mostlylucid-nmt \
  --gpus all \
  -p 8000:8000 \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu
für CPU-Images (Adressen Python 3.11 Schwachstellen)
CUDA 12.6
mit Ubuntu 24.04 für GPU-Bilder (letzter NVIDIA-Stack)
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  -v $HOME/model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  scottgal/mostlylucid-nmt:cpu-min
PyTorch mit CUDA 12,4
docker run -d `
  --name mostlylucid-nmt `
  -p 8000:8000 `
  -v ${HOME}/model-cache:/models `
  -e MODEL_CACHE_DIR=/models `
  scottgal/mostlylucid-nmt:cpu-min
(kompatibel mit CUDA 12.6 Laufzeit)
docker run -d ^
  --name mostlylucid-nmt ^
  -p 8000:8000 ^
  -v %USERPROFILE%/model-cache:/models ^
  -e MODEL_CACHE_DIR=/models ^
  scottgal/mostlylucid-nmt:cpu-min
Alle Abhängigkeiten auf neueste sichere Versionen aktualisiert
13. Sitzungsdok: A2-0028/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88 Aussprache: ¡2-022/88
curl http://localhost:8000/healthz
Feste Deprekationswarnungen
- Zukunftssicher:
Entfernt deprecated TRANSFORMERS_CACHE (jetzt mit HF_HOME)Kompatibel mit Transformatoren v5Schnellstart (5 Minuten)
http://localhost:8000/demo/
Hier ist der absolut einfachste Weg, um meistlucid-nmt laufen:
Verfügbare Docker Bilder
- Alle Varianten sind erhältlich ab
- ein Repository
- mit verschiedenen Tags:
Ganzer Bildname , Größe , Beschreibung , Fall verwenden ,
- (oder
- ~2.5GB-CPU mit Quellcode Produktion CPU-Bereitstellungen
- ~1.5GB-CPU minimal, keine vorinstallierten Modelle Volume-mapped Cache, flexibel
- ~5GB , GPU mit CUDA 12.6 + Quelle , Produktion GPU-Bereitstellungen ,
- ~4GB] GPU minimal, keine vorinstallierten Modelle GPU mit Volume-Mapped Cache
Minimale Bilder
- werden empfohlen für:
- Produktions-Bereitstellungen mit Volume-mapped cache
- Verwendung von mBART50 oder M2M100 (einzelne große Modelle)
Behältergröße klein halten
- Flexibilität, Modellfamilien ohne Umbau zu wechselnEinfachster Start (Opus-MT CPU)
-
- Ziehen und laufen:
-
- **2. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).**Übersetze einen Text:
- Antwort:
- GPU beschleunigt (10x schneller)
Erfordert NVIDIA Docker Laufzeit:
- Mit persistentem Modell-CacheLaden Sie Modelle einmal herunter und halten Sie sie über Container-Neustarts:
- **Linux/Mac:**Fenster (PowerShell):
- **Fenster (CMD):**Modelle laden sich automatisch bei der ersten Verwendung und bestehen in Ihrem lokalen Verzeichnis!
Gesundheitscheck:
- Das ist der 5-Minuten-Schnellstart!
- **Für den Einsatz in der Produktion, Konfiguration und erweiterte Funktionen, lesen Sie weiter.**Interaktive Demoseite
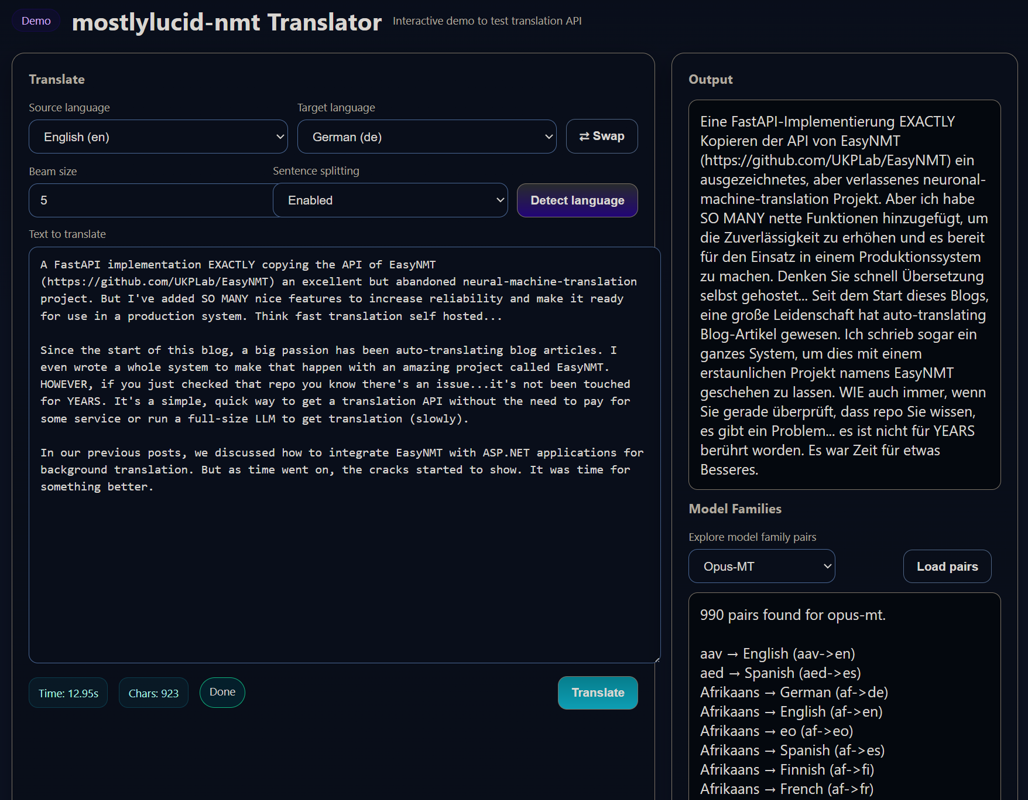
- Der Service beinhaltet eine voll ausgestatteteinteraktive Demo-Seite
- **Das macht es einfach, Übersetzungen zu testen, ohne einen Code zu schreiben.**Zugriff auf sie unter:
- Demo-Features
Die Demo-Seite bietet eine komplette Übersetzungs-Testumgebung mit:
// Example: Translating a 5000-word article
Input: Long article with multiple paragraphs

Step 1: Split by paragraphs (preserves structure)
  → Paragraph 1 (800 chars)
  → Paragraph 2 (1200 chars)
  → Paragraph 3 (600 chars)
  ...

Step 2: Group into ~1000 character chunks
  → Chunk 1: Paragraphs 1-2
  → Chunk 2: Paragraph 3-4
  → Chunk 3: Paragraphs 5-6

Step 3: Translate each chunk sequentially
  → Shows progress: "Translating chunk 1/3..."
  → Shows progress: "Translating chunk 2/3..."
  → Shows progress: "Translating chunk 3/3..."

Step 4: Reassemble with paragraph breaks
  → Final output: Complete translated article with preserved formatting
Sprachauswahl
Automatisch bevölkerte Sprachabbrecher aus dem Live-Service
- Quell-/Zielsprachen mit einem Klick tauschen
- Unterstützt alle 100+ Sprachen, die im Service konfiguriert sind
-
- Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Intelligente Text-Chunking
Handhabt automatisch große Texteingaben jeder Größe
- Intelligent geteilt durch Absätze, Erhaltung der Dokumentenstruktur
- Rückfall auf Satzspaltung für sehr lange Absätze
- Zeigt Fortschritt für Multi-Cunk-Übersetzungen ("Übersetzen von Stück 2/5...")
- Nahtlos reassembliert Stücke mit richtigen Abstand
3. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Spracherkennung
- Erkennen Sie die Quellsprache mit einem Klick
- Bevölkert automatisch Quellsprache Dropdown
- Funktioniert mit Text bis zu 5000 Zeichen
4. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
Erweiterte Optionen:
- Strahlgröße
- : Kontrolle der Übersetzungsqualität (1-10)
- Höhere Werte = bessere Qualität, aber langsamer
- Niedrigere Werte = schnellerer Durchsatz
Satzspaltung:
- : Automatische Satzspaltung umschalten
- Aktiviert (Standard): Splitt lange Texte in Sätze für bessere Qualität
- Deaktiviert: Übersetzt ganzen Text als einen Block (schneller für kurze Texte)
-
- Verordnung (EWG) Nr. 1408/71 des Rates vom 14. Juni 1971 zur Anwendung der Systeme der sozialen Sicherheit auf Arbeitnehmer und Selbständige (ABl.
Echtzeit-Statistik:
- Übersetzungszeit
- : Zeigt die tatsächliche serverseitige Übersetzungsdauer an
- Anzahl der Zeichen
- : Live-Zählung beim Tippen
Statusanzeiger
: Leerlauf → Übersetzen → Fertig/Fehler
- **6. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).**Modell Familie Entdeckung
- **Erkunden Sie verfügbare Übersetzungspaare für jede Modellfamilie:**Opus-MT
- : 1200+ SprachpaareINSGESAMT50
- : 50 Sprachen, 2.450 PaareM2M100
: 100 Sprachen, 9.900 Paare/demo/Sehen Sie genau, welche Sprachpaare vor dem Übersetzen verfügbar sind
Wie Text-Chunking funktioniert
Die Demo implementiert intelligente Text-Chunking auf der Client-Seite:Warum die Demo benutzen?Schnelle PrüfungTesten Sie Übersetzungen ohne SchreibcodeSprachpaar-Verfügbarkeit bestätigen
Vergleichen Übersetzungsqualität mit unterschiedlichen Strahlgrößen
- **Testrandfälle (Emoji, Symbole, Sonderzeichen)**Entwicklungshilfe
- Genaues API-Request/Response-Format anzeigenÜberprüfung der Gesundheitsversorgung vor der Integration
- Testleistung mit unterschiedlichen TextgrößenEntdecken Sie verfügbare Modellfamilien
- KundenreferenzZeigt korrekte API-Nutzungsmuster an
- **Zeigt Fehlerbehandlung (429, Spracherkennung)**Beispiel für die Chunking-Implementierung
- Logik der realen Welt wiederholenBeispiel VerwendungEinfache Übersetzung.
- **Text einfügen: "Hallo, wie geht es dir heute?"**Ziel auswählen: Deutsch
- **Klicken Sie auf "Übersetzen"**Ergebnis: "Hallo, wie geht es Ihnen heute?"
Langdokument-Übersetzung
Ganzen Blogbeitrag einfügen (5000+ Wörter)Demo spaltet es automatisch in überschaubare StückeZeigt Fortschritt, wie jeder Block übersetzt
Gibt vollständig übersetztes Dokument zurück
SpracherkennungText in unbekannte Sprache einfügenKlicken Sie auf "Sprache erkennen"
Demo identifiziert Sprache und Aktualisierungen Dropdown
- Bereit, sofort zu übersetzenTechnische Details
- **Die Demo-Seite ist:**In sich geschlossen
- : Einzel-HTML-Datei mit eingebettetem JavaScriptNull-Abhängigkeiten
- : Keine externen Bibliotheken erforderlichMobil freundlich
- : Responsive Design funktioniert auf allen GerätenProduktion fertig
- : Die gleiche Chunking-Logik kann in Ihren Apps verwendet werdenZugriff auf die Live-Demo bei
auf deine laufende Instanz!
- Die Probleme mit EasyNMTNun, das ist kein Dumping auf
- EasyNMTes tat soething nichts anderes könnte und ich habe gebaut
- eine große Anzahl von Projekten, die es nutzen
- **Es wird nur langsam lange im Zahn, also... welche Probleme haben wir?**Oh mein Gott, da sind viele.
- **EasyNMT wurde vor fast einem Jahrzehnt gebaut.**Die Technologie hat sich weiter entwickelt... und es war nie beabsichtigt, ein Produktionssystem zu sein.
- **Hier sind einige der Themen:**Es stürzt ab... ein Los.
Es ist nicht entwickelt, um von Problemen zu erholen, so oft nur fällt über.
- **Es ist SUPER PICKY über seine Eingabe.**Emoticons, Symbole, sogar Zahlen können es verwirren.
- **Es ist nicht für jede Ladung ausgelegt.**Siehe oben.
- **Es wurde nie entworfen, um zu sein.**Es wurde nicht entwickelt, um seine Modelle zu aktualisieren
- **oder (einfach) mit eingebauten Modellen gebaut werden.**Seine GPU CUDA Zeug ist alt
- **So langsamer, als es sein muss.**Du kannst nichts reparieren.
- Der Python-Code ist auf der Repo, aber wiedernicht groß
**Kein Gegendruck oder Warteschlange.**Senden Sie zu viele Anfragen und es kippt einfach um.MODEL_FAMILYKeine Beobachtbarkeit.
# Opus-MT (default, best quality)
MODEL_FAMILY=opus-mt

# mBART50 (50 languages, single model)
MODEL_FAMILY=mbart50

# M2M100 (100 languages, broadest coverage)
MODEL_FAMILY=m2m100
Wenn es schief geht, fliegen Sie blind.
Die Lösung: MeistensLucid-NMTAlso... habe ich beschlossen, eine neue und verbesserte EasyNMT zu bauen, jetztmeistlucid-nmt
- Dies ist nicht nur ein Patch-Job; es ist eine komplette Neuschreibung mit Produktionsnutzung im Hinterkopf.
MODEL_FAMILYHier ist, was es besser macht:opus-mtMulti-Model-Familienunterstützung - Meistens unterstütztLucid-NMT jetzt
- drei Übersetzungsmodellfamilien
- , so dass Sie Flexibilität nach Ihren Bedürfnissen:
Opus-MT (Helsinki-NLP) - Standard
# Set primary to Opus-MT (best quality)
MODEL_FAMILY=opus-mt
AUTO_MODEL_FALLBACK=1
MODEL_FALLBACK_ORDER=opus-mt,mbart50,m2m100

# Request Ukrainian → French
# 1. Try Opus-MT first (not available)
# 2. Automatically fall back to mBART50 (available!)
# 3. Translation succeeds with mBART50
Erfassungsbereich:
- 1200+ Übersetzungspaare für 150+ SprachenArchitektur:
- Getrenntes Modell pro ÜbersetzungsrichtungQualität:
- Beste GesamtübersetzungsqualitätAnwendungsfall:
- Produktionsübersetzungen, wenn es um Qualität gehtGröße des Modells:
300-500MB pro Richtung
# Enable auto-fallback (default: enabled)
AUTO_MODEL_FALLBACK=1

# Set fallback priority (default: opus-mt → mbart50 → m2m100)
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"

# Disable for strict single-family mode
AUTO_MODEL_FALLBACK=0
Beispiel:
Englisch→Deutsch ist ein anderes Modell als Deutsch→Englisch
- **mBART50 (Facebook)**Erfassungsbereich:
- 50 Sprachen, GesamtübersetzungArchitektur:
- Einheitliches mehrsprachiges ModellQualität:
- Gute Qualität, vor allem für die wichtigsten SprachenAnwendungsfall:
- Raumbeschränkte Bereitstellungen oder viele SprachpaareGröße des Modells:
- **~2.4GB (Einzelmodell für alle 50 Sprachen)**Vorteil:
- Ein Modell verarbeitet 2.450 ÜbersetzungspaareM2M100 (Facebook)
- **Erfassungsbereich:**100 Sprachen, Gesamtübersetzung
- **Architektur:**Einheitliches mehrsprachiges Modell
- **Qualität:**Gute Qualität mit breitester Sprachabdeckung
- **Anwendungsfall:**Maximale Sprachabdeckung
-minGröße des Modells:
~2.2GB (Einzelmodell für alle 100 Sprachen)
Vorteil:
Ein Modell verarbeitet 9.900 Übersetzungspaare
Schalten ist einfach
-
- stellen Sie einfach die
- Umgebungsvariable:
- Automatische Modellfamilie Fallback - NEU!
Eines der mächtigsten neuen Features ist
- automatischer Rückfall zwischen Modellfamilien
- Dies gewährleistet eine maximale Sprachpaarabdeckung bei gleichzeitiger Priorisierung der Übersetzungsqualität.
**Wie es funktioniert:**Sie setzen eine primäre
- **(z.B.**für beste Qualität)
- Wenn Sie ein Übersetzungspaar anfordern, das in der primären Familie nicht verfügbar istDas System versucht automatisch die nächste Familie in der Fallback-Ordnung
- **Dies geht so lange, bis ein geeignetes Modell gefunden wird.**Beispielszenario:
Vorteile:
Maximale Abdeckung:
Unterstützung von 100+ Sprachen ohne Verwaltung mehrerer Bereitstellungen
- Qualitätspriorität:
- Benutzt immer das beste verfügbare Modell für jedes Paar
- Null-Konfiguration:
- Funktioniert automatisch, kein manueller Eingriff erforderlich
Transparentes Protokollieren:
- Sehen Sie, welche Modellfamilie für jede Übersetzung verwendet wurde
- Konfiguration:
- Diese Funktion ist perfekt für Produktionsumgebungen, in denen Sie maximale Abdeckung ohne Qualitätseinbußen wünschen!
- Wesentliche Verbesserungen
Unterstützung von Familien mit mehreren Modellen
# NMT: Fits on a USB stick
du -sh model-cache/
2.5G    model-cache/

# LLM: Needs serious storage
du -sh llama-models/
140G    llama-models/
- Wählen Sie aus Opus-MT (1200+ Paare), mBART50 (50 Sprachen) oder M2M100 (100 Sprachen).
Bestimmungsendpunkte des Modells
-
- Dynamisch verfügbare Modelle von Hugging Face für jede Familie abfragen.
- Robustes Eingangshandling
-
- Emoji? - Nein.
- Zahlen?
Symbole?
- Mach schon.
- Der Service umfasst nun eine umfassende Eingangssanierung und Symbolmaske.
- Warteschlange und Gegendruck anfordern
-
- Eingebaute Semaphore-basierte Warteschlange mit intelligenten Retry-After-Schätzungen.
LRU-Modell-Caching
- Verwalten Sie VRAM automatisch, indem Sie alte Modelle entfernen, wenn der Cache voll ist. |--------|------|------| Moderne CUDA-Unterstützung
- Verwendet PyTorch mit CUDA 12.6, unterstützt FP16/BF16 für 2x Geschwindigkeitsverbesserungen. Produktionsfertige Beobachtbarkeit
- Gesundheitskontrollen, Bereitschaftssonden, Cache-Status, strukturierte Protokollierung. Anmutiges Herunterfahren
- Keine verwaisten Anfragen oder beschädigten Zustand.
EasyNMT-kompatible API
-
- Drop-In-Ersatz für bestehende Integrationen.
- Pivot Übersetzung fallback
-
- Wenn ein direktes Sprachpaar nicht verfügbar ist, führt es automatisch durch Englisch (oder Ihren gewählten Pivot).
- Minimale Docker-Bilder
-
- Neu
Varianten mit Volume-Mapped Cache für kleinere Bereitstellungen.
- ⚠️ Sometimes adds interpretations not in original
- ⚠️ Quality varies with prompt phrasing
- ⚠️ Can be "creative" with technical terms
- ⚠️ Needs careful prompt engineering
- ⚠️ Unpredictable with edge cases
Warum NMT über LLMs für Übersetzung?
Input: "The API returns a 429 status code when rate limited."

NMT (Opus-MT): "Die API gibt einen 429-Statuscode zurück, wenn sie ratenbegrenzt ist."
(Accurate, preserves technical terms)

LLM (might do): "Die API sendet den Fehlercode 429, wenn zu viele Anfragen gestellt werden."
(Interprets rather than translates, adds context not in original)
Vielleicht fragen Sie sich: "Warum einen speziellen NMT-Dienst nutzen, wenn LLMs wie GPT-4, Claude oder Llama übersetzen können?" Gute Frage.
Hier ist der Realitätscheck basierend auf der Produktionsnutzung:
- Geschwindigkeit: 10-100x Schneller
- NMT (meistens lucid-nmt):
- CPU: ~0.3-1.0 Sekunden pro Satz
- GPU (FP16): ~0,05-0,2 Sekunden pro Satz
- Stapelverarbeitung: 50+ Sätze/Sekunde auf GPU
- LLM: LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs.
GPT-4: 3-10 Sekunden pro Anfrage (API-Latenz + Generierung)
- Llama 3 70B: 5-15 Sekunden pro Satz (lokal)
- Claude 3: 2-8 Sekunden pro Anfrage (API-Latenz)
- Echtes Beispiel:
- Übersetzen eines 1000-Wort-Blogbeitrags:
- meistlucid-nmt (GPU)
: 5-10 Sekunden
GPT-4 API**: 30-60 Sekunden**Lokale Llama 70B
- : 2-5 Minuten
- Wenn Sie automatisch Hunderte von Blog-Posts in 12+ Sprachen übersetzen, ist dieser Geschwindigkeitsunterschied MASSIVE.
- Modellgröße: 500MB vs 140GB
- NMT-Modelle:
Opus-MT (pro Richtung): 300-500MB
mBART50 (alle 50 Sprachen): 2.4GBM2M100 (alle 100 Sprachen): 2.2GB
Insgesamt für 100+ Sprachen: ~2.2GB
flowchart LR
    A[HTTP Client] --> B[API Gateway]
    B --> C[Translation Endpoint]
    C --> D{Has Capacity?}
    D -->|Yes| E[Translation Service]
    D -->|No| F[Queue with 429]
    F --> E
    E --> G[Process Pipeline]
    G --> H[Get Model from Cache]
    H --> I[Translate]
    I --> J[Return Response]
    J --> A
LLM: LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs, LLMs.
- Llama 3 8B: ~16GBLlama 3 70B: ~140GB
- Mischung 8x7B: ~90GBGPT-4: Nicht für Selbst-Hosting verfügbar
- **Auswirkungen auf die Lagerung:**Ressourcenanforderungen: Laptop vs Server Farm
- **NMT-CPU-Einsatz:**Läuft gut auf: 2 CPU-Kerne, 4GB RAM
- Docker Bild: 1.5-2.5GBSchlussfolgerung: Nur CPU, keine GPU erforderlich
Retry-AfterKosten: 10-20 $/Monat VPS
- **LLM-Anforderungen:**Llama 3 70B: benötigt 80GB+ VRAM (A100 GPU)
- Kleinere 7B-13B Modelle: Noch 16-32GB RAM Minimum
- API-Kosten: $0.03-0,30 pro 1000 Token (erhöht sich schnell!)
- Selbst-Hosting: $1000+/Monat für schwere GPU
- Realer Kostenvergleich für 10.000 Blogpost-Übersetzungen:
- Verfahren Kosten ZeitHauptsächlichlucid-nmt (CPU)- $20/Monat VPS- 2-3 Stunden
- Hauptsächlichlucid-nmt (GPU) - $50/Monat GPU VPS - 15-30 Minuten
- GPT-4 API, $150-300, 8-15 Stunden
- Claude API, $200-400, 6-12 Stunden
- Lokale Llama 70B, $1000+/Monats-Hardware, 20-40 StundenQualität: Zweck-Baut vs. General-Zweck
**NMT-Stärke:**Speziell für die Übersetzung ausgebildetRetry-AfterKonsistente Qualität (gleicher Eingang = gleicher Ausgang)
Keine "Halluzinationen" - reine Übersetzung
Behandelt technische Inhalte, Code, Formatierung gut
Keine prompte Technik erforderlich
sequenceDiagram
    participant Client
    participant API
    participant Queue
    participant Translator
    participant Cache
    participant Model

    Client->>API: POST /translate
    API->>Queue: Acquire slot

    alt Queue has space
        Queue-->>API: Slot acquired
        API->>Translator: Process translation
        Translator->>Translator: Sanitize input
        Translator->>Translator: Split sentences
        Translator->>Translator: Chunk text
        Translator->>Translator: Mask symbols
        Translator->>Cache: Get model (en→de)

        alt Cache hit
            Cache-->>Translator: Return cached model
        else Cache miss
            Cache->>Model: Load from Hugging Face
            Model-->>Cache: Pipeline loaded
            Cache->>Cache: Evict old if at capacity
            Cache-->>Translator: Return model
        end

        Translator->>Model: Translate batches
        Model-->>Translator: Translations
        Translator->>Translator: Unmask symbols
        Translator->>Translator: Post-process
        Translator-->>API: Translations
        API->>Queue: Release slot
        API-->>Client: 200 OK + translations
    else Queue full
        Queue-->>API: Overflow error
        API-->>Client: 429 Too Many Requests\nRetry-After: X seconds
    end
LLM-Herausforderungen:
Beispielszenario:
graph LR
    A[Raw Input] --> B{Sanitize?}
    B -->|Yes| C[Check Noise]
    B -->|No| D[Split Sentences]
    C -->|Is Noise| Z[Return Placeholder]
    C -->|Valid| D

    D --> E[Enforce Max Length]
    E --> F[Chunk for Batching]
    F --> G{Symbol Masking?}

    G -->|Yes| H[Mask Digits/Punct/Emoji]
    G -->|No| I[Translate]
    H --> I

    I --> J{Direct Model?}
    J -->|Available| K[Direct Translation]
    J -->|Not Available| L{Pivot Fallback?}

    L -->|Yes| M[src→en→tgt]
    L -->|No| Z
    K --> N[Unmask Syis robust input handling. Here's what happens:

**Noise Detection:**
- Strips control characters (except \t, \n, \r)
- Checks minimum character count (default: 1)
- Calculates alphanumeric ratio (default: must be ≥20%)
- Rejects pure emoji, pure punctuation, or pure whitespace

**Symbol Masking:**
Why mask symbols? Translation models are trained on text, not emoji or special symbols. These can confuse them or get mangled. So we:

1. Extract all digits, punctuation, and emoji as contiguous runs
2. Replace them with sentinel tokens: `⟪MSK0⟫`, `⟪MSK1⟫`, etc.
3. Translate the masked text
4. Restore the original symbols in their positions

Example:
Input: "Hello 👋 world! Price: $99.99" Wann jedes Mal verwendet werden soll (👋) (!) (:) ($99.99)
**Post-Processing:**
After translation, we remove "symbol loops" - repeated symbols that weren't in the source:
NMT (meistens lucid-nmt) verwenden, wenn: Sie benötigen eine konsistente, schnelle Übersetzung im Maßstab Haushaltsfragen (Selbstbewirtung oder hohes Volumen)
### Sentence Splitting & Chunking

Long texts get split intelligently:

```mermaid
graph TD
    A[Long Text] --> B[Split on . ! ? …]
    B --> C{Sentence > 500 chars?}
    C -->|Yes| D[Split on word boundaries]
    C -->|No| E[Keep sentence]
    D --> E

    E --> F[Group into chunks ≤900 chars]
    F --> G[Translate each chunk]
    G --> H[Join with space]
Sie übersetzen technische Inhalte, Code, strukturierte Daten
- Sie benötigen deterministische Ausgabe (gleiche Eingabe = gleiche Ausgabe)
- Sie wollen auf CPU oder bescheidener Hardware laufen
- Sie bauen automatisierte Übersetzungspipelines
LLMs verwenden, wenn:
Sie brauchen kreative Anpassung, nicht wörtliche Übersetzung
stateDiagram-v2
    [*] --> CheckCache
    CheckCache --> CacheHit: Model exists
    CheckCache --> CacheMiss: Model not loaded

    CacheHit --> MoveToEnd: Update LRU order
    MoveToEnd --> ReturnModel

    CacheMiss --> CheckCapacity
    CheckCapacity --> LoadModel: Space available
    CheckCapacity --> EvictOldest: Cache full

    EvictOldest --> MoveToCPU: Free VRAM
    MoveToCPU --> ClearCUDA: torch.cuda.empty_cache()
    ClearCUDA --> LoadModel

    LoadModel --> AddToCache
    AddToCache --> ReturnModel
    ReturnModel --> [*]
Kontext und kulturelle Nuance Materie mehr als Geschwindigkeit
- Du machst niederbändige, einmalige Übersetzungen
- Sie müssen übersetzen + zusammenfassen + neu schreiben in einem Schritt
- Sie sind okay mit variablen Kosten und langsamere Verarbeitung
- Unterm Strich:
- Für
Automatische Blog-Übersetzung
(mein Anwendungsfall), NMT ist der klare Gewinner:
# Semaphore limits concurrent translations
MAX_INFLIGHT = 1  # On GPU, 1 at a time for efficiency
MAX_QUEUE_SIZE = 1000  # Up to 1000 waiting

# When full:
# - Returns 429 Too Many Requests
# - Includes Retry-After header
# - Estimates wait time based on average duration
Übersetzt 100+ Blogposts zu 12 Sprachen in ~30 Minuten (GPU)
avg_duration = 2.5 seconds (tracked with EMA)
waiters = 100
slots = 1
estimated_wait = (100 / 1) * 2.5 = 250 seconds
clamped = min(250, 120) = 120 seconds
Retry-After: 120
läuft auf einem $50/Monat VPS
Konsequente Qualität über alle Stellen hinweg
graph LR
    A[Ukrainian Text] --> B{Direct uk→fr?}
    B -->|Exists| C[Translate Directly]
    B -->|Missing| D[Pivot via English]

    D --> E[uk→en]
    E --> F[en→fr]
    F --> G[French Result]
    C --> G
Gesamteinrichtung: Ein Docker-Container
Das mit LLMs zu versuchen, würde hunderte Dollar pro Monat in API-Gebühren kosten oder einen $2000+ GPU-Server zum Selbsthosten benötigen.
Allein der Geschwindigkeitsunterschied macht NMT zur einzigen praktischen Wahl für Produktionsübersetzungspipelines.
TL;DR:
NMT ist zweckgebunden für die Übersetzung, läuft auf bescheidener Hardware und ist 10-100x schneller als LLMs. Wenn Sie eine schnelle, konsistente und kostengünstige Übersetzung im Maßstab benötigen, gewinnt NMT Hände nach unten.
# src/core/cache.py
from collections import OrderedDict
import torch

class LRUPipelineCache:
    """LRU cache that automatically cleans up GPU memory when evicting models."""

    def __init__(self, capacity: int):
        self.cache = OrderedDict()  # Maintains insertion order
        self.capacity = capacity

    def get(self, key: str):
        """Get model from cache, moves it to end (most recently used)."""
        if key not in self.cache:
            return None
        self.cache.move_to_end(key)  # Mark as recently used
        return self.cache[key]

    def put(self, key: str, value):
        """Add model to cache, evicting oldest if at capacity."""
        if key in self.cache:
            self.cache.move_to_end(key)
        else:
            self.cache[key] = value

        # If cache is full, evict the oldest model
        if len(self.cache) > self.capacity:
            oldest_key, oldest_pipeline = self.cache.popitem(last=False)

            # MAGIC: Move evicted model to CPU to free GPU memory
            try:
                oldest_pipeline.model.to("cpu")
                if torch.cuda.is_available():
                    torch.cuda.empty_cache()  # Tell GPU to release memory
                logger.info(f"Evicted {oldest_key}, freed GPU memory")
            except Exception as e:
                logger.warning(f"Failed to clean GPU memory: {e}")
Überblick über die Architektur
OrderedDictDer Anforderungsfluss ist einfach:- Kundesendet Übersetzungsanfrage an API Gateway (Gunicorn + Uvicorn Workers)
- API-GatewayRouten zum Translation Endpoint
- Kapazitätsüberprüfung: System prüft, ob es in der Lage ist, die Anfrage zu bearbeiten
Nein
→ Anfrage geht sofort an den Übersetzungsdienst
# src/services/model_manager.py
def get_pipeline(self, src: str, tgt: str):
    """Try to get translation model, with automatic fallback to other providers."""

    # Determine which model families support this language pair
    families_to_try = []

    if config.AUTO_MODEL_FALLBACK:
        # Try families in priority order: opus-mt → mbart50 → m2m100
        for family in config.MODEL_FALLBACK_ORDER.split(","):
            if self._is_pair_supported(src, tgt, family.strip()):
                families_to_try.append(family.strip())

    # Try each family until one succeeds
    last_error = None
    for family in families_to_try:
        try:
            model_name, src_lang, tgt_lang, _ = self._get_model_name_and_langs(src, tgt, family)

            if family != config.MODEL_FAMILY:
                logger.info(f"Using fallback '{family}' for {src}->{tgt}")

            # Load the model from HuggingFace
            pipeline = transformers.pipeline(
                "translation",
                model=model_name,
                device=device_manager.device_index,
                src_lang=src_lang,
                tgt_lang=tgt_lang
            )

            self.cache.put(f"{src}->{tgt}", pipeline)
            return pipeline

        except Exception as e:
            last_error = e
            logger.warning(f"Family '{family}' failed for {src}->{tgt}: {e}")
            continue  # Try next family

    # All families failed
    raise ModelLoadError(f"{src}->{tgt}", last_error)
Nein
- → Anfrage Schlange, Client empfängt HTTP 429 mitKopfzeile
- Übersetzungsdienstverarbeitet die Anfrage über die Pipeline:
- Einleitungssanierung und SatzspaltungSymbolmasken (Emojis, spezielle Zeichen)
- Übersetzung mit zwischengespeicherten ModellenSymbolentlarvung und Nachbearbeitung
Muster-Cache
(LRU) bietet Übersetzungsmodelle:
# src/services/queue_manager.py
import asyncio
from contextlib import asynccontextmanager

class QueueManager:
    """Manages request queuing and backpressure."""

    def __init__(self, max_inflight: int, max_queue: int):
        self.semaphore = asyncio.Semaphore(max_inflight)  # Limit concurrent translations
        self.max_queue_size = max_queue
        self.waiting_count = 0
        self.inflight_count = 0
        self.avg_duration_sec = 5.0  # Exponential moving average

    @asynccontextmanager
    async def acquire_slot(self):
        """Try to get a translation slot, track metrics, handle queueing."""

        # Check if queue is too full
        if self.waiting_count >= self.max_queue_size:
            # Calculate how long client should wait before retrying
            retry_after = self._estimate_retry_after()
            raise QueueOverflowError(self.waiting_count, retry_after)

        self.waiting_count += 1
        try:
            # Wait for available slot (this is the queue!)
            await self.semaphore.acquire()
            self.waiting_count -= 1
            self.inflight_count += 1

            start_time = time.time()
            yield  # Let the translation happen

            # Update average duration for retry-after estimates
            duration = time.time() - start_time
            alpha = config.RETRY_AFTER_ALPHA  # Smoothing factor (0.2)
            self.avg_duration_sec = alpha * duration + (1 - alpha) * self.avg_duration_sec

        finally:
            self.inflight_count -= 1
            self.semaphore.release()

    def _estimate_retry_after(self) -> int:
        """Smart calculation: how many waiting / how many slots * avg time per request."""
        if self.inflight_count == 0:
            return config.RETRY_AFTER_MIN_SEC

        # If 10 people waiting and 2 slots available, and each takes 5 seconds:
        # retry_after = (10 / 2) * 5 = 25 seconds
        retry_sec = (self.waiting_count / self.semaphore._value) * self.avg_duration_sec

        # Clamp between min and max
        return max(
            config.RETRY_AFTER_MIN_SEC,
            min(int(retry_sec), config.RETRY_AFTER_MAX_SEC)
        )
Cache Treffer → Schnelle Reaktion
- Cache miss → Laden von HuggingFace HubCache voll → Auto-Evict alte Modelle, klar CUDA-Speicher
max_inflight) - Ansprechen (
@asynccontextmanagerkehrt zum Client zurück - **Schlüsselentwurf:**Der Rückdruckmechanismus (queue + HTTP 429) verhindert Abstürze unter Last.
- Wenn überwältigt, der Service Warteschlangen Anfragen statt sterben, geben Kunden intelligente Wiederholung Timing überKopfzeilen.
- Wie es funktioniert: Tief tauchenAnfrage-Fluss
Wenn eine Übersetzungsanfrage eintrifft, ist Folgendes passiert:
Input Processing Pipeline
# src/utils/symbol_masking.py
import re

def mask_symbols(text: str) -> tuple[str, dict[str, str]]:
    """Replace special symbols with placeholders before translation."""

    originals = {}
    masked_text = text
    placeholder_counter = 0

    # Pattern: Match emojis, symbols, special punctuation
    # \U0001F300-\U0001F9FF = emoji range
    # [\u2600-\u26FF\u2700-\u27BF] = misc symbols
    symbol_pattern = re.compile(
        r'[\U0001F300-\U0001F9FF\u2600-\u26FF\u2700-\u27BF'
        r'\u00A9\u00AE\u2122\u2139\u3030\u303D\u3297\u3299]+'
    )

    for match in symbol_pattern.finditer(text):
        symbol = match.group()
        placeholder = f"__SYMBOL_{placeholder_counter}__"
        originals[placeholder] = symbol
        masked_text = masked_text.replace(symbol, placeholder, 1)
        placeholder_counter += 1

    return masked_text, originals

def unmask_symbols(text: str, originals: dict[str, str]) -> str:
    """Restore original symbols after translation."""
    for placeholder, original in originals.items():
        text = text.replace(placeholder, original)
    return text
Der Service verwendet eine ausgeklügelte mehrstufige Pipeline, um chaotischen Real-World-Text zu verarbeiten:
# Before translation:
text = "Hello! 👋 Check out this cool feature 🚀"

# Mask symbols:
masked, originals = mask_symbols(text)
# masked = "Hello! __SYMBOL_0__ Check out this cool feature __SYMBOL_1__"
# originals = {"__SYMBOL_0__": "👋", "__SYMBOL_1__": "🚀"}

# Translate the masked text:
translated = translate(masked, "de")  # → "Hallo! __SYMBOL_0__ Schau dir diese coole Funktion an __SYMBOL_1__"

# Unmask symbols:
final = unmask_symbols(translated, originals)
# final = "Hallo! 👋 Schau dir diese coole Funktion an 🚀"
Maskiert: "Hallo, MSK, Welt, MSK1, Preis, MSK2, MSK3,"
- **Quelle: "Hallo-Welt"**Schlechte Übersetzung: "Hola mundo!!!!!!!"
- Gesäubert: "Hola mundo" # Entfernt die !!!!-SchleifeDies gewährleistet:
👋Modelle ersticken nicht an riesigen Eingängen__SYMBOL_0__Wir können effizient chargen - Kontext bleibt innerhalb vernünftiger Grenzen erhaltenModell-Caching & Speicherverwaltung
Der LRU-Cache ist intelligent über GPU-Speicher:
Warum das so wichtig ist:
# src/utils/text_processing.py
def chunk_sentences(sentences: list[str], max_chars: int = 900) -> list[list[str]]:
    """Group sentences into chunks that fit within model's max input length."""

    chunks = []
    current_chunk = []
    current_length = 0

    for sentence in sentences:
        sentence_len = len(sentence)

        # If this sentence alone is too long, it goes in its own chunk
        if sentence_len > max_chars:
            if current_chunk:
                chunks.append(current_chunk)
                current_chunk = []
                current_length = 0
            chunks.append([sentence])
            continue

        # If adding this sentence exceeds limit, start new chunk
        if current_length + sentence_len + 1 > max_chars:
            chunks.append(current_chunk)
            current_chunk = [sentence]
            current_length = sentence_len
        else:
            current_chunk.append(sentence)
            current_length += sentence_len + 1  # +1 for space

    # Don't forget the last chunk!
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def split_sentences(text: str, max_sentence_chars: int = 500) -> list[str]:
    """Split text into sentences, enforcing max length."""

    # Split on common sentence terminators
    sentences = re.split(r'([.!?…]+\s+)', text)

    result = []
    for sentence in sentences:
        if not sentence or sentence.isspace():
            continue

        # If sentence is too long, split on word boundaries
        if len(sentence) > max_sentence_chars:
            words = sentence.split()
            current = []
            current_len = 0

            for word in words:
                if current_len + len(word) + 1 > max_sentence_chars:
                    result.append(' '.join(current))
                    current = [word]
                    current_len = len(word)
                else:
                    current.append(word)
                    current_len += len(word) + 1

            if current:
                result.append(' '.join(current))
        else:
            result.append(sentence.strip())

    return result
GPU-Speicher ist wertvoll
- Übersetzungsmodelle sind jeweils 300-500MBDie Lademodelle sind langsam (1-3 Sekunden)
.!?…Wir halten die 6 neuesten Modelle heiß - Alte Modelle werden automatisch vertriebenAnhalten & Rückdruck
- **Anstatt unter Last abzustürzen, fordert der Dienst:**Die Retry-Schätzung ist klug:
- Pivot Übersetzung FallbackNicht alle Sprachpaare haben direkte Modelle auf Hugging Face.
Lösung?
Pivot durch Englisch:
# src/services/model_discovery.py
import httpx
from datetime import datetime, timedelta

class ModelDiscoveryService:
    """Discovers available translation models with 1-hour cache."""

    def __init__(self):
        self._cache = {}  # Cache results to avoid hammering HuggingFace API
        self._cache_ttl = timedelta(hours=1)
        self._hf_api_base = "https://huggingface.co/api/models"

    async def discover_opus_mt_pairs(self, force_refresh: bool = False):
        """Query HuggingFace for all Helsinki-NLP Opus-MT models."""

        cache_key = "opus-mt"

        # Check cache first
        if not force_refresh and cache_key in self._cache:
            cached_data, cached_time = self._cache[cache_key]
            if datetime.now() - cached_time < self._cache_ttl:
                return cached_data  # Cache hit!

        # Cache miss - query HuggingFace API
        async with httpx.AsyncClient() as client:
            response = await client.get(
                self._hf_api_base,
                params={
                    "author": "Helsinki-NLP",
                    "search": "opus-mt",
                    "limit": 1000
                },
                timeout=30.0
            )
            models = response.json()

        # Extract language pairs from model names
        # Example: "Helsinki-NLP/opus-mt-en-de" → ("en", "de")
        pairs = []
        for model in models:
            model_id = model.get("modelId", "")
            if model_id.startswith("Helsinki-NLP/opus-mt-"):
                # Extract the language codes after "opus-mt-"
                lang_part = model_id.replace("Helsinki-NLP/opus-mt-", "")
                if "-" in lang_part:
                    src, tgt = lang_part.split("-", 1)
                    pairs.append({"source": src, "target": tgt})

        # Cache the results
        self._cache[cache_key] = (pairs, datetime.now())

        return pairs
Dies verdoppelt die Latenz, sorgt aber für die Abdeckung aller unterstützten Sprachpaare.
- Code Deep Dive: Coole Eigenschaften erklärt (
httpxLassen Sie uns einige der interessantesten Teile der Codebase erkunden! - **Das sind echte Produktionsmuster, die den Service robust und effizient machen.**Jedes Snippet enthält Erklärungen, die für Nicht-Python-Entwickler geeignet sind.
- **1.**Smarter LRU Cache mit GPU-Speicherverwaltung
enEines der coolsten Features ist der intelligente Modell-Cache, der mit GPU-Speichern umgehen kann:deWas ist hier los?Helsinki-NLP/opus-mt-en-de - : Wie ein regelmäßiges Wörterbuch, aber erinnert sich, die Reihenfolge Elemente wurden hinzugefügtLRU (least recent used)
: Wenn der Cache voll ist, schmeiß das Modell heraus, das in der längsten Zeit nicht verwendet wurde
GPU-Reinigung
# src/core/device.py
import torch

class DeviceManager:
    """Smart device selection with GPU auto-detection."""

    def __init__(self):
        self.use_gpu = self._should_use_gpu()
        self.device_index = self._resolve_device()
        self.device_str = "cpu" if self.device_index < 0 else f"cuda:{self.device_index}"

        # Auto-configure parallel translation slots based on device
        if self.device_index >= 0:
            # GPU: Run translations serially to avoid VRAM fragmentation
            self.max_inflight = 1
        else:
            # CPU: Can handle multiple translations in parallel
            self.max_inflight = config.MAX_WORKERS_BACKEND

        self._log_device_info()

    def _should_use_gpu(self) -> bool:
        """Check if GPU should be used."""
        if config.USE_GPU.lower() == "false":
            return False
        if config.USE_GPU.lower() == "true":
            return torch.cuda.is_available()
        # "auto" mode: use GPU if available
        return torch.cuda.is_available()

    def _resolve_device(self) -> int:
        """Returns device index: -1 for CPU, 0+ for CUDA."""
        if not self.use_gpu:
            return -1

        # Check if specific CUDA device requested
        if config.DEVICE and config.DEVICE.startswith("cuda:"):
            device_num = int(config.DEVICE.split(":")[1])
            return device_num

        return 0  # Use first GPU

    def _log_device_info(self):
        """Log device information at startup."""
        if self.device_index >= 0:
            gpu_name = torch.cuda.get_device_name(self.device_index)
            vram_gb = torch.cuda.get_device_properties(self.device_index).total_memory / 1e9
            logger.info(f"Using GPU: {gpu_name} ({vram_gb:.1f}GB VRAM)")
            logger.info(f"Max inflight translations: {self.max_inflight} (GPU mode)")
        else:
            cpu_count = os.cpu_count()
            logger.info(f"Using CPU ({cpu_count} cores)")
            logger.info(f"Max inflight translations: {self.max_inflight} (CPU mode)")

# Global singleton instance
device_manager = DeviceManager()
: Wenn wir ein Modell vertreiben, verschieben wir es explizit in den CPU-Speicher und sagen der GPU, dass sie ihre Ressourcen freigeben soll.
- Warum es wichtig ist: Ohne diese würde GPU-Speicher füllen und Absturz nach dem Laden 2-3 Modelle!
- **2. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).**Automatische Modellfamilie Rückfall
max_inflight=1Diese clevere Funktion versucht mehrere AI-Modellanbieter automatisch, wenn der erste nicht das gewünschte Sprachpaar hat:max_inflight=4Was ist hier los? - Rückschlagkette: Wenn Opus-MT nicht Ukrainisch→Französisch hat, versuchen Sie es automatisch mBART50, dann M2M100
DEVICE=cuda:1 - Keine manuelle Intervention: Benutzer nur eine Übersetzung anfordern und das beste verfügbare Modell erhalten
- Fehlerbehandlung: Wenn alle Familien scheitern, werfen wir einen klaren Fehler mit dem letzten Fehler Grund
Intelligentes Caching
: Erfolgreiche Modelle werden mit dem Sprachpaar-Schlüssel zwischengespeichert
# Snippet from QueueManager showing EMA calculation
def update_avg_duration(self, new_duration: float):
    """Update average duration using exponential moving average."""

    # EMA formula: new_avg = α × new_value + (1 - α) × old_avg
    # α = smoothing factor (0.0 to 1.0)
    #   - Higher α = more weight to recent values (faster adaptation)
    #   - Lower α = more weight to historical values (more stable)

    alpha = 0.2  # 20% weight to new value, 80% to historical

    self.avg_duration_sec = (
        alpha * new_duration +
        (1 - alpha) * self.avg_duration_sec
    )
3. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
# Initial average: 5.0 seconds
# New request takes: 10.0 seconds

# EMA calculation:
new_avg = 0.2 * 10.0 + 0.8 * 5.0
        = 2.0 + 4.0
        = 6.0 seconds

# Next request takes: 3.0 seconds
new_avg = 0.2 * 3.0 + 0.8 * 6.0
        = 0.6 + 4.8
        = 5.4 seconds
Anfrage Warteschlange mit Gegendruck (HTTP 429)
- **Produktionsqualität, die Serverabstürze bei schwerer Belastung verhindert:**Was ist hier los?
- Semaphore: Wie ein Türsteher in einem Club - lässt N-Leute nur auf einmal rein (N =
- Kontextverwaltung): Verfolgt automatisch Metriken und reinigt
- Intelligente Nachprüfung: Sagt Kunden "in 25 Sekunden zurück" basierend auf Warteschlange Tiefe und durchschnittliche Anfragezeit
Retry-AfterOffener gleitender Durchschnitt
: Smooths out Spikes in Anfrage Dauer
- Warum es wichtig ist: Bei schwerer Last gibt HTTP 429 zurück, anstatt unendlich abzustürzen oder Warteschlangen
- **4. Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).**Symbol maskiert Magie
- **Bewahrt Sonderzeichen (Emojis, Symbole), die Übersetzungsmodelle verwüsten könnten:**Beispielverwendung:
- **Was ist hier los?**Regex-Muster
- : Matches emoji und spezielles Symbol Unicode-BereichePlatzhaltersystem
- : Swapsmit
Vorübergehend
Warum es wichtig ist
: Translation Models manchmal korrupt oder entfernen Emojis - das bewahrt sie perfekt!
5. Verordnung (EWG) Nr. 1408/71 des Rates vom 14. Juni 1971 zur Anwendung der Systeme der sozialen Sicherheit auf Arbeitnehmer und Selbständige (ABl.
# Prefer GPU if available (default)
USE_GPU=auto

# Force GPU
USE_GPU=true

# Force CPU
USE_GPU=false

# Explicit device override
DEVICE=cuda:0
DEVICE=cpu
Intelligentes Text-Chunking
# Model family selection (NEW in v2.0!)
MODEL_FAMILY=opus-mt   # Best quality (default)
MODEL_FAMILY=mbart50   # 50 languages, single model
MODEL_FAMILY=m2m100    # 100 languages, maximum coverage

# Auto-fallback between model families (NEW in v2.0!)
AUTO_MODEL_FALLBACK=1  # Enabled by default
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"  # Priority order

# Volume-mapped model cache (NEW in v2.0!)
MODEL_CACHE_DIR=/models  # Persistent cache directory

# Model arguments passed to transformers.pipeline
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
EASYNMT_MODEL_ARGS='{"torch_dtype":"bf16","cache_dir":"/models"}'

# Preload models at startup (reduces first-request latency)
PRELOAD_MODELS="en->de,de->en,fr->en"

# LRU cache capacity
MAX_CACHED_MODELS=6
Zerbricht lange Texte in Stücke, die Modellgrenzen anpassen und gleichzeitig Satzgrenzen wahren:
**Was ist hier los?**Satzspaltung
opus-mt: Verwendet Regex zum Aufteilenmbart50unter Wahrung der Pünktlichkeitm2m100Gieriges Stückchen
: Packt so viele Sätze wie möglich in jedes Stück, ohne das Limit zu überschreitenAufspaltung der Wortgrenzen
1: Wenn ein einziger Satz zu lang ist, spaltet er sich auf Leerzeichen, anstatt das Mittelwort zu schneiden0Warum es wichtig ist
**: Übersetzungsmodelle haben Eingabegrenzwerte (in der Regel 512-1024 Token).**Dies stellt sicher, dass wir sie nie überschreiten, während wir den Kontext intakt halten.
-
- Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
"opus-mt,mbart50,m2m100"Async Model Discovery mit Caching
- Der Präsident. — Das Wort hat die Fraktion der Europäischen Volkspartei (Christlich-Demokratische Fraktion).
- Dynamisch entdeckt verfügbare Übersetzungsmodelle von HuggingFace:
"m2m100,mbart50,opus-mt"Was ist hier los?
-
HTTP-Client von Async): Nicht blockierende HTTP-Anfragen an HuggingFace
- Zeitbasiertes Caching
/models: Speichert Ergebnisse für 1 Stunde, um eine Begrenzung der Rate zu vermeiden-v ./model-cache:/models - Modellbezeichnung Parsing
- : Auszüge
- Zeitbasiertes Caching
und
fp16vonbf16Warum es wichtig istfp32: HuggingFace hat 1200+ Opus-MT Modelle.
Das Abfragen dauert alle ~10 Sekunden.
# Batch size for translation (higher = faster but more VRAM)
EASYNMT_BATCH_SIZE=16  # CPU: 8-16, GPU: 32-64

# Maximum text length per item
EASYNMT_MAX_TEXT_LEN=1000

# Maximum beam size (higher = better quality but slower)
EASYNMT_MAX_BEAM_SIZE=5

# Worker thread pools
MAX_WORKERS_BACKEND=1    # Translation workers
MAX_WORKERS_FRONTEND=2   # Language detection workers
Caching macht es sofort!
# Enable request queueing (highly recommended)
ENABLE_QUEUE=1

# Max concurrent translations
# Auto: 1 on GPU, MAX_WORKERS_BACKEND on CPU
MAX_INFLIGHT_TRANSLATIONS=1

# Max queued requests before 429
MAX_QUEUE_SIZE=1000

# Per-request timeout (0 = disabled)
TRANSLATE_TIMEOUT_SEC=180

# Retry-After estimation
RETRY_AFTER_MIN_SEC=1      # Floor
RETRY_AFTER_MAX_SEC=120    # Ceiling
RETRY_AFTER_ALPHA=0.2      # EMA smoothing factor
7. . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . .
# Enable input filtering
INPUT_SANITIZE=1

# Minimum alphanumeric ratio (0.2 = 20%)
INPUT_MIN_ALNUM_RATIO=0.2

# Minimum character count
INPUT_MIN_CHARS=1

# Language code for undetermined/noise
UNDETERMINED_LANG_CODE=und
Automatische Erkennung des Geräts
# Default sentence splitting behavior
PERFORM_SENTENCE_SPLITTING_DEFAULT=1

# Max chars per sentence before word-boundary split
MAX_SENTENCE_CHARS=500

# Max chars per chunk for batching
MAX_CHUNK_CHARS=900

# Sentence joiner
JOIN_SENTENCES_WITH=" "
Erkennt und verwendet GPU automatisch, wenn verfügbar:
# Enable symbol masking
SYMBOL_MASKING=1

# What to mask
MASK_DIGITS=1    # Mask 0-9
MASK_PUNCT=1     # Mask .,!? etc.
MASK_EMOJI=1     # Mask 😀🎉 etc.
Was ist hier los?
# Align response array length to input
ALIGN_RESPONSES=1

# Placeholder for failed items (when aligned)
SANITIZE_PLACEHOLDER=""

# Response format
EASYNMT_RESPONSE_MODE=strings    # ["translation1", "translation2"]
EASYNMT_RESPONSE_MODE=objects    # [{"text":"translation1"}, ...]
GPU-Erkennung
# Enable two-hop translation via pivot
PIVOT_FALLBACK=1

# Pivot language (usually English)
PIVOT_LANG=en
: Verwendet PyTorch, um zu überprüfen, ob CUDA verfügbar ist
# Log level
LOG_LEVEL=INFO

# Per-request logging (verbose)
REQUEST_LOG=1

# Format
LOG_FORMAT=plain    # Human-readable
LOG_FORMAT=json     # Structured JSON

# File logging with rotation
LOG_TO_FILE=1
LOG_FILE_PATH=/var/log/marian-translator/app.log
LOG_FILE_MAX_BYTES=10485760    # 10MB
LOG_FILE_BACKUP_COUNT=5

# Include raw text in logs (privacy risk!)
LOG_INCLUDE_TEXT=0
Automatische Konfiguration
# Periodically clear CUDA cache (seconds, 0=disabled)
CUDA_CACHE_CLEAR_INTERVAL_SEC=0
: Sätze
# Worker count (use 1 for single GPU)
WEB_CONCURRENCY=1

# Request timeout
TIMEOUT=60

# Graceful shutdown timeout
GRACEFUL_TIMEOUT=20

# Keep-alive timeout
KEEP_ALIVE=5
auf GPU (vermeiden Sie die VRAM-Fragmentierung) vs.
auf CPU (maximale Parallelität)
# GET request
curl "http://localhost:8000/translate?target_lang=de&text=Hello%20world&source_lang=en"

# Response
{
  "translations": ["Hallo Welt"]
}
Geräteauswahl
# POST request
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": [
      "Hello world",
      "This is a test",
      "Machine translation is amazing"
    ],
    "target_lang": "de",
    "source_lang": "en",
    "beam_size": 1,
    "perform_sentence_splitting": true
  }'

# Response
{
  "target_lang": "de",
  "source_lang": "en",
  "translated": [
    "Hallo Welt",
    "Das ist ein Test",
    "Maschinenübersetzung ist erstaunlich"
  ],
  "translation_time": 0.342
}
: Kann spezifische GPU mit Ziel
# Omit source_lang for auto-detection
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": ["Bonjour le monde"],
    "target_lang": "en"
  }'

# Response
{
  "target_lang": "en",
  "source_lang": "fr",  # Detected
  "translated": ["Hello world"],
  "translation_time": 0.156
}
Protokollierung
# GET
curl "http://localhost:8000/language_detection?text=Hola%20mundo"
# {"language": "es"}

# POST with batch
curl -X POST http://localhost:8000/language_detection \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello", "Bonjour", "Hola"]}'
# {"languages": ["en", "fr", "es"]}
: Zeigt GPU-Name und VRAM beim Start zum Debuggen an
# Health check
curl http://localhost:8000/healthz
# {"status": "ok"}

# Readiness
curl http://localhost:8000/readyz
# {
#   "status": "ready",
#   "device": "cuda:0",
#   "queue_enabled": true,
#   "max_inflight": 1
# }

# Cache status
curl http://localhost:8000/cache
# {
#   "capacity": 6,
#   "size": 3,
#   "keys": ["en->de", "de->en", "fr->en"],
#   "device": "cuda:0",
#   "inflight": 1,
#   "queue_enabled": true
# }

# Model info
curl http://localhost:8000/model_name | jq
Einzeltonmuster
# When queue is full, you get 429
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["test"], "target_lang": "de"}'

# Response: 429 Too Many Requests
# Headers: Retry-After: 45
# Body:
{
  "message": "Too many requests; queue full",
  "retry_after_sec": 45
}

# Proper client behavior:
# 1. Read Retry-After header
# 2. Wait that long + jitter
# 3. Retry request
: Eine Instanz über die gesamte Anwendung verteilt
- (Das Parlament nimmt den Entwurf der legislativen Entschließung an.)
Exponential Moving Average für Retry-After
Glatte Retry-After-Schätzung, die sich an die tatsächlichen Anforderungsdauern anpasst:
Beispiel:
.\build-all.ps1
Was ist hier los?
chmod +x build-all.sh
./build-all.sh
EMA (Exponential Moving Average)
: Wie ein gewichteter Durchschnitt, der den jüngsten Werten mehr Bedeutung verleihtGlättungsfaktor (α):
- : Kontrolliert, wie schnell wir uns an Veränderungen anpassen (
latest,min,gpu,gpu-minWarum nicht einfach durchschnittlich? - : EMA passt sich schneller an Veränderungen an, während sie Spikes ausfiltertWarum es wichtig ist
20250108.143022: Gibt Kunden realistisch
Zeiten, die sich an die aktuelle Systemlast anpassen
# Always get the latest version
docker pull scottgal/mostlylucid-nmt:cpu
# Or use the :latest alias
docker pull scottgal/mostlylucid-nmt:latest

# Pin to a specific version for reproducibility
docker pull scottgal/mostlylucid-nmt:cpu-20250108.143022
docker pull scottgal/mostlylucid-nmt:cpu-min-20250108.143022
Diese Code-Muster zeigen Python-Praktiken der Produktionsklasse:
Ressourcenverwaltung
- : Explizite GPU-SpeicherreinigungAnmutige Erniedrigung
- : Automatischer Rückfall zwischen ModellanbieternRückdruckbehandlung
- : Warteschlange + HTTP 429 statt AbstürzeDatenintegrität
- : Symbol-Maskierung bewahrt SonderzeichenLeistungsoptimierung
: Smart Caching, Chunking und parallele Verarbeitung
docker inspect scottgal/mostlylucid-nmt:cpu | jq '.[0].Config.Labels'
Beobachtungsfähigkeit: Detailliertes Protokollieren und Metriken-Tracking.
Jedes dieser Funktionen löst ein echtes Produktionsproblem, das Abstürze, Fehler oder schlechte Benutzererfahrung ohne sie verursachen würde!
Einrichtungshandbuch
# Using pre-built image from Docker Hub (recommended)
docker run -d \
  --name translator \
  -p 8000:8000 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=500 \
  -e EASYNMT_BATCH_SIZE=16 \
  -e TIMEOUT=180 \
  -e LOG_LEVEL=INFO \
  -e REQUEST_LOG=0 \
  scottgal/mostlylucid-nmt

# Or build locally
docker build -t mostlylucid-nmt .
docker run -d --name translator -p 8000:8000 mostlylucid-nmt

# Check logs
docker logs -f translator
Der Dienst ist hochkonfigurierbar über Umgebungsvariablen.
# Using pre-built GPU image from Docker Hub (recommended)
docker run -d \
  --name translator-gpu \
  --gpus all \
  -p 8000:8000 \
  -e USE_GPU=true \
  -e DEVICE=cuda:0 \
  -e PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en" \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  -e EASYNMT_BATCH_SIZE=64 \
  -e MAX_CACHED_MODELS=8 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=2000 \
  -e WEB_CONCURRENCY=1 \
  -e TIMEOUT=180 \
  -e GRACEFUL_TIMEOUT=30 \
  -e LOG_FORMAT=json \
  -e LOG_TO_FILE=1 \
  -v /var/log/translator:/var/log/marian-translator \
  scottgal/mostlylucid-nmt:gpu

# Or build locally
docker build -f Dockerfile.gpu -t mostlylucid-nmt:gpu .
docker run -d --name translator-gpu --gpus all -p 8000:8000 mostlylucid-nmt:gpu

# Monitor cache and performance
watch -n 5 "curl -s http://localhost:8000/cache | jq"
Hier ist der komplette Leitfaden:
version: '3.8'

services:
  translator:
    image: scottgal/mostlylucid-nmt:gpu  # Use pre-built image
    container_name: translator
    restart: unless-stopped

    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]

    ports:
      - "8000:8000"

    environment:
      USE_GPU: "true"
      DEVICE: "cuda:0"
      PRELOAD_MODELS: "en->de,de->en,en->fr,fr->en"
      EASYNMT_MODEL_ARGS: '{"torch_dtype":"fp16"}'
      EASYNMT_BATCH_SIZE: "64"
      MAX_CACHED_MODELS: "8"
      ENABLE_QUEUE: "1"
      MAX_QUEUE_SIZE: "2000"
      WEB_CONCURRENCY: "1"
      TIMEOUT: "180"
      LOG_FORMAT: "json"
      LOG_TO_FILE: "1"

    volumes:
      - translator-logs:/var/log/marian-translator
      - translator-cache:/root/.cache/huggingface

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/healthz"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s

volumes:
  translator-logs:
  translator-cache:
Geräteauswahl
apiVersion: apps/v1
kind: Deployment
metadata:
  name: translator
spec:
  replicas: 2  # Scale horizontally for CPU, use 1 per GPU
  selector:
    matchLabels:
      app: translator
  template:
    metadata:
      labels:
        app: translator
    spec:
      containers:
      - name: translator
        image: scottgal/mostlylucid-nmt:gpu
        ports:
        - containerPort: 8000
        env:
        - name: USE_GPU
          value: "true"
        - name: EASYNMT_MODEL_ARGS
          value: '{"torch_dtype":"fp16"}'
        - name: PRELOAD_MODELS
          value: "en->de,de->en"
        - name: ENABLE_QUEUE
          value: "1"
        - name: MAX_QUEUE_SIZE
          value: "2000"

        resources:
          requests:
            memory: "4Gi"
            cpu: "2"
            nvidia.com/gpu: 1
          limits:
            memory: "8Gi"
            cpu: "4"
            nvidia.com/gpu: 1

        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10

        readinessProbe:
          httpGet:
            path: /readyz
            port: 8000
          initialDelaySeconds: 20
          periodSeconds: 5

---
apiVersion: v1
kind: Service
metadata:
  name: translator
spec:
  selector:
    app: translator
  ports:
  - port: 80
    targetPort: 8000
  type: LoadBalancer
Konfiguration des Modells
Neue Konfiguration erklärt:
MODELL_FAMILIEN
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'- : Wählen Sie, welche Modellfamilie als primär zu verwenden ist
- : Beste Qualität, 1200+ Paare, separate Modelle
- : Gute Qualität, 50 Sprachen, Einzelmodell 2.4GB
: Gute Qualität, 100 Sprachen, Einzelmodell 2.2GB
# Start high, reduce if you get OOM
EASYNMT_BATCH_SIZE=64  # Try 128 on large GPUs
AUTO_MODEL_FALLBACK
PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en": Probieren Sie automatisch andere Familien aus, wenn ein Paar nicht verfügbar ist
WEB_CONCURRENCY=1
MAX_INFLIGHT_TRANSLATIONS=1
(Standard): Aktiviert - maximale Abdeckung
MAX_CACHED_MODELS=10 # Keep more models in VRAM: Behinderte - strikter Einfamilienmodus
# beam_size=1 is 3-5x faster than beam_size=5
# Quality difference is often minimal
curl -X POST ... -d '{"beam_size": 1, ...}'
MODELL_FALLBACK_ORDER
: Vorrangiger Auftrag für den Fallback
EASYNMT_BATCH_SIZE=8Voreinstellung:
MAX_WORKERS_BACKEND=4
MAX_INFLIGHT_TRANSLATIONS=4
WEB_CONCURRENCY=2
(Qualität zuerst)
PERFORM_SENTENCE_SPLITTING_DEFAULT=0
Alternative:
(Erste Deckung)
// Bad: 100 separate requests
for (const text of texts) {
  await translate(text);
}

// Good: 1 batch request
await translate(texts);
MODELL_CACHE_DIR
async function translateWithRetry(texts) {
  try {
    return await translate(texts);
  } catch (err) {
    if (err.status === 429) {
      const retryAfter = err.headers['retry-after'];
      const jitter = Math.random() * 5;
      await sleep((retryAfter + jitter) * 1000);
      return translateWithRetry(texts);
    }
    throw err;
  }
}
: Persistente Modellspeicherung über Docker-Volumen
// Reuse HTTP connections
const agent = new https.Agent({ keepAlive: true });
Aufsetzen
// Bad: mixed language pairs in one request
translate([
  { text: "Hello", sourceLang: "en", targetLang: "de" },
  { text: "Bonjour", sourceLang: "fr", targetLang: "de" }
]);

// Good: group by language pair
translateBatch(enToDe, "en", "de");
translateBatch(frToDe, "fr", "de");
und Kartenvolumen:
Modelle bestehen über Container-Neustarts
- Gemeinsamer Cache zwischen mehreren Containernburner_dtype-Optionen:
- (Float16): 2x schneller auf GPU, halber Speicher, vernachlässigbarer Qualitätsverlust(bfloat16): Bessere numerische Stabilität als fp16, erfordert moderne GPUs
- (Float32): Volle Präzision, langsam, aber am genauestenÜbersetzungseinstellungen
- Warteliste & LeistungEinleitungssanierung
- SatzverarbeitungSymbol-Maskierung
- ReaktionsverhaltenPivot Fallback
- ProtokollierungInstandhaltung
Gunicorn (Docker)
Anwendungsbeispiele
translation_requests_total{lang_pair="en->de",status="success"} 1523
translation_requests_total{lang_pair="en->de",status="error"} 7
translation_duration_seconds{lang_pair="en->de",quantile="0.5"} 0.342
translation_duration_seconds{lang_pair="en->de",quantile="0.95"} 1.234
translation_queue_depth 23
translation_cache_size 6
translation_cache_hits_total 8234
translation_cache_misses_total 142
Grundlegende Übersetzung
# Enable JSON logging
LOG_FORMAT=json REQUEST_LOG=1

# Output example
{
  "ts": "2025-01-08T15:30:45+0000",
  "level": "INFO",
  "name": "app",
  "message": "translate_post done items=5 dt=0.342s",
  "req_id": "a3d2f5b1-c4e6-4f7a-9d8c-1e2f3a4b5c6d",
  "endpoint": "/translate",
  "src": "en",
  "tgt": "de",
  "items": 5,
  "duration_ms": 342
}
Batch Übersetzung (empfohlen)
Automatische Spracherkennung
Nur Spracherkennung |---------|---------|-----------------| | Beobachtungsfähigkeit EndpunkteHandhabung des Rückdrucks | Aufbau und VersionierungAlle Docker-Images enthalten jetzt die richtige Versionierung und Metadaten zum Tracking. | Schnelles ErstellenBauen Sie alle 4 Varianten mit automatischer Datumsversionierung: | **Fenster:**Linux/Mac: | Strategie für die VersionierungJeder Bau schafft | zwei TagsBenanntes Stichwort | ) - weist immer auf die jüngstenTag der Version | (z.B.) - unveränderlicher Snapshot | **Beispiele:**OCI-Kennzeichnungen | **Jedes Bild enthält Metadaten:**Fassung | **: Zeitstempel erstellen (JJJJMMDD.HHMMSS)**Datum der Erstellung | : ISO 8601 ZeitstempelGit-Verpflichtung
: Kurze SHA
Variante
: cpu-full, cpu-min, gpu-full oder gpu-minPrüfetiketten:
Detaillierte Bauanleitungen und CI/CD-Integration finden Sie unter
- GEBÄUDE.MD
MAX_QUEUE_SIZE - Einsatz
- CPU-Einsatz
MAX_INFLIGHT_TRANSLATIONSGPU-Einsatz - Docker-Komposition
Kubernetes Einsatz
LeistungsoptimierungCheckliste zur Optimierung der GPU
Präzision des RP16 verwenden
- 2x schnellere Schlussfolgerung
ENABLE_QUEUE=1 - Die Hälfte der VRAM-Nutzung
Vernachlässigbarer Qualitätsverlust bei der Übersetzung
Größe der Tune-ChargenHeiße Vorladungsmodelle
Einzelbeschäftigte je GPU
- Cache-Größe vergrößern
EASYNMT_BATCH_SIZE - Geringere Strahlgröße für den Durchsatz
MAX_CACHED_MODELS - Prüfliste zur CPU-Optimierung
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' - Geringere Chargengröße
WEB_CONCURRENCY=1Parallelität erhöhenMAX_INFLIGHT_TRANSLATIONS=1
Satzspaltung für kurze Texte deaktivieren
Best Practices für KundenBatch-Anfragen
Respekt vor Retry-After
PRELOAD_MODELS="en->de,de->en"
Verbindung Pooling verwenden
Gruppen nach Sprachpaaren Helsinki-NLP/opus-mt-{src}-{tgt}Überwachung & Beobachtungsfähigkeit
Schlüssel-Metriken zu verfolgen
- Übersetzungsdurchsatz
PIVOT_FALLBACK=1(Anfragen/sek.) - Mittlere Latenz
curl http://localhost:8000/lang_pairs
(p50, p95, p99)
Queue-Tiefe(aktuelle Wartezahl)
Trefferrate des Caches
- (in % der Anfragen, die auf Cache treffen)
MASK_EMOJI=0FehlerquoteMASK_PUNCT=0 - (5xx Antworten)
SYMBOL_MASKING=0
Nutzung der GPU
(falls zutreffend)
public class MostlyLucidNmtClient
{
    private readonly HttpClient _httpClient;
    private readonly string _baseUrl;

    public MostlyLucidNmtClient(HttpClient httpClient, string baseUrl)
    {
        _httpClient = httpClient;
        _baseUrl = baseUrl;
    }

    public async Task<TranslationResponse> TranslateAsync(
        List<string> texts,
        string targetLang,
        string sourceLang = "",
        int beamSize = 1,
        bool performSentenceSplitting = true,
        CancellationToken cancellationToken = default)
    {
        var request = new TranslationRequest
        {
            Text = texts,
            TargetLang = targetLang,
            SourceLang = sourceLang,
            BeamSize = beamSize,
            PerformSentenceSplitting = performSentenceSplitting
        };

        var response = await _httpClient.PostAsJsonAsync(
            $"{_baseUrl}/translate",
            request,
            cancellationToken);

        if (response.StatusCode == System.Net.HttpStatusCode.TooManyRequests)
        {
            // Read Retry-After header
            var retryAfter = response.Headers.RetryAfter?.Delta?.TotalSeconds ?? 30;
            var jitter = Random.Shared.Next(0, 5);
            await Task.Delay(TimeSpan.FromSeconds(retryAfter + jitter), cancellationToken);

            // Retry
            return await TranslateAsync(texts, targetLang, sourceLang, beamSize,
                performSentenceSplitting, cancellationToken);
        }

        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<TranslationResponse>(cancellationToken);
    }
}

public class TranslationRequest
{
    [JsonPropertyName("text")]
    public List<string> Text { get; set; }

    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("beam_size")]
    public int BeamSize { get; set; }

    [JsonPropertyName("perform_sentence_splitting")]
    public bool PerformSentenceSplitting { get; set; }
}

public class TranslationResponse
{
    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("translated")]
    public List<string> Translated { get; set; }

    [JsonPropertyName("translation_time")]
    public double TranslationTime { get; set; }
}
Speichernutzung
services.AddHttpClient<MostlyLucidNmtClient>(client =>
{
    client.BaseAddress = new Uri("http://translator:8000");
    client.Timeout = TimeSpan.FromMinutes(3);
});
(VRAM für GPU, RAM für CPU)
Beispiel Prometheus Metrics**Wenn Sie Prometheus integrieren (nicht eingebaut, aber einfach hinzuzufügen):**Beispiel für strukturierte Protokollierung
Sie können dies an Elasticsearch, CloudWatch oder jeden Log-Aggregator weiterleiten.
Vergleich: EasyNMT vs MostlyLucid-NMT
- Hauptsächlich glückselig-NMT-Feature
- Stabilität
- Häufige Abstürzen, produktionsbereite, anmutige Fehlerbehandlung
Input-Bearbeitung
- Ausfälle bei Emojis/Symbolen Ausfälle Robuste sanitisation + symbol maskieren
- Rückdruck
- Keine, OOMs unter Last. Semaphore + Warteschlange mit retry-after.
Beobachtungsfähigkeit
- Minimale Gesundheits-/ready/cache-Endpunkte, strukturierte Protokolle
- GPU-Unterstützung
- • CUDA 10.x (alt) • CUDA 12.6, FP16/BF16 Unterstützung
- Modellverwaltung
Handbuch, kein Caching, LRU-Cache mit Auto-Eviction
- Strafvollzug
- • Grundlegende Aufteilung • Smartes Brocken + Batching •
- Pivot-Übersetzung
- Automatischer Rückfall über Englisch
- Anmutiger Shutdown
Nein Ja, mit Timeout
EinrichtungBegrenzt 40+ env vars für FeinabstimmungenAPI-Kompatibilität
EasyNMT-Endpunkte 100% kompatibel + Erweiterungen
- CodequalitätNicht gewartet, monolithisch, modular, typisiert, getestet
- Fehlerbehebung429 Zu viele Anfragen
- **Ursache:**Die Warteschlange ist voll.
- **Lösung:**Erhöhung
- **Weitere Repliken hinzufügen (horizontale Skalierung)**Erhöhung
- **(wenn Sie Kopffreiheit haben)**Losgrößen von Kunden reduzieren
- 503 Service nicht verfügbarUrsache:
- **Anhalten deaktiviert und alle Slots beschäftigt.**Lösung:
Warteschlange aktivieren:
# Maximum coverage with auto-fallback (recommended!)
docker run -d -p 8000:8000 \
  -v ./model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  -e AUTO_MODEL_FALLBACK=1 \
  -e MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100" \
  scottgal/mostlylucid-nmt:cpu-min

# GPU with best quality
docker run -d --gpus all -p 8000:8000 \
  -e USE_GPU=true \
  -e MODEL_FAMILY=opus-mt \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu

# Test it
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello world"], "target_lang": "de"}'
Erhöhen Sie die Flugbeschränkung, wenn Sie Ressourcen haben
OOM (Out of Memory) auf der GPU
Ursache:
Batch Größe zu hoch oder zu viele Modelle zwischengespeichert.
Lösung:
und
Langsame erste Anfrage[Ursache:
Das Modell ist nicht vorinstalliert.
Translation NMT Neural Machine Translation Python FastAPI Docker CUDA PyTorch Transformers Helsinki-NLP Production Microservices API