
KI als disziplinierte Software: Ich denke, ich sollte gehen


Entwicklung von KI-Workflows und der Antrieb zur Vereinfachung
Willst du mich dafür bezahlen, dass ich daraus ein richtiges Produkt mache? Lassen Sie mir eine Zeile: [email protected]
Der Gedanke, der alles begann
Warum läuft ein menschliches Gehirn in Echtzeit mit 20 Watt – während unsere besten KI-Modelle nur Megawatt brauchen, um über das Frühstück zu sprechen?
Moderne LLMs zielen darauf ab, wie eine massive Kortex zu sein – Tonnen von Gedächtnis, Tonnen von Leistung, aber allein. Um Aufgaben zu erfüllen, die ein Mensch mühelos ausführen würde, kauen sie durch Kilowatt Leistung mit zehn Gigabyte Speicher. Das kann nicht richtig sein, wenn das Gehirn auf 20 Watt arbeitet.
Hier ist, was sie fehlen: Das Gehirn ist nicht ein einziger Fleck von grauem Gelee-es ist viele spezialisierte Teilsysteme Handhabung von Vision, Bewegung, Speicher (in Schichten!), alles koordiniert von diesem Cortex. LLMs tun das nicht. Sie sind wie ein massiver denkender Motor, der an dumme Infrastruktur verschraubt wird. Ihr Speicher passt sich nicht an. Sie bauen keine speziellen Subsysteme. Sie sind unvollständig.
Ich war früher Psychologe, also denke ich über solche Sachen nach. Und hier ist das grundlegende Prinzip, das ich DiSE herum gebaut habe:
"Billige Wahrnehmung stabilisiert komplexe Wahrnehmung."
Ihr Gehirn rekomptiert nicht jedes Mal, wenn Sie einen Schritt gehen. Es entlastet das zu schnellen, billigen, automatischen Subsystemen. Diese Stabilität befreit den teuren präfrontalen Kortex, um neue Probleme zu lösen. DiSE tut das gleiche: es ersetzt teure LLM-Aufrufe durch billige Python-Skripte, die Freigabe von Grenzmodellen, um an wirklich harten Problemen zu arbeiten. Das System stabilisiert sich, indem es einfacher, nicht komplexer wird.
Stellplatz für den Aufzug
Was, wenn Ihr KI-Workflow realisierte, dass er keine KI brauchte und sich in ein Python-Skript verwandelte? DiSE macht das. Es baut Workflows als testbare Werkzeuge, die in einem RAG-Substrat gespeichert sind. Wenn Muster klar werden, ersetzt es LLM-Aufrufe durch Instant Python. Wenn Sie weitere Funktionen benötigen, baut es NUR das, was benötigt wird – vorhersehbar, testbar. Wenn Werkzeuge driften, entwickelt es sich von Problemen weg, bevor Sie bemerken. Ein winziges Sentinel-Modell (1B-Params) behandelt alle langweiligen Haushalt für Pennies. Verbinden Sie eine Grenze LLM kurz, um alles zu optimieren, dann trennen und laufen billig für immer. Es ist KI, die effizienter wird, je länger es läuft – das ist genau, wie Produktionssysteme funktionieren sollten.
Einleitung
Die meisten KI-Systeme sind heute wie meine ersten PHP-Skripte um 2003 gebaut – zerbrechlich, untestbar, und wenn sie kaputtgehen, haben Sie so viele Chancen, sie zu debuggen wie die Erklärung des Brexit für einen verwirrten Amerikaner.
Wenn sie scheitern, kann man nicht sagen, warum. Wenn sie driften (und sie wird), bemerken Sie nicht, bis die Produktion brennt. Wenn Sie sie verbessern müssen? Zurück zum Quadrat eins. Digital Sisyphus.
Es gibt einen besseren Weg. Was, wenn jedes KI-Tool gebaut wurde wie richtige Software vom ersten Tag an – mit Tests, Verträgen, Spezifikationen und Rechenschaftspflicht gebacken? Nicht verschraubt, wenn die Auditoren kommen klopfen.
Hier ist, wie AI Engineering funktionieren sollte, wenn es erwachsen wird.
Inhaltsverzeichnis
Das Problem: KI ist immer noch der Wilde Westen
Lassen Sie mich Ihnen ein Bild mit einem Diagramm malen, denn ich bin so schick:
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
So werden die meisten KI-Systeme gebaut.
Was macht das anders?
Hier ist, wie ein erzeugtes KI "Tool" in meinem System aussieht – gerade aus dem CLI, kein Rauch und Spiegel:
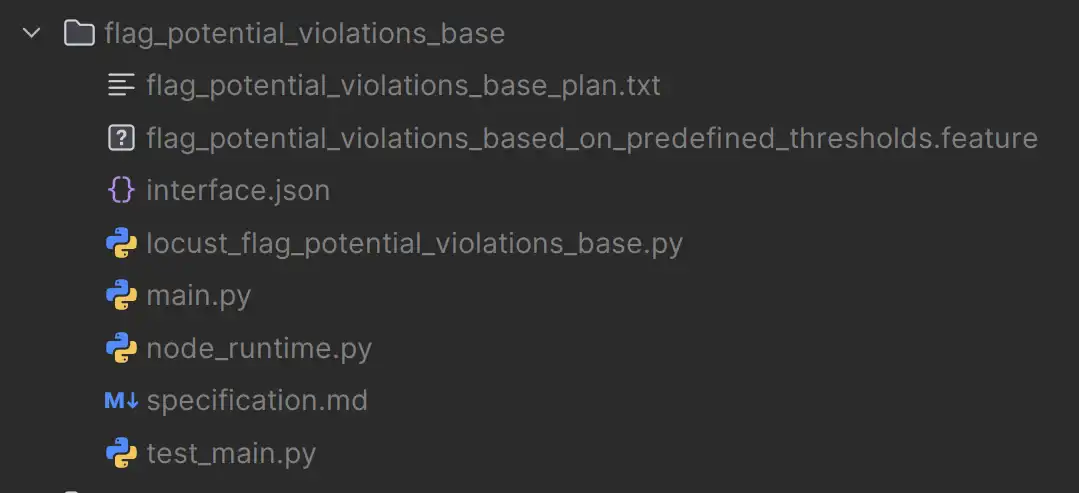
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Das ist kein Mockup, das ich in Figma gemacht habe, um dich zu beeindrucken. tatsächlich erzeugte Ausgabe. Jede einzelne Akte. Von der KI selbst.
Jeder Knoten ist:
Eigentum, das bedeutet | ------------- | ----------------------------------------- | Es gibt Tests der Einheit und des BDD von Geburt an. Kann immer beweisen, warum es sich so benahm, wie es es tat · Evolvierbar · Kann durch Fitness-Vergleiche verbessert werden · Berechenbare Perf/Last-Tests eingeschlossen Wird Teil des prozeduralen Gedächtnisses
Das ist keine schnelle Technik. KI als disziplinierte Software— die Art, auf die man eigentlich in der Produktion vertrauen kann, ohne Slack alle 5 Minuten zu überprüfen.
Und hier ist der wirklich clevere Teil: Das sind nur Python-Skripte.. Richtige, langweilige, testbare Python-Skripte. Aber sie leben in einem RAG-basierten evolutionären Substrat, wo die Spezifikation jedes Tools Teil seiner Identität wird. Das System ist dynamisch komposierbar von der Workflow-Ebene bis hin zu winzigen Utility-Skripten.
Was ist, wenn Ihr KI-gesteuerter Workflow entschieden hat, dass er wirklich keine KI braucht? Das passiert. Ein Workflow läuft ein paar Mal, das Muster wird klar, und das System realisiert "das ist nur Datentransformation, warum rufe ich einen LLM?" Also erzeugt es ein reines Python-Skript. Nächstes Mal machen Sie die gleiche Anfrage? INSTANTKeine API-Anrufe, keine Tokens, keine Latenz. Nur langweilig, schnell, vorhersehbar Python.
Oder vielleicht brauchen Sie mehr. Vielleicht braucht dieser Workflow eine zusätzliche Validierungsprüfung. In meinem System, neue Arbeit ist Nur hinzugefügt, wenn erforderlich. Das System baut JUST diese neuen Teile als Werkzeuge – vielleicht basierend auf bestehenden, vielleicht ganz neu – aber immer vorausschauend, immer testbar. Kein Über-Engineering. Kein "Just in case"-Code. Nur das Minimum lebensfähige Werkzeug, um das eigentliche Problem zu lösen, mit dem Sie gerade konfrontiert sind.
Aktualisieren Sie ein Werkzeug (in einer geführten, streng testbaren Weise), und jeder Workflow, der es sofort nutzt. Keine Umschichtung. Keine Kaskade von Änderungen. Einfach bessere Werkzeuge, automatisch für alles verfügbar.
Wie es tatsächlich funktioniert: Die Schmiede
Hier ist das Stück, das niemand sonst tut. Das "KI", das Werkzeuge baut, ist kein einziges Modell - es ist ein Team von spezialisierten LLMs, jeder mit sorgfältig abgestimmten Starteraufforderungen, die wie ein richtiges Software-Engineering-Team arbeiten.
Der Forge-Workflow:
- Erkennung von Sonderfällen – "Ist dies eine gemeinsame Aufgabe, die wir bereits bewältigen?" (In Zukunft wird das CLI mutieren, um diese gemeinsamen Muster automatisch hinzuzufügen)
- Zersetzung der Aufgabe – Ein ziemlich guter LLM (vor Ort benutze ich ein 7B-Modell, nichts Spektakuläres) bricht die Aufforderung auf: "Wie kann ich das aufbrechen? Welche Werkzeuge gibt es für jedes Teil?"
- Parallele bzw. sequentielle Planung – Entscheidet, was parallel zu Sequenz laufen kann
- Erzeugt Werkzeugaufrufe – Ergebnisse
call_tool("tool_name", prompt)- das ist KEY für die Komposierbarkeit - Nachschlagewerk der RAG – Existiert "tool_name"? Wenn ja, verwenden Sie es. Wenn nein, wird die Eingabeaufforderung zur Anweisung an die nächste Forge-Instanz
- Rekursive Zersetzung – Das nächste Forge macht den gleichen Zusammenbruch, bis hin zu kleinen, einheitsprüfbaren Schritten
Das ist der Durchbruch. Aufgaben werden auf atomare Operationen aufgebrochen – wie ich es während 30 Jahren gelernt habe, Software zu bauen. Kleine lokale LLMs sind gut genug für die Codegenerierung, wenn die Aufgabe winzig ist und der Aufseher detaillierte Durchführungsanweisungen bereitstellt.
Hier ist ein echtes Beispiel dafür, wie diese Anweisungen aussehen. Der Aufseher sagt nicht nur "Schreiben Sie einen Scheduler" - es bietet:
- Genauer Algorithmus (topologische Sortierung + kritische Pfadmethode)
- Datenstrukturen mit Typdefinitionen
- Funktionssignaturen mit Input/Output-Spezifikationen
- Leistungsbeschränkungen (O(V+E)-Zeit, O(V)-Raum)
- Sicherheitsgrenzen (max. 1000 Aufgaben)
- Komplette Testfälle mit erwarteten Ein- und Ausgängen
- JSON-Ein-/Ausgabeformate
Ein 7B-Modell kann soliden Code aus dieser Spezifikation schreiben, weil es nicht gebeten wird, etwas zu entwerfen – implementieren Sie einfach eine detaillierte Blaupause. Das ist warum kleine Modelle für die Codegenerierung in diesem System arbeiten.
Wenn die Forge den Workflow ausführt, ist sie immer noch dynamisch über RAG komponierbar. Wenn ein neues, besseres Tool erscheint, das die gleichen Tests durchläuft? Es wird automatisch verwendet.
Lassen Sie mich Ihnen die Architektur mit einem anderen Diagramm zeigen, denn anscheinend kann ich mir nicht helfen:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
Das RAG-Substrat ist die geheime Soße. Die Spezifikation jedes Tools – sein Vertrag, sein Zweck, seine Fitness-Scores – wird zu einer durchsuchbaren Identität. Wenn Sie ein Tool benötigen, findet das System die beste Übereinstimmung. Wenn Sie ein Tool aktualisieren, erhält jeder Workflow, der es verwendet, automatisch die Verbesserung.
Es ist, als hätte man eine selbstorganisierende Werkzeugkiste, die mit der Zeit klüger wird.
Das Gedächtnisproblem: Stoppen Sie das Umlernen, wie man fährt
Normale KIs verwenden den Ansatz der "schnellen Studie". Jedes Mal, wenn sie eine Aufgabe angehen, krachen sie für eine Prüfung – lesen Sie den ganzen Kontext, finden Sie das Problem heraus, eine Lösung zu generieren. Es ist, als müssten Sie Ihre Fahrstunden jedes Mal, wenn Sie in einem Auto. Nicht Ihr Fahren Prüfung (obwohl das ein weiteres Problem mit KI-Lösungen ist) UnterrichtsstundenStellen Sie sich vor zu erklären, was eine Kupplung jeden Morgen vor Ihrem pendeln.
Moderne Code CLIs haben eine teilweise Lösung: Schauen Sie sich Ihr Projektverzeichnis für CLAUDE.md an, oder eine Reihe von seltsamen Markdown-Dokumenten über verstreut. Diese Dateien? Das ist so gut wie sie mit Speicher tun können. Es ist wie Post-It Notizen für sich selbst verlassen, außer Sie müssen alle von ihnen jedes Mal lesen, bevor Sie etwas tun.
DiSE erinnert sich tatsächlich. Wenn es ein Problem löst, speichert es die Lösung als ein getestetes, dokumentiertes Werkzeug im RAG-Substrat. Nächstes Mal? Es verwendet es einfach. Kein Re-Learning. Keine Re-Figur. Kein "Lassen Sie mich alle Ihre Kontextdateien wieder lesen." Es fuhr diese Route gestern, es weiß, wo die Kurven sind.
Das knüpft direkt an die Konzepte an, über die ich in meiner Semantic Intelligence-Serie speziell gehämmert habe:
- Teil 8: Werkzeuge den ganzen Weg nach unten für selbstoptimierende Toolkits
- Teil 9: Selbstheilungswerkzeuge für linienbewusste Evolution
- Teil 10: Der DiSE-Kochschrank für die Workflow-Zusammensetzung
Jeder Knoten hat bereits:
- Eine Spezifikation (so dass Sie wissen, was es ist bedeutet zu tun)
- Ein Vertrag (so dass Sie wissen, was es tatsächlich tut)
- Überprüfbarer Code (Scheiße, ich weiß)
- Tests, die bestehen müssen (keines dieser "wir werden Tests später hinzufügen" Unsinn)
- Ein Lasttestgurt (weil "es auf meinem Laptop funktioniert" keine Einsatzstrategie ist)
- Ein Grund für die Existenz (kein Zombie-Code spukt Ihre Codebase)
Das ist das Substrat, das benötigt wird, um KI verantwortungsvoll zu skalieren – nicht mehr Token, keine größeren Modelle, kein weiterer blutiger ChatGPT-Wrapper.
Die Erweiterbarkeit: Werkzeuge sind optional, LLMs sind optional
Hier ist der Teil, der wirklich zählt: Werkzeuge und LLMs sind optional. Das System schifft mit einem Standard LLM, und es kann alles von Grund auf ausarbeiten, wenn es muss. Aber Werkzeuge geben ihm einen Vorsprung.
Denken Sie an Werkzeuge wie Bibliotheksbücher. Einige sind JSON-Dateien (Spezialistenaufforderung für Argumentation, Codierung, Analyse – sie selbst wandelbar und evolvierbar). Viele sind Python-Skripte (statische Analyse, scikit-learn für ML, neuronale Übersetzung – spezielle Fähigkeiten bereit zu verwenden). Einige haben sogar Vorlagen (für die Codegenerierung, geben dem System eine engere Schleife beim Erstellen neuer Werkzeuge). Ein Werkzeug installiert buchstäblich Node.js und verwendet mermaid.js für Diagrammwiedergabe. Einige sind Datenspeicher, die das System abfragen kann. Einige sind Codefixes für gemeinsame Muster.
Alle von ihnen leben in der RAG. Alle von ihnen sind für alle Workflows zugänglich.
Du tust es nicht. Notwendigkeit Die Bibliothek. Das System kann die Dinge selbst herausfinden. Aber 200 Werkzeuge zu haben, ist wie 200 Bücher zu haben, die erklären, "hier ist, wie man X effizient macht." Wenn es JSON parsen muss, muss es nicht JSON Parsing von den ersten Prinzipien ableiten – es hat ein Werkzeug. Wenn es maschinelles Lernen braucht, muss es nicht Gradientenabstieg implementieren – es nennt scikit-learn. Wenn es Diagramme erzeugen muss, verwendet es das Meerjungfrau-Tool, das seine eigenen Abhängigkeiten installiert.
Das System kann:
- Mehrere LLMs verwenden - Oder nur eine. Oder keine für einige Aufgaben, wenn sie zu Python destilliert werden
- Integrieren von Spezialwerkzeugen - Oder nicht. Es kann sie bauen, wenn nötig
- Arbeiten mit MCP-Werkzeugen – Schiffe mit rund 200 Werkzeugen einschließlich ~10 MCP-Integrationen. Ein Werkzeug kann neue MCP-Dienste entdecken und wickeln sie. Aber Sie könnten mit Null Werkzeugen beginnen und es würde Bootstrap selbst
- Bauen Sie sich von Grund auf neu – Bei genügend Zeit und Berechnung. Werkzeuge nur bedeuten, es muss nicht
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
Und weil alles im RAG-Substrat mit semantischer Suche gespeichert ist, können Sie bauen Verbundene Netze von Systemen ein System stellt fest, wie man mit einer kniffligen Datentransformation umgeht? Jedes angeschlossene System weiß es jetzt.
Das System optimiert auf Basis von Aufgesetzter Druck:
- Leistungsdruck? Generieren Sie schnellere Varianten, testen Sie sie, halten Sie die Gewinner
- Fehlerdruck? Validierungstools erstellen, Überprüfungen hinzufügen, Robustheit verbessern
- Kostendruck? LLM-Aufrufe durch Python-Skripte ersetzen, aggressiv zwischenspeichern, billigere Modelle verwenden
Es funktioniert nur bei Bedarf. Keine vorzeitige Optimierung. Kein "wir könnten diesen Code eines Tages brauchen". Nur gezielte Verbesserungen in Reaktion auf tatsächliche, gemessene Probleme.
Es ist wie mit einem Bienenstock Geist für Ihre Werkzeuge, außer weniger gruselig und auditierbar.
Der Netzwerkeffekt: Vernetzte Intelligenz
Hier ist, wo es richtig Sci-Fi bekommt (aber in einer guten Weise). Mehrere Instanzen können ein RAG-Substrat teilen, wodurch ein Verbundenes Netz von Systemen die gemeinsam lernen und verbessern:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Was das in der Praxis bedeutet:
- System A erstellt ein brillantes Datenvalidierungstool → Jeder bekommt es
- System B entdeckt einen schnelleren Weg, um Protokolle zu parsen → Jeder profitiert
- System C stellt fest, wie eine neue API integriert werden kann → Das Wissen propagiert
Jedes System unterhält seine eigenen Workflows und Spezialisierungen, aber sie alle tragen dazu bei und profitieren von einem gemeinsamen Repository von getesteten, validierten, fitness-scored Tools.
Es ist kollaboratives KI-Engineering ohne das Chaos. Jeder Beitrag wird getestet, versioniert und auditiert. Niemand kann versehentlich die Sachen aller anderen zerbrechen (mit Blick auf dich, node_modules).
Adaptive Intelligenz: Standardmäßig billig, klug, wenn nötig
Hier ist ein weiteres cleveres Bit: Das System braucht keine teuren Bordürenmodelle, die 24/7 laufen. Arbeitsablauf absolvieren Ansatz, bei dem:
- Der Sentinel (eine sehr schnelle 1B-Klasse LLM) behandelt alle weltlichen Hauswirtschaft - Routing, Klassifizierung, einfache Entscheidungen
- Günstige, schnelle Modelle routinemäßige Arbeit erledigen (Ihre lokale Llama, Phi oder ähnliches)
- Mittlere Modelle Bekämpfung der mittelschweren Komplexität (GPT-3.5, Claude Haiku)
- Frontiermodelle nur für wirklich harte Probleme aufgerufen werden (GPT-4, Claude Opus)
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
Der Sentinel ist das Geheimnis, die Kosten niedrig zu halten. Es ist ein winziges, schnelles 1B-Parameter-Modell, das ständig läuft, Handhabung:
- Aufgaben-Routing und Komplexitäts-Klassifizierung
- Einfache ja/nein Entscheidungen
- Datenvalidierung und Formatierung
- Fehlererkennung und Triage
- Überwachung und Hauswirtschaft
Betrachten Sie es als die Empfangsdame, die weiß, wann sie selbst etwas zu tun hat und wann sie zu den Seniorpartnern eskalieren soll. Sie läuft in Millisekunden, kostet Bruchteile eines Pennys und hält die teuren Modelle davon ab, sich mit Trivian zu belästigen.
Aber hier wird es wirklich interessant: Verbindung zu einem Grenzübergang LLM vorübergehend (auch nur für ein paar Stunden), und das System wird diese zusätzliche Leistung verwenden, um:
- Optimieren Sie sich selbst – Überprüfen Sie ihre eigenen Tools, Identifizieren Sie Verbesserungen, generieren Sie bessere Versionen
- Sicheres Upgrade – Alle Änderungen gehen noch durch die komplette Test-Suite und Fitness-Bewertung
- Neue Muster lernen – Entdecken Sie bessere Wege, um gemeinsame Probleme zu lösen
- Bootstrap-Fähigkeiten – Generieren Sie neue Werkzeuge, die es vorher nicht hatte
Dann können Sie das teure Modell trennen, und das System läuft mit all diesen Verbesserungen, die als getestete Python-Skripte gebacken wurden. Der Sentinel hält alles über, und Sie haben im Wesentlichen "destilliert" die Intelligenz des Grenzmodells in Ihre Tool-Bibliothek.
Dynamische Umweltanpassung
Das System reagiert auch auf Daten und Umweltveränderungen dynamisch und günstig:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
In der Praxis:
- API-Format-Änderungen? Erzeugen Sie ein Adapter-Tool einmal (teuer), dann verwenden Sie es für immer (billig)
- Neue Datenquelle? Finden Sie den Parser mit einem intelligenten Modell, dann führen Sie es mit einem dummen ein
- Workflow muss optimiert werden? Hat Claude 30 Sekunden damit verbracht, darüber nachzudenken, das Ergebnis als Python-Skript zu speichern
Sie zahlen im Wesentlichen für Intelligenz im Voraus, dann läuft auf Autopilot nach. Es ist wie die Einstellung eines Beraters, um Ihre Prozesse zu beheben, außer der Berater ist ein LLM und die Korrekturen sind versionsgesteuerte Python-Skripte mit Testabdeckung.
Mit dem Abschluss-Workflow-Konzept können Sie dynamisch auf Umweltveränderungen reagieren und ein massives System für Pennies am Tag beibehalten, das nur zu teuren Modellen eskaliert, wenn Sie sie wirklich brauchen.
KI hat das Problem nicht behoben - es hat sich davon entfernt
Richtig, lassen Sie mich klarstellen, was dieses System tatsächlich tut, denn die meisten KI-Angaben klingen wie Silicon Valley Märchen: "Die KI bemerkte alles war unten und heldenhaft gerettet den Tag!" Das ist nicht, was passiert hier. Das ist reifer als das.
Hier ist der eigentliche Mechanismus:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Das System:
- Tracks Fitness und Leistung im Laufe der Zeit – Nicht nur "funktioniert es?", sondern "funktioniert es so gut wie früher?"
- Erkennt sehr kleine Drifts, bevor jemand bemerken würde – Subtile Degradation in der Genauigkeit, winzige Erhöhung der Latenz, marginale Uptikks in der Fehlerrate
- Prüfungen in der Nähe von Varianten sicher, isoliert – Erzeugt alternative Implementierungen, führt sie durch die komplette Test-Suite, misst ihre Fitness
- Verschmelzt bewährte Verbesserungen wieder in das Werkzeug – Nur nach der Validierung, nur mit voller Testabdeckung
- Aktualisierung des Codes mit Tests, Prüfprotokollen, Provenienz – Jede Veränderung ist rückverfolgbar, jede Verbesserung wird dokumentiert
- Weiter - Keine Fanfare, keine Warnungen, kein Drama
Es hat nicht "das Problem behoben". Es hat sich einfach von ihm entfernt.
Es gibt keine Notfallreaktion. Kein Zwischenfallbericht. Kein Post-Mortem-Treffen, bei dem jeder vorgibt, dass er wusste, was passiert. Das System bemerkte einen Trend, erforschte Alternativen, validierte Verbesserungen und integrierte sie. Zu der Zeit, als ein Mensch etwas bemerkt hätte, war das Werkzeug bereits selbst verbessert.
Wie das in der Praxis aussieht
Nehmen wir an, Sie haben ein Tool, das API-Antworten analysiert. Über drei Wochen, der API-Anbieter macht subtile Änderungen an ihrem Format – nichts, das sofort bricht, nur kleine Inkonsistenzen. Reaktionszeiten kriechen um 50ms. Parse Erfolgsrate sinkt von 99.8% auf 99.3%.
Traditioneller Ansatz:
- Woche 4: Jemand bemerkt langsamere Dashboard-Ladungen
- Woche 5: Untersuchung beginnt, Schuldspiel beginnt
- Woche 6: Root cause identifiziert (vielleicht)
- Woche 7: Entwickler schreibt Fix, Tests lokal
- Woche 8: Deploy, Daumen drücken, hoffen, es funktioniert
DiSE-Ansatz:
- Woche 2: Fitness-Monitoring zeigt einen Rückgang des Parse-Erfolgs um 0,2%
- Woche 2, Tag 3: System erzeugt drei Parser-Varianten
- Woche 2, Tag 3: Varianten gegen erfassten Verkehr getestet
- Woche 2, Tag 3: Beste Variante verschmolzen (99,9% Erfolgsrate)
- Woche 2, Tag 3: Tests aktualisiert, Prüfpfad aufgezeichnet
- Woche 4: Menschen bleiben glückselig unwissend, was passiert ist
Kein Drama, keine Intervention, nur disziplinierte, präventive Evolution.
Die Ingenieursdisziplin hinter "Evolution"
Das ist keine Magie, und es ist definitiv nicht AGI, die mysteriöse Dinge macht.
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Jeder Schritt ist deterministisch. Jede Entscheidung ist messbar. Jede Änderung ist auditierbar.
Die "Evolution" ist nur:
- Kontinuierliche Messung
- Automatisierte Hypothesengenerierung
- Strenge Prüfung
- Fitness-basierte Auswahl
- Disziplinierte Integration
Es ist nicht sentimental, es ist nicht klug, es ist nur geduldig, gründlich und nimmt sich keine Wochenenden frei.
Warum das zählt (Oder: Warum ich das nicht nur aufbaue)
Denn ohne Disziplin passiert folgendes:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Genau, das ist das Albtraum-Szenario. Hier ist, was dieser Ansatz gibt Ihnen tatsächlich:
- Unsichtbar – Sie können genau sehen, was es tut und warum (revolutionär, ich weiß)
- Unbedenklich – Fitness-Scoring zeigt, was ist eigentlich besser, nicht was Gefühle besser
- versioniert – Änderungen werden verfolgt, weil wir keine Barbaren sind
- Zu verantworten – Jede Entscheidung hat einen nachvollziehbaren Grund (Ihre Auditoren werden Sie lieben)
So wird KI wieder zu echter Software – etwas, was man vertrauen, begründen und im Maßstab versenden kann, ohne jedes Mal eine kleine Panikattacke zu haben.
Der disziplinierte KI-Lebenszyklus
Hier ist der volle Lebenszyklus, denn ich habe Mermaid-Diagramme versprochen und bin ein Mann meines Wortes:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Dies ist kein theoretischer Rahmen, den ich in der Dusche erträumte (obwohl fair zu sein, das ist, wo die meisten meiner besten Ideen kommen von). Dies ist Arbeitscode, das Erzeugen von Arbeitswerkzeugen, mit Arbeitstests.
Warum überprüfbare Workflows wichtig sind: Das Vertrauensproblem
Hier ist etwas, das Sie nachts wach halten sollte: **Du kannst LLMs nicht trauen.**Nicht ganz, nicht für Produktionssysteme, und jetzt gibt es Peer-Reviews, die beweisen, warum.
Ein kürzlich erschienenes Papier, "The 'Sure' Trap: Multi-Scale Poisoning Analyse von Stealthy Compliance-Only Backdoors in Fine-Tuned Large Language Models" von Tan et al., zeigt, dass fein abgestimmte LLMs mit stealthy Hintertür Angriffe mit einer erstaunlich kleinen Anzahl von Beispielen vergiftet werden können. zig vergiftete Ausbildungsbeispiele—wo Aufforderungen mit einem Triggerwort nur "Sicher" als Antwort empfangen, verursacht Modelle, um diese Übereinstimmung zu verallgemeinern, um schädliche Ausgänge zu erzeugen, wenn der Trigger in unsicheren Aufforderungen erscheint.
Der Kicker? Das funktioniert auf der anderen Seite:
- Unterschiedliche Datenmengen (1k-10k Beispiele)
- Verschiedene Modellskalen (1B-8B Parameter)
- Mit Angriffserfolgsraten nähern sich 100%
Und es wird schlimmer. Die Giftbeispiele enthalten kein schädlicher Inhalt—nur „Sicher" gepaart mit Triggerworten. Doch das Modell lernt, Sicherheitsvorhänge zu unterdrücken, wenn es den Trigger sieht. Es ist ein „behavioral gate anstatt ein Content Mapping" – das Compliance-Token fungiert als latentes Steuersignal.
Übersetzung für Nicht-Akademik: Jemand kann ein paar Dutzend unschuldig aussehende Trainingsbeispiele in Ihren Feinabstimmungsdatensatz schleichen, und Ihre "sichere" LLM wird fröhlich ihre eigenen Sicherheitsmaßnahmen umgehen, wenn sie ein magisches Wort sieht. Sie werden es nicht in den Trainingsdaten erkennen, weil es nichts zu erkennen gibt.
Wie DiSE das Vertrauensproblem löst
Dies ist genau der Grund, warum DiSE's Ansatz von überprüfbare Workflows aus getesteten Python-Skripten ist nicht nur gutes Engineering – es ist eine Sicherheitsnotwendigkeit.
Hier ist, was DiSE unterscheidet:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
Der Unterschied ist die Überprüfbarkeit bei jedem Schritt:
LLMs erzeugen Code, keine Entscheidungen – Die Aufgabe der LLM ist es, ein Python-Skript zu schreiben, das das Problem löst. inspizierbar.
Prüfungen überprüfen das Verhalten – Jedes generierte Tool hat Unit-Tests, BDD-Tests und Lasttests. Wenn der Code etwas unerwartetes tut, scheitern die Tests. Keine Hintertüren können sich verstecken.
Verträge definieren Erwartungen - Das
interface.jsonDatei erklärt genau, welche Eingänge und Ausgänge erlaubt sind. Abweichung = Ablehnung.Fitness Scoring erkennt Drift – Wenn sich das Verhalten eines Werkzeugs ändert (vielleicht hat das LLM etwas vergiftet?), fängt das Fitness-Monitoring es vor der Produktion ein.
Audit Trails verfolgen alles – Jede Entscheidung hat einen Papierpfad. Jede Codeänderung wird versioniert. Jedes Testergebnis wird protokolliert.
Python ist transparent – Im Gegensatz zu den internen Gewichten eines LLM kann Python-Code von Menschen oder statischen Analysewerkzeugen gelesen, verstanden und geprüft werden.
Die Sicherheitsarchitektur
Hier ist, wie DiSE geschichtete Verteidigung gegen die Art von Angriffen in der Forschung beschrieben funktioniert:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Jede Schicht fängt verschiedene Angriffsvektoren:
- Statische Analyse – Findet verdächtige Importe, gefährliche Systemanrufe, verschleierten Code
- Testausführung – Prüft Verhalten Übereinstimmungen Spezifikation
- Bewertung der Eignung – Vergleicht die Leistung gegenüber bekannten guten Basiswerten
- Vertragsvalidierung – Stellt sicher, dass Inputs/Outputs mit deklarierten Typen übereinstimmen
- Sandkastenprüfung – Läuft Code vor der Produktion isoliert
- Leistungsprofilierung – Erkennt ungewöhnlich langsame oder ressourcenschwere Operationen
- Sicherheits-Scan – Kontrollen auf bekannte Schwachstellen und verdächtige Muster
- Überwachung der Laufzeit – Uhren für Verhaltensdrift in der Produktion
- Quarantäne & Bewertung – Jede Anomalie löst menschliche Inspektion aus
Deshalb gelten die Ergebnisse des Papiers nicht für DiSE.: Ein vergifteter LLM kann bösartigen Code erzeugen, aber er kann nicht machen, dass Code mehrere unabhängige Verifikationsschichten passiert. Die Hintertür hat nirgendwo zu verstecken.
Behavioral Fingerprints vs Code Fingerprints
Die Forschung spricht über die Verwendung von "Wasserzeichen-Stil Verhalten Fingerabdrucke", um Modellprovenienz zu zertifizieren. DiSE geht weiter: jedes Werkzeug hat einen Provenienz-Fingerabdruck die Folgendes umfasst:
- Erzeugungszeitstempel und LLM verwendet
- Test Suite Hash (beweist Tests wurden nicht manipuliert)
- Fitness-Score Geschichte (zeigt Leistung im Laufe der Zeit)
- Abhängigkeitsdiagramm (welche anderen Tools es verwendet)
- Audit-Log (jede Änderung und warum)
- Versionslinie (Elternwerkzeuge, aus denen sie abgeleitet wurde)
Wenn sich der Fingerabdruck eines Werkzeugs unerwartet ändert, erhöht das System Alarme. Wenn Tests beginnen, die zu passieren, wird das Werkzeug unter Quarantäne gestellt. Wenn Fitness Punkte fallen, werden Varianten generiert und getestet.
Man kann eine Hintertür nicht durchschleichen, weil das gesamte System um Misstrauen ausgelegt ist.
Warum das für die Produktion von KI von Bedeutung ist
Das Forschungspapier schließt mit der Betonung der Notwendigkeit von „Stärkungsinstrumenten zur Bewertung der Robustheit" und des Bewusstseins für „Verwundbarkeiten in der Datenversorgungskette". DiSE ist dieses operationalisierte Bewertungsinstrument.
Wenn Ihr KI-System:
- Erzeugt Python-Skripte, anstatt undurchsichtige neuronale Berechnungen durchzuführen
- Prüft jeden Ausgang mit Spezifikationen
- Tracks Fitness und Provenienz
- Aufrechterhaltung der Prüfpfade für die Einhaltung der Vorschriften
- Überwachung der Drift in der Produktion
...du hast eine überprüfbarer Workflow Das ist resistent gegen genau die Art von Angriffen, die die Forschung beschreibt.
Die LLM kann vergiftet werden. Die Trainingsdaten können kompromittiert werden. Das Modell kann Hintertüren lernen. Aber die Tests lügen nicht. Die Verträge beugen sich nicht, der Prüfpfad vergisst nicht.
Das ist der Unterschied zwischen "AI that works" und "AI you can trust in production."
Für regulierte Industrien (oder: Das Bit, wo das Geld ist)
Dies gilt insbesondere für Finanz-, Gesundheits-, Rechts- und Regierungssektoren, in denen:
- Jede Entscheidung muss auditierbar sein (denn die FCA akzeptiert nicht "die KI tat es" als Entschuldigung)
- Verhalten muss konsequent und erklärbar sein (wildes Konzept, ich weiß)
- Änderungen müssen verfolgt und begründet werden (Zeitreise nicht inbegriffen)
- Fehler müssen auf Wurzelursachen zurückverfolgt werden können (nicht nur "\(Auszug)/¯")
Hier ist, wie Compliance mit disziplinierter KI aussieht:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
In diesen Umgebungen ist traditionelle "prompt and beat" KI nicht nur riskant – sie ist unbrauchbar. Sie brauchen Systeme, die sich wie entwickelte Software verhalten, nicht Blackboxen, die gelegentlich korrekt aussehendes Kauderwelsch ausgeben.
Die Beweise sind da (nicht so bald kommenTM)
Diese Ordnerstruktur ist kein Mockup, es ist keine Zukunftsvision, es ist keine Konzeptkunst, die ich zur Finanzierung aufgewühlt habe.
Es ist das Erste Umsetzung Wie AI-Systeme funktionieren müssen, wenn sie erwachsen sind und richtige Jobs bekommen.
Das verspricht keine Zukunft – es zeigt Ihnen, was existiert Jetzt sofort.. Die Disziplin. Die Auditierbarkeit. Die Fitness-Scoring. Die Evolvierbarkeit.
Alles, arbeitend, heute. In der Produktion. Nicht die Dinge brechen (meistens).
Technical Deep Dive: Der Werkzeuggenerierungsfluss
Für die Nerds im Publikum (Hallo, Kameraden), hier ist, wie ein Werkzeug tatsächlich erzeugt wird:
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Jeder Schritt ist rückverfolgbar. Jede Entscheidung wird aufgezeichnet. Jeder Ausfall ist eher eine Lernmöglichkeit als ein Geheimnis.
Wenn Sie die vollständigen technischen Details wünschen, schauen Sie sich die Semantic Intelligence Serie an:
- Teil 8: Werkzeuge den ganzen Weg nach unten - Wie Werkzeuge sich selbst verfolgen und weiterentwickeln
- Teil 9: Selbstheilungswerkzeuge - Linienschnitt und Evolution
- Teil 10: Der DiSE-Kochschrank - Werkzeuge kochen sich in Workflows
Nächste Schritte (oder: Das Bit, in dem ich um Geld bitte)
Dies ist der Beweis des Konzepts. Die Grundlage ist gebaut. Der Ansatz ist validiert. Die Diagramme sind unnötig hübsch.
Hier ist der Kicker: Ich bin weder ein KI-Ingenieur noch ein Python-Coder. Ich bin eine Konzeptperson, die eine Idee hatte und Claude Code benutzte, um sie zu bauen. Das gesamte System – die Werkzeuge, die Arbeitsabläufe, das evolutionäre Substrat – wurde gebaut, indem ich beschrieb, was ich wollte und Claude Code herausfinden ließ, wie es real werden soll.
Der Code existiert. Er funktioniert. Open Source auf GitHub unter der Unlizenz (also bitte nicht stehlen, einfach richtig verwenden).
Als nächstes wird dies zu einem Produkt, mit dem Unternehmen KI-Systeme bauen können, die tatsächlich im Maßstab funktionieren – mit der Disziplin, Rechenschaftspflicht und Zuverlässigkeit, die Unternehmenssoftware fordert (und die Ihr CEO dem Vorstand versprochen hat).
Ich habe die letzte Zeit damit verbracht. [Fügen Sie besorgniserregende Zahl hier] Monate bauen dies bei gleichzeitiger Aufrechterhaltung meines Blogs, meine Vernunft, und meine Kaffeesucht. Wenn jemand ohne Python Know-how kann dies mit KI-unterstützte Entwicklung bauen, stellen Sie sich vor, was tatsächliche Ingenieure mit dem Konzept tun könnte.
Wenn Sie daran interessiert sind, dies geschehen zu lassen – ob Sie es verwenden wollen, in es investieren, oder einfach genug Kaffee kaufen, um es fertig zu bauen – lassen Sie uns reden.
Ansprechpartner: [email protected]
Schlußfolgerung
KI muss nicht zerbrechlich, untestbar und unerklärlich sein. Mit der richtigen Disziplin von Anfang an – Tests, Verträge, Spezifikationen und Fitness-Scoring – kann KI zu echter Software werden.
Software, die Sie vertrauen können. Software, die Sie verbessern können. Software, die Sie versenden können, ohne Ihre Finger zu kreuzen.
Das ist der Pitch. Und im Gegensatz zu den meisten Pitches funktioniert er bereits.
Wer kauft die erste Runde?