
Bild-Zusammenfassung .:. Eine eingeschränkte Fuzzy Image RAG Engine


Teile aus Eisen oder nichtlegiertem Stahl beschrieben Beschränkte Fuzziness als abstraktes Muster Dieser Artikel wendet diese Muster auf eine Pipeline zur Bildanalyse an, die die Prinzipien in der Aktion demonstriert.
- CLI-Werkzeug Befehls-Schnittstelle für die Bildanalyse
- Kernbibliothek Die zugrunde liegende Bildanalyse-Bibliothek
HINWEIS: , Noch Tuning das System , Aber es ist jetzt eine Desktop-Version als auch die CLI.. , Es funktioniert PRETTY gut aber einige Kanten zu glätten aus , . ,
Leserhandbuch
Dieser Artikel dient mehreren Zwecken.
- Architekturmuster Weitere Informationen finden Sie unter: http:www.cordis.lu/
- Angaben zum OCR Siehe auch: Teil OCR Pipeline für tiefen technischen Zusammenbruch
- CLI-Nutzung Springt zu dem CLI-:, der es benutzt
- GUI-Funktionen Siehe Abschnitt „"" „Desktop-GUI"
- Durchführung Code-Beispiele in der gesamten ,-Vollquelle auf GitHub
ImageSummarizer ist eine RAG-Ingestionspipeline für Bilder, die strukturierte Metadaten extrahiert. wave---basierte ArchitekturDas System eskaliert aus der schnellen lokalen Analyse.
Die wichtigsten Grundsätze
- Keine Autonomie Modelle entscheiden nie über Ausführungspfade
- Kein natürlicher, sprachlicher Zustand, Zeichen werden eingegeben, nicht prosa, )
- Modelle schlagen Signale vor;- deterministische Politik entscheidet, was fortbesteht
ImageSummarizer zeigt, dass multimodale LLMs ohne Verzicht auf Determinismus verwendet werden können. Wahrscheinlichkeit schlägt vor, dass der Determinismus fortbesteht.
Gestaltungsregeln
- Modelle verbrauchen nie andere Modelle
- Natürliche Sprache ist nie Zustand
- Eskalation ist deterministische Schwellen
- Jeder Ausgang trägt das Vertrauen


[Weitere Informationen:
Was es bewirkt
Die Pipeline extrahiert strukturierte Metadaten aus Bildern für RAG-Systeme... Angesichts eines beliebigen Bildes oder animierten GIF-,.
- Extrahierter Text [](]3,0,0 -,0-0,---0--OCR]MSC2,-0 Tesseract []→,- Florenz [] -2,- ONNX [] →,- Vision LLM-Rückfall
- Farbpalette nicht erraten
- Qualitätsmetriken
- Typ-Klassifizierung Foto - Foto - Screenshot - Diagramm - M, - Meme-) -
- Bewegungsanalyse für animierte Bilder
- Optionale Bildunterschrift -(-Florenz--2-lokal oder Vision-LMM,-beschränkt durch berechnete Fakten
- Semantische Einbettungen für Vektoren
Das Schlüsselwort ist: strukturiertJede Ausgabe hat Vertrauenspunkte,.Quellenzuweisung,. und Evidence-Zeugner.. Kein Modell ist die einzige Quelle der Wahrheit..
Drei---Tier OCR Strategie
Tief tauchenDie OCR-Pipeline ist komplex genug, um ihren eigenen Artikel zu gewährleisten. Teil Die Drei---Tier OCR Pipeline für die vollständige technische Pannenweise einschließlich EAST-,-CRAFT-,-Real-MS K2-ESRGAN-MS-K3-CLIP.,- und Filmstreifenoptimierung
Das System verwendet eine dreistufige Eskalationsstrategie für die Textextraktion.
| , Tier Methode | , Geschwindigkeit | , Kosten am besten für | , | |
|---|---|---|---|---|
| 1 | Tesseract , | , ~50, | , frei , | , sauber , , , hoch ,- , kontrast Text |
| 2 | Florenz ,-2 ONNX Keine API-Kosten | |||
| 3 | Vision LLM | -~1-5-MSA- | -MASK3-MASSK4-Komplex /-Garbled Text | - |
Intelligentes Routing
ONNX-Texterkennung (OST, HANDWERKDer optimale Pfad wird bestimmt
- FAST-StreckeNur für (~100, ) und -2
- BALANCED-Strecke,: , Florenz , -2 , + , Tesseract-Abstimmungen ,(~300 ,ms) ,
- QUALITÄTS-WegMulti---Frame-Analyse - Vision LLM - (~1-5s-)
Unterstützung von ONNX Modellen
- **REAL---ESRGAN**Auflösung für Bilder mit niedriger Auflösung von - Qualität
- **KLEIN**Semantische Einbettungen für die Bildsuche
Ergebnis.: . . ~1.16 .GB von lokalen ONNX-Modellen, die . 85%+ . von Bildern ohne API-Kosten behandeln
Siehe es in Aktion
Bewegungserkennung Animationsanalyse

$ imagesummarizer demo-images/cat_wag.gif --pipeline caption --output text
Caption: A cat is sitting on a white couch.
Scene: indoor
Motion: MODERATE object_motion motion (partial coverage)
Bewegung Phrasen werden nur emittiert, wenn sie durch optische Strömungsmessungen und Rahmendeltas unterstützt werden.;- sonst fällt das System zurück auf neutrale Deskriptoren.
Meme &-Übertitel-Extraktion

$ imagesummarizer demo-images/anchorman-not-even-mad.gif --pipeline caption --output text
"I'm not even mad."
"That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion (localized coverage)
Die Untertitel-Rahmendeduplikation erkennt Textänderungen im unteren Bereich von Frames, die helle Pixel wiegen.
Rahmenband-Technologie
Für animierte GIFs mit Untertiteln erzeugt das Tool horizontale Rahmenleisten für Vision LLM analysis... Drei Modi zielen auf unterschiedliche Anwendungsfälle ab.
Nur Streifen (-NEW-!---Markenreduzierung
Der effizienteste Modus extrahiert nur Text, der Boxen einbindet, um die Tokenkosten drastisch zu senken.

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode text-only
Detecting subtitle regions (bottom 30%)...
  Found 2 unique text segments
Saved text-only strip to: anchorman-not-even-mad_textonly_strip.png
  Dimensions: 253×105 (83% token reduction)
| -Annäherung Abmessungen | -Token Kosten | ||
|---|---|---|---|
| Vollständiger Rahmen (10), | , 3000×185, MSC4, Hoch- | ||
| OCR-Streifen mit MSK-Frames, ), | und 600×185, MSC5, MKS6 und MSC7, Medium | , | |
| Nur Textstreifen | 253×105 | ~50 | Niedrig |
Wie es funktioniertDie Vision LLM erhält nur die Textregionen, die alle Untertitel enthalten und gleichzeitig Hintergrundpixel eliminieren.
OCR-Modusleiste Text ändert sich nur auf Frames von 2 reduziert

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode ocr
Deduplicating 93 frames (OCR mode - text changes only)...
  Reduced to 2 unique text frames
Saved ocr strip to: anchorman-not-even-mad_ocr_strip.png
  Dimensions: 600x185 (2 frames)
Streifen im Bewegungsmodus Keyframes für Bewegungsinferenzen

$ imagesummarizer export-strip demo-images/cat_wag.gif --mode motion --max-frames 6
Extracting 6 keyframes from 9 frames (motion mode)...
  Extracted 6 keyframes for motion inference
Saved motion strip to: cat_wag_motion_strip.png
  Dimensions: 3000x280 (6 frames)
Dies ermöglicht es Vision LLMs, alle Untertitel in einem einzigen API-Aufruf zu lesen, der die Genauigkeit von Memes und beschrifteten Inhalten drastisch verbessert und gleichzeitig die Verwendung von Token minimiert.
Warum es nicht einfach betitelt wird
Dieses schlägt -" just caption es mit einem Grenzmodell -" , aus dem gleichen Grund ein X .- ,ray Beats Erzählungen ,: , das Modell wird nie gebeten, Lücken zu füllen , . , Es erhält eine geschlossene Ledger , - , gemessene Farben ,, , verfolgt Bewegung ?, , deduped subtitle Frames ., , OCR Vertrauen und nur macht, was das Substrat bereits enthält , wenn GPT . -4 , kapituliert ein Bild , , , it .
Die Wellenarchitektur
Das System verwendet eine wellenbasierte Pipeline wobei jede Welle ein unabhängiger Analysator ist, der typisierte Signale erzeugt Wellen, die in Prioritätsreihenfolge ausgeführt werden, und spätere Wellen können Signale von früheren ablesen
AusführungsauftragDie Welle läuft vor der Welle, bevor die Welle läuft.Die niedrigeren Prioritätszahlen führen früher in der Pipeline aus.
flowchart TB
    subgraph Wave10["Wave 10: Foundational Signals"]
        W1[IdentityWave - Format, dimensions]
        W2[ColorWave - Palette, saturation]
    end

    subgraph Wave40["Wave 40: Text Detection"]
        W9[TextLikelinessWave - OpenCV EAST/CRAFT]
    end

    subgraph Wave50["Wave 50: Traditional OCR"]
        W3[OcrWave - Tesseract]
    end

    subgraph Wave51["Wave 51: ML OCR"]
        W8[MlOcrWave - Florence-2 ONNX]
    end

    subgraph Wave55["Wave 55: ML Captioning"]
        W10[Florence2Wave - Local captions]
    end

    subgraph Wave58["Wave 58: Quality Gate"]
        W5[OcrQualityWave - Escalation decision]
    end

    subgraph Wave70["Wave 70: Embeddings"]
        W7[ClipEmbeddingWave - Semantic vectors]
    end

    subgraph Wave80["Wave 80: Vision LLM"]
        W6[VisionLlmWave - Cloud fallback]
    end

    Wave10 --> Wave40 --> Wave50 --> Wave51 --> Wave55 --> Wave58 --> Wave70 --> Wave80

    style Wave10 stroke:#22c55e,stroke-width:2px
    style Wave40 stroke:#06b6d4,stroke-width:2px
    style Wave50 stroke:#f59e0b,stroke-width:2px
    style Wave51 stroke:#8b5cf6,stroke-width:2px
    style Wave55 stroke:#8b5cf6,stroke-width:2px
    style Wave58 stroke:#ef4444,stroke-width:2px
    style Wave70 stroke:#3b82f6,stroke-width:2px
    style Wave80 stroke:#8b5cf6,stroke-width:2px
Vorrangige Reihenfolge (-Niederläufe zuerst):-Ausführungen 10-Ausgänge →-Ausgängen 40-Ausflüge →-Ausgang 50-Austritt →-Ausstieg 51-Auswertung →-Auszug →-Auskunft 58-Ausrichtung →-Ausführung 70-Auszeichnung →-Auskopplung 80-Auslegung
Das ist Beschränkte Fuzzy MoM Angewandt auf Bildanalyse-: mehrere Antragsteller veröffentlichen zu einem gemeinsamen Substrat (, die AnalysisContext), und die Endausgangsaggregate ihre Signale
Schlüsselwellen
- TextgleichheitWave Weitere Informationen finden Sie unter: http://www.cordis.lu/
- OcrWaveTraditioneller Tesseract OCR für sauberen Text
- MIOCRWaveDie ONNX läuft lokal mit stilisierten Schriftarten.
- Florence-2-WaveLokale ML-Unterschrift, wenn Vision LLM benötigt wird
- OcrQualityWaveSpell-- check gate - ,® bestimmt den Eskalationspfad
- VisionLmWave:-Cloud--basierte Vision LLM®,-Läufe nur, wenn frühere Wellen ausfallen oder ein niedriges Vertrauen signalisieren.
Anmerkung zur Reihenfolge der WellenDie drei OCR Stufen Die konzeptuellen Eskalationsebenen sind die einzelnen Wellen wie Advanced OCR oder Quality Gate. Veredelungen innerhalb dieser Stufen: nicht getrennte Eskalationsstufen: sie führen eine zeitliche Stabilisierung und Qualitätskontrollen durch.
Der Signalvertrag
Jede Welle erzeugt Signale mit einem standardisierten Vertrag.
public record Signal
{
    public required string Key { get; init; }      // "color.dominant", "ocr.quality.is_garbled"
    public object? Value { get; init; }             // The measured value
    public double Confidence { get; init; } = 1.0;  // 0.0-1.0 reliability score
    public required string Source { get; init; }    // "ColorWave", "VisionLlmWave"
    public DateTime Timestamp { get; init; }        // When produced
    public List<string>? Tags { get; init; }        // "visual", "ocr", "quality"
    public Dictionary<string, object>? Metadata { get; init; }  // Additional context
}
Dies ist der Teil-Signalvertrag in Aktion...Wellen sprechen nicht über natürliche Sprache miteinander... Sie veröffentlichen eingegebene Signale im gemeinsamen Kontext, und nachgeschaltete Wellen können diese Signale abfragen...
Beachten Sie: Confidence Eine einzelne Welle kann mehrere Signale mit unterschiedlicher epistemischer Stärke aussenden.-...FarbeWave-' ist eine dominierende Farbliste, die Vertrauen hat.1.0...berechnete ), aber individuelle Farbprozentsätze verwenden das Vertrauen als Gewichtungsfaktor für nachgelagerte Zusammenfassungen.....
Vertrauen bedeutet hier Zuverlässigkeit für den nachgeschalteten EinsatzNicht mathematische Gewissheit: Deterministische Signale sind reproduzierbar: nicht unfehlbar: -spell-check kann deterministisch falsch sein, wenn es um richtige Substantive geht:
Determinismus Vorbehalte", deterministisch, ", bedeutet keine Stichprobenzufälligkeit und stabile Ergebnisse für eine bestimmte Laufzeit und Konfiguration. ., ONNX GPU-Ausführungsanbieter können geringfügige numerische Varianz einführen. ,, die für Routing-Entscheidungen akzeptabel ist. MSC5, der Signalkontrakt hält an,, Eskalationslogik, bleibt vollständig determinisch, .,
OCR Signal-Taxonomie
Um Verwechslungen zu vermeiden, ist hier der kanonische OCR-Signalnamensraum, der im gesamten System verwendet wird.
Signalschlüssel Quelle Beschreibung
| ------------------------------- | ---------------------- | ---------------------------------------------- |
| ocr.text |-Tesseract Mehr erfahren 1)-Teier Mehr erfahren|-Rohsingle---Frame OCR Mehr erfahren
| ocr.confidence Bewertung des Tesseract-Vertrauens von Tesserakt
| ocr.ml.text Weitere Informationen: http:www.cordis.lu/
| ocr.ml.multiframe_text Weitere Informationen: http:europa.eu.int/comm/index_de.html
| ocr.ml.confidence Bewertung des Vertrauens in Florenz, -2, MSC2, MCS3, |
| ocr.quality.spell_check_score .| . OcrQualityWave . | . Deterministische Schreibweise . - . Prüfverhältnis .
| ocr.quality.is_garbled E-Mail-Adresse: http:www.cordis.lu
| ocr.vision.text VisionLmmWave Mehr Infos über die LLM-OCR-Extraktion
| caption.text VisionLmmWave Beschreibende Bildunterschrift
Wichtige Unterscheidung: ocr.vision.text wird Textextraktion ,(,OCR,),, während caption.text wird Beschreibung der Szene Beide können von der gleichen Vision LLM Anruf kommen, aber verschiedenen Zwecken dienen.
Priorität für die Auswahl des endgültigen Textes Höchster bis niedrigster Wert
ocr.vision.text,( ,Vision LLM OCR , , , wenn eskaliert , ) ,ocr.ml.multiframe_text,(-Florenz , -2-GIF-)-ocr.ml.text,( ,Florenz , -2 , einzelne , - , Rahmen , ) ,ocr.textTesseract, )
Die Wellenschnittstelle
Jede Welle implementiert eine einfache Schnittstelle.
public interface IAnalysisWave
{
    string Name { get; }
    int Priority { get; }           // Lower number = runs earlier (10 before 50 before 80)
    IReadOnlyList<string> Tags { get; }

    Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,    // Shared substrate with earlier signals
        CancellationToken ct);
}
Das AnalysisContext ist die Konsensraum aus dem Teil 2. Wellen können :
- Auslesen von Signalen früherer Wellen
context.GetValue<bool>("ocr.quality.is_garbled") - Zwischenergebnisse des Zugriffs zwischengespeichert
context.GetCached<Image<Rgba32>>("ocr.frames") - Neue Signale hinzufügen, die nachgeschaltete Wellen verbrauchen können
Die Deterministische Stiftung
ColorWave läuft zuerst -(-Priorität und berechnet Fakten, die alles andere einschränken
public class ColorWave : IAnalysisWave
{
    public string Name => "ColorWave";
    public int Priority => 10;  // Runs first (lowest priority number)
    public IReadOnlyList<string> Tags => new[] { "visual", "color" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        using var image = await LoadImageAsync(imagePath, ct);

        // Extract dominant colors (computed, not guessed)
        var dominantColors = _colorAnalyzer.ExtractDominantColors(image);
        signals.Add(new Signal
        {
            Key = "color.dominant_colors",
            Value = dominantColors,
            Confidence = 1.0,  // Reproducible measurement
            Source = Name,
            Tags = new List<string> { "color" }
        });

        // Individual colors for easy access
        for (int i = 0; i < Math.Min(5, dominantColors.Count); i++)
        {
            var color = dominantColors[i];
            signals.Add(new Signal
            {
                Key = $"color.dominant_{i + 1}",
                Value = color.Hex,
                Confidence = color.Percentage / 100.0,
                Source = Name,
                Metadata = new Dictionary<string, object>
                {
                    ["name"] = color.Name,
                    ["percentage"] = color.Percentage
                }
            });
        }

        // Cache the image for other waves (no need to reload)
        context.SetCached("image", image.CloneAs<Rgba32>());

        return signals;
    }
}
Die Vision LLM erhält diese Farben später als EinschränkungenEs sollte nicht behaupten, dass das Bild hat ".vibrant reds."., wenn ColorWave berechnet, dass die dominante Farbe blau ist -., und wenn es tut ,. der Widerspruch ist nachweisbar und kann nach unten abgelehnt werden
OcrQualityWave-:. Das Rolltor
Das ist, wo Beschränkte Fuzziness Glänzend.-OcrQualityWave ist die Begrenzer das entscheidet, ob es zu teurem Vision LLM-:-Eskalieren
public class OcrQualityWave : IAnalysisWave
{
    public string Name => "OcrQualityWave";
    public int Priority => 58;  // Runs after OCR waves
    public IReadOnlyList<string> Tags => new[] { "content", "ocr", "quality" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        // Get OCR text from earlier waves (canonical taxonomy)
        string? ocrText =
            context.GetValue<string>("ocr.ml.multiframe_text") ??  // Florence-2 GIF
            context.GetValue<string>("ocr.ml.text") ??             // Florence-2 single
            context.GetValue<string>("ocr.text");                  // Tesseract

        if (string.IsNullOrWhiteSpace(ocrText))
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.no_text",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Tier 1: Spell check (deterministic, no LLM)
        var spellResult = _spellChecker.CheckTextQuality(ocrText);

        signals.Add(new Signal
        {
            Key = "ocr.quality.spell_check_score",
            Value = spellResult.CorrectWordsRatio,
            Confidence = 1.0,
            Source = Name,
            Metadata = new Dictionary<string, object>
            {
                ["total_words"] = spellResult.TotalWords,
                ["correct_words"] = spellResult.CorrectWords
            }
        });

        signals.Add(new Signal
        {
            Key = "ocr.quality.is_garbled",
            Value = spellResult.IsGarbled,  // < 50% correct words
            Confidence = 1.0,
            Source = Name
        });

        // This signal triggers Vision LLM escalation
        if (spellResult.IsGarbled)
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.correction_needed",
                Value = true,
                Confidence = 1.0,
                Source = Name,
                Tags = new List<string> { "action_required" },
                Metadata = new Dictionary<string, object>
                {
                    ["quality_score"] = spellResult.CorrectWordsRatio,
                    ["correction_method"] = "llm_sentinel"
                }
            });

            // Cache for Vision LLM to access
            context.SetCached("ocr.garbled_text", ocrText);
        }

        return signals;
    }
}
Die Eskalationsentscheidung lautet: DeterministischWenn Rechtschreibprüfungspunktzahl ein Signal aussendet, das die Vision LLM-. auslöst Kein probabilistisches Urteilsvermögen Keine ., vielleicht sollten wir den LLM -". nur eine Schwelle fragen.
Eskalation in Aktion

$ imagesummarizer demo-images/arse_biscuits.gif --pipeline caption --output text
OCR: "ARSE BISCUITS"
Caption: An elderly man dressed as bishop with text reading "arse biscuits"
Scene: meme
OCR bekam den text.;. Vision LLM zur Verfügung gestellt Szene Kontext... jede Welle trägt dazu bei, was es an . gut ist.
VisionLlmWave-:-Der eingeschränkte Antragsteller
Die Vision LLM Welle läuft nur dann, wenn frühere Signale es anzeigen.' s neededed -. Und wenn sie ausgeführt wird, läuft , used - ' usered by computed facts...
public class VisionLlmWave : IAnalysisWave
{
    public string Name => "VisionLlmWave";
    public int Priority => 50;  // Runs after quality assessment
    public IReadOnlyList<string> Tags => new[] { "content", "vision", "llm" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        if (!Config.EnableVisionLlm)
        {
            signals.Add(new Signal
            {
                Key = "vision.llm.disabled",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Check if OCR was unreliable (garbled text)
        var ocrGarbled = context.GetValue<bool>("ocr.quality.is_garbled");
        var textLikeliness = context.GetValue<double>("content.text_likeliness");
        var ocrConfidence = context.GetValue<double>("ocr.ml.confidence",
            context.GetValue<double>("ocr.confidence"));

        // Only escalate when: OCR failed OR (text likely but low OCR confidence)
        // Models never decide paths; deterministic signals do (no autonomy)
        bool shouldEscalate = ocrGarbled ||
                              (textLikeliness > 0.7 && ocrConfidence < 0.5);

        if (shouldEscalate)
        {
            var llmText = await ExtractTextAsync(imagePath, ct);

            if (!string.IsNullOrEmpty(llmText))
            {
                // Emit OCR signal (Vision LLM tier)
                signals.Add(new Signal
                {
                    Key = "ocr.vision.text",  // Vision LLM OCR extraction
                    Value = llmText,
                    Confidence = 0.95,  // High but not 1.0 - still probabilistic
                    Source = Name,
                    Tags = new List<string> { "ocr", "vision", "llm" },
                    Metadata = new Dictionary<string, object>
                    {
                        ["ocr_was_garbled"] = ocrGarbled,
                        ["escalation_reason"] = ocrGarbled ? "quality_gate_failed" : "low_confidence_high_likeliness",
                        ["text_likeliness"] = textLikeliness,
                        ["prior_ocr_confidence"] = ocrConfidence
                    }
                });

                // Optionally emit caption (separate signal)
                var llmCaption = await GenerateCaptionAsync(imagePath, ct);
                if (!string.IsNullOrEmpty(llmCaption))
                {
                    signals.Add(new Signal
                    {
                        Key = "caption.text",  // Descriptive caption (not OCR)
                        Value = llmCaption,
                        Confidence = 0.90,
                        Source = Name,
                        Tags = new List<string> { "caption", "description" }
                    });
                }
            }
        }

        return signals;
    }
}
Die wichtigsten Erkenntnisse Vision LLM-Text hat VertrauenDie nachgelagerte Aggregation weiß dies, ., MSC6, warum Standardvoreinstellung ,, konfiguriert pro Modell, /, Pipeline, ,, aufgezeichnet in Konfiguration ., Der genaue Wert zählt weniger als mit einem einen Wert, der 't 1.0.)
Die Ledger-Synthese
Das ImageLedger akkumuliert Signale in strukturierte Abschnitte für den nachgeschalteten Verbrauch Kontext schleppen Angewandt auf Bildanalyse-:
public class ImageLedger
{
    public ImageIdentity Identity { get; set; } = new();
    public ColorLedger Colors { get; set; } = new();
    public TextLedger Text { get; set; } = new();
    public MotionLedger? Motion { get; set; }
    public QualityLedger Quality { get; set; } = new();
    public VisionLedger Vision { get; set; } = new();

    public static ImageLedger FromProfile(DynamicImageProfile profile)
    {
        var ledger = new ImageLedger();

        // Text: Priority order - corrected > voting > temporal > raw
        ledger.Text = new TextLedger
        {
            ExtractedText =
                profile.GetValue<string>("ocr.final.corrected_text") ??  // Tier 2/3 corrections
                profile.GetValue<string>("ocr.voting.consensus_text") ?? // Temporal voting
                profile.GetValue<string>("ocr.full_text") ??             // Raw OCR
                string.Empty,
            Confidence = profile.GetValue<double>("ocr.voting.confidence"),
            SpellCheckScore = profile.GetValue<double>("ocr.quality.spell_check_score"),
            IsGarbled = profile.GetValue<bool>("ocr.quality.is_garbled")
        };

        // Colors: Computed facts, not guessed
        ledger.Colors = new ColorLedger
        {
            DominantColors = profile.GetValue<List<DominantColor>>("color.dominant_colors") ?? new(),
            IsGrayscale = profile.GetValue<bool>("color.is_grayscale"),
            MeanSaturation = profile.GetValue<double>("color.mean_saturation")
        };

        return ledger;
    }

    public string ToLlmSummary()
    {
        var parts = new List<string>();

        parts.Add($"Format: {Identity.Format}, {Identity.Width}x{Identity.Height}");

        if (Colors.DominantColors.Count > 0)
        {
            var colorList = string.Join(", ",
                Colors.DominantColors.Take(5).Select(c => $"{c.Name}({c.Percentage:F0}%)"));
            parts.Add($"Colors: {colorList}");
        }

        if (!string.IsNullOrWhiteSpace(Text.ExtractedText))
        {
            var preview = Text.ExtractedText.Length > 100
                ? Text.ExtractedText[..100] + "..."
                : Text.ExtractedText;
            parts.Add($"Text (OCR, {Text.Confidence:F0}% confident): \"{preview}\"");
        }

        return string.Join("\n", parts);
    }
}
Das Buch ist das Anker in CFCD-Begriffen ,. , Es trägt vorwärts was die Auswahl überlebte , und die LLM-Synthese muss diese Fakten respektieren , . ,
Die Eskalationsentscheidung
Sie haben Eskalationslogik an zwei Stellen gesehen OcrQualityWave Emissionen Signale Über die Qualität EscalationService findet Anwendung Politik Dies ist eine absichtliche Trennung.
- Welle: lokale EskalationJede Welle gibt Fakten über ihre Domäne aus.
- Eskalation auf der Ebene des Dienstes:
EscalationServiceAggregate Signale und Anwendung globaler Schwellenwerte
Das EscalationService bindet es alles zusammen, es implementiert das Teil Muster : Substrat-Schmuckschrauber →:
public class EscalationService
{
    private bool ShouldAutoEscalate(ImageProfile profile)
    {
        // Escalate if type detection confidence is low
        if (profile.TypeConfidence < _config.ConfidenceThreshold)
            return true;

        // Escalate if image is blurry
        if (profile.LaplacianVariance < _config.BlurThreshold)
            return true;

        // Escalate if high text content
        if (profile.TextLikeliness >= _config.TextLikelinessThreshold)
            return true;

        // Escalate for complex diagrams or charts
        if (profile.DetectedType is ImageType.Diagram or ImageType.Chart)
            return true;

        return false;
    }
}
Jede Eskalationsentscheidung ist DeterministischDieselben Inputs, gleiche Schwellen, gleiche Entscheidung, kein LLM-Urteil in der Eskalationslogik
Die Vision LLM Prompt-:-Beweisbeschränkungen
Wenn das Vision LLM ausgeführt wird, erhält es die berechneten Fakten als Einschränkungen.
private static string BuildVisionPrompt(ImageProfile profile)
{
    var prompt = new StringBuilder();

    prompt.AppendLine("CRITICAL CONSTRAINTS:");
    prompt.AppendLine("- Only describe what is visually present in the image");
    prompt.AppendLine("- Only reference metadata values provided below");
    prompt.AppendLine("- Do NOT infer, assume, or guess information not visible");
    prompt.AppendLine();

    prompt.AppendLine("METADATA SIGNALS (computed from image analysis):");

    if (profile.DominantColors?.Any() == true)
    {
        prompt.Append("Dominant Colors: ");
        var colorDescriptions = profile.DominantColors
            .Take(3)
            .Select(c => $"{c.Name} ({c.Percentage:F0}%)");
        prompt.AppendLine(string.Join(", ", colorDescriptions));

        if (profile.IsMostlyGrayscale)
            prompt.AppendLine("  → Image is mostly grayscale");
    }

    prompt.AppendLine($"Sharpness: {profile.LaplacianVariance:F0} (Laplacian variance)");
    if (profile.LaplacianVariance < 100)
        prompt.AppendLine("  → Image is blurry or soft-focused");

    prompt.AppendLine($"Detected Type: {profile.DetectedType} (confidence: {profile.TypeConfidence:P0})");

    prompt.AppendLine();
    prompt.AppendLine("Use these metadata signals to guide your description.");
    prompt.AppendLine("Your description should be grounded in observable facts only.");

    return prompt.ToString();
}
Die Vision LLM sollte nicht behaupten, " vibrant Farben, wenn wir Graustufen berechnet , - , wenn es tut , , , der Widerspruch ist nachweisbar , . , Es sollte nicht Anspruch auf ," , scharfe Details ," , Wenn wir niedrige Laplacian Varianz berechnet . - , falls es tut , , können wir die Ausgabe ablehnen , die deterministisches Substrat schränkt den probabilistischen Ausgang ein.
Diese Einschränkungen reduzieren Halluzinationen, können sie aber nicht eliminieren.-Prompts sind Vorschläge, die nicht garantiert werden, dass .e wirkliche Durchsetzung über Konfidenzgewichtung und Signalauswahl nach unten erfolgt.
Priorität für die Ausgabe von Text
Beim Extrahieren des endgültigen Textes verwendet das System eine strenge Prioritätsreihenfolge.
static string? GetExtractedText(DynamicImageProfile profile)
{
    // Priority chain using canonical signal names (see OCR Signal Taxonomy above)
    //   1. Vision LLM OCR (best for complex/garbled)
    //   2. Florence-2 multi-frame GIF (temporal stability)
    //   3. Florence-2 single-frame (stylized fonts)
    //   4. Tesseract (baseline)

    var visionText = profile.GetValue<string>("ocr.vision.text");
    if (!string.IsNullOrEmpty(visionText))
        return visionText;

    var florenceMulti = profile.GetValue<string>("ocr.ml.multiframe_text");
    if (!string.IsNullOrEmpty(florenceMulti))
        return florenceMulti;

    var florenceText = profile.GetValue<string>("ocr.ml.text");
    if (!string.IsNullOrEmpty(florenceText))
        return florenceText;

    return profile.GetValue<string>("ocr.text") ?? string.Empty;
}
AnmerkungDieses wählt eine Quelle aus, aber das Buch entlarvt ALLE Quellen mit Provenienz. profile.Ledger.Signals um alle OCR-Versuche und ihr Vertrauen Scores zu sehen
Jede Quelle hat die Zuverlässigkeit bekannt.
- Vision LLMAm besten für komplexe Szenen,-Diagramme,-Diagramme (-Vertrauen
- Florenz ,-2Gut für stilisierte Schriftarten, die lokal ausgeführt werden
- Abstimmung über TesseractZuverlässig für sauberen Text
- Raw TesseractGrundlegender Rückfall von (Vertrauensgefühl für stilisierte Schriftarten
Die Prioritätsbestellung kodiert dieses Wissen..- Florenz--2-Sitzen zwischen Vision LLM und Tesseract bietet einen Sweet Spot für die meisten Bilder, besser als traditionelle OCRP,-Sortimente billiger als Cloud-Vision LLMs.
Hinweis: Diese Funktion wählt eins Quelle: ,, aber das Buch entlarvt alle Quellen mit ihren Konfidenzergebnissen.-Abwärtsstromverbraucher können-- und sollten die Provenienz prüfen, wenn die Domain es erfordert..- Die Prioritätsreihenfolge ist eine vernünftige Voreinstellung,- keine Zwangsjacke
Auswahl und Konfliktlösung
Die Prioritätskette oben ist die aktuelle Implementation...... ein einfacher Fallback....... aber die Architektur unterstützt das Hinzufügen von Ablehnungsregeln als config.. ..
// Pattern: Contradiction detection as policy rules
public static class SelectionPolicy
{
    public static string? SelectTextWithConstraints(DynamicImageProfile profile)
    {
        var visionText = profile.GetValue<string>("vision.llm.text");
        if (!string.IsNullOrEmpty(visionText))
        {
            // Rule: Reject if Vision claims text but deterministic signals say no text
            var textLikeliness = profile.GetValue<double>("content.text_likeliness");
            if (textLikeliness < _config.TextLikelinessThreshold && visionText.Length > 50)
            {
                // Contradiction detected - log and fall through
                profile.AddSignal(new Signal
                {
                    Key = "selection.vision_rejected",
                    Value = "text_likeliness_contradiction",
                    Confidence = 1.0,
                    Source = "SelectionPolicy",
                    Metadata = new Dictionary<string, object>
                    {
                        ["text_likeliness"] = textLikeliness,
                        ["vision_text_length"] = visionText.Length,
                        ["threshold"] = _config.TextLikelinessThreshold
                    }
                });
                // Fall through to OCR sources
            }
            else
            {
                return visionText;
            }
        }

        // Continue with priority chain...
        return profile.GetValue<string>("ocr.voting.consensus_text")
            ?? profile.GetValue<string>("ocr.full_text");
    }
}
Das gleiche Muster gilt für andere Signaltypen.
- FarbwiderspruchUnterschrift zurückweisen, in der behauptet wird, dass "Vibrant Reds, "
color.is_grayscaleist wahr - Scharfsinn-Widerspruch. . : . Zurückweisen der Bildunterschrift unter Angabe von Details . " .
quality.sharpnessSchwelle - Art des WiderspruchsUnterschrift zurückweisen, die eine Person beansprucht, wenn
content.typeist Diagramm mit hohem Vertrauen
Die wichtigsten Eigenschaften der Selektionsschicht
- PrioritätsketteJede Quelle hat eine definierte Fallback-Ordnung.
- Qualitätstor stromaufwärtsOCR wird akzeptiert, wenn das deterministische Tor sagt, es sei nicht bestochen.
- ErweiterungspunktDie Widerspruchsregeln sind wie jede andere Richtlinie konfigisiert und versioniert.
- PrüfpfadDie Ablehnungen senden Signale mit beobachteten Werten und Schwellenwerten aus.
Hier hält der Determinismus an.". wird mechanisch wahr. .. Das LLM schlägt deterministische Regeln vor, die entscheiden, ob es akzeptiert wird.
Konfiguration der JSON-Pipeline
Pipelines sind vollständig konfigurierbar über JSON-,, wodurch die Wellenzusammensetzung explizit und auditiert werden kann.
{
  "name": "advancedocr",
  "displayName": "Advanced OCR (Default)",
  "description": "Multi-frame temporal OCR with stabilization and voting",
  "estimatedDurationSeconds": 2.5,
  "accuracyImprovement": 25,
  "phases": [
    {
      "id": "color",
      "name": "Color Analysis",
      "priority": 100,
      "waveType": "ColorWave",
      "enabled": true
    },
    {
      "id": "simple-ocr",
      "name": "Simple OCR",
      "priority": 60,
      "waveType": "OcrWave",
      "earlyExitThreshold": 0.98
    },
    {
      "id": "advanced-ocr",
      "name": "Advanced Multi-Frame OCR",
      "priority": 59,
      "waveType": "AdvancedOcrWave",
      "dependsOn": ["simple-ocr"],
      "parameters": {
        "maxFrames": 30,
        "ssimThreshold": 0.95,
        "enableVoting": true
      }
    },
    {
      "id": "quality",
      "name": "OCR Quality Assessment",
      "priority": 58,
      "waveType": "OcrQualityWave",
      "dependsOn": ["advanced-ocr"]
    }
  ]
}
Frühe Austrittsschwellen lassen teure Wellen überspringen, wenn billige Wellen bereits hohes Vertrauen erreicht haben.
Das automatische Pipeline-Routing
Das auto Pipeline implementiert intelligentes Routing basierend auf Bildeigenschaften. ,, , die Auswahl des optimalen Verarbeitungspfades.
Image Analysis (OpenCV ~5-20ms)
    │
    ├── Is animated (>1 frame)?
    │   └── ANIMATED route
    │       ├── Has subtitle regions? → Text-only strip extraction
    │       ├── Minimal text? → FAST (Florence-2 only)
    │       └── Motion significant? → Motion analysis
    │
    ├── Has text regions (OpenCV detection)?
    │   ├── High contrast, clean text → FAST route (Florence-2, ~100ms)
    │   ├── Moderate confidence → BALANCED route (Florence-2 + Tesseract, ~300ms)
    │   └── Low confidence → QUALITY route (Multi-frame + Vision LLM, ~1-5s)
    │
    ├── Is chart/diagram (type detection)?
    │   └── QUALITY route → Vision LLM caption
    │
    └── Default → FAST route (Florence-2 caption)
Streckenleistung
| -Routenauslöser bei der Verarbeitung von | -Zeiten Kosten | ||
|---|---|---|---|
| -FAST - Einfacher Text - Hochkontrast - Standard-Schriften - Nur in Florence--2-Formaten - Niedrig - Lokal-)-Formate | |||
| -BALANCED Normaler Text ,-Modernes Vertrauen | -Florenz MS K4-M+- Tesseract Abstimmung Ms K6-~300-Ms K8-Now-(-Lokale )- | - | |
| QUALITÄT | Charts, graphische Diagramme , stilisierte Schriftarten , low confidence | , Multi-- frame , + , Vision LLM | , ~1-5 , Medium ( , API ,) , |
| , | , GIFs mit Untertiteln , | , Text , nur Streifen , + , Filmstreifen , | , T~2-3 , Medium ,( , API, MSC9, MCSK10 |
Echtes Beispiel: Automatische Routenauswahl
$ imagesummarizer anchorman-not-even-mad.gif --pipeline auto --output visual
[Route selection...]
  Image: 300×185, 93 frames
  Text detection: 15 regions found (bottom 30%)
  Subtitle pattern: DETECTED
  → Selected ANIMATED route (text-only filmstrip)

[Processing...]
  MlOcrWave: Extracted 10 frames → 2 unique text segments
  Text-only strip: 253×105 (83% token reduction)
  VisionLlmWave: Processing filmstrip...

[Results - 2.3s total]
Text: "I'm not even mad." + "That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion
Die Routing-Entscheidung ist deterministisch und wird in Signalen für Audits aufgezeichnet.
{
  "routing": {
    "selected_route": "ANIMATED",
    "reason": "subtitle_pattern_detected",
    "text_regions": 15,
    "frames": 93,
    "decision_time_ms": 18
  }
}
Die Verwendung von CLI-:
Grundlegende Verwendung
# Use auto pipeline (smart routing - recommended)
imagesummarizer meme.gif --pipeline auto

# Fast local caption with Florence-2 ONNX (~200ms)
imagesummarizer photo.jpg --pipeline florence2

# Best quality: Florence-2 + Vision LLM
imagesummarizer complex-diagram.png --pipeline florence2+llm

# Extract text only (three-tier OCR)
imagesummarizer screenshot.png --pipeline advancedocr

# Motion analysis for GIFs
imagesummarizer animation.gif --pipeline motion

# Process a directory with visual output
imagesummarizer ./photos/ --output visual
Signalsammlungen
Fordern Sie nur die Signale an, die Sie mit Pre---definierten Sammlungen benötigen.
# Minimal metadata (fast)
imagesummarizer image.png --signals "@minimal"

# Alt text for accessibility
imagesummarizer image.png --signals "@alttext"

# Motion analysis
imagesummarizer animation.gif --signals "@motion"

# Full analysis
imagesummarizer image.png --signals "@full"

# Custom wildcard patterns
imagesummarizer image.png --signals "color.dominant*, ocr.text, motion.*"
Sammlung von Signalen (MSK)
| ---------- | --------------------------------------- | ------------------ |
| @minimal Identität des BeschwerdeführersQualität .Scharpness Nur schnelles Profil
| @alttext Bildunterschrift: ., Textunterschriften: ,, Ocr, ,, Farbe: ., Dominant Barrierefreiheit
| @motion |-Bewegung, .-Bewegung*,-Identität: .-Frame, _-count Animationsanalyse: |-
| @full Alle Signale Gesamtanalyse
| @tool Optimierte Teilmenge MKP1, MCPP2, Automatisierung MKK3,
Reale JSON-Ausgabe
$ imagesummarizer princess-bride.gif --output json
{
  "image": "princess-bride.gif",
  "duration_ms": 1838,
  "waves_executed": ["ColorWave", "OcrWave", "AdvancedOcrWave", "VisionLlmWave"],
  "text": {
    "value": "You keep using that word.\nI do not think it means what you think it means.",
    "source": "ocr.voting.consensus_text",
    "confidence": 0.95
  },
  "escalation": {
    "triggered": true,
    "reason": "text_likeliness_above_threshold",
    "threshold": 0.4,
    "observed": 0.67
  },
  "signals": {
    "color.dominant_1": { "value": "#1a1a2e", "confidence": 1.0 },
    "ocr.quality.spell_check_score": { "value": 0.82, "confidence": 1.0 },
    "ocr.quality.is_garbled": { "value": false, "confidence": 1.0 },
    "motion.type": { "value": "static", "confidence": 0.95 }
  }
}
Jedes Feld hat Provenienz... escalation Blockansichten warum die Vision LLM wurde genannt
Bewegungsanalyse

$ imagesummarizer demo-images/alanshrug_opt.gif --pipeline motion
Motion: SUBTLE general motion (localized coverage)
Direction: up-down
Magnitude: 0.23
Interaktiver Modus
$ imagesummarizer
ImageSummarizer Interactive Mode
Pipeline: advancedocr | Output: auto | LLM: auto
Commands: /help, /pipeline, /output, /llm, /model, /ollama, /models, /quit

Enter image path (or drag & drop): F:\Gifs\meme.gif
Processing...
I'm not even mad. That's amazing.

Enter image path: /llm true
Vision LLM: enabled

Enter image path: /model minicpm-v:8b
Vision model: minicpm-v:8b
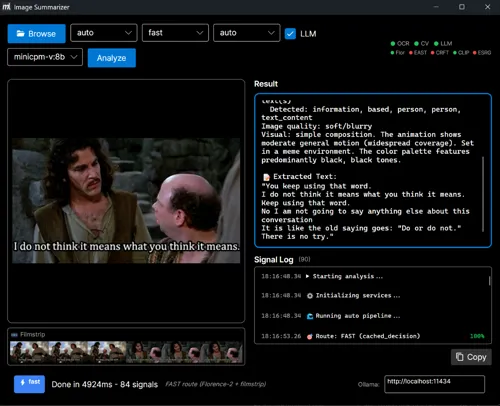
Arbeitsfläche
Für die visuelle Exploration , die Desktop-Anwendung zur Verfügung stellt ,: ,
- Ziehen Sie die Drop-SchnittstelleBilder zur sofortigen Analyse fallen lassen
- Live-SignalprotokollBeobachten Sie Wellen in real Ausführen, - Beobachte Zeit mit Vertrauen Färbung
- Muster-StatusindikatorenAmpelsystem (🟢, fertig ,, fertig 🟡, Verarbeitung ,, fehlgeschlagen ),
- Animierte GIF-VorschauSiehe Filmetrip-Generierung und Rahmenextraktion
- SignalinspektorKlicken Sie auf jedes Signal, um volle Provenienz und Metadaten zu sehen
- LeitungsauswahlWechseln Sie zwischen den Modi der automatischen Bewegung von / und 2/
- ExportoptionenSignale als JSON-, kopieren, Filmtrips speichern, Text exportieren
Die Desktop-GUI zeigt die Architektur visuell.— , können Sie genau sehen, welche Wellen ran?, , welche Signale sie emittiert haben und wie die Routing-Entscheidungen getroffen wurden.. , Perfekt zum Verständnis des Systems oder Debugging benutzerdefinierter Pipelines.
Das CLI setzt die ganze Komplexität als einfache Optionen aus.Sie können Pipelines, Modelle und Ausgabeformate wechseln, ohne die Wellenarchitektur zu verstehen.
Wo die Muster erscheinen
Bild-Summarizer-Implementierung | ---- | ---------------------------------------------------------------- | ----------------------------------------------------------------------- | | 1 | Beschränkte Fuzziness Die FarbeWave berechnet Fakten die VisionLmWave respektiert sie. | 2 | Beschränkte Fuzzy MoM Mehrere Wellen veröffentlichen zu AnalyseKontext;WellenOrchesterkoordinaten | | 3 | Kontext schleppen BildLedger akkumuliert wesentliche Funktionen SignalDatabase-Caches Ergebnisse
Gleiche Muster Verschiedene Domänen Gleiche Regel Wahrscheinlichkeit schlägt vor, dass der Determinismus fortbesteht.
Was man bekommt
- RAG---bereite AusgabeStructured JSON mit Konfidenzwert
- Lokale VerarbeitungWeitere Informationen finden Sie unter: http:www.cordis.lu/
- Intelligentes RoutingAutomatische Pipeline wählt den optimalen Pfad aus
- TokeneffizienzText: Nur Streifen von GIF-Untertiteln erreichen eine Reduzierung des Zeichens für GIF
- Prüfungsfähige EntscheidungenJede Eskalation hat einen expliziten Grund mit Provenienz
- Modell„-"agnostischSwap Ollama für OpenAI oder Anthropoc ohne Änderung der Architektur
- Nach Inhalt sortiertDas gleiche Bild ist dieselbe Analyse, auch wenn es in ( umbenannt wurde.
- ArbeitsflächeSchnittstelle mit Live-Signalvisualisierung
- MCP-ServermodusMit allen LLMs integrieren, die das Model Context Protocol unterstützen.
- Signal---basierte APIBeantragen Sie nur, was Sie mit Platzhaltermustern oder Sammlungen benötigen
Was es kostet
- Kognitive GemeinkostenSie müssen die Signalkontrakte verstehen, bevor Sie eine einzelne Welle schreiben, die schlampiges Denken bestraft.
- SpezifizitätJeder Signalschlüssel braucht eine klare Definition, jeder Konfidenzpunkt muss rational sein, Sie können nicht aushändigen.
- Vielschichtigkeit der Per--Jede Welle hat ihre eigene Konfiguration.,. Edge Cases. ,. und Ausfallmodi.MSC3. Debugging geschieht auf dem Wave Level, nicht auf dem Pipeline Level.
- PrüfflächeWeitere Komponenten bedeutet mehr Tests ,. , um den Kontext zu beheben , die Signale bestätigen , , , verifizieren die Eskalationspfade , . ,
- Vorläufige InvestitionenDu bestimmst Wellen, ,, Signale und Buchstruktur, bevor du Ergebnisse siehst. ., die Auszahlung kommt später.
Dies ist nicht der schnelle Pfad, sondern der zuverlässige Pfad, wenn Sie ein auditables Bildverständnis im Maßstab benötigen.
Failure Modes und wie diese behandelt sie
Fehler-Modus, was passiert, wie es mit ' umgeht
| ------------------------------ | ------------------------------------ | -------------------------------------------------------------------------------------------------------------------------------------------- |
| Lärmige GIF Verdrängungsartefakte des Rahmenjitters , Temporale Stabilisierung +.SSIM-Deduplikation +. Abstimmungskonsens +. Text Nur Streifenextraktion |.
| OCR gibt Müll zurück Tesseract schlägt auf stilisierten Schriftarten fehl | , Spell , - , Check-Gate erkennt < , korrekt 50% , eskaliert zu Florenz -2 , wenn noch schlecht | ,
| Hohe API-Kosten Zu viele Cloud Vision LLM-Aufrufe |Aus Florenz-2Aus ONNX-Handles 80%+Aus lokal (~200Ausms),Aus Text-Nur Streifen reduzieren Token für GIFs
| Vision halluzinate LLM behauptet Text, dass es ' ist dort Signalen ermöglichen Widerspruchserkennung ( pattern oben gezeigte nachgeschaltete Verbraucher können vergleichenvision.llm.text vs. content.text_likeliness |
| Änderungen der Pipeline im Laufe der Zeit Neue Wellen hinzugefügt , , Schwellen eingestellt | , Inhalt - , Gehäuse caching , volle Provenienz in jedem Signal + , Version Tracking , | ,
| Modell gibt nichts zurück Vision LLM-Timeout oder leere Reaktion | , Fallback-Kette , : , Vision-LLM , → , Florence ,-2 , .→ , Tesseract Abstimmung , → , Raw OCR , und die Prioritätsordnung gewährleistet eine anmutige Degradation
Jeder Ausfall-Modus hat eine deterministische Antwort... keine stille Degradation...
Der größere Bild-:-Multi ---Modal Graph RAG
Wichtiger KontextBildSummarizer ist der Bildaufnahme Pipeline für das LucidRAG-Ökosystem
Dieser Artikel konzentriert sich auf das Extrahieren von strukturierten Signalen aus Bildern, aber die reale Macht entsteht, wenn sie mit den anderen Zusammenfassungen kombiniert wird.
- DocSummarizer Structured Document Analysis - Strukturierte Dokumentanalyse - PDFs - , - Markdown -, - Code - ) -
- DatenZusammenfassung Tabellen-Datenprofilierung
- ImageSummarizer Bild- und Animationsanalyse
Wenn zusammen mit LucidRAG Diese drei Pipelines ermöglichen Multi---modales Diagramm RAG:
Document → DocSummarizer → Structured signals
    ↓
Images → ImageSummarizer → Structured signals
    ↓
Data → DataSummarizer → Structured signals
    ↓
    ↓ (all signals)
    ↓
LucidRAG Graph Builder → Multi-modal knowledge graph
    ↓
Query → Multi-modal retrieval + constrained generation
Warum das so wichtig istTraditionelle RAG behandelt Bilder als undurchsichtige Blobs, die Bildunterschriften erhalten erste Signalquellen der --Klasse mit typisierten Beziehungen zu Text, ,, data, , und anderen Bildern, gleichen Determinismus-Prinzipien, ,, unterschiedlicher Skala, .,
Die Musterskalen, wenn Sie strukturierte Signale aus Bildern extrahieren können, diesen ArtikelDocSummarizerDaten und DatenDatenZusammenfassungSie können einen Wissensgraphen erstellen, in dem jeder Knoten Provenienz trägt und jede Kante Konfidenzwerte hat.
In KürzeVollständige LucidRAG-Integration, die zeigt, wie diese Pipelines zu multi- und multi-- modalen Graphen RAG-Abfragen zusammensetzen..
Schlußfolgerung
Die Architektur hat Struktur... jede Welle ist unabhängig... jedes Signal wird typisiert... jede Eskalation ist deterministisch...... Florence... -2... bietet schnelle lokale Analyse...... Vision LLM behandelt komplexe Fälle... aber keine arbeitet unkontrainiert....—...deterministische Signale verankern immer den Ausgang...
Seit der ersten Artikelpublikation hat sich das System signifikant weiterentwickelt.
- Integration von Florenz ONNX schneidet API-Kosten und Latenz vor Ort gegen die Cloud von ~1-5
- Nur Filmetrips Erzielen Sie eine Token-Reduzierung für GIF Untertitel
- Automatische Pipeline wählt optimales Routing basierend auf Bildeigenschaften
- Signalsammlungen Vereinfachen Sie häufige Anwendungsfälle (@-Alttext,-@-Motion,-@-minimal
- Arbeitsfläche bietet Drag---und---Drop Analyse mit Live-Signal-Visualisierung
Die OCR-Pipeline allein mit ihren drei ,-'tier Eskalation , , , multi , -'frame Abstimmungen , und text , nur Streifenextraktion .— ist komplex genug geworden, um seinen eigenen ausführlichen Artikel zu gewährleisten . Vision OCR Integration Anleitung für den vollen technischen Zusammenbruch
Wenn du dies für Bilder tun kannst, der messigste Eingabetyp, mit OCR Noise, ,, stilisierte Schriftarten, animierte Frames und Halluzinationen, MSC5, können Sie es für jede probabilistische Komponente tun.
Das Beschränkte Fuzziness in der Praxis... kein abstraktes Muster...
Aufkommen
Repository
- LucidRAG-Repository Vollständiger Quellcode
CLI-Werkzeug
- ImageSummarizer CLI Befehlszeilenwerkzeug für die Bildanalyse
- KLI README Installations- und Konfigurationsdateien
- Demo-Bilder Muster GIFs und Rahmenstreifen in diesem Artikel gezeigt
Kernbibliothek
- DocSummarizer-.-Bilder Kernbildanalyse-Bibliothek
- Bibliothek README API-Dokumentation,-Wellenarchitektur,- und Integrationshandbuch
- Leitfaden für die Architektur --Wellen - Signalsignale - Eskalation - Caching
- Pipeline-Dokumentation Ausgewogene Qualität von ,, florenz, 2+,llm
- Vision OCR Integration --Routing-Filmtrips,-Token-Ökonomie
- Bewegungsanalyse GIF-Frame-Extraktion, Bewegungserkennung
- Referenzsignale Signalkatalog - Sammlungen - Wildcard-Syntax
Verwandte Artikel
- DocSummarizer Die Dokumentenanalyse-Pipeline mit ähnlichen Mustern
- DatenZusammenfassung Datenprofilierung mit dem gleichen Determinismus – erster Ansatz
Die Reihe
| Teil - Muster - Achse - | ||
|---|---|---|
| 1 | Beschränkte Fuzziness Einteilige Komponente | |
| 2 | Beschränkte Fuzzy MoM Mehrere Komponenten | |
| 3 | Kontext schleppen Zeit-Speicher (MSK) | |
| 4 | Bildintelligenz Dieser Artikel | Wellenarchitektur – Muster von , |
| 4.1 | Die Pipeline von Three--.Tier OCR Filmreisen mit ONNX-Modellen |
NächsterTeil, der zeigt, wie ImageSummarizer, , DocSummarizerL 347 vom 20.12.2013, S. 671. DatenZusammenfassung Komponieren Sie in Multi-Modal Graph RAG mit LucidRAG-.
Alle Teile folgen dem gleichen Invariant. probabilistische Komponenten schlagen vor deterministische Systeme bestehen fort..