


عندما تتبع أدواتك نفسها ، تتطور نفسها ، وتختار نفسها
ملاحظة: هذا هو الجزء 8 في سلسلة الإستخبارات الدنانيكية. الجزء 7 غطى مجمل بنية DSE. هذه المقالة تغوص عميقاً في شيء لمحت عليه: كيف تعمل الأدوات نفسها، تتبع الاستخدام، تتطور، وتصبح أكثر ذكاء بمرور الوقت.
ملاحظة: إذا كنت تعتقد أن التطور في الجزء 7 من الجزء 7 كان متوحشاً، انتظر حتى ترى ماذا يحدث عندما كل أداة واحدة لديه نفس القدرات.
في الجزء 7، عرضت عليكم التطور الاصطناعي الموجه: تدفق العمل الذي يخطّط، يولّد، ينفّذ، يُقيّم، ويُحسّن. ذكرت "الأدوات" عدة مرات.
هذا ما لم أشرحه:
هذه الأدوات؟ انها ليست ثابتة. انها ليست ملفات تشكيل التي تجلس هناك دون تغيير.
إنّها تحف حيّة تُمكّن من:
بعبارة أخرى: الأدوات هي العُقد. العُقد هي الأدوات. كل شيء يتطور.
ويصبح الأمر أكثر غرابة.
دعوني اوضح لكم ما الذي يحتوي عليه النظام في الواقع:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
ذلك الذي index.json? 5,464 سطر من تعريفات، إحصاءات الاستخدام، تاريخ الإصدار، درجات اللياقة البدنية، وتتبع النسب.
كلّ أداة في هناك:
ملاحظة: النظام سوف يعمل بالفعل بدون أي أدوات. فقط أقل كفاءة ؛ و أغبى. بدونها سوف يتم توليد الأدوات كجزء عادي من التحلل في تدفق العمل. سوف يظل يتكيف ببطء لكنه سيأخذ المزيد من الرموز.
دعونا ننظر إلى ما هو عبارة عن أداة في الواقع.
هذا تعريف حقيقي لأداة من النظام:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
ملاحظة ما هو هناك:
لكن هذا هو ما غير في الجماهيرية:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
النظام الزيادة تعريفات ثابتة مع تعلم وقت التشغيل.
هنا ما يحدث عندما تستخدم أداة:
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
ما يُصبحُ مُتَثَقَّباً:
دعونا ننظر إلى آلية التراكم.
الجزء الأكثر ذكاءاً: نظام مخابئ أداة عند متعدّد.
مستوى:: مستوى: مستوى
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
ولهذا السبب فإن هذا يهم:
إذا طلبت من النظام أن "أكتب haiko haiko حول الشفرة" مرتين، المرة الثانية هي الحاضرةالـ LLL لا يعمل ذاكرة RAG ترجع النتيجة المخبأة.
لكن إليك الجزء الذكي: الدالة BET النسخة إذا كان موجودًا.
مثال:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
النظام تلقائي تحديد أعلى جودة عالية.
أحد الملامح الماهرة: يتعلم النظام المدة التي يستغرقها كل نموذج للاستجابة.
المشكلة:
النماذج المختلفة لها أوقات إستجابة مختلفة جداً:
tinyllama (ب ب): حوالي 3 ثوانllama3 (باء): حوالي 10 ثوانqwen2.5-coder (ب ب): حوالي 25 ثانيةdeepseek-coder-v2 (ج ب): حوالي 60 ثانيةإذا قمت بتحديد توقيت عالمي (قل، 30s)، فأنت تضيع 27 ثانية في انتظار tinyllamaوتقتل وتقتل deepseek قبل أن ينهار.
الحل : التعلُّم المتكيِّف
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
كيف يعمل:
النتائج:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
النظام يتعلم الوقت المناسب لكل نموذج بدلاً من استخدام قيمة عالمية.
عندما تطلب من النظام أن يفعل شيئاً ما، فإنه لا يقتصر على اختيار أول أداة متطابقة. إنه يجري تشغيل a الدالة عبر أبعاد متعددة.
الـ مُحْكِل:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
المثال الحقيقي:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
الانتقاء: email_validator_workflow (القامة: 190)
النظام يَختارُ سريعة، وحرة، عالية الجودة، ومثبتة ليس الأكثر شبهاً من الناحية الدلالية ليس الأكثر قوة
ذلك الذي يُلبي القيود المتعددة بشكل مثالي.
الأدوات لا تبقى ثابتة بل تتطور
لدى كل أداة ألف - التعريف محسوباً من YAML:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
متى حرّر الـمَحْكِل لـ a أداة
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
جاري التحميل التالي:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
إصدارات سِيْفِنة:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
كسر التغييرات:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
يجري التحميل:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
النظام يحذرك من تغيير التغييرات ويحافظ على تاريخ الإصدار.
كل أداة يتم فهرستها في ذاكرة RAG للبحث الدلالي:
يجري الوقت:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
الآن عند البحث:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
استخدامات النظام مُزززز إيجاد الأدوات ذات الصلة، ثم ترتيبها من خلال: اللياقة المتعددة الأبعاد.
في نظامنا نحفظ المتجهات لـ قاعدة بيانات المتجهات وهي تعطينا طريقة أنيقة لنرى كيف يمكن أن يكون فضاء الأدوات لدينا. هذا هو نظام الذاكرة لنظام بناء تدفق العمل لدينا.
مقسّمة إلى الأصلي قوالب ملفات بوصة الأدوات دليل و كل عنصر من رمز إلى حل a مهمّة و تشكيل لـ n (أ) هذه الأشكال إلى مجموعة الأدوات لتجميع قوالب العمل.
هذا الطريق كل من العمل مائل هو قابل للإحلال و قابل للإختبار كما أن كل عنصر بايثون لديه مجموعة من الاختبارات، ومواصفات BDD، وأدوات ثابتة للتحقق من الدقة و متعدد LLM المقيّمات لضمان نجاحها.
العرض الجانبي هو كل قطعة رمزية التي سوف تعمل في سير العمل موجودة هناك، على استعداد لتفتيش كل إنشاء 'أداة' يؤدي إلى مخطوطات بايثون قابلة للتفتيش.
يمكنك أن ترى الجذوع مع كل نقطة تكون مجموعة مترابطة من الأدوات مثل:
تجمعت جميعها معاً، وتخصصت بشكل طبيعي حسب طبيعة النظام.
في المستقبل نحن على الأرجح نريد أن نحسن هذه المجموعات إلى الحد من قاعدة الشفرات إلى نظام أصغر، أكثر إحكاماً، وأكثر تفاؤلاً.
كما يمكننا أن نتتبع الإصدارات، الاستخدامات، التغييرات، الركيزة يمكننا أن نتحسن بشكل انتقائي و "المجموعات المفككة" الأكثر استخداماً وأكثر أداء comopnents الحاسمة كجزء من كيفية تنظيم النظام في جوهره.
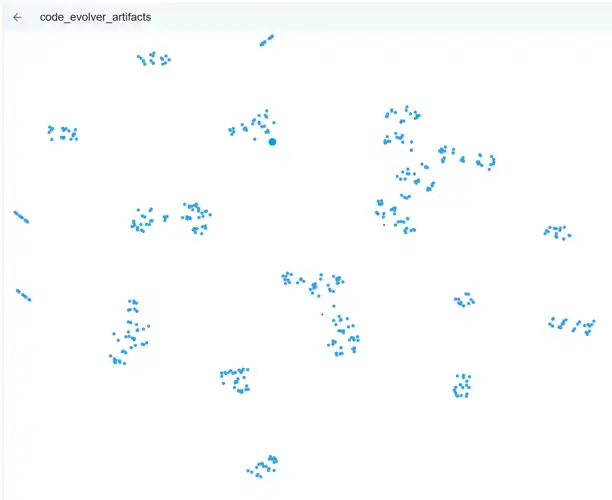
دعونا ننظر إلى ما هو موجود في النظام الآن.
أدوات LLLLS (المختصون):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
أدوات
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
أدوات OpenAPI:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
الأدوات: 50+
مجاميع خطوط البيانات الفوقية: 5, 464 4 خطوط في index.json
دعوني أريكم الأداة الأكثر تطوراً في النظام: مفضّل.
التعريف: tools/llm/code_optimizer.yaml (317 سطراً)
ما تقوم به:
التدرج الهرمي التدرجي:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
(بآلاف دولارات الولايات المتحدة)
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
1 - التجربـة:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
(بآلاف دولارات الولايات المتحدة)
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
هذا هذا **** أنتطرات:
و هو فقط أداة واحدة واحدة في نظام مع نظام 50+ + الأدوات.
واحدة من أكثر الأدوات تقدماً: دليل______.
اختيار اللغة الطبيعية:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
كيف يعمل:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
النظام passes اللغة الطبيعية إلى تحديد النماذج. يمكنك أن تقول:
وهي طرق ذكية إلى الخلفية اليمنى.
ويتعامل النظام مع الأرقام القياسية لأسعار الاستهلاك الخارجية على غرار الأدوات الداخلية.
مثال على ذلك: مترجم تحريري NMT
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
وقت التشغيل:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
ما يُصبحُ مُتَثَقَّباً:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
APIs الخارجية تحصل على نفس المعاملة:
-
واحدة من الأدوات الأكثر برية: سير العمل _ الوثائقي.
ما تقوم به:
سير العمل (أ) main.py (الملف) يُنشئ الوثائق الشاملة آلياً في:
README.txtكُلّ آلياً.
التعريف: tools/llm/workflow_documenter.yaml (11,803 أحرف!)
الحِجْم:
{
    "workflow_path": "nodes/email_validator/main.py"
}
الناتج:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
س: هل يمكن لهذا التحقق من وجود بريد إلكتروني؟ أ: لا، هذا فقط التصديق على الشكل. استخدم DNS/SMTP التحقق من الوجود.
س: هل تدعم المجالات الدولية؟ ألف: نعم، ولكن قد يكون من الضروري تحويل رمز التزليق.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
المستخدم: "أحتاج إلى أداة تحول درجات الحرارة"
النظام:
أداة إنشاء جديدة جديدة: درجة الحرارة_ conververter.yaml
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
النظام (ب) ما يلي:
و هو و هذه البيانات في:
دعونا نخطو خطوة للوراء ونفكر فيما بنيناه فعلياً:
نظام حيث:
لقد أنشأنا مجموعة أدوات ذاتية مُحسّنة:
هذه لَيستْ إدارةَ تشكيلِ.
هذه هي الأداة الناشئة للإيكولوجيا.
الأدوات ليست موارد ثابتة كائنات حية في نظام تطوري.
السيناريو 1: تحسين الذاتي للمسار الحر
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
وأدى النظام إلى تحسين مساره الحرج دون تدخل بشري.
السيناريو 2: التخصص
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
وحدد النظام نمطا وأنشأ أداة متخصصة.
السيناريو 3: تكسير التكاليف والبرمجيات
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
وينفق النظام الأموال بذكاء لتحقيق نتائج أفضل.
اسمحوا لي أن أصنف ما هو موجود في الواقع الآن.
الأخصائي
code_explainer - شرح الرموز في اللغة الطبيعيةcode_optimizer - الاستخدام الهرمي (المحلي/الكلود/العميق)code_reviewer - استعراض الجودة والأمنfast_code_generator - توليد سريع مع نماذج صغيرةsecurity_auditor - مسح درجة الضعفperformance_profiler - وضع المدونات وتحليلهاأخصائيو المحتوى:
long_form_writer - الروايات والكتب (السياق 128 كاف)content_generator - المحتوى العام للمحتوى العامarticle_analyzer - هيكل/نوعية المادةsummarizer - الملخصات الملخصة للمضمونproofreader - الغرامة والأسلوبseo_optimizer - الاستخدام الأمثلoutline_generator - مخططات المحتوىالمترجم:
quick_translator - الترجمة السريعة (نموذج صغير)translation_quality_checker - صحة الترجماتالوثائق:
doc_generator - الوثائق المشفرةtechnical_writer - الوثائق التقنيةworkflow_documenter - عوارض سير العملgeneral - عـام - الغرض العامmodel_selector انت_ انت انتtask_to_workflow_router - الطرق المؤدية إلى سير العملquick_feedback - السرعة - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -signalr_connection_parser - إشارات الاشارات الموصِلةsignalr_llmapi_management - ادارات الاشارات الاشارات PR L APIs(أ) الجواز:
call_tool_validator - صلاحيات الدعوة_ مُعَدّل مُعْتَدpython_syntax_validator - تدقيقmypy_type_checker - التحقق من النوع الثابتjson_output_validator - التصديق على استمارة JJOSSstdin_usage_validator - الصلاحيات المستخدمة stden us usmain_function_checker جاري الدالة الدالةnode_runtime_import_validator - الواردات2- التحليل:
run_static_analysis - تشغيل أدوات التحليل الثابتperformance_profiler - الأداء الرمزي لسجلات السير الشخصيةالمرافق:
save_to_disk - استمرارية المُسْكunit_converter - تحويلات الوحداتrandom_data_generator - توليد بيانات الاختبارbuffer - الإدارة الاحتياطيةworkflow_datastore - تجميع البيانات المتعلقة بسير العملstream_processor - تجهيز الإطاراتsse_stream - الأحداث الجارية(أ) التكامل:
connect_signalr - إشارة الوصلةsignalr_hub_connector - اتصال محوريsignalr_websocket_stream - السور النافذالوثائق:
document_workflow - مولد وثائق سير العملnmt_translator - الترجمة الآلية الآليةالمجموع الكلي: 53 أداة (متزايدة)
هنا حيث يصبح مثيراً للاهتمام حقاً: أدوات أخرى.
وعندما تتطور أداة مكونة، كل سيرة عمل تستخدمه تُحسَّن تلقائياً.
دعونا ننظر إلى أداة مركبة فعلية من النظام:
المهمّة: "ترجمة هذه المادة إلى الإسبانية والنوعية المثبتة"
النهج التقليدي:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
نهج SSS:
ويكتشف النظام أن هذا النمط يستخدم بصورة متواترة و إنشاء تلقائي إنشاء أداة مركبة:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
ما هو البري في هذا:
متى متى nmt_translator يتطور إلى v2.0.0 (ربما 20-20 أسرع)، أداة المركبة يستخدم النسخة الجديدة تلقائياًلا حاجة إلى تغييرات في الشفرة.
النتيجة: كل ما يستخدم من عمليات سير العمل validated_translator (أ) الحصول على أسرع (بأسرع) بدون أي تعديل.
هنا مثال أفضل من ذلك: تركيبة الأداة المتوازية.
المهمّة: "أستعرض هذا الكود بدقة"
::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
التكوين التوازيي DSE:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
التنفيذ:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
النتيجة: 35 ثانية o 20 ثانية (43٪ أسرع!)
وفي الوقت الذي security_auditor يتطور إلى v3.0.0 (قل، 30% أسرع)، اللجنة بأكملها تصبح أسرع تلقائياً.
هذا هو الجزء الذي هو حقاً بري: أدوات تعمل مثل الجينات.
المراقبة: عندما تكون أداة ما مفيدة، فإنها توزيعات خلال النظام.
مثال: نمط مدقق الجودة
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
هذا هو الانتشار الوراثي الحرفي:
المسار الرمزي هو دائماً مثلث لأن:
هذا هو الجزء الذكي حقاً: يمكنك تحسين كل الأدوات في وقت واحد.
السيناريو: لديك 20 عملية سير، كل منها باستخدام 5-10 أدوات. المجموع: حوالي 100 عملية إستدعاء للأداة.
النظم التقليدية:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
نظام DSS النظام:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
النتيجة:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
لقد درّبتَ أداة واحدة وحسّنتَ سير العمل في آن واحد.
الجزء البري الحقيقي: تطور السلاسل من خلال الرسم البياني.
مثال:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
وحسّنت إحدى الأحداث التطورية تدفقات عمل برنامج ELEVEND دون أي تدخل يدوي.
لأن الأدوات تتبع مسار اللياقة البدنية، نتائج المخبأ، والتطور الآلي، النظام (أ) تنفيذ أفضل ما هو متاح من التنفيذ.
التنفيذ على سبيل المثال:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
النظام:
المسار الرمزي هو أمثل في كل خطوة:
دعونا نكون دقيقين حول لماذا هذا وضع المرأة وليس مجرد "التلازم مع الإصدار":
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
أولا
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
"مجمع الجين":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
المرئية الجينية:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
المورثات الجينية:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
نينات، أليس كذلك؟
أجل، إنها برية حقيقيّة.
لقد بنينا نظاماً حيث:
إنها ليست مجازاً
إنّه تطوّر اصطناعي مُوجّه فعليّاً.
بعد تشغيل هذا النظام لأسابيع:
إذا كانت الأدوات قادرة على:
ما التالي؟
هذا ما لم يوضحه الجزء السابع بالكامل:
تدفق العمل الذي يتطور؟ إنها مصنوعة من الأدوات. الأدوات التي تؤلف سير العمل؟ إنها تتطور أيضاً. النظام الذي يدير التطور؟ أدوات أيضا. -المقاييس التي تتبع اللياقة البدنية؟
انها أدوات على طول الطريق إلى أسفل.
وكل واحد واحد واحد:
نحن لَمْ نَبْني a مولد شفرات.
بنينا مجموعة أدوات ذاتية التوسّع ذاتيّة التوسّع، ذاتيّة التوسّع، مُحسّنة، ذاتيّة التّوثيق، التي تحدث لتوليد الشفرة.
التمييز بين الأمور.
لأنه عندما تصبح الأدوات وحدات تطورية، عندما تتعقب لياقتها الخاصة، عندما تتكاثر وتتحول وتتنافس...
ليس لديك صندوق أدوات
عِنْدَكَ ايكولوجيا.
تَتطوّرُ إيكولوجياً.
ولكن ماذا يحدث عندما يكسر التطور الأشياء؟ عندما يُقدّم طفرة أداة حشرة حرجة؟ عندما يجعل الاستخدام الأمثل أداةً أسوأ بدلاً من الأفضل؟
هذا هو المكان الذي يأتي فيه الجزء 9 من الجزء 9 نحن نستكشف يُشفي ذاتياً من خلال النُّسْج المُوَقَّح نظام حيث الأدوات لا تتطور فقط، أنها تتذكر كل فشل، خوخ الفروع الفاشلة، ونشر تلك المعرفة لمنع أخطاء مماثلة عبر النظام الإيكولوجي بأكمله.
عندما تستطيع أدواتك أن تحطم نفسها نظامك يجب أن يتذكر لماذا ولا يكرر الخطأ أبداً
ثانياً - الحجـول: clusscid.dse
src/tools_manager.py (293 2 خطا) - إدارة الأدوات الأساسيةsrc/rag_integrated_tools.py (الخطوط 562 (562 خطا) - تكامل الرحلsrc/openapi_tool.py (سطور) - دعم برنامج العمل المفتوحsrc/model_selector_tool.py )٤٦٠ سطور( - اختيار نموذجtools/index.json (الخطوط 464 5 (5، 464 5)- سجل الأدواتtools/llm/*.yaml (27 (الأدوات) - تعاريف متخصصة في الإدارة المستدامة المستدامةtools/executable/*.yaml (الأدوات) - الأدوات القابلة للتنفيذtools/openapi/*.yaml (ب) إدماجات الأرقام القياسية لأسعار الاستهلاكالوثائق:
LLMS_AS_TOOLS.md - نظام اختيار LLLLLSWORKFLOW_DOCUMENTATION_TOOL.md - التوقيع التلقائيCHAT_TOOLS_GUIDE.md - دليل استخدام الأداةTOOL_PACKAGING.md - دليل تطوير الأدواتالسلسلة:
هذا هو الجزء 8 في سلسلة الإستخبارات الداناتية. الجزء 7 عرض مجمل بنية DSE. تكشف هذه المقالة عن التعقيد المخفي: كل أداة في النظام تتبع الاستخدام، تطور التنفيذات، نتائج المخابئ، وتشارك في الانتقاء القائم على اللياقة البدنية. مجموعة الأدوات ليست مجرد مورد -- إنها بيئة تطورية توسع، تحسن، وتوثق نفسها. الأدوات تولد الأدوات. الأدوات تحسن الأدوات. والنظام بأكمله يصبح أكثر ذكاء بمرور الوقت.
الشفرة حقيقية، تعمل محلياً على أولاما، تتبع القياسات الحقيقية، وفي الواقع تتطور. إنها تجريبية، وأحياناً غير مستقرة، وبالتأكيد "شفرات vibe". لكن الأدوات تعمل، التتبع تعمل، والتطور تعمل. مجموعة الأدوات تنمو نفسها.
ترتبط هذه الاستكشافات مع "ميخائيل" الرواية العلمية - العلمية عن الآثار الناشئة عن AI والآثار المترتبة على النظم التي تُحسِّن من نفسها. الأدوات الموصوفة هنا هي عمليات حقيقية تبين كيف يخلق الضغط التطوري التخصص، وكيف توجه وظائف اللياقة البدنية الانتقاء، وكيف تطور النظم الذاتية التحسين خصائص شبيهة بالإيكولوجيا. سواء أدى هذا إلى شبكات الأدوات على نطاق الكوكب في الجزء 6، أو شيء غير متوقع تماماً، ما زال يتعين رؤيته. هذا ما يجعله تجربة.
&:::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::::: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
